


Python切片语法详解:start、stop与step参数含义
深入解析Python切片语法中start、stop与step三个参数的含义与底层运作机制,结合正负索引、前闭后开规则、缺省值机制与常见避坑点,提供完整实用的代码示例与图解。
在 Python 编程中,切片(Slicing)是从字符串、列表或元组等序列类型中按特定规律提取子集最常用的语法。切片的核心语法为 sequence[start:stop:step],分别对应起始索引、结束边界与步长。本文将逐一拆解这三个参数的具体含义、取值规则与省略默认值,并深入探讨正负步长下的运算方向与常见避坑点。
一、切片基本形式与三个核心参数
假设你正在处理一批按时间顺序记录的用户行为日志列表,需要快速提取出从第 2 项到第 8 项之间的记录,或者每隔 2 项抽取一个样本进行抽样分析。使用循环逐个取值不仅代码繁琐,而且执行效率较低。Python 的切片语法正是为了解决这类序列子集截取问题而设计的。
切片的基本语法结构格式如下:
sequence[start:stop:step]其中三个参数的具体定义与作用如下:
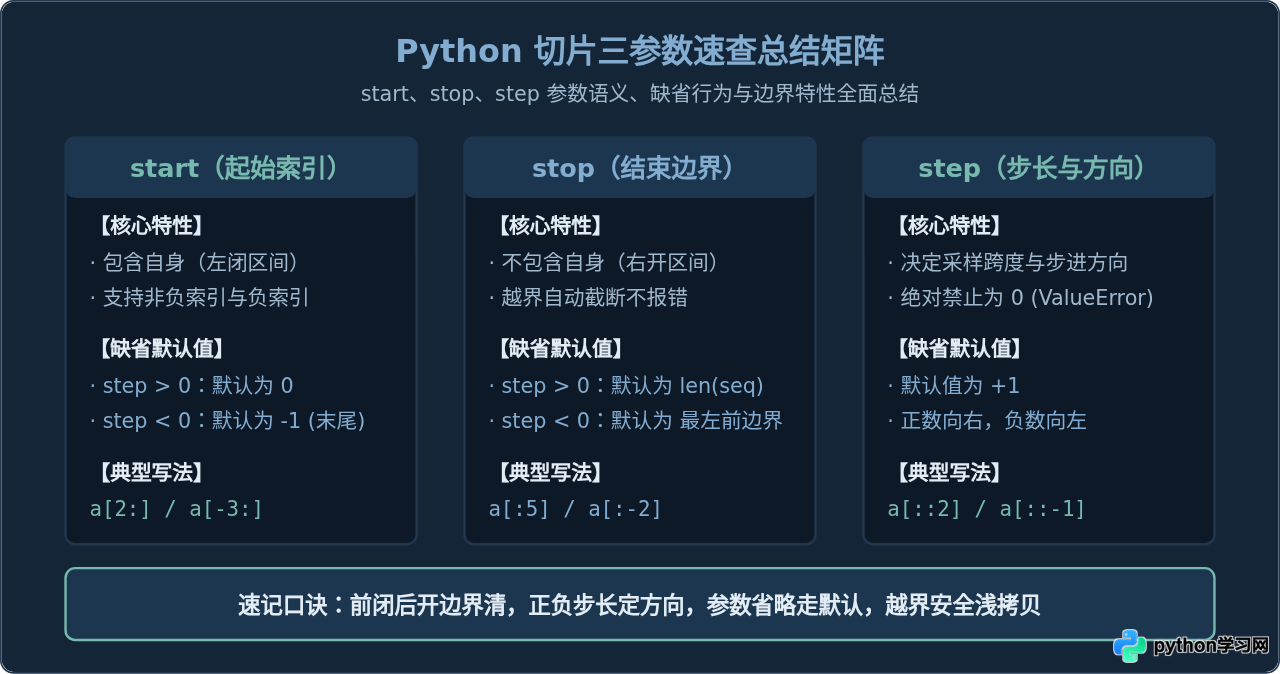
- start(起始索引):切片提取的起点位置。该位置上的元素会被包含在提取结果中(即包含边界)。
- stop(结束索引):切片提取的终止边界。该位置上的元素不会被包含在结果中(即前闭后开区间
[start, stop))。 - step(步长):每次提取元素之间的间隔步进数与移动方向。step 大小决定跳跃间隔,其正负符号决定遍历方向。
二、start 与 stop:正向索引与前闭后开规则
在默认情况下(即未显式指定 step,或者 step 显式设置为正整数),Python 按照从左往右(升序索引)的方向进行遍历截取。
1. 为什么采用“前闭后开”区间?
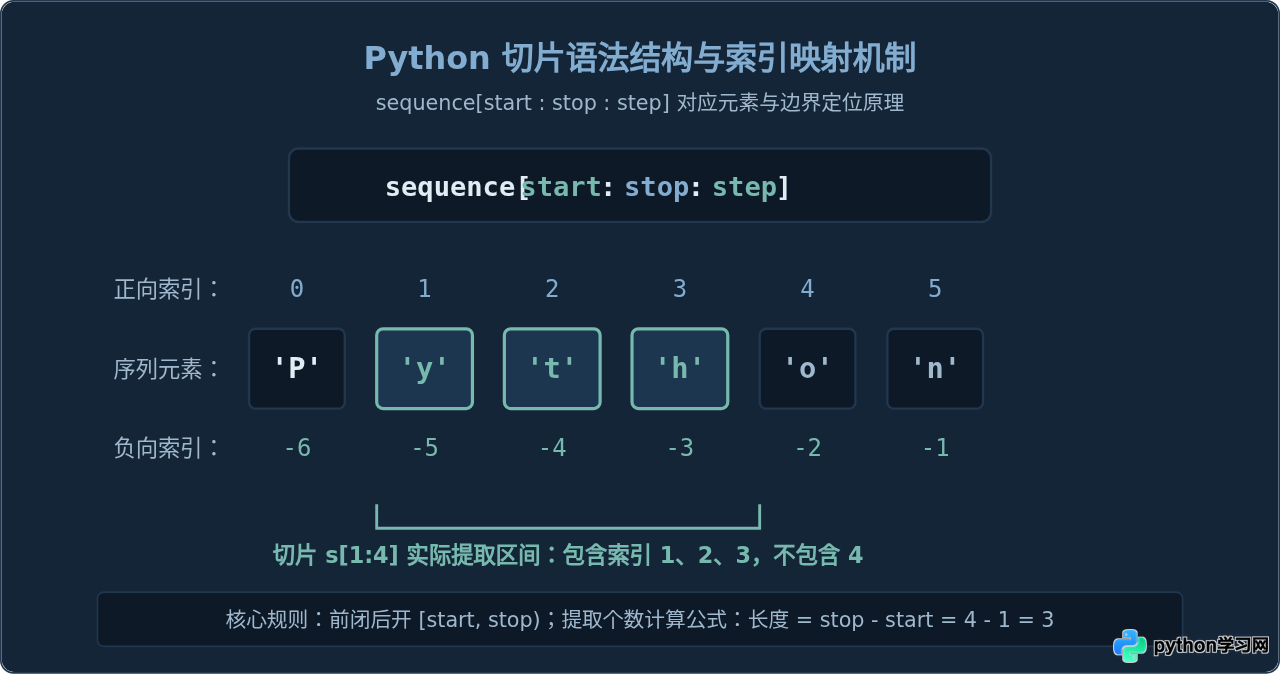
在数学表达中,区间记作 [start, stop)。这意味着索引为 start 的元素在结果中,而 stop 处的元素被排除在外。设计为前闭后开有两项非常清晰的代码优势:
- 截取长度一目了然:在步长为 1 时,截取的元素个数恰好等于
stop - start。例如s[1:4]的元素个数为4 - 1 = 3。 - 序列切分无缝拼接:任意一个分界点
k都可以将序列无缝切为两部分s[:k]与s[k:],二者内容互补且无重叠。
2. 省略参数时的缺省值处理
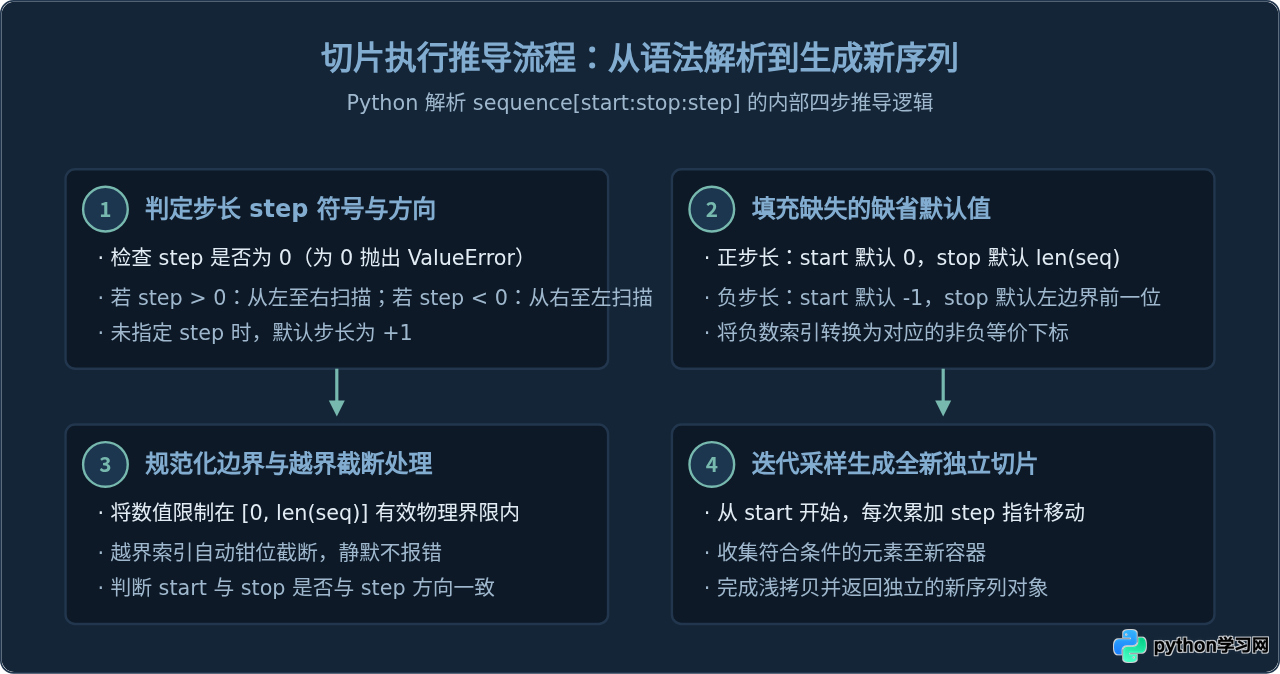
切片语法允许省略其中的一个或多个参数。当省略 start 或 stop 时,Python 会根据 step 的符号自动赋予合理的默认值:
- 省略 start:当 step 为正时,默认从序列最左端开始(索引
0)。 - 省略 stop:当 step 为正时,默认截取直至序列最右端(包含序列的最后一个元素,等价于序列长度
len(sequence))。 - 二者皆省略:例如
sequence[:],表示完整复制该序列的所有元素。
# 示例代码:start 与 stop 参数操作
words = ['zero', 'one', 'two', 'three', 'four', 'five']

# 显式指定 start 与 stop
print(words[1:4])
# 示例输出: ['one', 'two', 'three']

# 省略 start(从头部开始)
print(words[:3])
# 示例输出: ['zero', 'one', 'two']

# 省略 stop(截取至末尾)
print(words[3:])
# 示例输出: ['three', 'four', 'five']

# 使用负向索引指定边界
print(words[-4:-1])
# 示例输出: ['two', 'three', 'four']在使用单个索引访问元素(如 sequence[100])时,超出序列范围会直接抛出 IndexError: list index out of range。但在切片操作中,Python 会自动将超出边界的 start 或 stop 截断到序列的有效边界内。例如对长度为 6 的列表执行 words[2:100],结果会截取从索引 2 到列表末尾的元素,不会报错。
三、深入理解 step 参数:正负步长与提取方向
step(步长)不仅决定了提取元素时的采样间隔,更直接决定了遍历序列的行进方向。它是切片语法中最具灵活性,也是初学者最容易产生混淆的参数。
1. 正步长(step > 0):正向等距采样
当 step 为正整数时,指针从左侧向右侧移动。例如 step=2 表示每隔 1 个元素取一个值;step=3 表示每隔 2 个元素取一个值。
当 step > 0 时,必须满足 start < stop 才能提取出有效元素;若 start >= stop,由于向右移动无法从靠后的位置到达靠前的位置,切片将直接返回空序列。
numbers = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

# 隔项采样(偶数)
print(numbers[::2])
# 示例输出: [0, 2, 4, 6, 8]

# 从索引 1 开始隔项采样(奇数)
print(numbers[1::2])
# 示例输出: [1, 3, 5, 7, 9]

# 设定范围的同时指定步长
print(numbers[2:8:2])
# 示例输出: [2, 4, 6]
2. 负步长(step < 0):反向逆序遍历
当 step 为负整数时,指针移动方向逆转为从右向左。这一转变会带来两个核心推论:
- 必须满足
start > stop:因为向左移动,起点必须在终点的右侧。如果依旧写成start < stop(例如numbers[2:7:-1]),将得到空列表[]。 - 默认缺省值颠倒:当 step < 0 时,省略 start 默认代表最右侧末尾元素(索引
-1);省略 stop 则代表一路向左直到最左侧起始元素,且包含索引 0 处的元素。
# 经典的序列反转
print(numbers[::-1])
# 示例输出: [9, 8, 7, 6, 5, 4, 3, 2, 1, 0]

# 指定区间的反向截取(从索引 7 递减至索引 3)
print(numbers[7:2:-1])
# 示例输出: [7, 6, 5, 4, 3]

# 步长为 -2 的逆向采样
print(numbers[8:1:-2])
# 示例输出: [8, 6, 4, 2]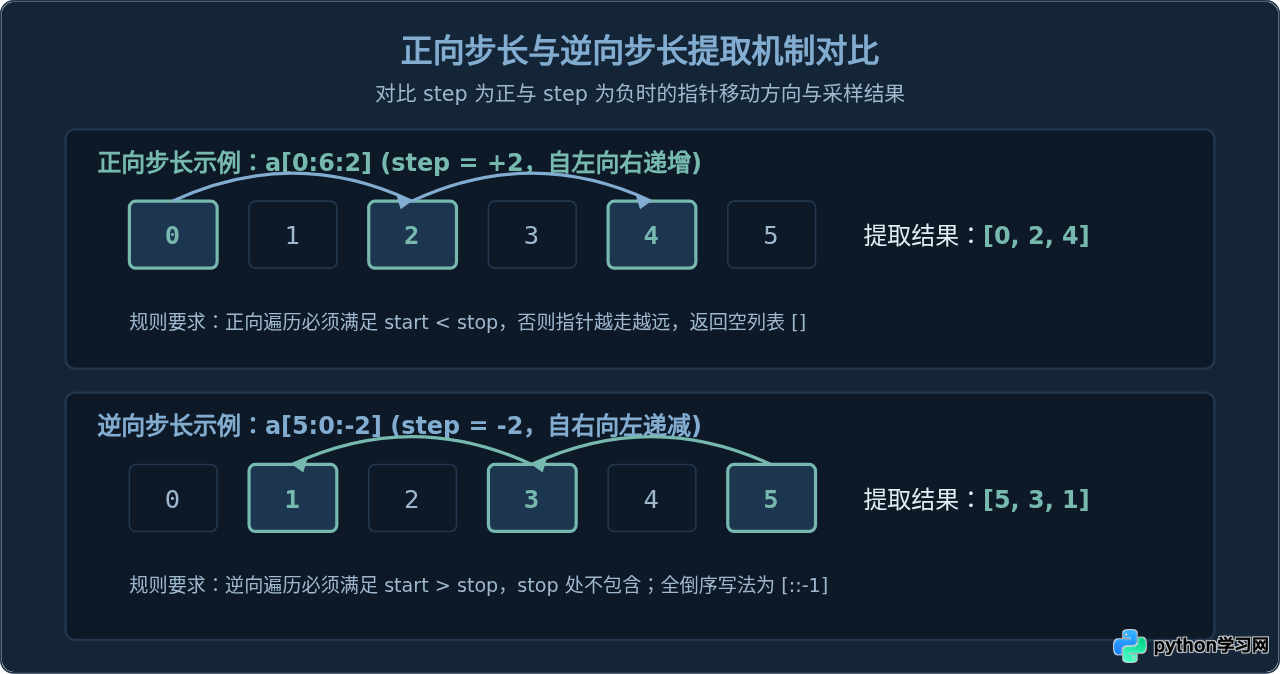
四、关键细节与常见陷阱排查
掌握了基本概念后,在实际编码中还需要特别警惕以下几个容易导致隐蔽 Bug 的陷阱:
1. 方向不匹配导致意外获取空序列
最容易出现的错误是设定了负步长,却依旧按照习惯保留了“较小的 start 和较大的 stop”。例如:
lst = [10, 20, 30, 40, 50]
# 误解:希望从索引 1 截取到 4,但倒序返回
wrong_slice = lst[1:4:-1]
print(wrong_slice)
# 示例输出: []原因排查:因为 step = -1 要求指针从起点向左移动,但起点 1 的左侧只有索引 0,永远无法抵达索引 4。Python 在检测到无法抵达终止条件后,直接返回空列表 []。正确的写法应该是 lst[3:0:-1],或者先切片再反转 lst[1:4][::-1]。
2. 切片操作生成的是浅拷贝(Shallow Copy)
使用 a[:] 可以快速复制一个新列表。修改新列表中元素的基本赋值不会影响原列表,但如果列表中嵌套了字典、子列表等可变对象,切片仅复制了引用:
matrix = [[1, 2], [3, 4]]
matrix_copy = matrix[:]

# 修改最外层容器元素(原列表不受影响)
matrix_copy.append([5, 6])
print(len(matrix))       # 示例输出: 2
print(len(matrix_copy))  # 示例输出: 3

# 修改嵌套的可变对象(原列表被同步改变!)
matrix_copy[0][0] = 999
print(matrix[0][0])      # 示例输出: 999
3. 原生 slice() 对象的等价性
在 Python 底层,方括号中的切片语法 a[start:stop:step] 实际上是调用了内置的 slice(start, stop, step) 类构造函数:
# 显式创建切片对象
rule = slice(1, 5, 2)

data_a = [0, 1, 2, 3, 4, 5, 6]
data_b = "abcdefg"

# 统一复用同一个切片规则
print(data_a[rule])  # 示例输出: [1, 3]
print(data_b[rule])  # 示例输出: 'bd'
当需要跨多个不同的数据序列应用同一套截取逻辑时,直接创建可复用的 slice 命名对象,不仅能大幅提升代码的可读性,也便于统一维护和单元测试。
五、全景速查对照表
| 切片表达式 | 等价完整形式 | 扫描方向 | 功能说明 |
|---|---|---|---|
a[:] |
a[0:len(a):1] |
向右 | 浅拷贝复制整个序列的所有元素 |
a[:k] |
a[0:k:1] |
向右 | 截取从开头到索引 k 之前(前 k 个元素) |
a[k:] |
a[k:len(a):1] |
向右 | 截取从索引 k 一直到末尾的所有元素 |
a[::2] |
a[0:len(a):2] |
向右 | 从头到尾隔项采样(索引为 0, 2, 4... 的元素) |
a[::-1] |
a[-1:-(len(a)+1):-1] |
向左 | 快速将整个序列完整倒序翻转 |
a[end:start:-1] |
a[end:start:-1] |
向左 | 在指定范围内逆序提取元素(要求 end > start) |
通过本文的解析,可以看出 Python 切片语法的强大在于其高度统一的规则设计:始终遵循“包含起点、排除终点”的区间契约;始终通过 step 的正负号严格把控扫描方向;并在参数缺省时提供确定性的安全回退机制。牢记这三点,便能从容应对序列处理与数据抽样的各种场景。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















