


pandas读取CSV时直接设置index_col避免后续重置索引
详细讲解在Python pandas中使用read_csv读取CSV文件时,通过直接设置index_col参数确立索引,避免后续繁琐的set_index与reset_index操作,提升代码整洁度与处理效率。
pd.read_csv() 中配置 index_col 参数指定索引列,可以在文件解析阶段一步确立行索引结构。这种做法直接省去了后续调用 set_index() 的中间步骤,从源头上杜绝因索引重叠、误操作或结构混乱而不得不调用 reset_index() 的返工流程,使数据清洗逻辑更加精炼且执行效率更高。
传统迂回做法与直接配置的路径差异
很多初学者在读取包含业务标识(如订单号、用户ID、时间戳)的 CSV 文件时,往往采用先无参数读取、再单独设置索引的方式。这种模式虽然逻辑直观,但会在数据加载与转换过程中引入不必要的冗余状态。
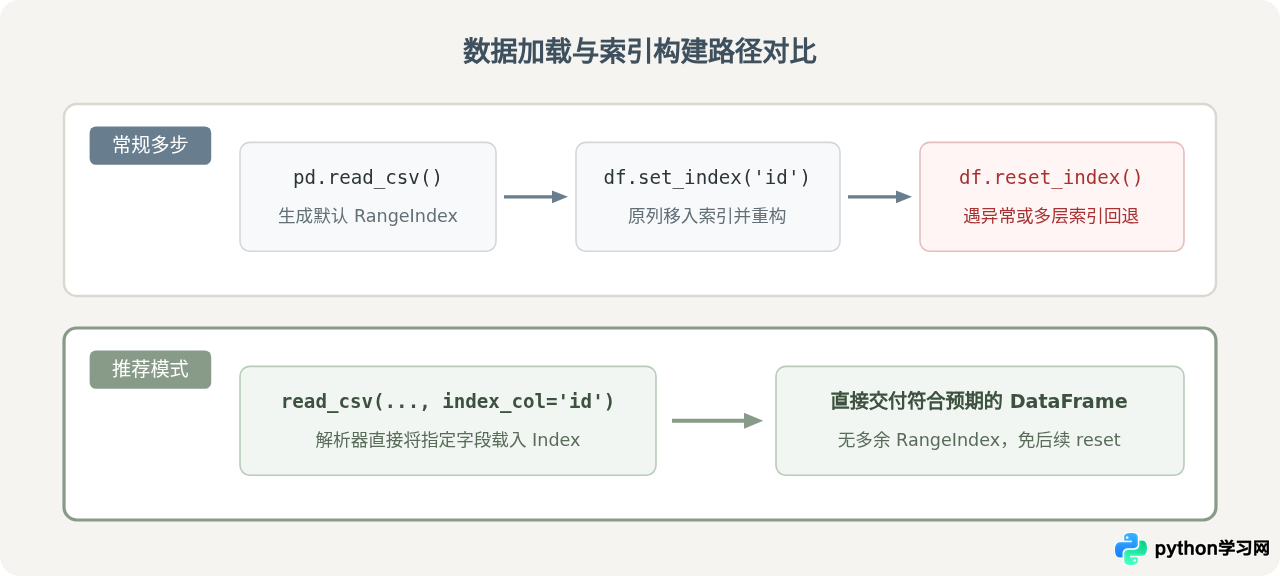
为了清晰展示两者的实际开销,我们通过下表对比在相同 CSV 文件下,两种处理方式的关键差异:
| 对比维度 | 读取后手动 set_index() | 读取时直接配置 index_col |
|---|---|---|
| 中间状态 | 初次读取产生 0 到 N-1 的默认连续数字索引 | 无多余默认索引,加载完毕即为业务键索引 |
| 内存与对象开销 | 需在内存中创建两个连续的 DataFrame 对象并重新构建索引映射 | C 语言解析层单次扫描分配,直接绑定索引块 |
| 列名保留行为 | 需注意 drop=False 选项,否则原列从列集合中移除 |
明确将对应列转换为 Index,列与索引职责分明 |
| 防错表现 | 多次重复调用容易导致索引层次叠加,需用 reset_index() 修补 |
源头保证幂等性,下游脚本不需要来回恢复索引 |
index_col 的常用配置方式与操作步骤
index_col 参数非常灵活,支持列名字符串、整型列位置、列名列表以及布尔值四种传参形式。读者可根据 CSV 的结构特征选择最匹配的写法。
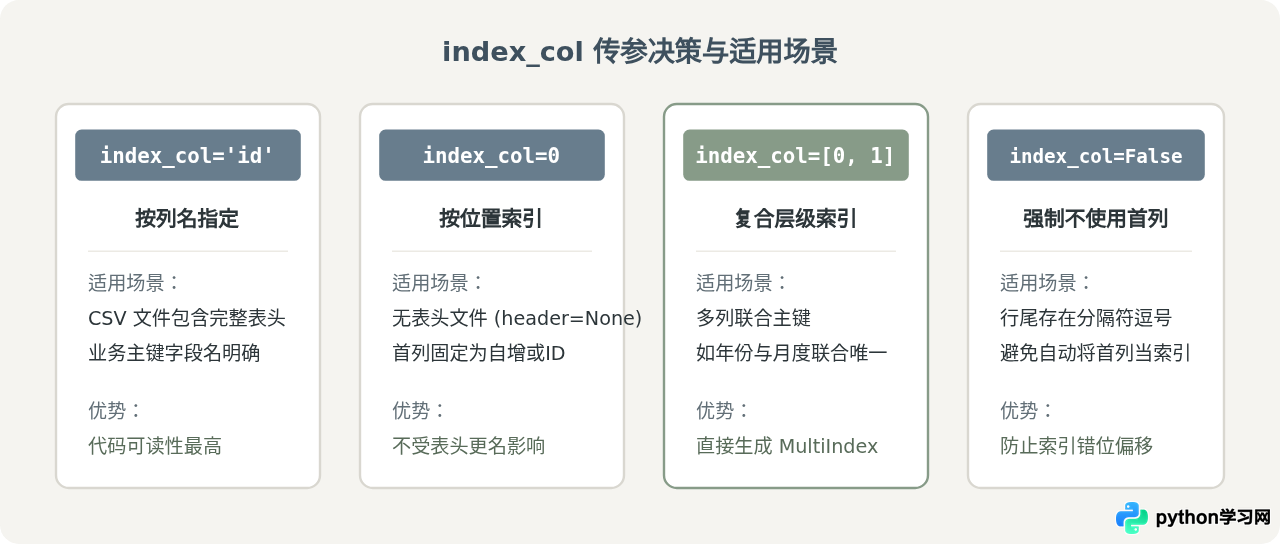
场景一:使用明确的列名作为单列索引
假设我们有一个名为 orders.csv 的订单记录文件,其首行为标题,其中 order_id 为唯一标识:
import pandas as pd

# 推荐写法:通过字符串直接指定列名
df = pd.read_csv('orders.csv', index_col='order_id')
print(df.head(2))可以看到,order_id 已经直接作为行索引(Index),不再存在默认的 0, 1, 2... 数字行标,也不需要在此之后额外执行 df.set_index('order_id')。
场景二:基于列序号加载(常用于无表头或固定格式文件)
当 CSV 文件没有表头,或者首列固定为自增编号时,传入整数 0 是最为便捷的选择:
# 0 代表以 CSV 中的第一列作为索引
df = pd.read_csv('sensor_log.csv', header=None, index_col=0)
场景三:构建复合索引(MultiIndex)
若数据集需要联合多个维度进行定位(例如按地区和月份聚合的数据),可以向 index_col 传递一个列表:
# 传递列名列表构建两级索引
df_multi = pd.read_csv('sales_data.csv', index_col=['region', 'quarter'])
print(df_multi.index)底层原理:为什么直接设置能够避免 reset_index
要理解为什么 index_col 能从根本上消除对 reset_index() 的依赖,需要深入 pandas 解析 CSV 文件的内部数据流转机制。
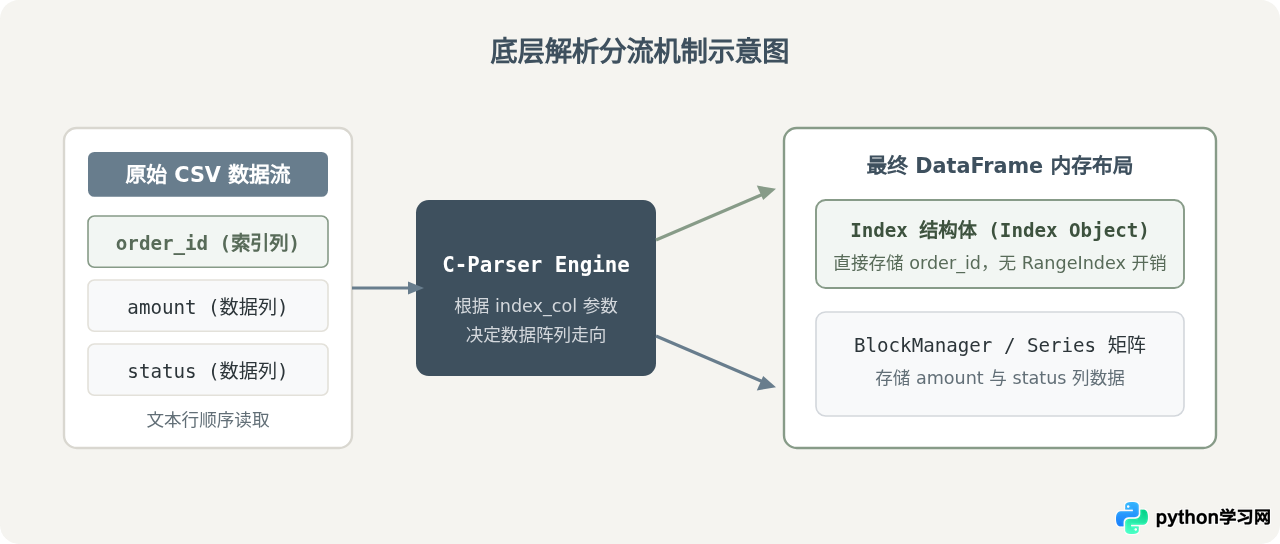
在 pandas 底层,DataFrame 由两部分核心构成:管理各列二维数组的 BlockManager 和负责坐标定位的 Index 引擎。两者的协同机制解释了为何事前指定优于事后重设:
- 避免无效的默认 RangeIndex 创建:当不传
index_col时,底层 C 解析器默认必须先构造一个从 0 开始的整数序列作为索引。如果后续再调用df.set_index(),这个刚刚生成的默认序列就会被丢弃,造成一次无意义的内存申请与垃圾回收。 - 杜绝列与索引的重复与遗漏:在数据处理流水线中,如果多个函数交替对 DataFrame 进行过滤、切片或分组,中途调用
set_index()若未显式设置drop=False,原列就会消失;若设置不当,在后续调用reset_index()恢复时又经常会触发ValueError: cannot insert id, already exists的列名冲突错误。而在读取源头便锁定索引,能确保整个下游流水线中数据形态高度稳定。
关键细节与常见问题排查
在实际应用 index_col 时,有几个细微但高频出现的问题需要特别注意:
有些 CSV 文件导出格式不规范,表头字段可能带有前后空格(例如
"order_id, amount" 中包含前导空格)。如果直接使用 index_col='amount' 会抛出 KeyError: 'amount'。此时可搭配 skipinitialspace=True 参数:
df = pd.read_csv('orders.csv', skipinitialspace=True, index_col='amount')如果你的索引列是时间戳(如
timestamp),不要在读取后使用 to_datetime() 再重置索引。直接在 read_csv 中同时配置 index_col 与 parse_dates,可以一步得到解析完毕的 DatetimeIndex:
df = pd.read_csv('trades.csv', index_col='trade_time', parse_dates=['trade_time'])
print(type(df.index))
# 输出:<class 'pandas.core.indexes.datetimes.DatetimeIndex'>index_col=None 是默认值,pandas 会根据数据自动推断(当每行末尾有多余逗号时,pandas 可能误将第一列当作索引);而显式设置 index_col=False 则会强制锁定“不把第一列当做索引”,始终生成纯正的连续数字行标。
总结
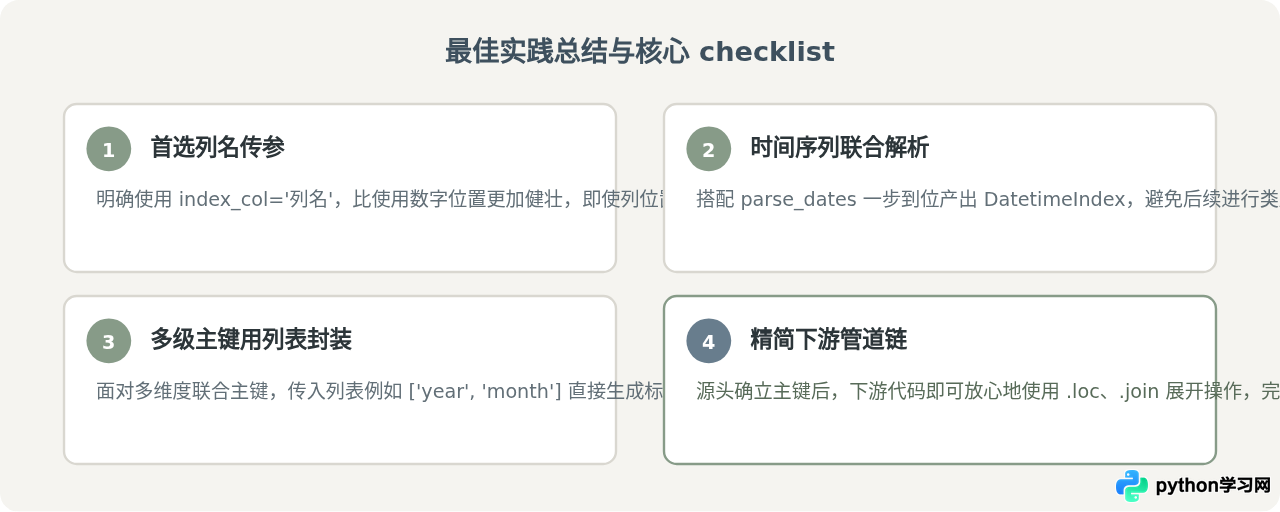
在 pandas 中,行索引是连接数据与运算的核心枢纽。通过在 pd.read_csv() 时显式配置 index_col,我们不仅在代码语法上减少了对 set_index() 的书写,更重要的是在底层解析环节一次性完成了数据块与索引块的分配,规避了中间重复对象的产生。这种在源头建立主键的严谨习惯,能有效防止后续由于索引混乱而频繁依赖 reset_index() 补救的情况,使整个数据处理流水线更清晰、更稳健。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















