


Python堆排序算法代码实现及复杂度分析
深入讲解Python堆排序算法原理、最大堆构建与调整过程、完整代码实现及详细的时间与空间复杂度分析。
堆排序(Heap Sort)是一种基于完全二叉树结构的比较类排序算法。它通过将无序数组组织成二叉堆结构,利用堆顶元素恒为极值的特性,在原数组上反复提取最大值(或最小值)并将其移至末尾,从而实现整体升序(或降序)排序。本文将深入讲解堆排序的核心机制、给出清晰的 Python 代码实现,并对算法的时间与空间复杂度进行细致推导与总结。
一、堆的逻辑结构与数组映射关系
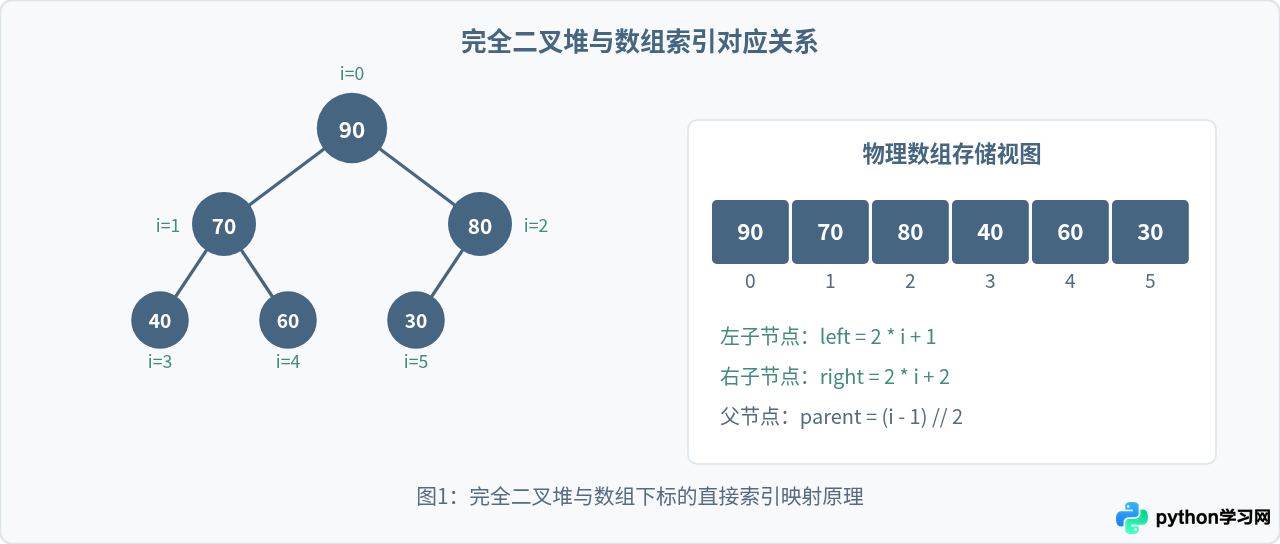
二叉堆在逻辑上是一棵完全二叉树,但在物理存储上通常直接使用连续的线性数组。完全二叉树的紧凑性质使得节点之间的父子关系可以通过数组下标高效计算,而无需额外的指针引用。
对于基于零索引(0-indexed)的 Python 列表:
- 若父节点下标为
i,则其左子节点下标为2 * i + 1; - 其右子节点下标为
2 * i + 2; - 反之,若子节点下标为
j(j > 0),其父节点下标为(j - 1) // 2。
二、堆排序的核心操作:堆化(Heapify)
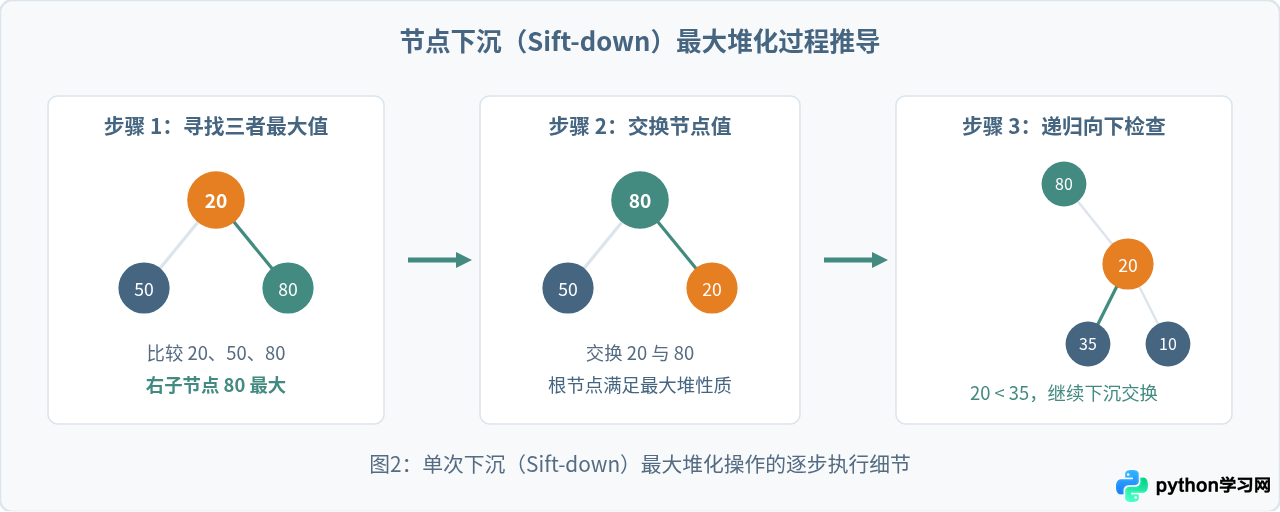
堆排序的核心是 heapify 操作(通常为最大堆化)。假设节点的左右子树均已满足最大堆性质,但当前根节点的值可能小于其子节点,此时需要将根节点沿树向下“下沉”(Sift-down):
- 比较当前节点、左子节点和右子节点,找出三者中的最大值下标;
- 若最大值并非当前节点,则交换当前节点与最大子节点的值;
- 沿发生交换的子节点分支继续向下递归执行该操作,直到当前节点大于等于所有子节点或到达叶子节点为止。
三、堆排序的整体算法流程
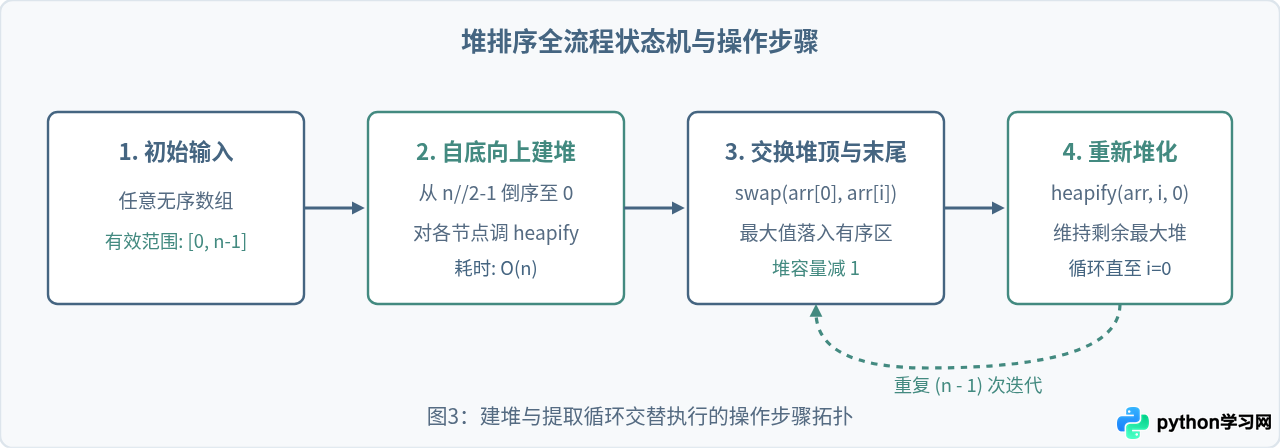
堆排序完整流程分为两大阶段:建堆与循环提取排序。
- 构建最大堆:从最后一个非叶子节点
(n // 2 - 1)开始,逆序向前遍历至根节点0,依次对每个节点执行heapify。所有操作完成后,整个无序列表即构成为符合性质的最大堆。 - 排序与收缩堆:将堆顶元素(当前堆内最大值
arr[0])与堆末尾有效元素arr[i]互换;交换后,原最大值已到达其最终有序位置。将堆的有效范围缩小 1,并对新的堆顶arr[0]重新调用heapify,恢复最大堆性质。重复该过程直至堆内只剩 1 个元素。
四、Python 代码实现
下面给出堆排序的标准 Python 实现,采用原地(In-place)交换,不产生额外的数组内存开销:
def heapify(arr: list, n: int, i: int) -> None:
    """
    维护最大堆性质的核心函数 (Sift-down 下沉)
    :param arr: 待排序列表
    :param n: 当前堆的有效元素个数
    :param i: 当前需要检查下沉的节点索引
    """
    largest = i          # 将当前节点假定为最大值
    left = 2 * i + 1     # 左子节点下标
    right = 2 * i + 2    # 右子节点下标

    # 若左子节点存在且数值大于当前最大值
    if left < n and arr[left] > arr[largest]:
        largest = left

    # 若右子节点存在且数值大于当前最大值
    if right < n and arr[right] > arr[largest]:
        largest = right

    # 若最大值不是根节点,则交换并递归调整受影响的子树
    if largest != i:
        arr[i], arr[largest] = arr[largest], arr[i]
        heapify(arr, n, largest)


def heap_sort(arr: list) -> list:
    """
    堆排序主函数
    :param arr: 待原地排序的列表
    :return: 排序后的列表自身
    """
    n = len(arr)
    if n <= 1:
        return arr

    # 第一阶段:构建最大堆
    # 最后一个非叶子节点下标为 (n // 2) - 1,逆序向上处理到根节点 0
    for i in range(n // 2 - 1, -1, -1):
        heapify(arr, n, i)

    # 第二阶段:逐个提取最大元素并进行原地交换
    for i in range(n - 1, 0, -1):
        # 将当前堆顶(最大值)移至数组末尾已排序区域
        arr[0], arr[i] = arr[i], arr[0]
        # 在缩小后的堆 [0, i) 上重新对堆顶执行 heapify
        heapify(arr, i, 0)

    return arr


# 验证执行示例
if __name__ == "__main__":
    sample_data = [12, 11, 13, 5, 6, 7]
    print("排序前数组:", sample_data)
    heap_sort(sample_data)
    print("排序后结果:", sample_data)
排序前数组: [12, 11, 13, 5, 6, 7]排序后结果: [5, 6, 7, 11, 12, 13]
五、复杂度分析与性能特性
堆排序之所以在理论与工业实践中占有重要地位,在于其严格且稳定的时间界限与低廉的空间开销。
1. 时间复杂度
- 建堆时间复杂度:O(n)
直觉上容易认为对n/2个节点各做一次O(log n)的下沉需要O(n log n)。但实际上,越靠近底部的节点数量越多、下沉的最大距离越短。高度为h处的节点数最多为ceil(n / 2^(h+1)),其下沉时间为O(h)。对整个级数求和可知,建堆总操作次数严格收敛于O(n)。 - 排序提取时间复杂度:O(n log n)
共进行n - 1次交换与堆顶重新下沉。每次堆顶调整至多遍历树的高度,耗时为O(log n)。因此总提取时间为(n - 1) * O(log n) = O(n log n)。 - 综合时间复杂度:O(n log n)
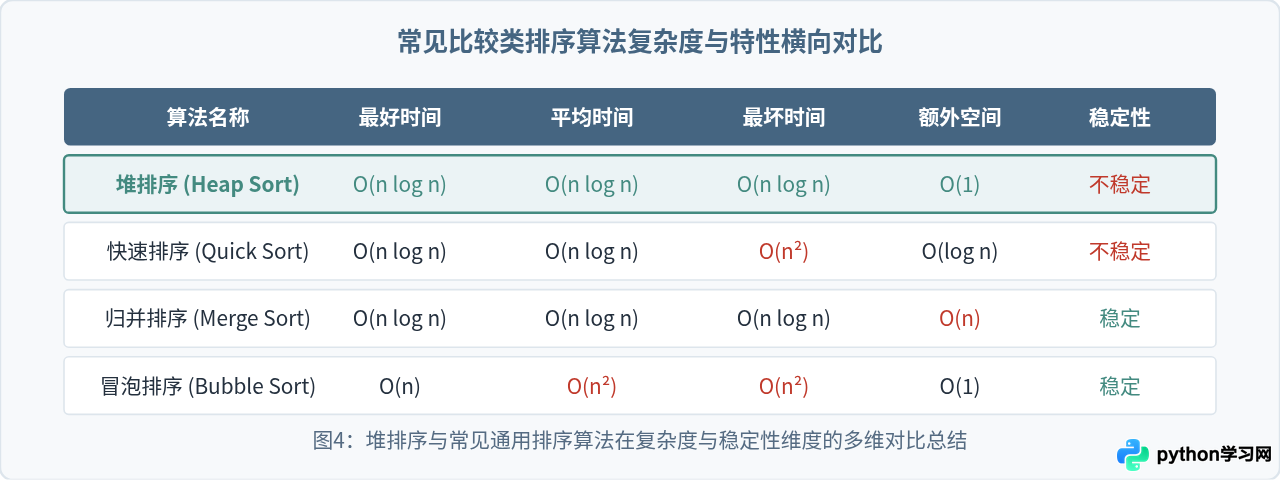
无论是最好情况(数组已有序或全等)、最坏情况(逆序),还是平均情况,建堆与提取两部分的计算量均保持不变,因此堆排序在任何情况下的时间复杂度恒为O(n log n)。
2. 空间复杂度与稳定性
- 空间复杂度:O(1)
堆排序在原输入数组上进行交换与重构,无需申请额外的动态数组空间。若采用迭代方式编写下沉函数,辅助空间为纯粹的O(1);即便采用递归版本,调用栈深度也仅为O(log n),属于极低的原地算法。 - 稳定性:不稳定
堆排序在节点下沉和交换过程中,可能会将相对位置靠前的相同元素跨层交换到靠后位置,破坏原有等值元素的顺序,因而属于非稳定排序算法。
六、实践总结与应用场景
堆排序的核心优势在于极佳的最坏时间保证与极低的内存开销。与可能退化为 O(n²) 的未优化快速排序相比,堆排序即使面对精心构造的对抗输入也能严格保持 O(n log n) 执行效率;而与同样具备稳定时间界的归并排序相比,它省去了 O(n) 的辅助数组分配,内存利用率极高。
在实际工程中,堆结构的延伸应用还包括优先队列设计以及海量数据下的 Top-K 极值筛选(只需维护大小为 K 的固定小顶堆或大顶堆,能在 O(n log k) 时间和 O(k) 空间内解决海量数据过滤问题)。理解并掌握堆的物理存储机制与下沉维护逻辑,是夯实底层算法思维的关键一步。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















