


Python与C/Java取模运算差异:负数结果为何不同
深入解析Python与C/Java在处理负数取模运算时的底层数学逻辑与设计分歧,剖析向下取整与向零截断的本质区别,并提供跨语言开发中的实用避坑指南。
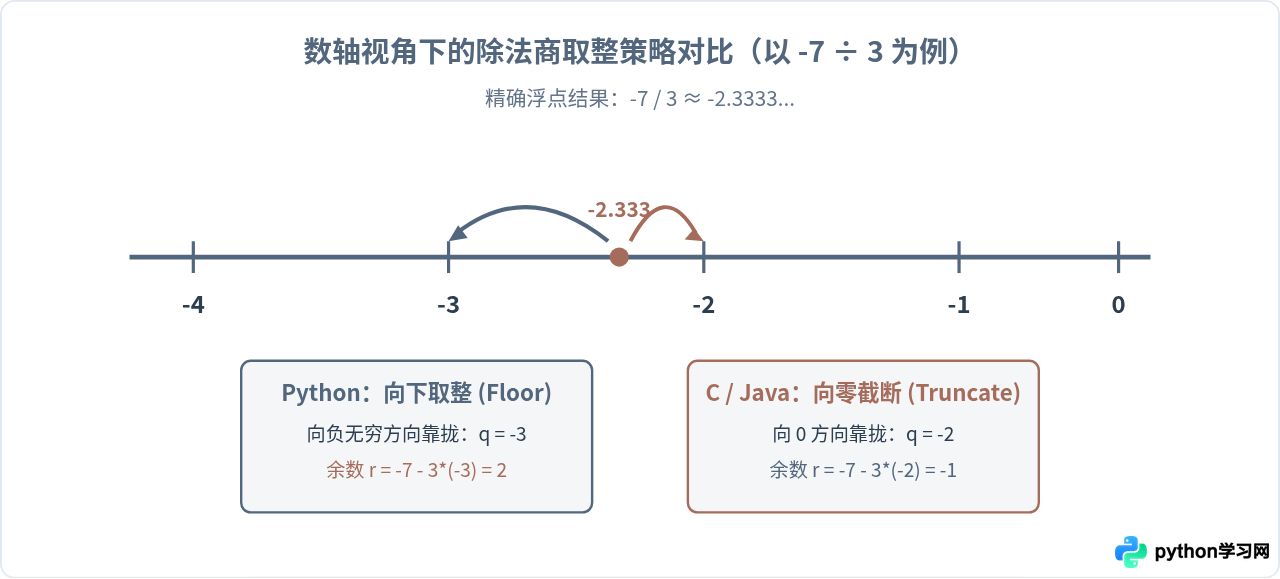
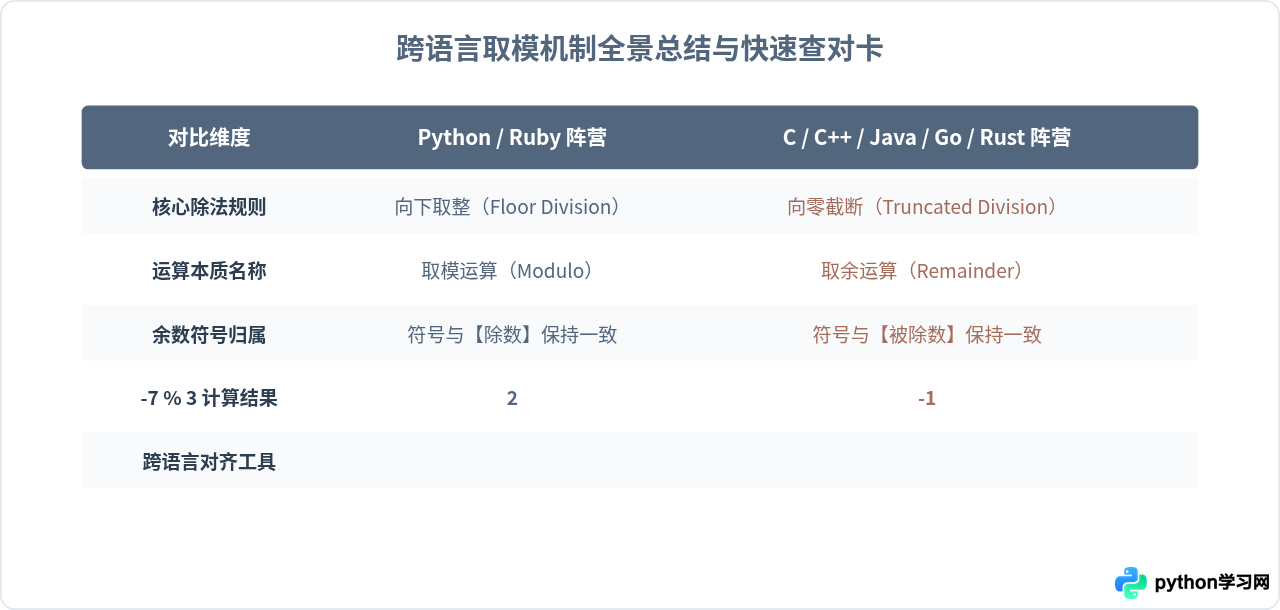
很多开发者在跨语言编程时,都曾遇到过一个令人困惑的现象:在 Python 中执行 -7 % 3,得到的结果是 2;而同样的代码放在 C、C++ 或 Java 中运行,结果却是 -1。这个差异并非实现上的笔误或系统 bug,而是源于底层对除法取整策略的不同选择:Python 采用的是向负无穷方向取整的“向下取整”(Floor Division),而现代 C 和 Java 采用的是向零方向靠近的“截断取整”(Truncated Division)。
一、现象呈现:令人困惑的负数取模结果
我们先来看两段简洁的代码对比,直观观察两个阵营的运算差异:
# Python 终端示例
print(-7 % 3)   # 输出:2
print(7 % -3)   # 输出:-2
print(-7 % -3)  # 输出:-1
// Java / C 语言示例
System.out.println(-7 % 3); // 输出:-1
System.out.println(7 % -3); // 输出:1
System.out.println(-7 % -3); // 输出:-1当操作数全为正整数时(例如 7 % 3),两种语言均毫无悬念地输出 1。然而一旦引入负数,计算结果不仅数值不同,连正负符号也产生了明显分歧。要弄清根本原因,我们需要回到初等数学中的带余除法定义。
二、核心数学机制:除法取整策略的分歧
无论是哪门编程语言,取模(Modulo)与取余(Remainder)都遵循同一个严格的欧几里得恒等式约束:
给定被除数
a 和除数 d(d ≠ 0),存在唯一的商 q 和余数 r,满足:a = d × q + r整理可得余数计算式:
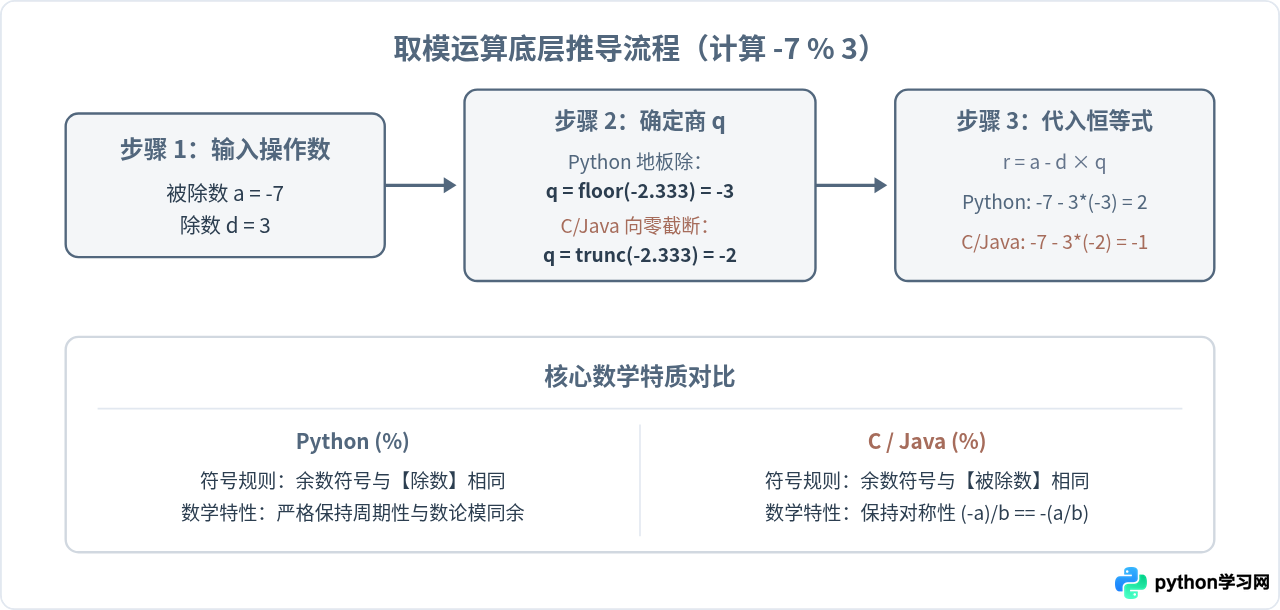
r = a - d × q
从公式可以看出,余数 r 的值完全取决于商 q 的取值。当进行整数除法 a / d 无法整除时,得到的浮点结果必须转化为一个整数商 q。正是在“如何将实数商转为整数”这一点上,不同语言做出了截然不同的设计决策:
1. Python 采用的地板除法(Floor Division)
Python 规定,整数除法使用 math.floor() 的数学规则,即商 q 必须取不大于真实浮点值的最大整数(向负无穷方向舍入):
- 计算
-7 / 3时,精确商为-2.3333...。 - 不大于
-2.3333...的最大整数是-3,因此商q = -3。 - 代入余数公式:
r = -7 - (3 × -3) = -7 - (-9) = 2。
这种规则保证了:余数的符号始终与除数 d 的符号一致(或者为 0)。只要除数为正,余数就必定落在区间 [0, d) 内。
2. C/Java 采用的截断除法(Truncated Division)
现代 C(C99 标准起)、C++ 以及 Java 规定,整数除法直接舍弃小数部分,即向零方向截断(向原点方向舍入):
- 计算
-7 / 3时,精确商为-2.3333...。 - 向零截断舍弃小数后,商
q = -2。 - 代入余数公式:
r = -7 - (3 × -2) = -7 - (-6) = -1。
这种规则带来的结果是:余数的符号始终与被除数 a 的符号一致(或者为 0)。如果被除数是负数,余数就是非正数。
三、设计权衡:为什么语言标准选择不同
面对截断除法与地板除法,两种语言阵营的选择体现了不同的工程哲学与应用侧重:
1. C 与 Java:贴近底层硬件与算术对称性
在 x86 等主流 CPU 架构中,硬件级的整数除法指令(如 IDIV)在微代码层面实现的就是向零截断。C 语言自诞生起就强调贴近底层硬件和执行效率。在 C89 标准时期,负数除法的舍入方式曾被列为“由实现定义”(Implementation-Defined)。直到 C99 标准制定时,委员会为了消灭不确定性,正式将向零截断写入标准,Java 也全盘采纳了该定义。
这种选择最大的优势在于满足算术对称性:在 C/Java 中,(-a) / b == -(a / b) 始终成立。例如 -7 / 3 == -(7 / 3) == -2。这符合人类直觉中“先计算数值、再附加负号”的习惯。
2. Python:贴近数论规律与周期性场景
Python 之父 Guido van Rossum 在专门阐释该设计的博文中指出,Python 优先考虑数学上的周期性。在时钟运算、散列分布以及循环数组等大量实际开发场景中,模数几乎总是正数。如果使用地板除,当数值在数轴上连续递增或递减时,余数始终在 [0, d-1] 之间呈现完美的锯齿状周期循环。
四、工程实践与避坑指南:跨语言开发常见陷阱
由于两类语言对取模的定义不同,在跨语言移植算法或日常编写业务逻辑时,极易踩入以下典型陷阱:
1. 奇偶性判断陷阱
在 C 或 Java 中,很多初学者习惯这样判断一个整数是否为奇数:
// 存在严重 Bug 的判断方式
public static boolean isOdd(int n) {
    return n % 2 == 1; // 当 n = -5 时,-5 % 2 结果为 -1,返回 false!
}
当传入负奇数(如 -5)时,C/Java 的取模结果是 -1,导致该函数错误地将负奇数判定为非奇数。正确的跨语言写法应判断余数不为零,或利用位运算:
// 正确且通用的写法
public static boolean isOdd(int n) {
    return n % 2 != 0; // 无论是 1 还是 -1,均不等于 0
}

// 或者利用位运算(不受正负号符号位干扰)
public static boolean isOddBit(int n) {
    return (n & 1) != 0;
}
2. 循环回退与环形缓冲区索引
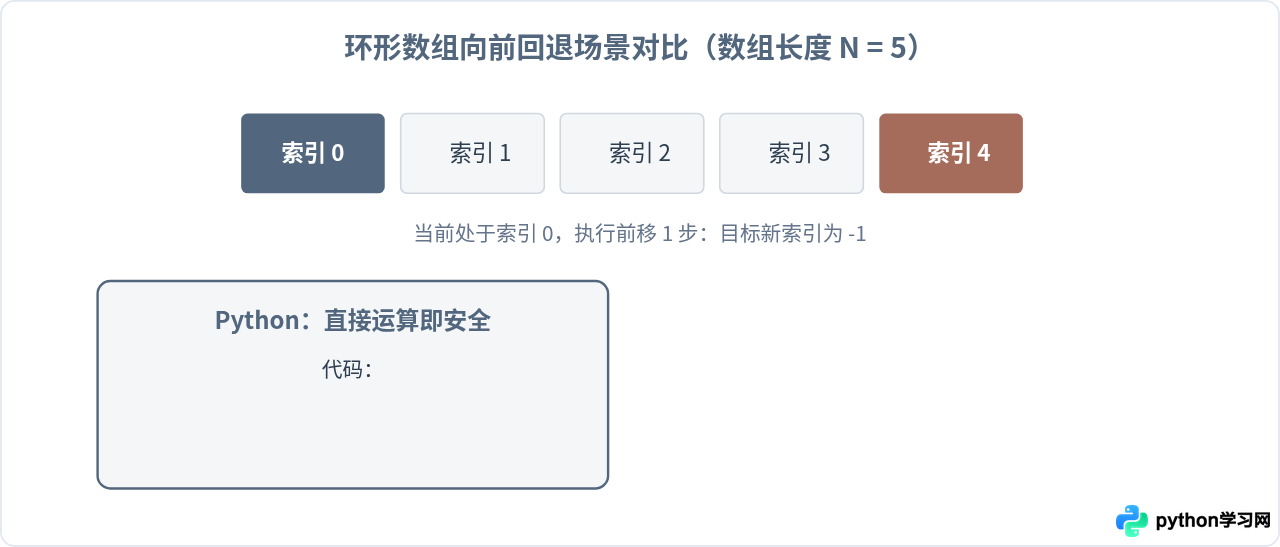
如前文图3所示,在维护一个容量为 N 的环形缓冲区时,向前移动 k 步如果直接写成 (curr - k) % N,在 C/Java 中就会产生负索引,导致崩溃。为此,各语言提供了标准库工具或经典公式:
- Java 8+ 推荐写法:使用
Math.floorMod(curr - k, N),它在底层实现了 Python 风格的地板取模。 - C/C++ 通用写法:采用“加模再取模”技巧:
((curr - k) % N + N) % N。 - Python 模拟 C 风格取模:如果 Python 需要与底层 C 库完全对齐余数符号,应调用
math.fmod(a, d)。
五、总结
负数取模在 Python 与 C/Java 中的结果差异,根源在于整数除法对商的取整策略:
- Python 选择了数学优美性:采用向下取整的地板除,余数符号与除数一致,更符合模算术的周期性和数学期望。
- C 与 Java 选择了硬件直觉性:采用向零截断的除法,余数符号与被除数一致,保持了对称性
(-a)/b == -(a/b),并与 CPU 底层指令行为相吻合。
理解这两种哲学的异同后,在编写算法时遇到涉及负数的奇偶校验、哈希散列分桶以及环形边界计算,就能准确预判边界行为并写出跨语言健壮的高质量代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















