


Python脚本文件与.ipynb笔记本文件有什么区别
深入对比Python脚本文件(.py)与Jupyter笔记本文件(.ipynb)的核心区别,涵盖底层存储格式、运行生命周期、工具链生态、协同工作流以及选型实践。
.py 脚本文件与 .ipynb 笔记本文件分别代表了“工程化执行”与“探索性计算”两种截然不同的工作模式。简单来说,.py 文件是纯文本源码,由解释器自顶向下线性批处理执行,适合模块封装、自动化流水线以及生产部署;而 .ipynb(Jupyter Notebook)底层是一个结构化 JSON 文档,将代码拆分为多个可独立按需运行的交互式单元格,并在代码下方即时呈现富文本、数据表格与可视化图表,专为数据科学探索、算法实验调优及教学演示而设计。
一、底层存储结构与文件构成机制
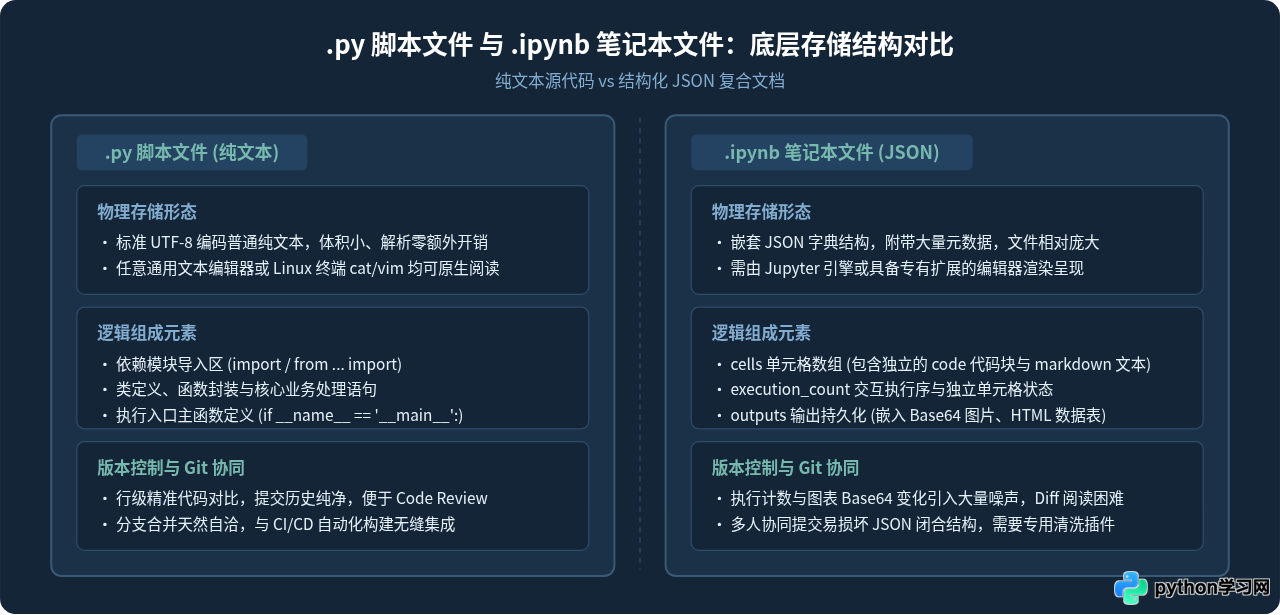
初学者在编辑器中双击打开文件时,看到的往往是界面渲染后的代码高亮。然而从文件系统和物理存储的底层来看,两种文件的组织方式有着根本性的区别。
.py 脚本文件本质上是标准的 UTF-8 编码普通文本文件。它的内容完全由符合 Python 语法规范的代码字符组成,没有附加任何专有包装。我们可以使用任何通用文本编辑器(如 VS Code、Sublime Text,甚至系统的纯文本记事本)直接阅读或编辑它。它的逻辑层级完全依赖 Python 的语法规则(如缩进、函数声明与模块导入)自发体现,体积极为轻巧。
.ipynb 笔记本文件全称为 IPython Notebook 文件。虽然其后缀名为 .ipynb,但其真实格式是一个遵循严格模式定义的 JSON 树状文本。若在纯文本编辑器中不加渲染地直接打开它,便会发现它由若干核心字段构成:
cells数组:包含了全部单元格对象。每个单元格明确标识其类型(code代码块或markdown文本块)、源代码行数组,以及该单元格专属的元数据。execution_count:记录该代码单元格最近一次在内核中被执行的计数序号。outputs数组:用于持久化保存单元格执行后产生的所有结果。这里不仅保存控制台文本输出,还会将 Matplotlib 等工具生成的图像直接转码为庞大的 Base64 字符串嵌入其中。metadata与nbformat:记录所绑定的 Python 内核版本、语言规范与 Notebook 架构版本号。
这种存储差异直接决定了版本控制(Git)的工作体验。在 Git 仓库中,修改 .py 文件的某一行,产生的 Diff 记录清晰聚焦于该行代码;而修改并运行一个 .ipynb 文件,即使逻辑代码未变,执行序号的递增以及图表输出重新渲染生成的 Base64 差量,也会引发动辄数百行的元数据变更噪点,给团队多人分支合并(Merge)带来显著的冲突解决成本。
二、运行时执行机制与状态生命周期
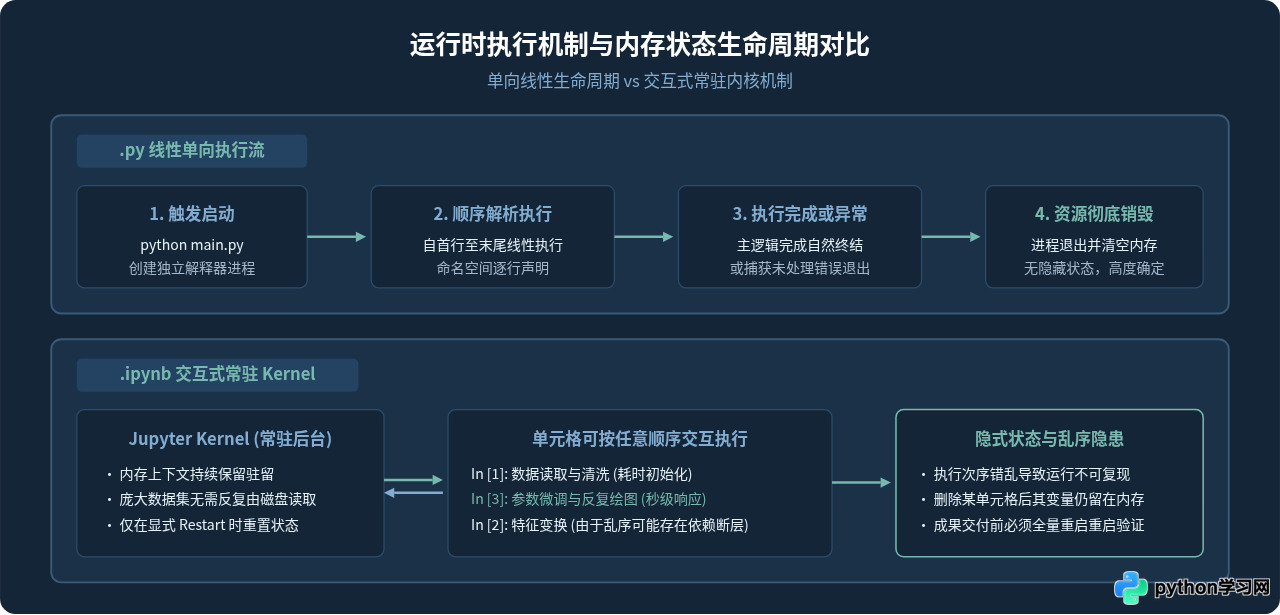
两者在计算机内存中的生命周期与运行控制机制存在根本性分歧。这直接影响了代码的调试方式与执行结果的确定性。
1. Python 脚本的线性确定性执行
当我们在命令行中执行 python script.py 时,操作系统会为其创建一个全新的 Python 解释器进程。程序从文件的第一行代码开始,自顶向下严格线性推进:
# process_data.py
import pandas as pd

raw_data = pd.read_csv("dataset.csv")
cleaned_data = raw_data.dropna()
cleaned_data.to_csv("result.csv", index=False)
print("处理完成")
在执行过程中,全局变量与作用域对象按照代码顺序逐一创建。一旦所有代码执行完毕,或者在某个中间环节抛出了未捕获的异常导致中断,Python 进程便会立即终止。所有被分配的内存对象、中间变量由系统垃圾回收机制统一清理,不会保留任何驻留状态。下一次运行脚本时,系统依然从第一行全新构建,执行结果完全具备确定性与可复现性。
2. Jupyter Notebook 的交互式内核与常驻状态
与纯脚本的一次性生命周期不同,Jupyter 的核心在于后台常驻的计算内核(例如 ipykernel)。在用户打开并连接到 Notebook 时,内核进程就已经处于持续运行中。
用户可以通过快捷键按需运行任意一个单元格(Cell)。所有运行过的单元格共享同一个全局命名空间。例如,在第一个单元格中加载了一个 10GB 的数据集,这个数据集会一直停留在内存中;随后用户在第二个单元格中尝试不同的数据过滤算法,只需反复点击执行第二个单元格,而不需要重新经历耗时的数据读取阶段。这种即时反馈特性是其在数据分析领域大受欢迎的核心原因。
然而,常驻状态也带来了著名的无序执行陷阱(Out-of-order Execution)。在 Notebook 中,代码执行的真实先后次序取决于用户的点击顺序,而非单元格在页面中的上下排列:
- 若先运行下方的 Cell B 改变了变量
status = "ready",再向上运行 Cell A 打印status,输出将依赖于刚才的修改。 - 单元格左侧的标签(如
In [1],In [5])标明了真实的执行次序。当次序错乱或某些单元格被删除后,内存中仍旧残留着旧变量。这经常导致作者本人运行正常,但当将文件分享给他人从头执行时却报出NameError或计算结果不一致。
三、工程化工具链与调试生态的差异
一个项目的推进通常分为“概念探索”与“系统落地”两个阶段。不同的文件类型在工程化工具链中的待遇大不相同。
1. 静态分析、重构与单元测试
现代软件工程严重依赖静态代码分析与重构工具。对于 .py 脚本:
- IDE(如 PyCharm、VS Code)能够进行毫秒级的类型推导、未引用变量警告、作用域跨文件跳转与重命名重构。
- 可以使用
flake8、ruff、black等工具统一代码格式与静态规范。 - 单元测试框架(如
pytest、unittest)可以自动检索所有测试文件并批量断言,便于集成进持续集成系统(CI)。
而对于 .ipynb 文件,大多数静态检查工具无法直接对 JSON 内部的代码片段生效(虽然有特定插件包装,但体验和速度明显受限)。此外,在常规开发中,无法通过标准的 import my_analysis.ipynb 直接引入另一个 Notebook 中定义的函数,这极大地阻碍了代码的模块化复用。
2. 调试模式与定位方式
在 .py 脚本中,开发者通常在代码行设置标准断点,借助 IDE 调试器进行单步步入(Step Into)、逐行步过(Step Over)以及检查调用栈帧(Call Stack)。
在 .ipynb 中,开发者最常用的“调试”方式是在新单元格中临时写一行 df.info() 或 print(var) 查看当前内存状态。虽然交互直观,但面对深层递归或复杂类层次结构时,缺乏完整的调用栈追踪工具。
四、从原型探索到工程落地的规范重构步骤
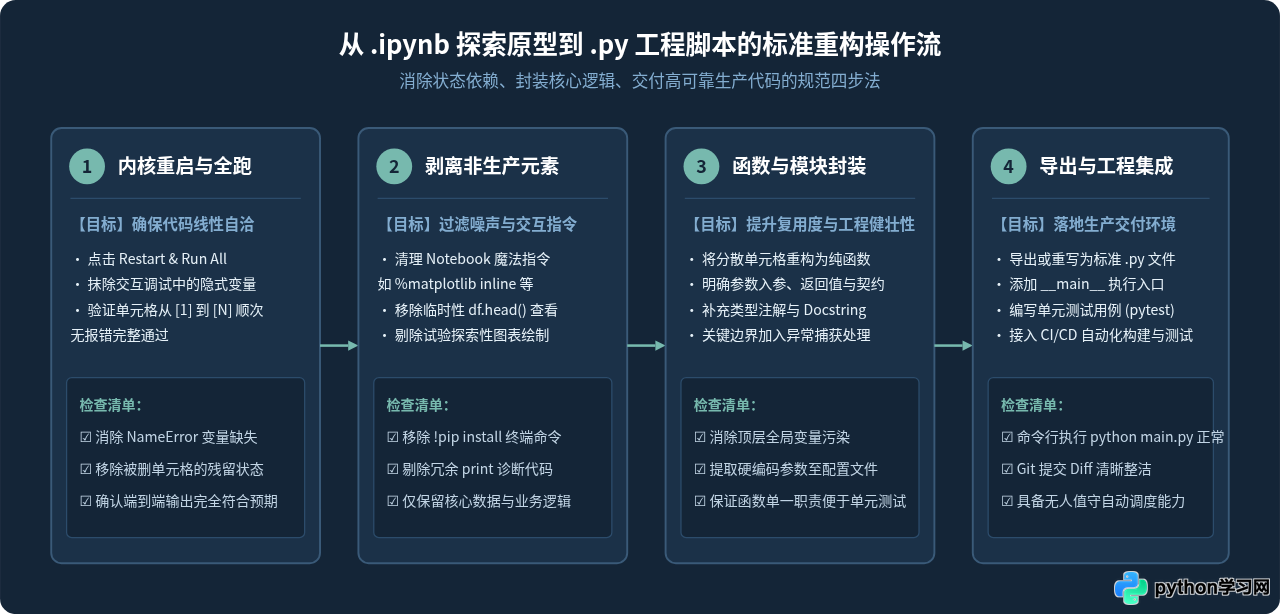
在数据科学与机器学习实践中,普遍的工作范式是:先在 Notebook 中完成探索与验证,再将其重构成 Python 脚本以进入生产流水线。完成这一过程需要遵循清晰的重构步骤。
详细操作步骤说明
-
第一步:重启内核并依序全量执行(Restart & Run All)
在 Jupyter 界面中点击菜单栏的Kernel -> Restart & Run All。这一步能够彻底清空后台常驻内存,确保所有代码能自第 1 个单元格无中断地线性执行至末尾,消除任何依赖于特定手动点击顺序产生的假象。 -
第二步:剔除非生产与交互指令
移除所有的 IPython 魔法命令(例如%matplotlib inline、%timeit)以及直接调用 shell 的行(如!pip install ...)。同时删除用于中间过程肉眼观察的df.head()、交互控件或临时绘图代码。 -
第三步:将松散代码封装为纯函数与模块
避免在顶层作用域留下大量裸露的全局变量。将数据处理、特征提取、模型训练等逻辑封装为具备明确入参与返回值的函数。为核心函数加上 Python 类型提示(Type Hints),并提取数据库连接串、文件路径等硬编码内容至专门的配置文件或环境变量中。 -
第四步:沉淀至 .py 文件并配置主入口
新建标准.py文件(或通过jupyter nbconvert --to script notebook.ipynb导出后整理)。在文件底部定义标准入口:
最后在终端环境下使用if __name__ == "__main__": # 解析命令行参数并调用业务函数 run_pipeline()python main.py验证无界面执行结果。
五、场景选型决策与“双轨协同”实践
了解了两者的技术本质后,在日常工作中何时选用哪种文件,可以通过以下明确的场景边界进行判断。
| 对比维度 | .py 脚本文件 | .ipynb 笔记本文件 |
|---|---|---|
| 核心设计定位 | 工程化逻辑实现、自动化流水线、系统组件 | 交互式探索试验、数据分析、教学呈现 |
| 底层数据格式 | 纯文本(UTF-8 字符源码) | JSON 复合树(集成代码、Markdown 与 Base64 输出) |
| 运行时状态 | 单次运行,结束后内存销毁,无状态残留 | 常驻后台内核(Kernel),各单元格共享交互状态 |
| 执行顺序保证 | 严格自顶向下线性批处理 | 由使用者手动按需触发单元格,可能存在乱序 |
| 版本控制协同 | Git diff 极其精确,便于合并审查 | 执行计数与图表 Base64 带来大量噪点,易冲突 |
| 工程工具支持 | 深度支持静态类型分析、自动重构与单元测试 | 重在快速打印、内联图表查看与变量检查器 |
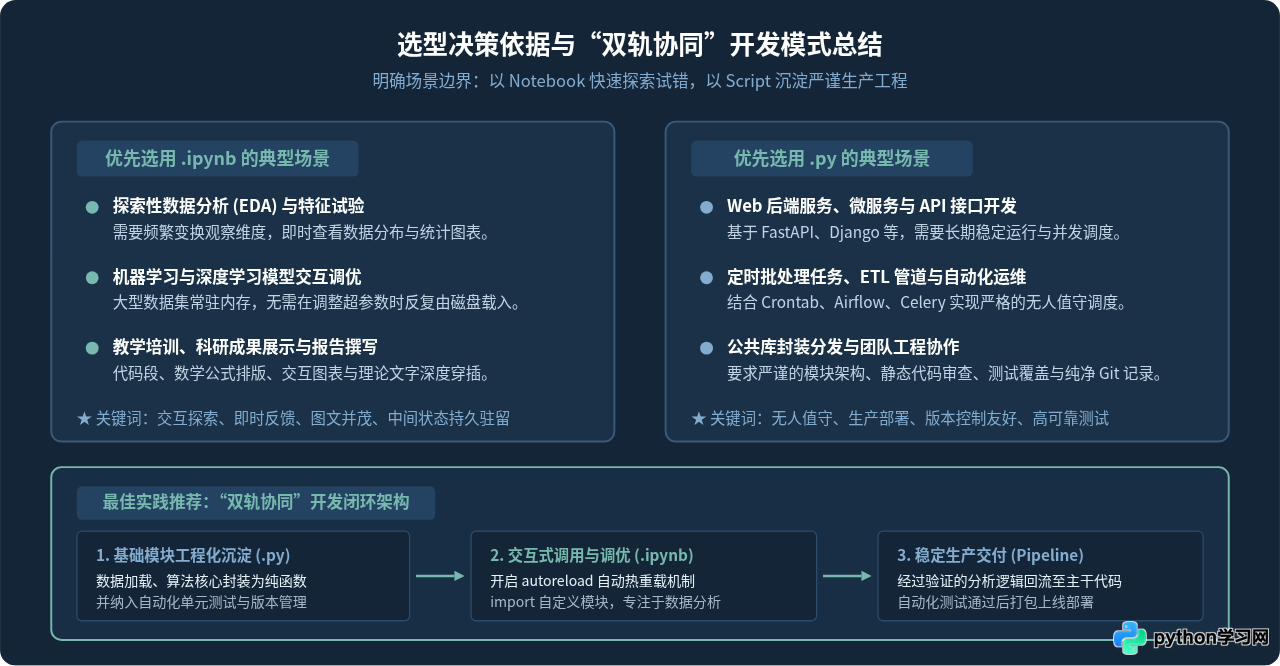
工业界推荐的“双轨协同”开发模式
成熟的工程团队通常不会在两者之间做排他性选择,而是采用相互配合的协同模式:
-
核心逻辑沉淀在
.py模块中:将通用的数据解析、特征工程、数据库读写、模型结构定义等封装在项目根目录或子包的.py文件内。这样能够享受到完整的 Git 版本审查、Lint 规范检测以及单元测试覆盖。 -
在
.ipynb中仅作为高层调用与实验入口:在 Notebook 的首个单元格中配置 IPython 的模块自动重载扩展:
如此一来,开发者既能随时在外部编辑器中修改%load_ext autoreload %autoreload 2 from src.features import extract_user_features from src.models import train_baseline # 在 Notebook 中直接调用并观察可视化输出 features = extract_user_features(df).py文件并获得即时生效,又能在 Notebook 中利用保留的内存数据进行极速的可视化交互探查,兼顾了探索效率与工程严谨性。
六、高频疑问与实践避坑指南
Q1: 如何在无图形界面的远程 Linux 服务器上运行 .ipynb?
如果远程生产环境没有安装桌面环境或不便开放 Jupyter Web 端口,可以通过官方转换工具将其快速转为纯脚本执行:
# 快速将 notebook 转换为同名 .py 脚本
jupyter nbconvert --to script analysis.ipynb

# 在终端或后台执行生成的脚本
python analysis.py
若确实需要保留 Notebook 的执行输出并保留图表记录,可以使用 papermill 工具,它支持在命令行环境下对 .ipynb 进行参数化注入与端到端无人值守运行:
# 参数化执行并将运行结果写出为 output.ipynb
papermill analysis.ipynb output.ipynb -p batch_size 64 -p learning_rate 0.01
Q2: Git 协同中如何避免 .ipynb 文件带来的海量冲突?
解决 Notebook 版本控制难题最有效的方法是在提交前清空输出:
- 提交前手动清除输出:在 Jupyter 菜单栏选择
Cell -> All Output -> Clear后再保存并提交代码。 - 使用 Git 预提交钩子(Pre-commit hook):安装
nbstripout工具。只需在本地仓库执行nbstripout --install,Git 在执行git commit时会自动剥离 Notebook 中的单元格运行计数与图片 Base64 数据,使版本库中仅留存干净的代码文本。
Q3: 为什么企业生产环境中通常不建议直接调度 .ipynb?
直接在生产服务中使用 Notebook 存在显著隐患:首先,Notebook 缺乏标准的微服务健康监控与错误告警机制;其次,其内部隐藏的状态与变量生命周期难以保证幂等性;最后,容器化构建与资源释放机制在常驻 Kernel 架构下容易引起内存泄漏或显存锁定。因此,将经过验证的代码固化为 .py 脚本,配合 Airflow 或 Docker 进行标准容器化调度,是保障生产稳定性的通用行业规范。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















