


Python三元表达式与if-else语句对比:何时使用更简洁?
深入对比Python中的三元表达式与传统if-else语句,解析两者的本质差异、短路求值机制、适用场景与可读性边界,提供明确的代码选型与重构指南。
在编写Python代码时,我们经常需要根据某个条件的真假来决定变量的取值。核心的解决路径通常有两种:传统的四行if-else控制流语句,或者单行的三元表达式(官方称为条件表达式,Conditional Expression)。许多初学者容易走入两个极端,要么对三元表达式敬而远之,全篇充斥着机械冗长的多行判断;要么盲目追求“单行化”,把多重嵌套与复杂计算强塞进三元表达式中,破坏了代码的可读性。本文将直接对比这两种写法的机制差异,明确划定清晰的适用边界,帮助你在实际开发中写出既简洁又健壮的代码。
一、核心本质差异:语句与表达式
要准确判断何时使用三元表达式,首先必须理解它与标准if-else在语法层面的本质区别:语句(Statement)与表达式(Expression)的分立。
标准if-else属于控制流语句。它的主要职责是组织代码块的执行路径,自身没有返回值,因此不能作为赋值运算符右侧的操作数,也不能直接作为参数嵌入到函数调用或列表推导式内部:
# 标准 if-else 语句:必须拆分为多行,通过赋值语句间接接收结果
if score >= 60:
    result = "及格"
else:
    result = "不及格"
而在 Python 2.5 引入的三元表达式(语法形式为 X if C else Y)属于表达式。它的核心特征在于“必然产生一个计算结果并返回”,可以直接放置在任何需要数据值的地方:
# 三元表达式:直接计算并返回结果,赋给目标变量
result = "及格" if score >= 60 else "不及格"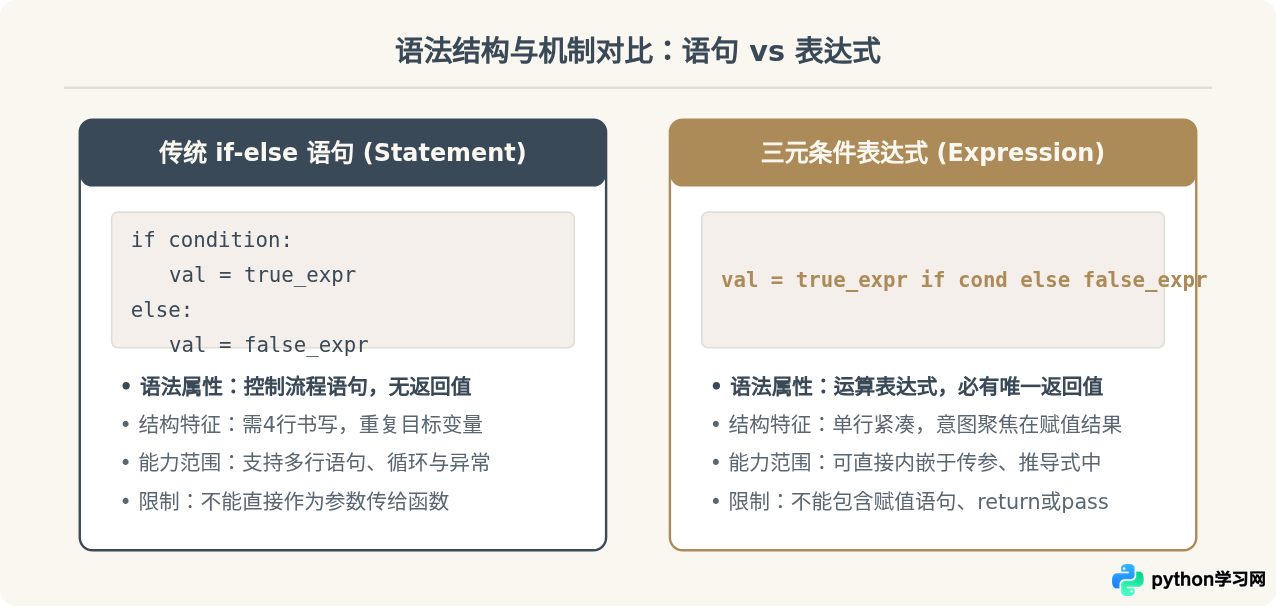
二、推导机制:求值顺序与短路特性
阅读和理解三元表达式时,最常见的误区是误以为程序会按从左到右的文字物理顺序执行。实际上,Python在执行 X if C else Y 时,有着严格且固定的求值推导顺序:
- 优先求值条件
C:解释器首先计算位于中间的条件判断表达式。 - 短路求值与分支隔离:
- 若
C为真(True),则只对X求值并作为整个表达式的结果,右侧的Y表达式完全被跳过,根本不会被执行; - 若
C为假(False),则只对Y求值并作为最终结果,左侧的X同样完全被忽略。
- 若
这种短路求值机制是三元表达式能够安全使用的基石。例如在避免“除零错误”或“空指针解引用”时,未被选中的分支不会触发异常:
# 安全计算比例:当 count 为 0 时直接返回 0,绝不会触发 ZeroDivisionError
ratio = total / count if count != 0 else 0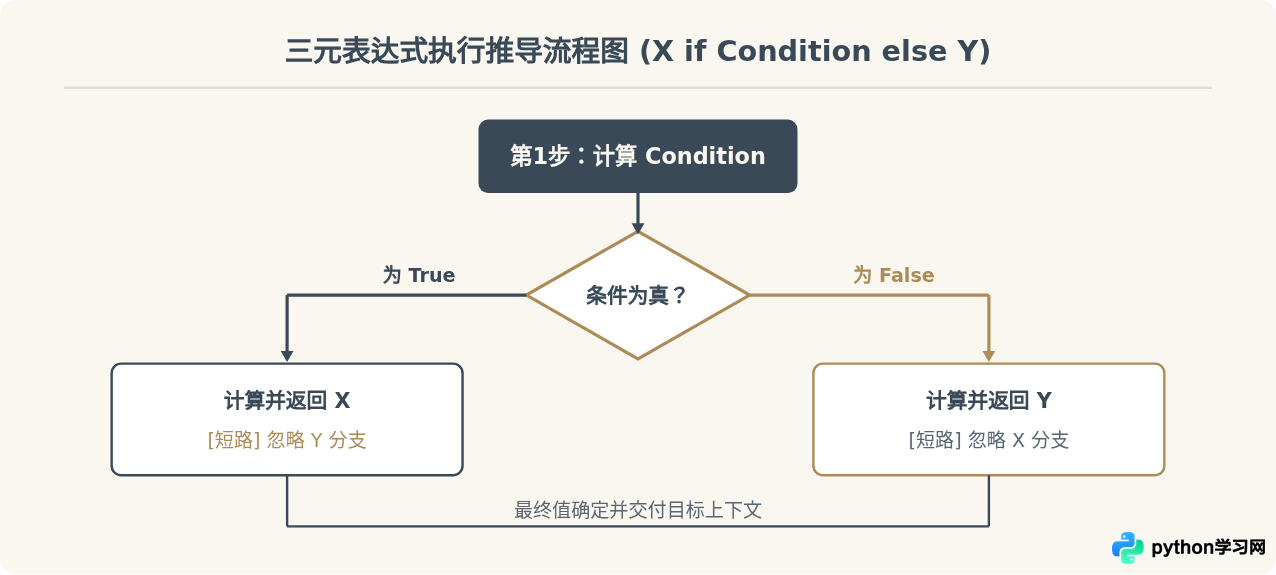
三、典型应用场景:何时使用更简洁?
“简洁”不仅意味着代码行数的减少,更代表读者能以更低的心智负担捕捉代码意图。在以下四个具体场景中,三元表达式的表现显著优于传统if-else。
1. 单一变量的二选一赋值
当目标仅仅是根据一个清晰条件给某一个变量赋予初值时,三元表达式能消除冗余的目标变量名重复,让读者的视线直接聚焦于赋值逻辑:
# 传统 if-else:status 出现了两次,结构松散
if is_active:
    status = "running"
else:
    status = "stopped"

# 优雅的三元表达式:紧凑直观
status = "running" if is_active else "stopped"
2. 函数参数的内联计算
当函数调用需要根据外部状态传入不同的实参时,使用三元表达式可以避免在调用前生硬地定义临时变量:
# 传统方式:为了传参不得不引入一个中间变量
if user.is_vip:
    discount = 0.8
else:
    discount = 1.0
order.calculate_price(discount)

# 三元表达式:直接内联传参,意图清晰连贯
order.calculate_price(0.8 if user.is_vip else 1.0)
3. 推导式中的数据转换与映射
在列表推导式、字典推导式或生成器中,如果需要对每一个元素做二元转换,三元表达式是唯一优雅的解决方案。注意区分推导式中三元表达式(负责转换)与尾部if(负责筛选)的位置差异:
scores = [85, 42, 78, 59, 93]

# 转换映射:及格标为 PASS,不及格标为 FAIL(置于 for 之前)
labels = ["PASS" if s >= 60 else "FAIL" for s in scores]
# 输出结果: ['PASS', 'FAIL', 'PASS', 'FAIL', 'PASS']

# 对比:尾部 if 仅用于过滤元素(只保留及格分)
passed_scores = [s for s in scores if s >= 60]
4. 简单属性默认值回退与展示格式化
在数据展示层,当数据为空或未指定时回退到默认占位符,三元表达式极为贴切:
display_name = user.nickname if user.nickname else "匿名用户"
plural_label = f"{count} items" if count > 1 else f"{count} item"
四、可读性边界:何时坚决退回 if-else?
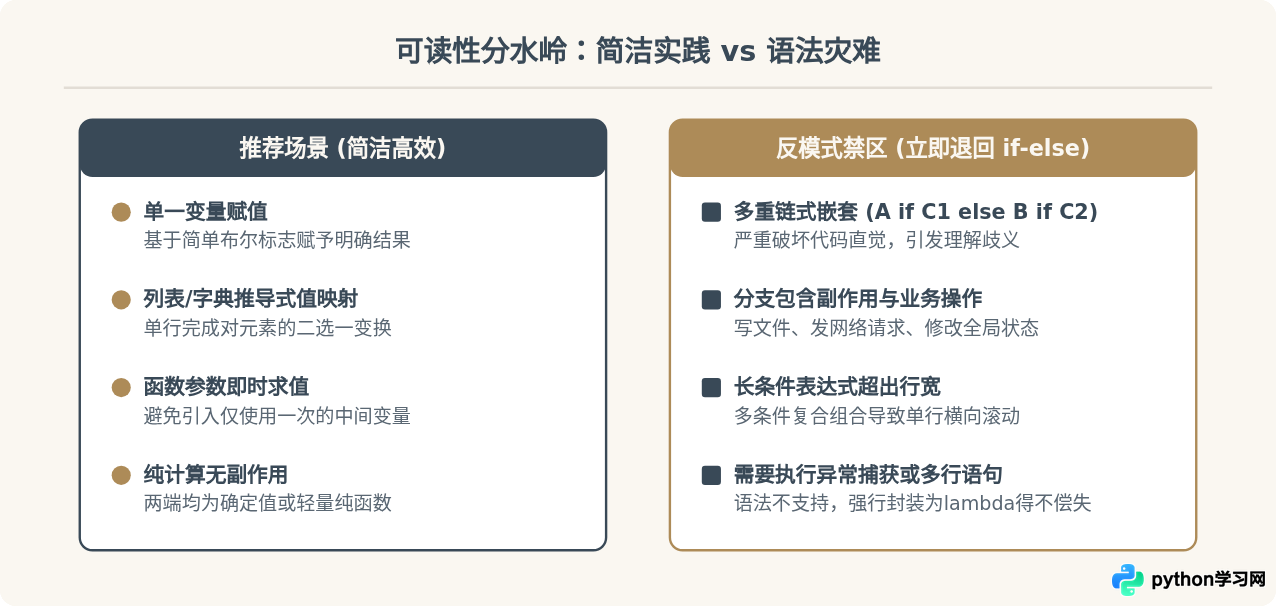
简洁的代码一旦失去节制,就会迅速沦为“语法杂耍”。当遇到以下三种情况时,强行使用三元表达式反而会严重损害代码质量,必须退回传统的if-else。
Python允许将三元表达式连缀成形如 A if C1 else B if C2 else D 的多层结构。这种语法合法但极其难以扫读,破坏了从上至下的视觉认知流,是典型的不良代码坏味道。
# 糟糕的坏味道:多重嵌套三元表达式(切勿在生产环境这样写)
grade = "优秀" if score >= 90 else "良好" if score >= 80 else "及格" if score >= 60 else "不及格"

# 正确做法:退回 elif 结构或使用字典映射,层次分明
if score >= 90:
    grade = "优秀"
elif score >= 80:
    grade = "良好"
elif score >= 60:
    grade = "及格"
else:
    grade = "不及格"
除嵌套之外,还有两个明确的退回边界:
- 包含副作用(Side-effects)的操作:如果分支内需要打印日志、写入数据库、抛出异常或修改对象内部状态,说明这是一段“控制流”,而非纯粹的“取值运算”。三元表达式禁止包含
print()以外的语句级逻辑。 - 条件或表达式过于冗长:如果条件判断需要跨越多个逻辑操作符(例如包含三四个
and/or组合),强行塞在单行内会导致行宽超标,此时将其拆解为带注释的多行if-else更易于维护。
五、选型总结:决策清单与速查矩阵
为了在实际编码时迅速做出选择,我们可以将考量维度提炼为一张清晰的决策对照表:
| 考量维度 | 三元表达式 (X if C else Y) | 标准 if-else 语句 |
|---|---|---|
| 语法类型 | 表达式(产生返回值) | 控制流语句(无返回值) |
| 最佳适用目标 | 单个变量的计算与赋值 | 控制程序执行走向与多步操作 |
| 分支复杂度 | 仅限严格的二元分支(True / False) | 支持任意数量的 elif 与复杂条件 |
| 嵌套支持度 | 语法支持但强烈不推荐(破坏可读性) | 推荐(结构清晰、缩进层次鲜明) |
| 推导式兼容性 | 完美支持,常用于元素映射 | 无法在推导式内部直接使用 |
| 副作用控制 | 应保持纯粹计算,避免副作用 | 适合承载日志、IO、异常处理等副作用 |
在面对具体的重构抉择时,可以直接遵循以下三步选型决策流:
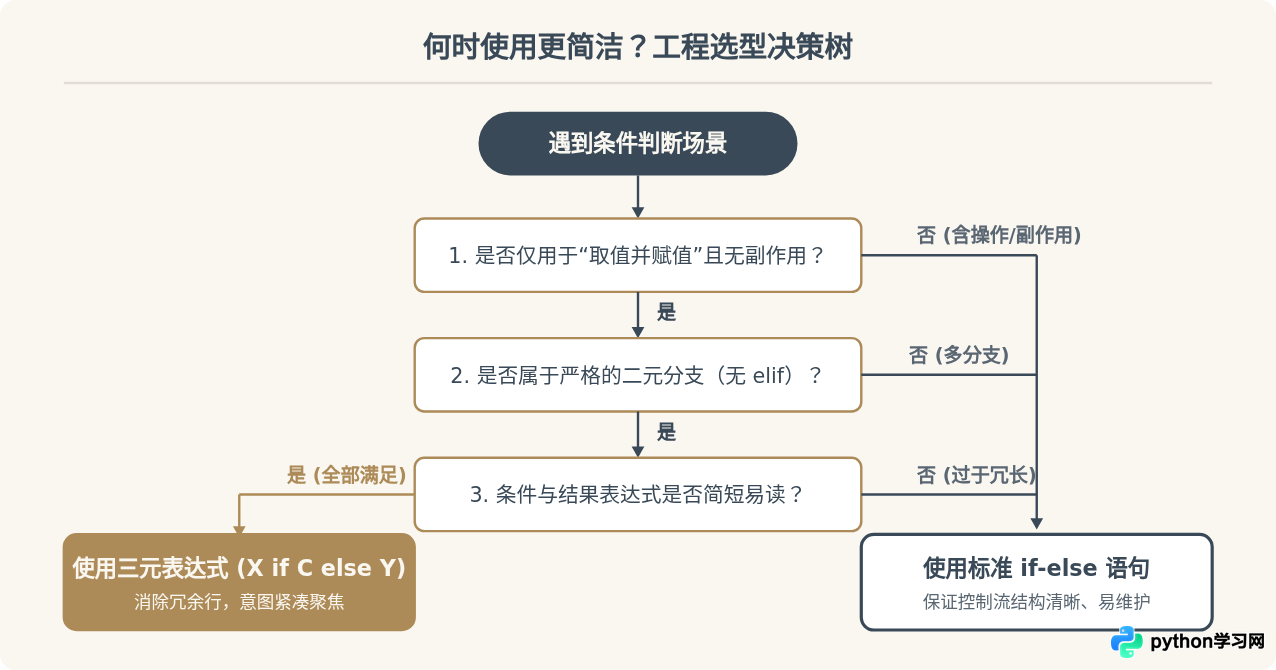
代码的“简洁”从来不是行数的绝对精简,而是信息表达效率与心智读取成本的平衡。在简单的二元数据赋值与推导式转换中,果断采用三元表达式能够让业务主干更加突出;而在涉及多分支、副作用或长逻辑链条的场景下,坦然使用多行if-else才是保障工程长期可维护性的成熟选择。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















