


Python中文注释乱码怎么办?文件编码声明详解
深入解析Python中文注释报错与乱码的根本原因,详细讲解PEP 263文件编码声明规范、编辑器UTF-8配置以及Python 2与Python 3的编码差异与解决步骤。
当在 Python 源码中写入中文注释或中文字符串时,若程序抛出 SyntaxError: Non-ASCII character 错误或在终端显示为乱序字符,根本原因在于文件实际保存的字节编码与Python 解释器预期的源码解码规则不匹配。解决该问题只需两步:首先确保编辑器将文件以 UTF-8 编码保存,然后在脚本前两行添加符合 PEP 263 规范的文件编码声明 # -*- coding: utf-8 -*-。本文将系统拆解其底层机理与标准操作细节。
一、为什么中文注释会导致报错与乱码?
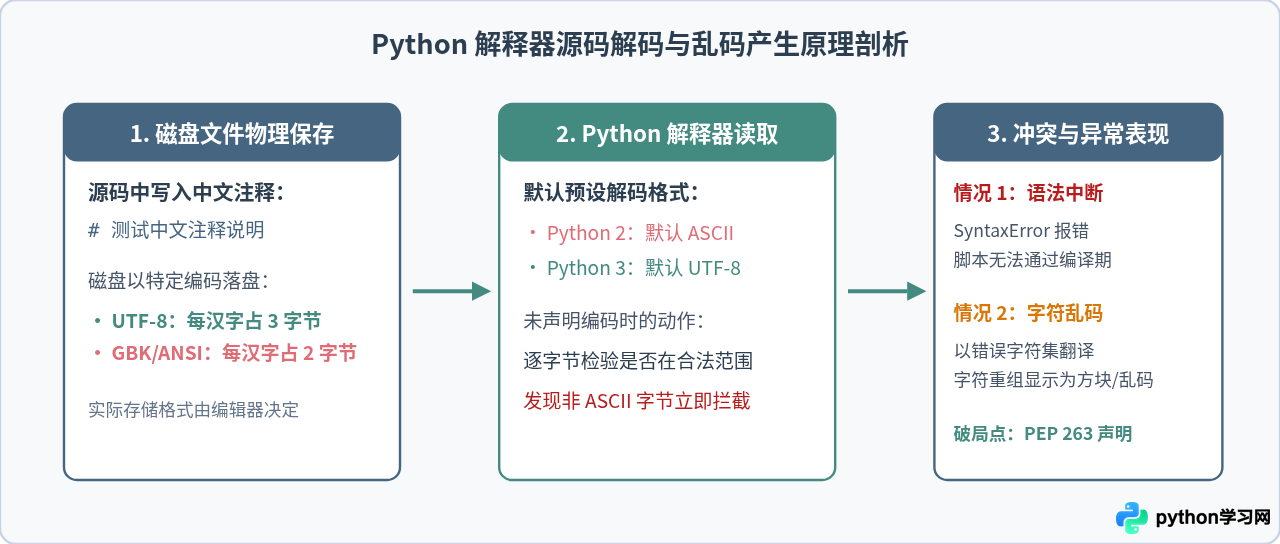
计算机在磁盘上保存文本文件时,本质上都是由十六进制字节(Byte)构成的二进制序列。当 Python 解释器启动并读取 .py 脚本时,它需要使用某种字符编码规则将这些物理字节重新翻译为内存中的字符。
在不同版本的 Python 中,默认的源文件解码器有着严格的设定:
- Python 2 环境:默认的源码文件编码设定为 ASCII。ASCII 编码仅定义了 0 到 127 范围内的 128 个基本英文字符及控制符。由于中文字符的字节值均大于 127,一旦 Python 2 解释器在源码中扫描到中文字符(无论写在代码逻辑中还是写在
#注释后面),都会立即中断执行并抛出语法错误:SyntaxError: Non-ASCII character '\xe4' in file ... but no encoding declared。 - Python 3 环境:官方已将源文件的默认编码全面升级为 UTF-8。如果源码文件本身以 UTF-8 格式保存,且运行环境正常,直接写中文注释并不会报错。但若开发环境或老旧编辑器(如部分 Windows 下的记事本或 IDE)默认将文件以 ANSI / GBK / CP936 格式写入磁盘,Python 3 的 UTF-8 解释器便会因无法正确识别多字节序列而抛出
SyntaxError: (unicode error) 'utf-8' codec can't decode byte ...。 - 终端渲染环境不一致:即使代码文件本身正确解析执行,如果程序
print输出中文字符串,而宿主命令行终端(如 Windows CMD 默认代码页 936)与输出流编码不一致,也会出现屏幕上显示问号、黑块或乱码的现象。
二、核心规范:PEP 263 文件编码声明详解
为了解决源文件中非 ASCII 字符的解析标准问题,Python 官方早在 Python 2.3 版本便制定了 PEP 263(Defining Python Source Code Encodings) 规范。该规范定义了一种特殊的“魔法注释”(Magic Comment),允许开发者在源码最上方明确告知解释器:“本文件是用何种字符集编码的”。
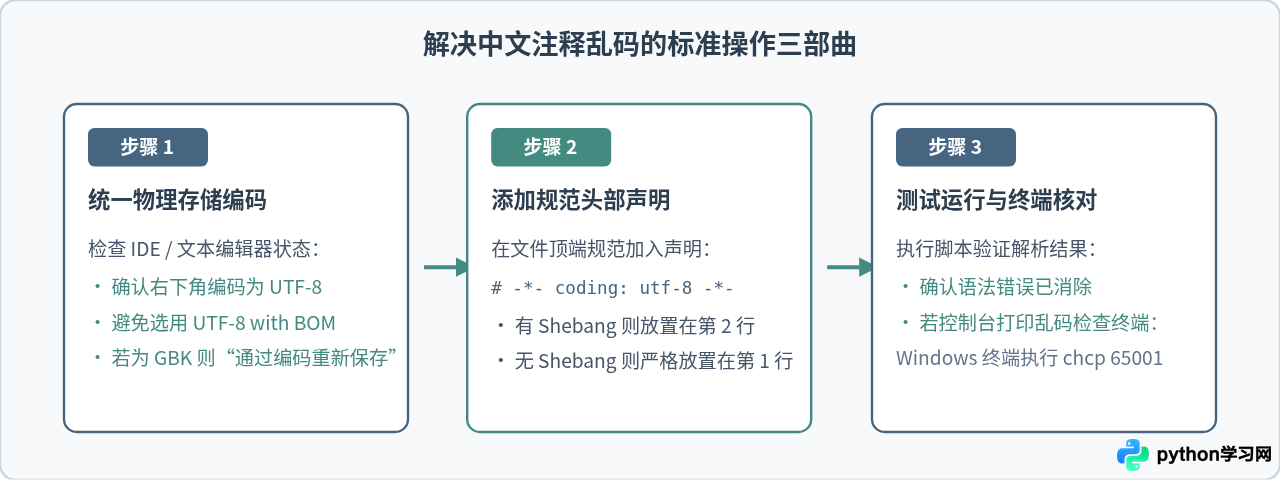
1. 标准语法与推荐写法
PEP 263 规定解释器在读取文件前两行时,会通过正则表达式 coding[=:]\s*([-\w.]+) 进行匹配。因此,以下几种写法均属于合法声明:
# -*- coding: utf-8 -*-# coding=utf-8# coding: utf-8在主流开发实践中,最推荐使用的是 # -*- coding: utf-8 -*-。两端的 -*- 源自 Emacs 和 Vim 等经典编辑器的模式标记语法,兼具极佳的工具兼容性与视觉辨识度。
2. 声明的放置位置要求(极其严格)
编码声明必须严格位于脚本的第一行或第二行。解释器为了性能考虑,不会扫描整份代码,仅在读取前两行时完成编码器的绑定。如果放置在第三行或更靠后的位置,声明将彻底失效,视作普通注释。
- 若脚本无 Shebang 解释器路径:直接放在第一行:
# -*- coding: utf-8 -*- # 这是一个计算圆面积的工具函数 import math - 若脚本包含 Shebang 行(Linux/macOS 可执行脚本):Shebang 必须独占第一行,编码声明紧随其后放在第二行:
#!/usr/bin/env python
# -*- coding: utf-8 -*-
# 系统维护自动化调度脚本
import sys
避坑提示:在编码声明之前,绝不能出现任何包含非 ASCII 字符的注释或空行。若第一行为中文注释,即便第二行补上 # coding: utf-8,解释器在解析第一行时就已经触发异常了。
三、核心误区:编码声明与实际保存编码的配合
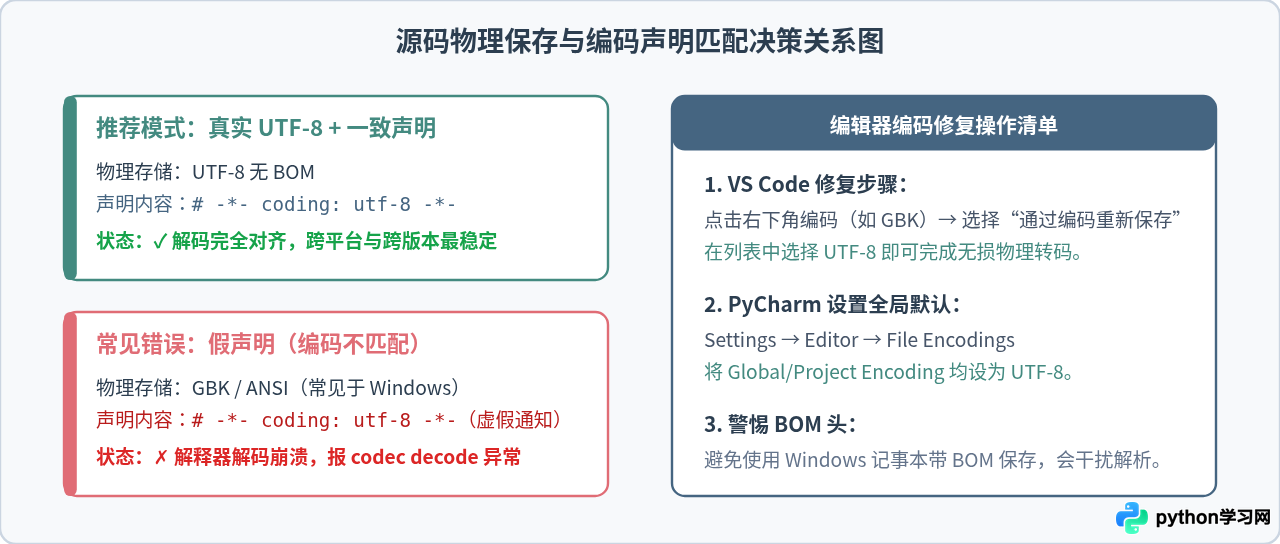
在实际排查中,许多初学者最容易产生的一个误解是:以为在文件头写了 # coding: utf-8,这个文件就自动变成了 UTF-8 编码。
事实并非如此。PEP 263 声明仅仅是一份单向通知,它向解释器指明“请以 UTF-8 的规则来阅读这个文件”。如果文件在硬盘上实际是由 GBK 或 ANSI 编码保存的,而头部却硬性声明了 utf-8,解释器强行按照 UTF-8 解码非法的双字节序列,反而会引发更顽固的解码异常。这就是所谓的“假声明冲突”。
| 文件物理存储编码 | 头部编码声明 | 解释器解析行为 | 实际运行结果 |
|---|---|---|---|
| UTF-8(无 BOM) | # -*- coding: utf-8 -*- |
按 UTF-8 读取真实 UTF-8 字节 | 完全正常,无报错与乱码 |
| GBK / CP936 | # -*- coding: utf-8 -*- |
以 UTF-8 解码 GBK 编码的汉字 | 报错 SyntaxError: (unicode error) |
| UTF-8 | 无任何声明(Python 2) | 默认按 7-bit ASCII 解码 | 报错 Non-ASCII character |
| UTF-8 | 无任何声明(Python 3) | 默认按 UTF-8 解码 | 正常运行(Python 3 默认规范) |
| GBK / CP936 | # -*- coding: gbk -*- |
按 GBK 规则正确解析该源码 | 可运行,但不推荐跨平台项目 |
四、Python 2 与 Python 3 的编码机制差异
理解 Python 字符串在不同版本中的本质演变,有助于从根本上掌握编码声明的作用范畴:
- Python 2 的双轨字符串模型:
Python 2 中存在两种字符串类型:
str(实际存储为原始字节序列)与unicode(存储为解码后的 Unicode 字符点)。若要显式创建 Unicode 字符串,必须加上前缀u"中文字符"。由于 Python 2 默认源编码是 ASCII,只要源码中出现非 ASCII 字符,就强制要求在头部显式声明编码;否则不仅中文注释无法通过解析,包含中文的字符串字面量也会使程序直接崩溃。 - Python 3 的全新架构:
Python 3 彻底重构了字符串体系:普通的
str原生就是 Unicode 字符序列,而原始二进制数据由专门的bytes类型处理。同时,PEP 3120 正式规定 UTF-8 为 Python 3 源码的默认编码。这意味着:只要开发者的源文件是以标准的 UTF-8 格式存储的,即使在第一行完全不写# -*- coding: utf-8 -*-,包含中文注释和中文字符串的代码也能够直接流畅执行。 - 现代开发中是否还需要写编码声明?
若团队或项目明确仅运行在 Python 3(例如 Python 3.8+),并且开发团队已在项目规范中通过
.editorconfig统一将所有文件锁死为 UTF-8 编码,则可以省略此行。但对于需要兼容旧环境、需要向开源社区交付通用模块,或公司内存在混合环境的工程,保留首行# -*- coding: utf-8 -*-依然是防御性编程的稳妥习惯。
五、常见衍生问题与排查指南
1. 为什么代码正常执行了,但 print 打印在 CMD 窗口中依然是乱码?
请注意区分“源码解析错误”与“终端显示乱码”:
- 若程序在第一行就报错终止,属于源码文件编码未识别,需要靠本文所述的 PEP 263 声明或编辑器转码解决。
- 若程序顺利执行完毕,但输出的文字变成
锟斤拷、乱码拼音或问号,属于终端输出流代码页不匹配。在 Windows CMD 默认代码页为 936(GBK)时,打印 UTF-8 字符流可能发生乱码。可在运行脚本前先执行chcp 65001命令切换终端至 UTF-8,或在 Python 3.7+ 中使用sys.stdout.reconfigure(encoding='utf-8')调整输出流编码。
2. 什么是 UTF-8 BOM?为什么它会导致特殊报错?
早期 Windows 系统下的记事本在保存 UTF-8 文本时,习惯在文件最开头写入 3 个隐藏字节(\xef\xbb\xbf),称为“字节顺序标记(BOM)”。虽然对人类不可见,但这三个字节位于所有代码之前,可能破坏 Python 解释器对首行 Shebang 和编码声明的正则识别,产生诡异的 SyntaxError: invalid character in identifier。建议在编辑器中一律选择 UTF-8 without BOM(无签名 UTF-8) 保存。
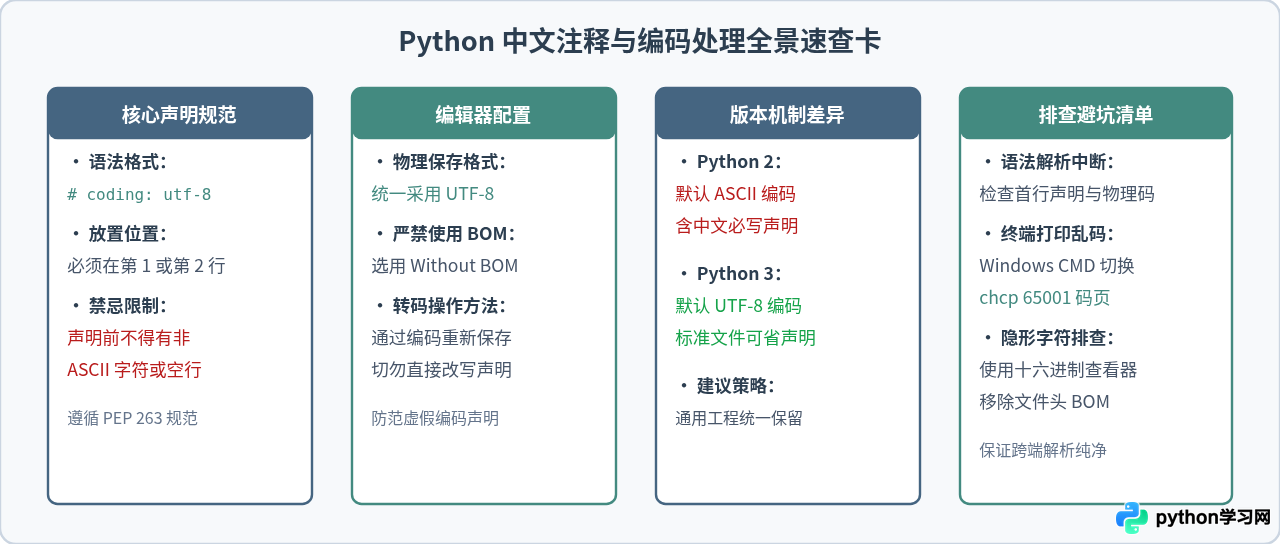
六、总结
处理 Python 中文注释乱码并不复杂,其核心逻辑可以归纳为八个字:“真实编码,如实声明”。只要养成将文件保存为 UTF-8(无 BOM)格式,并在脚本前两行添加 # -*- coding: utf-8 -*- 的标准习惯,便可彻底解决 Python 中因中文字符引发的各类解析与显示异常。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















