


Python机器学习经典书籍推荐:从入门到实战的系统化手册
系统梳理Python机器学习领域从基础数据处理、核心算法到端到端工程落地的经典书籍,提供科学的进阶路径、核心章节研读建议与配套实战方法。
学习Python机器学习常常陷入两类极端:要么一头扎进数学公式推导中,面对繁杂的高等数学与概率论望而生畏;要么停留在复制几行Scikit-Learn代码调用fit与predict,一旦面对实际业务数据便无法完成特征清洗、指标诊断与超参调优。解决这一脱节的关键,在于按照工程实践逻辑搭建梯度清晰的读书路径。本文梳理从数据清洗、基础算法实操到端到端工程落地的核心书目,并提供配套代码规范与高效阅读方案。
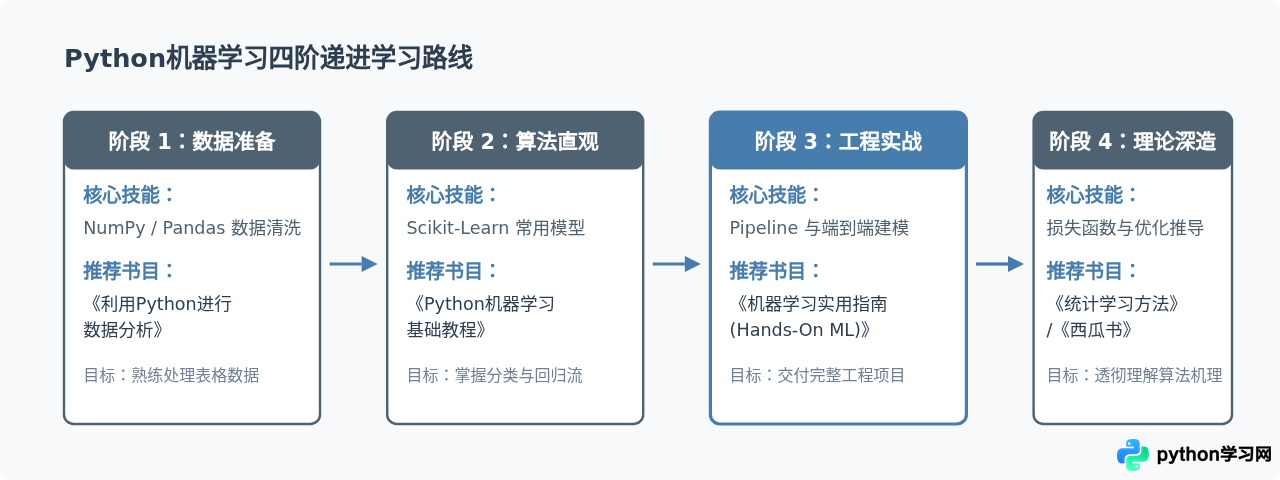
一、四阶梯进的系统化学习路线
机器学习不是孤立的算法集合,而是由数据预处理、特征构建、模型调优与验证组成的工程链条。选择书籍时应当覆盖完整链路,循序渐进地构建能力矩阵。
二、核心推荐书目与研读重点
1. 数据准备基石:《利用Python进行数据分析》(Wes McKinney 著)
真实项目中的机器学习模型耗时占比不到三成,其余大量精力都在处理杂乱无章的原始数据。本书作者是Pandas库的创始人,书中系统介绍了基于NumPy的矩阵计算基础,以及使用Pandas进行多维表重塑、聚合运算、时间序列解析与缺失数据填补的标准用法。
- 核心研读章节:第4章(NumPy基础)、第5章(Pandas入门)、第7章(数据清洗与准备)、第10章(数据聚合与分组运算)。
- 配套实战目标:能熟练运用
merge、groupby、pivot_table重构数据,并能快速检测出数据中存在的空值、极值与异常分布。
2. 直观入门与代码体验:《Python机器学习基础教程》(Andreas Müller & Sarah Guido 著)
本书第一作者为Scikit-Learn核心开发者之一。全书不堆砌复杂的泛函推导,而是结合大量二维平面可视化图形,直观展示支持向量机、决策树、随机森林、KNN等算法的决策边界形态。适合快速建立对模型超参数(如树深度max_depth、正则化参数C和gamma)影响效果的直观认知。
- 核心研读章节:第2章(监督学习算法原理与决策边界对比)、第3章(无监督学习与数据变换)、第5章(模型评估与指标调优)。
- 配套实战目标:掌握Scikit-Learn中
fit、transform、predict的标准调用规范,理解训练集与测试集划分对评估结果的根本影响。
3. 端到端工业实战标杆:《Scikit-Learn、Keras与TensorFlow机器学习实用指南》(Aurélien Géron 著)
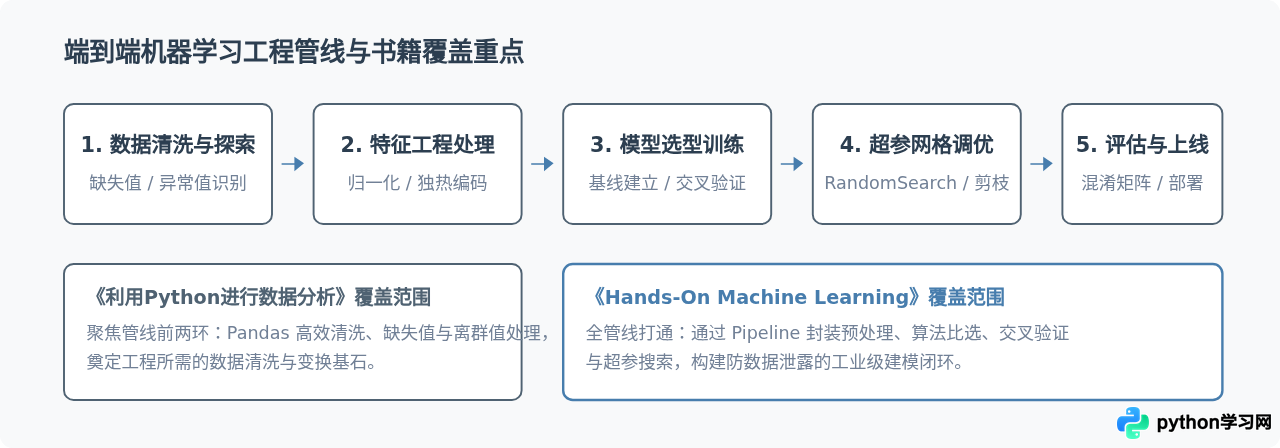
如果整个学习生涯只能精读一本Python机器学习实战书,本书无疑是首选。作者曾任Google机器学习团队主管,全书第2章以加州房价预测项目为蓝本,从问题定义、数据探索(EDA)、属性组合、流水线(Pipeline)构建,一直到交叉验证和超参数网格搜索,完整呈现工业界端到端标准研发闭环。
- 核心研读章节:第2章(端到端机器学习项目全流程)、第3章(分类任务中的精确率/召回率权衡)、第4章(线性模型训练与梯度下降)、第7章(集成学习与随机森林)。
- 配套实战目标:编写自定义转换器(Transformer),并利用
ColumnTransformer与Pipeline封装完整的特征预处理和建模链路,消除数据泄露隐患。
4. 算法机理与深度推导:《统计学习方法》(李航 著)
当能够在代码层面熟练运用各类模型后,若想进一步提升模型调优直觉,必须深入算法底层。李航老师的《统计学习方法》结构紧凑、推导严密,涵盖感知机、k近邻、朴素贝叶斯、逻辑斯蒂回归、SVM、提升方法(AdaBoost)以及EM算法。在阅读Python实战代码遇到瓶颈时,对照本书的公式推导,能彻底理解损失函数的构建原理与拉格朗日乘子法的优化过程。
三、实战范式:工业级Pipeline标准实现
书中推荐的最佳实践始终强调将预处理和模型估计器打包。初学者容易在训练集上直接计算全局均值进行填补,导致测试集信息渗透到训练过程中(数据泄露)。以下以Scikit-Learn标准流水线为例,展示经典书籍所提倡的标准化代码结构:
import numpy as np
import pandas as pd
from sklearn.datasets import fetch_california_housing
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import mean_squared_error

# 1. 准备数据
housing = fetch_california_housing(as_frame=True)
X, y = housing.data, housing.target
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 2. 定义特征处理管道(数值型特征:填补中位数 + 标准化缩放)
numeric_features = X.columns.tolist()
num_pipeline = Pipeline([
    ('imputer', SimpleImputer(strategy='median')),
    ('scaler', StandardScaler())
])

preprocessor = ColumnTransformer(transformers=[
    ('num', num_pipeline, numeric_features)
])

# 3. 组装端到端完整Pipeline
full_pipeline = Pipeline([
    ('preprocessor', preprocessor),
    ('regressor', RandomForestRegressor(n_estimators=100, random_state=42))
])

# 4. 训练与验证(预处理参数只在训练集拟合,测试集仅转换)
full_pipeline.fit(X_train, y_train)
y_pred = full_pipeline.predict(X_test)
rmse = np.sqrt(mean_squared_error(y_test, y_pred))

# 示例输出:RMSE指标反映模型测试集表现
print(f"Test RMSE: {rmse:.4f}")Pipeline.fit时,特征工程中的中位数和缩放方差均只基于X_train计算;当调用Pipeline.predict(X_test)时,会自动复用训练集统计量对测试数据进行相同转换,从而彻底隔离训练集与测试集边界。
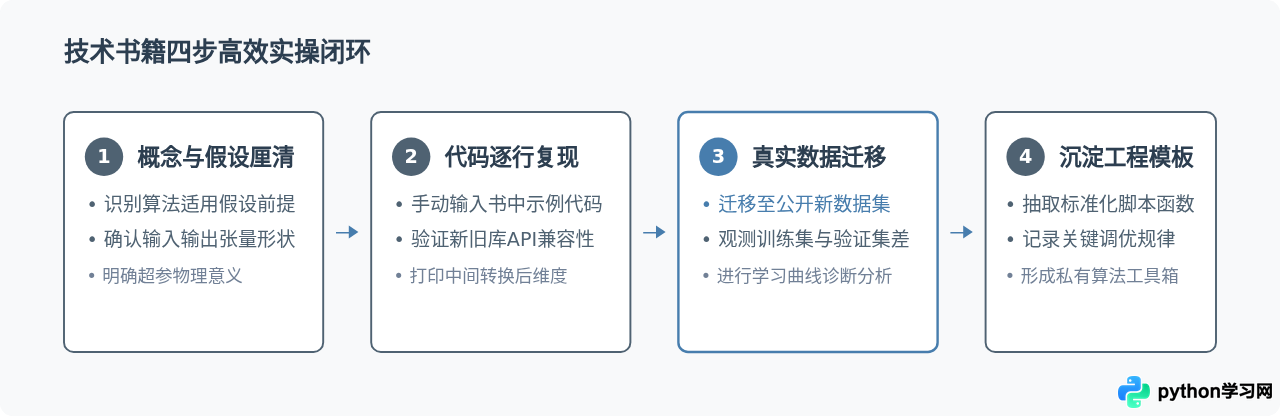
四、从理论阅读到代码复现的四步闭环
仅阅读书中文字容易产生“已经理解”的认知错觉。高效掌握机器学习知识,需要将每一章内容转化为可运行的代码与验证实验。
五、选书决策矩阵与常见避坑建议
为了让不同背景的读者迅速锁定当前阶段最匹配的书籍,下表从理论深度、代码实战度与核心技术栈三个维度进行系统对比:
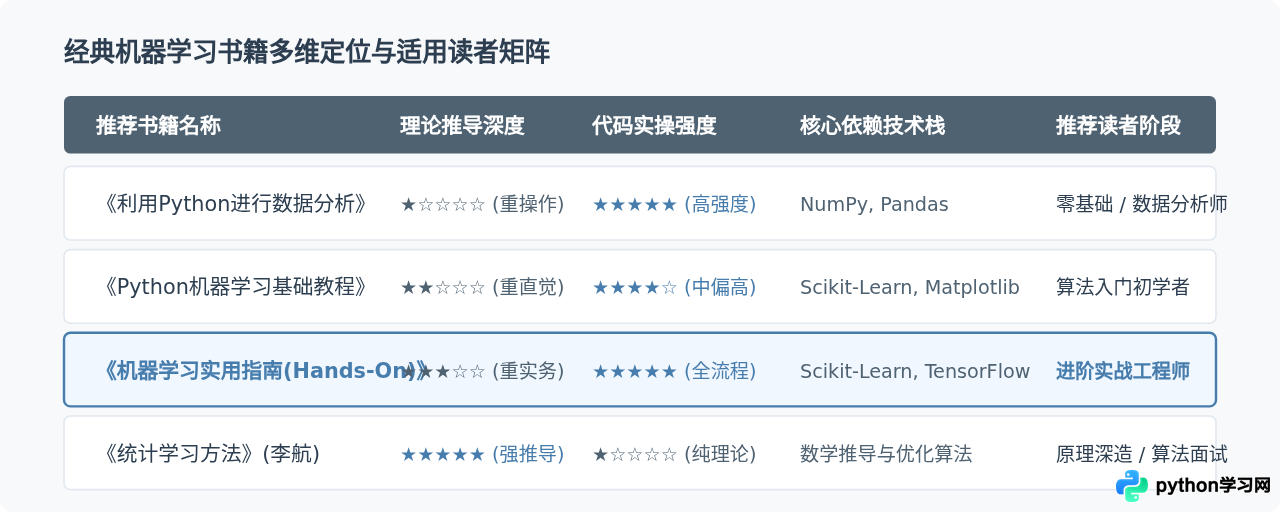
常见学习误区与修正建议:
- 误区一:不读前置数据处理书籍,直接阅读深度学习大部头。
修正:深度学习模型对异常值和缺失值极其敏感。如果连Pandas的索引对齐、缺失值填充策略和NumPy广播机制都不清楚,调试复杂网络时往往难以定位由于张量形状不匹配导致的隐蔽错误。先掌握《利用Python进行数据分析》能够事半功倍。 - 误区二:只用Jupyter Notebook分步打印,不封装工程模块。
修正:Notebook适合初期探索性数据分析(EDA),但在构建预测系统时,必须遵循《Hands-On Machine Learning》的指引,把清洗转换与预测逻辑封装进Pipeline,并编写可独立执行的.py脚本。 - 误区三:纠结于某一冷门算法的手写推导,忽视特征质量。
修正:工业界常言“数据和特征决定了机器学习的上限,而模型和算法只是逼近这个上限”。在研读基础理论的同时,应把大量精力放在对业务特征的理解、交互特征的构造以及特征筛选上,而非单纯更换模型架构。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















