


Python连接MySQL时怎么处理超时与异常断开
全面解析Python连接MySQL时遇到超时与异常断开的深层原因,包括常见错误码分析、驱动层超时参数设置、连接池主动探活与生命周期回收策略,以及生产环境最佳实践方案。
处理 Python 连接 MySQL 时的超时与异常断开,核心思路是构建分层防御体系:在驱动层设置合理的连接与读写超时(如 connect_timeout、read_timeout)防止线程无限挂死;在连接池层配合生命周期回收(pool_recycle)与借出前探活(pool_pre_ping)无感剔除死连接;同时在应用层对非幂等事务建立明确的捕获与重试边界。遵循这一路径,便能彻底解决服务闲置后初次请求报错、长耗时查询阻塞连接池以及底层网络静默断开等典型难题。
一、连接异常断开的深层原因与典型表现
在 Python 后端开发中,许多开发者最常遇到的现象是:系统在持续请求时表现稳定,但当应用静置一段时间(例如夜间或空闲半小时)后,收到的第一个请求就会抛出异常:OperationalError: (2006, 'MySQL server has gone away') 或 OperationalError: (2013, 'Lost connection to server during query')。随后再次刷新页面,请求又奇迹般地恢复正常。
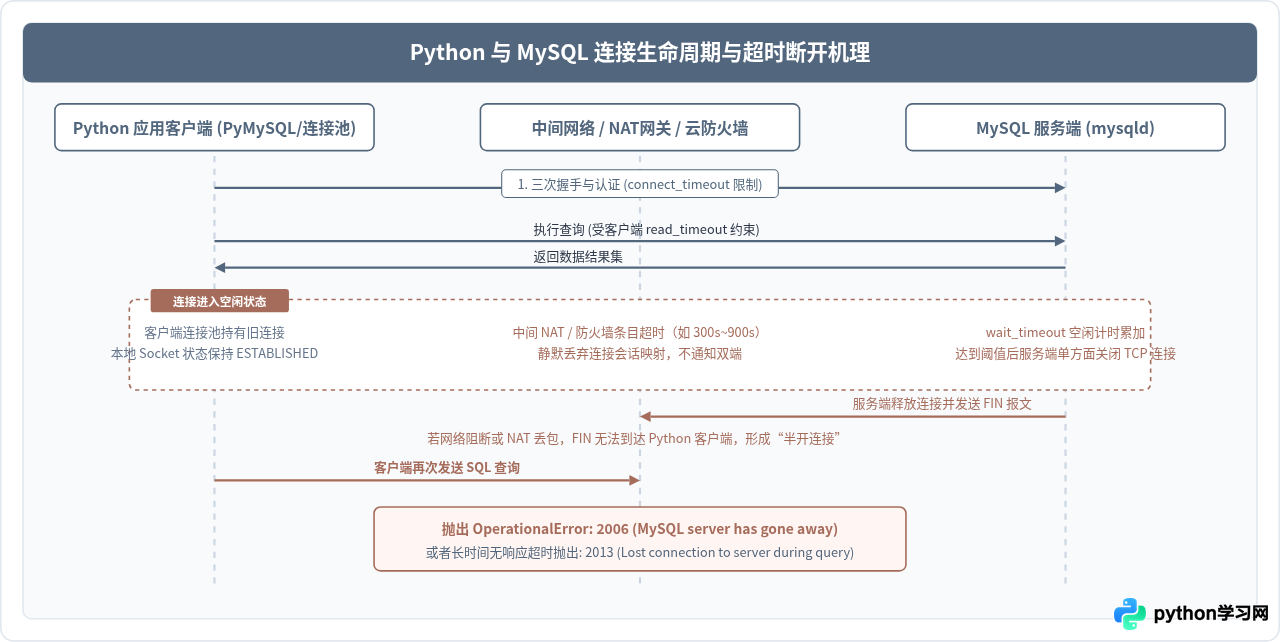
这种现象并非程序逻辑随机出错,而是由 TCP 网络连接的本质特性以及 MySQL 服务端的资源管理策略共同决定的。具体原因可归结为三类:
- 服务端空闲超时关闭连接:MySQL 默认配置了
wait_timeout和interactive_timeout(默认通常为 28800 秒,即 8 小时,但许多云厂商或生产环境会调整为 600 秒至 1800 秒)。当一条 TCP 连接在超过该时长内没有进行任何数据交互,MySQL 服务端线程会主动关闭该连接并回收资源。此时 Python 端如果仍持有原 Socket 句柄且未察觉,直接发送 SQL 就会立即触发 2006 错误。 - 中间网络设备静默剔除 NAT 映射:在微服务、容器化或跨机房架构中,客户端与 MySQL 实例之间通常隔着防火墙、云平台 NAT 网关或负载均衡器。这些网络中间件的空闲连接保活时间往往远短于 MySQL 服务端(通常在 300 秒至 900 秒)。若长期无流量,网关会直接丢弃连接会话条目,且通常不会向两端发送 FIN 报文。客户端再发送数据包时,收不到 ACK 响应直至超时,引发 2013 错误。
- 单次查询数据量超出协议限制:若单条 SQL 涉及超大字段写入(如保存大图、大 JSON 文本)或批量插入数万条数据,数据包体积超过了 MySQL 服务端的
max_allowed_packet限制,服务端会强制关闭连接并返回 2006 错误。
二、驱动层基础:配置明确的连接与读写超时
许多项目在配置数据库连接时,往往只传递 host、user、password 和 database,从而忽略了驱动层的网络超时参数。这意味着底层 Socket 默认使用操作系统级别的阻塞模式。当数据库因死锁、宕机或网络断开无法响应时,Python 进程中的对应线程将无限期挂起,进而迅速耗尽线程池与系统资源。
在主流的 PyMySQL 库中,必须明确配置以下三项超时参数:
connect_timeout:建立 TCP 握手和完成 MySQL 协议认证的最大等待时间(秒)。在网络抖动或 MySQL 连接数爆满时,能够快速失败并抛出异常,通常建议设置为3到5秒。read_timeout:发送查询后等待服务端返回数据的最大时间(秒)。若业务存在少量耗时慢查询,可按允许的最长时延设定(如30秒);严禁设置为None(无限等待)。write_timeout:向底层 Socket 发送大查询或数据包时的写入超时时间,建议设定为10到30秒。
import pymysql
from pymysql.constants import CLIENT

def create_raw_connection():
    try:
        connection = pymysql.connect(
            host="127.0.0.1",
            port=3306,
            user="app_user",
            password="secure_password",
            database="business_db",
            charset="utf8mb4",
            autocommit=False,
            # 驱动层超时控制:防止应用线程无限阻塞
            connect_timeout=5,
            read_timeout=30,
            write_timeout=15,
            cursorclass=pymysql.cursors.DictCursor
        )
        return connection
    except pymysql.err.OperationalError as e:
        error_code, error_msg = e.args
        print(f"建立连接失败 [错误码 {error_code}]: {error_msg}")
raise早期部分代码习惯传入
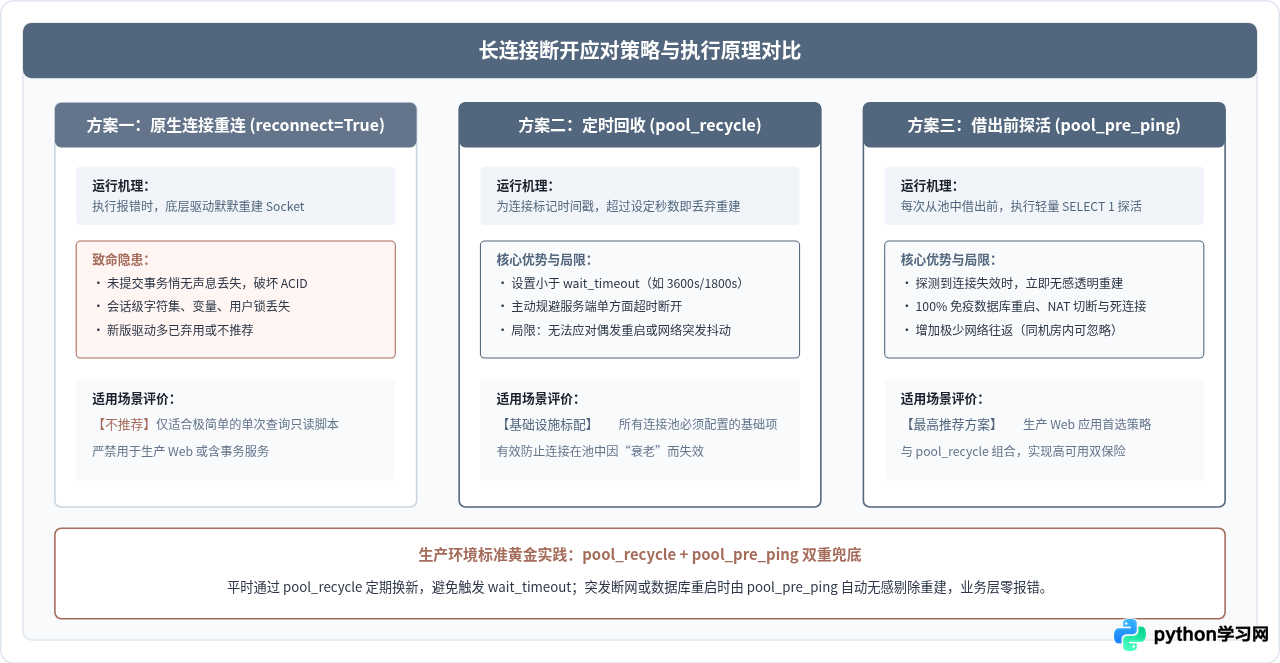
reconnect=True。但在现代应用中,这一机制存在严重安全隐患:如果一条连接在事务执行中途或设置了会话变量(如用户锁、时区、字符编码)后发生重连,旧连接的状态和未提交的事务将全部丢失。自动重连会导致脏读或事务原子性遭到破坏。因此,PyMySQL 官方及主流社区均推荐在连接池层或业务重试层处理断线,而非依赖驱动默默重连。
三、故障排查全流程:区分错误码与根因定位
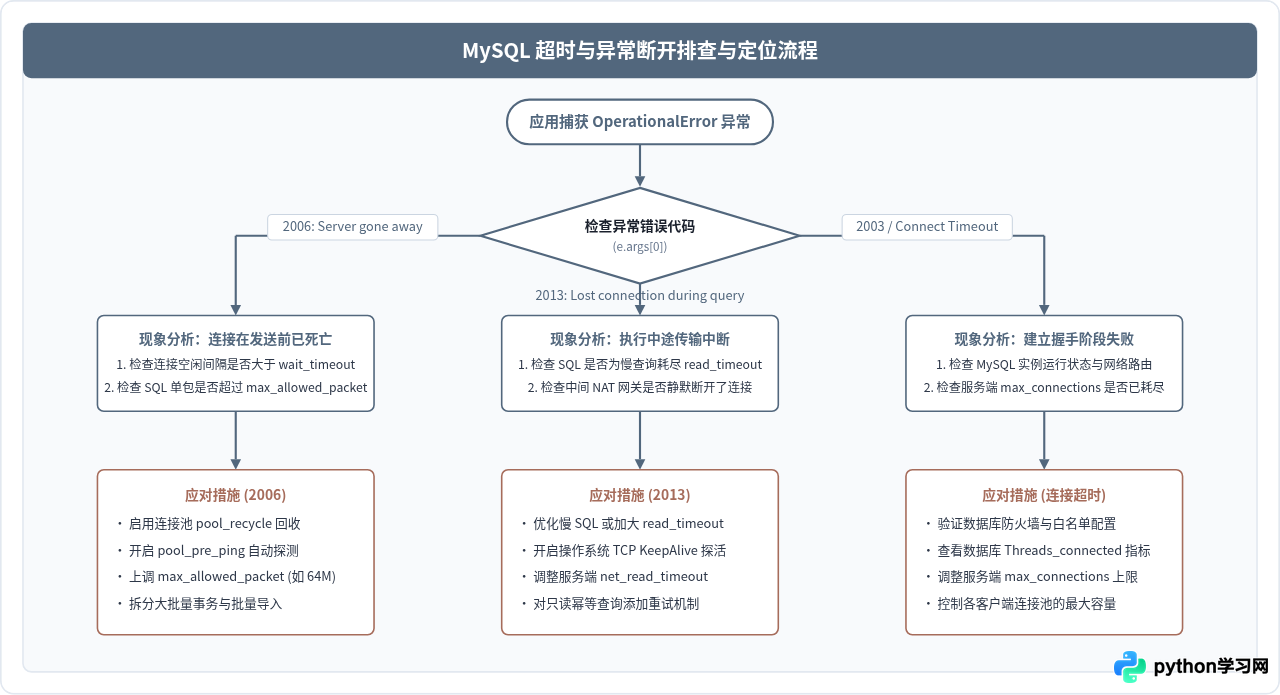
当生产环境捕获到 MySQL 断开异常时,不能盲目地调大超时时间,而应根据具体的错误码和数据库运行状态进行标准化排查。排查的核心判断逻辑如下图所示:
核心诊断 SQL 命令
在确认异常是由数据库配置引发时,可通过 MySQL 客户端执行以下 SQL 查看当前环境的关键参数设定:
-- 1. 查看超时相关变量设定(重点关注 wait_timeout 与 interactive_timeout)
SHOW GLOBAL VARIABLES LIKE '%timeout%';

-- 2. 查看单次最大数据包大小(字节数,默认多为 16MB 或 64MB)
SHOW GLOBAL VARIABLES LIKE 'max_allowed_packet';

-- 3. 查看连接数限制与当前已建立的连接数
SHOW GLOBAL VARIABLES LIKE 'max_connections';
SHOW GLOBAL STATUS LIKE 'Threads_connected';

-- 4. 查看因超时或异常中断的客户端累计计数
SHOW GLOBAL STATUS LIKE 'Aborted_clients';
SHOW GLOBAL STATUS LIKE 'Aborted_connects';
如果 Aborted_clients 指标数值持续高频增长,表明大量客户端连接未正常调用 close(),而是被服务端超时断开或中间网络切断。
四、生产级解决方案:连接池保活与自动重连机制
在 Web 服务、Celery 异步任务或数据分析常驻脚本中,频繁执行 connect() 和 close() 具有极高的握手成本,因此普遍采用连接池复用连接。然而连接池若不具备容错能力,保存了失效连接,就会持续向业务代码输出 2006 错误。针对这一问题,行业内主要有两种成熟模式:以 SQLAlchemy 为代表的 ORM 连接池管理,以及基于 DBUtils 的轻量级原生池管理。
1. SQLAlchemy 生产级连接池配置
在基于 SQLAlchemy 的应用中,解决空闲断连的最佳方式是在 create_engine 中传入 pool_pre_ping=True 并配置 pool_recycle:
from sqlalchemy import create_engine, text
from sqlalchemy.orm import sessionmaker

# 构建具备自动探活与生命周期回收的 Engine
DATABASE_URL = "mysql+pymysql://app_user:secure_password@127.0.0.1:3306/business_db?charset=utf8mb4"

engine = create_engine(
    DATABASE_URL,
    # 核心连接池大小
    pool_size=10,
    # 突发高峰允许超额创建的临时连接数
    max_overflow=20,
    # 连接在池中的最大存活时间(秒)。务必小于服务端的 wait_timeout
    # 例如服务端 wait_timeout 为 28800,这里设为 3600 或 1800
    pool_recycle=1800,
    # 关键参数:每次从池中借出连接时,自动执行轻量级 SELECT 1 探活
    # 若连接已失效,连接池会自动销毁并重建一条全新连接,业务代码无感知
    pool_pre_ping=True,
    # 透传底层 PyMySQL 驱动的超时设置
    connect_args={
        "connect_timeout": 5,
        "read_timeout": 30,
        "write_timeout": 15
    }
)

SessionLocal = sessionmaker(autocommit=False, autoflush=False, bind=engine)

def execute_query():
    # 借助上下文管理器获取连接并自动释放归还到池中
    with engine.connect() as connection:
        result = connection.execute(text("SELECT id, username FROM users WHERE status = :status"), {"status": 1})
        return result.fetchall()
2. 原生 SQL 场景:DBUtils PooledDB 的探活机制
如果项目没有使用 SQLAlchemy,而是使用纯原生 SQL,推荐通过 dbutils.pooled_db 管理连接。PooledDB 通过 ping 参数实现类似 pool_pre_ping 的探活逻辑:
from dbutils.pooled_db import PooledDB
import pymysql

# 初始化连接池
pool = PooledDB(
    creator=pymysql,
    maxconnections=20,      # 连接池允许的最大连接数
    mincached=5,            # 初始化时创建的空闲连接数
    maxcached=10,           # 保持的最大空闲连接数
    blocking=True,          # 连接池耗尽时是否阻塞等待
    # ping 探活控制参数:
    # 0 = 从不探测
    # 1 = 从池中取连接时执行探测 (相当于 pre-ping)
    # 2 = 执行 SQL 时探测
    # 4 = 自动提交时探测
    # 7 = 始终探测
    ping=1,
    host="127.0.0.1",
    port=3306,
    user="app_user",
    password="secure_password",
    database="business_db",
    charset="utf8mb4",
    connect_timeout=5,
    read_timeout=30
)

def query_with_pooled_db():
    conn = pool.connection()  # 若取出的连接已断开,由于 ping=1 会自动重连
    try:
        with conn.cursor(pymysql.cursors.DictCursor) as cursor:
            cursor.execute("SELECT 1 AS alive_flag")
            return cursor.fetchone()
    finally:
        conn.close()  # 归还连接至池中,而非真正关闭底层 Socket
五、应用层重试:处理非幂等操作与事务边界
即使配置了连接池探活,仍然无法彻底避免在 SQL 正在网络上传输或服务端正在执行阶段 发生的突发网络中断(此时 pre_ping 无法预测执行过程中的断网,会抛出 2013 错误)。
对于只读查询(如 SELECT),该操作天然具备幂等性,可以在捕获到 OperationalError 时安全重试;但对于写入与事务操作(INSERT、UPDATE、DELETE),盲目重试可能导致重复扣款或数据重复录入。因此,应用层的异常处理必须明确区分读写性质:
import time
import functools
import pymysql

def retry_on_db_disconnect(max_retries=3, delay=1):
    """
    针对只读/幂等查询的自动重试装饰器
    注意:切勿直接装饰包含写事务或非幂等操作的函数!
    """
    def decorator(func):
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            last_exception = None
            for attempt in range(1, max_retries + 1):
                try:
                    return func(*args, **kwargs)
                except pymysql.err.OperationalError as e:
                    error_code = e.args[0]
                    # 仅针对网络与超时断连错误码进行重试
                    if error_code in (2006, 2013, 2003):
                        last_exception = e
                        print(f"检测到底层连接异常 (code: {error_code}),第 {attempt} 次重试...")
                        time.sleep(delay * attempt)
                    else:
                        # 语法错误、死锁等其他业务异常直接向上抛出
                        raise
            raise last_exception
        return wrapper
    return decorator

@retry_on_db_disconnect(max_retries=3, delay=0.5)
def safe_fetch_user_profile(user_id):
    # 只读操作,即使中途断开重试也是安全的
    conn = pool.connection()
    try:
        with conn.cursor() as cursor:
            cursor.execute("SELECT * FROM user_profiles WHERE id = %s", (user_id,))
            return cursor.fetchone()
    finally:
        conn.close()
六、系统与网络层:开启 TCP KeepAlive 阻断静默丢包
在存在云网关、NAT 或防火墙的环境中,开启操作系统及 Python 层的 TCP KeepAlive 是避免长连接被“静默拔线”的根本硬件级手段。默认情况下,Linux 操作系统的 tcp_keepalive_time 长达 7200 秒(2 小时),这远远慢于防火墙在数分钟内丢弃映射的速度。
通过让操作系统每隔 60 秒自动向 MySQL 服务端发送一个空的探活 ACK 包,不仅可以刷新中间路由器的 NAT 会话计时器,还能在服务端真正宕机时尽早得知连接状态:
import socket
import pymysql

def get_keepalive_connection():
    # 创建底层连接
    conn = pymysql.connect(
        host="127.0.0.1",
        port=3306,
        user="app_user",
        password="secure_password",
        database="business_db"
    )
    # 获取底层的原生 socket 对象并配置 TCP KeepAlive
    sock = conn.Socket
    if sock:
        # 开启 KeepAlive
        sock.setsockopt(socket.SOL_SOCKET, socket.SO_KEEPALIVE, 1)
        # Linux 环境下针对保活间隔的细粒度微调(根据系统平台支持情况启用)
        if hasattr(socket, "TCP_KEEPIDLE"):
            sock.setsockopt(socket.IPPROTO_TCP, socket.TCP_KEEPIDLE, 60)   # 空闲60秒即开始探活
        if hasattr(socket, "TCP_KEEPINTVL"):
            sock.setsockopt(socket.IPPROTO_TCP, socket.TCP_KEEPINTVL, 10)  # 探测报文间隔10秒
        if hasattr(socket, "TCP_KEEPCNT"):
            sock.setsockopt(socket.IPPROTO_TCP, socket.TCP_KEEPCNT, 3)     # 探测失败3次即判定断线
    return conn
七、生产环境配置全景与参数对照总结
为了让系统在面对高并发、网络抖动和长时间空闲时保持稳健,建议按照以下四层协同体系进行参数匹配:
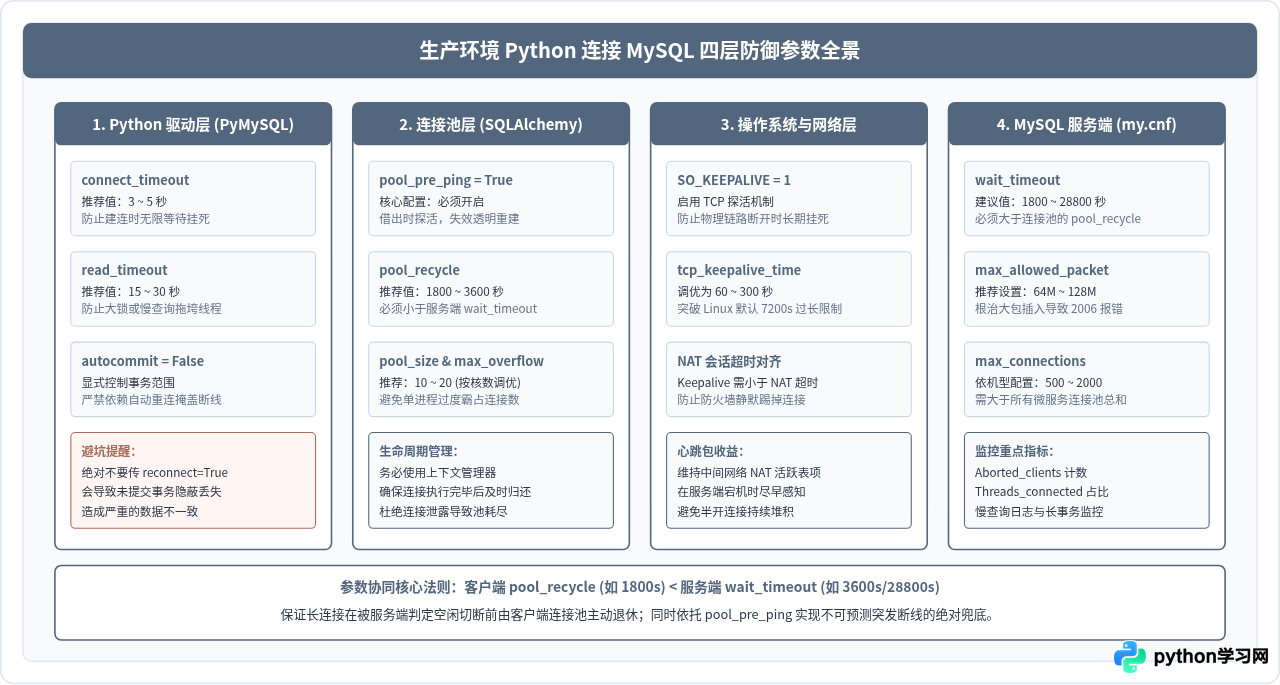
关键配置参数速查表
| 配置层级 | 参数名称 | 推荐设定值 | 作用与业务保障 |
|---|---|---|---|
| Python 驱动层 | connect_timeout |
3 ~ 5 秒 | 防止握手阶段因服务端不可达导致线程挂死 |
| Python 驱动层 | read_timeout |
15 ~ 30 秒 | 限制单个 SQL 最大等待时延,防止死锁或慢查阻塞连接 |
| 连接池层 (ORM) | pool_pre_ping |
True | 每次借出前轻量探活,已断开连接无感透明重建 |
| 连接池层 (ORM) | pool_recycle |
1800 秒 | 主动在 wait_timeout 到期前销毁老旧连接 |
| 网络与系统层 | SO_KEEPALIVE |
开启 (1) | 发送心跳保活包,防止云网关/防火墙静默丢弃 NAT 条目 |
| MySQL 服务端 | max_allowed_packet |
64M 或 128M | 避免批量插入大批数据时被服务端直接掐断连接 (2006) |
总结
在 Python 处理 MySQL 超时与断开的问题上,最容易陷入的误区是“头痛医头”,例如仅仅将 wait_timeout 盲目调大至数天,或者简单粗暴地开启不可靠的自动重连。真正健壮的架构应当明确各层职责:
在驱动层守住底线,设定严格的连接与读写超时(connect_timeout、read_timeout);在连接池层引入双保险,通过 pool_recycle 提前换新规避定时死亡,通过 pool_pre_ping 实时探活防御突发宕机;在应用层做好幂等与非幂等操作的边界划分;在系统层开启 KeepAlive 应对网络中间件的静默超时。遵循这套组合拳,即可确保系统在高并发访问和长时间空闲后均能保持连接的持续稳定。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















