


Python生成符合正态分布等特定统计分布的随机数
系统介绍在Python中生成正态分布、指数分布、泊松分布等统计分布随机数的实用方法。对比标准库random与NumPy现代生成器default_rng的机制、参数定义、性能差异与检验手段。
random 即可满足要求;而在数据分析、蒙特卡洛模拟或大规模矩阵运算场景中,应当使用现代 NumPy 的 np.random.default_rng() 接口。本文将围绕正态分布、指数分布、泊松分布等核心模型,梳理各实现方案的参数映射规则、底层机制与结果验证方法。
很多刚接触统计计算的开发者,在需要模拟带有噪声的物理量或生成仿真用户行为时,往往会直觉性地直接调用 random.random() 然后通过加减乘除拼凑数字。然而,现实世界中的测量误差、通信信道噪声通常遵循正态分布,设备排队间隔服从指数分布,而单位时间内突发请求的发生次数则服从泊松分布。如果不使用数学上严格的采样算法,随意拼接出的数据往往无法反映真实的概率分布特征。
一、核心分布形态与参数基础
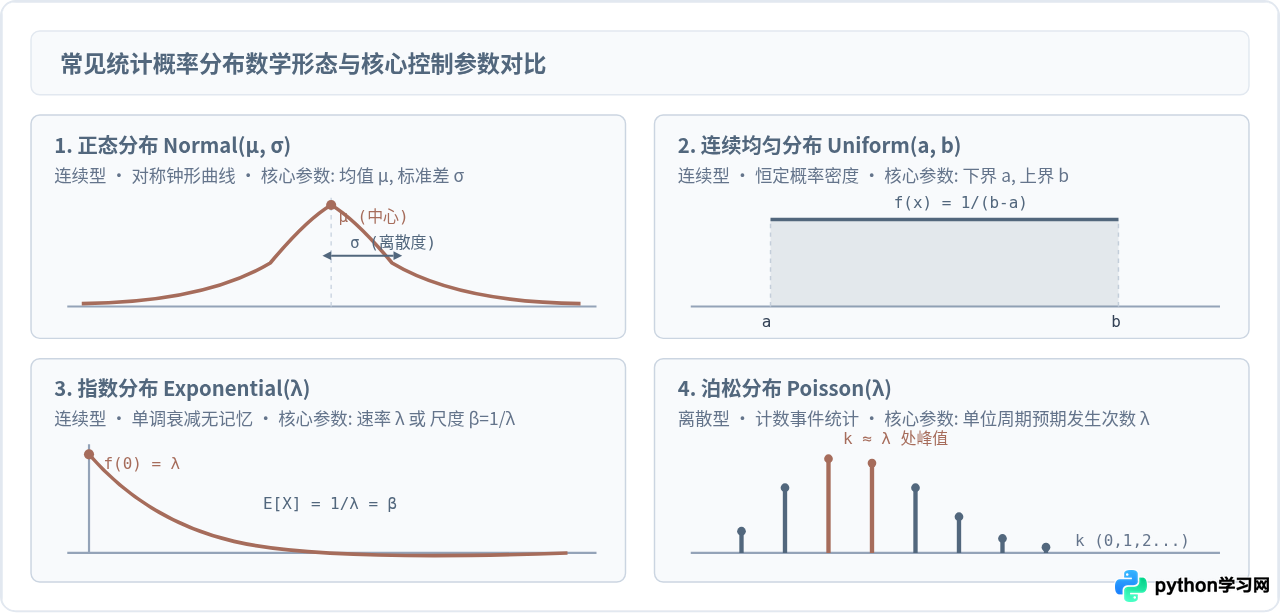
生成随机数之前,必须准确理解目标统计分布的数学特征及其核心控制参数。混淆参数定义(例如将“尺度参数”当作“速率参数”,或将“标准差”当作“方差”)是导致模拟结果失真的最常见原因。
二、标准库 random:纯 Python 环境下的单值生成
如果你的工程是一个轻量级工具脚本,不需要引入庞大的科学计算包,Python 内置的 random 模块就已经提供了几种最基础的分布发生器。
1. 正态分布采样:random.gauss 与 random.normalvariate
标准库中提供了两个生成正态分布的函数:random.gauss(mu, sigma) 和 random.normalvariate(mu, sigma)。两者的参数含义完全一致:mu 代表均值 $\mu$,sigma 代表标准差 $\sigma$。
import random

# 设置随机种子以保证结果可复现
random.seed(42)

# 生成一个均值为 100,标准差为 15 的正态分布样本
mu = 100.0
sigma = 15.0
sample = random.gauss(mu, sigma)
print(f"生成的正态分布单样本: {sample:.4f}")

# 批量采样并计算样本均值
samples = [random.gauss(mu, sigma) for _ in range(5000)]
sample_mean = sum(samples) / len(samples)
print(f"5000个样本的平均值: {sample_mean:.4f}")
random.gauss() 内部采用了略快的高斯加权算法,在多线程环境下略有状态共享损耗;而 random.normalvariate() 采用基于 Box-Muller 变换的实现,线程安全性略高。在常规单线程代码中,官方推荐直接使用 random.gauss()。
2. 指数分布采样:random.expovariate 的参数陷阱
调用 random.expovariate(lambd) 时需要特别留意参数定义:参数名为 lambd(即速率参数 $\lambda$)。生成的随机变量均值为 $1/\lambda$。
# 假设事件平均每 10 分钟发生一次,则速率 lambd = 1 / 10 = 0.1
lambd = 0.1
interval = random.expovariate(lambd)
print(f"模拟的下一次事件到达时间间隔: {interval:.2f} 分钟")
若读者错将“平均期望值 10”直接传给 random.expovariate(10),实际生成的将是均值仅为 0.1 的微小数值,这一点在实操中极易出错。
三、NumPy 规范:现代 default_rng 批量生成
当需要生成成千上万个模拟样本,或者需要构建多维特征矩阵时,Python 原生列表推导式的执行效率就会成为瓶颈。此时,行业标准是使用 numpy.random。
1. 为什么必须推荐使用 default_rng()
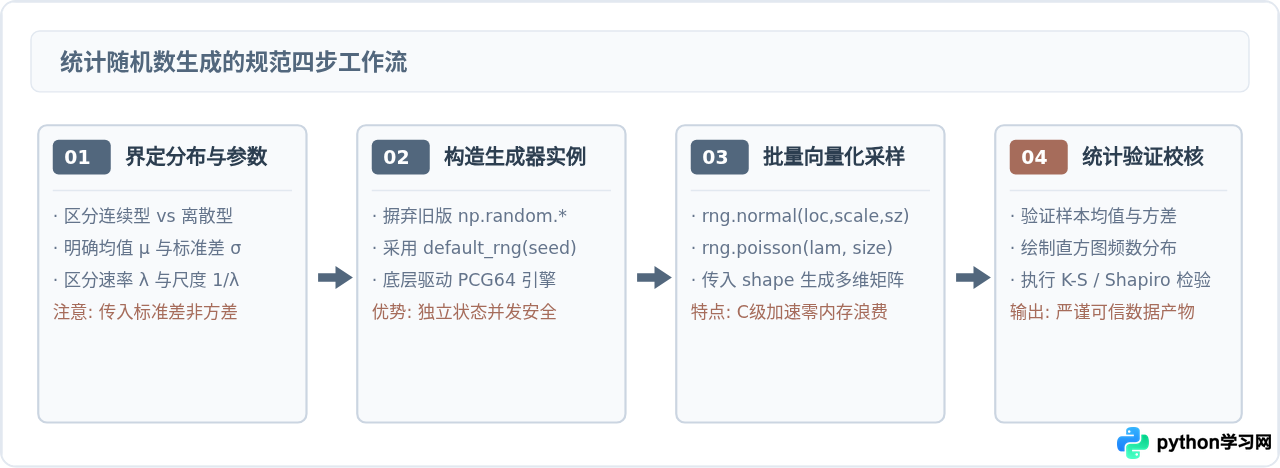
NumPy 自 1.17 版本起引入了全新的随机数子系统架构。在此之前,开发者通常使用类似 np.random.normal() 的模块级函数。旧接口依赖全局单一的 Mersenne Twister 状态,在多进程并发、多线程任务或不同模块协作时,容易发生状态竞争或产生意外相同的伪随机数序列。
现代最佳实践是通过 np.random.default_rng() 实例化一个独立的 Generator 对象,底层默认搭载经过严格统计检验的 PCG64(Permuted Congruential Generator)位发生器:
import numpy as np

# 创建独立的随机数发生器实例
rng = np.random.default_rng(seed=2026)

# 1. 生成正态分布 (loc=均值μ, scale=标准差σ, size=形状)
norm_arr = rng.normal(loc=50.0, scale=8.0, size=(1000, 2))
print("正态分布矩阵形状:", norm_arr.shape)
print("样本均值估计:", np.mean(norm_arr, axis=0))
print("样本标准差估计:", np.std(norm_arr, axis=0))

# 2. 生成连续均匀分布 [low, high)
uniform_arr = rng.uniform(low=0.0, high=10.0, size=5000)

# 3. 生成泊松分布 (离散型,单位时间期望发生次数 lam=4)
poisson_arr = rng.poisson(lam=4.0, size=5000)

# 4. 生成指数分布 (注意参数 scale = 1 / lambda)
# 若事件平均间隔为 5 秒,则 scale=5.0
exp_arr = rng.exponential(scale=5.0, size=5000)
四、架构深度对比:random 与 NumPy Generator
为理清二者的适用边界,我们可以从底层算法、状态隔离性、输出类型和吞吐性能四个维度进行系统对比。
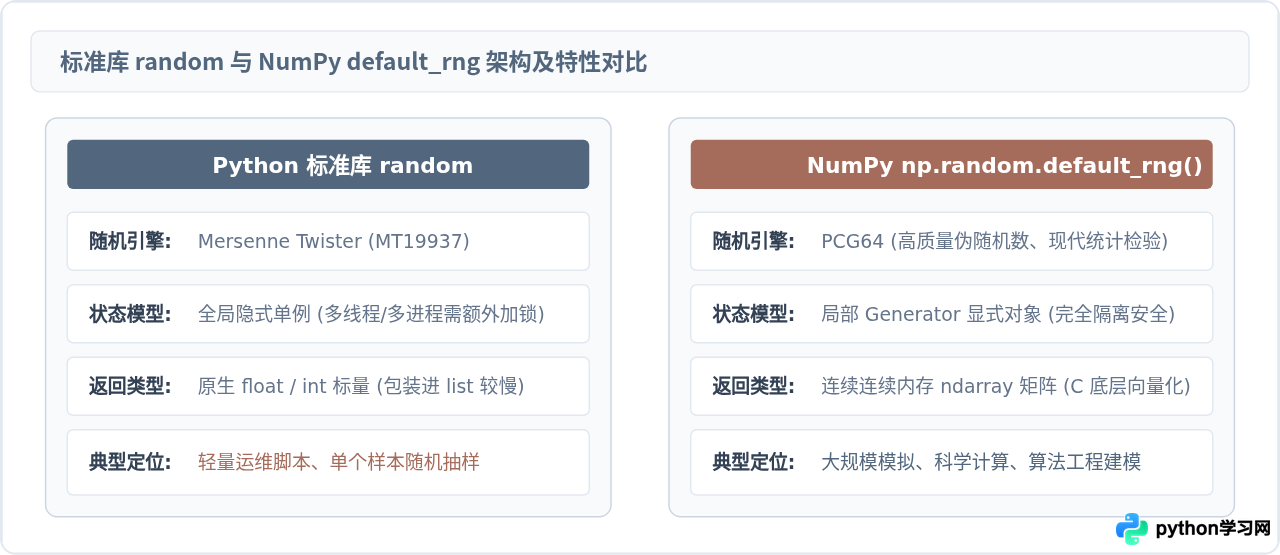
为了直观展现两者在大数据量下的性能差距,我们可以在同等硬件环境下测试生成 100 万个标准正态分布浮点数所需的耗时:
- random.gauss 列表推导式:耗时通常在
450ms ~ 650ms之间,伴随频繁的 Python 虚拟机对象分配。 - np.random.default_rng().normal:耗时通常仅需
12ms ~ 18ms,直接在底层连续 C 内存缓冲中填充数据,提速达 30 倍以上。
五、统计检验:验证生成的随机数是否达标
编写完随机生成逻辑后,不能仅凭控制台打印的一两个数字就假定代码无误。严谨的流程要求对样本进行双重检验:一是“经验矩估计”,二是“拟合优度检验”。
1. 样本矩(均值与方差)基本检验
正态分布的理论一阶矩为 $\mu$,二阶中心矩为 $\sigma^2$。我们可以通过大数定律验证样本统计量是否在置信区间内收敛:
import numpy as np

rng = np.random.default_rng(seed=123)
target_mu, target_sigma = 175.0, 6.0
n_samples = 200_000

# 采样
data = rng.normal(loc=target_mu, scale=target_sigma, size=n_samples)

# 计算样本统计值
calc_mean = np.mean(data)
calc_std = np.std(data, ddof=1)  # 无偏样本标准差

print(f"理论均值: {target_mu:.2f} | 样本均值: {calc_mean:.4f} (偏差: {abs(calc_mean - target_mu):.4f})")
print(f"理论标准差: {target_sigma:.2f} | 样本标准差: {calc_std:.4f} (偏差: {abs(calc_std - target_sigma):.4f})")
2. Kolmogorov-Smirnov 检验(K-S 检验)
均值和方差接近并不等同于样本整体符合正态曲线。借助 scipy.stats 模块中的 K-S 检验,我们可以计算样本经验累积分布函数(ECDF)与理论正态分布函数的最大偏离距离:
from scipy import stats

# 检验样本是否来自 N(175, 6^2)
ks_stat, p_value = stats.kstest(data, 'norm', args=(target_mu, target_sigma))
print(f"K-S 检验统计量: {ks_stat:.5f}, p 值: {p_value:.4f}")

# 若 p > 0.05,则无法拒绝样本服从指定正态分布的原假设
if p_value > 0.05:
    print("结论: 样本在 95% 置信水平下显著符合目标正态分布。")
else:
    print("警告: 样本未能通过分布一致性检验,请排查生成参数!")
六、常见分布快速决策与速查表
为便于在工程开发中快速查阅,下表整理了最常用统计分布在标准库与 NumPy 中的 API 对照及参数换算关系:
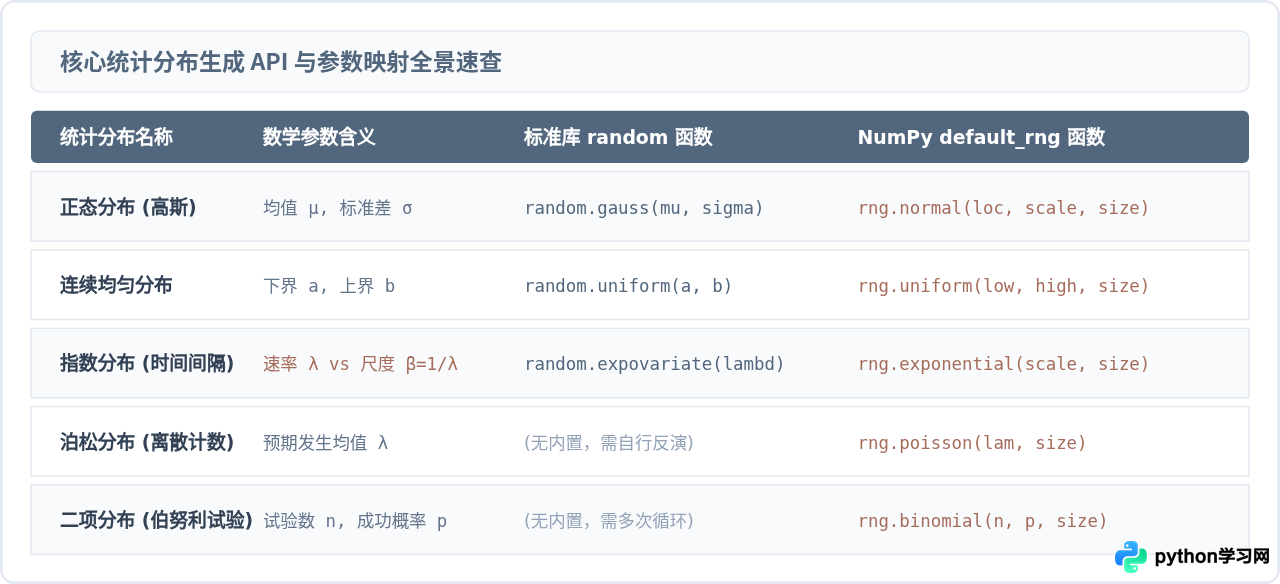
七、高频易错避坑总结
-
混淆标准差与方差:
在统计学教材中,正态分布常记作 $N(\mu, \sigma^2)$。但在 Python 代码中,无论
random.gauss(mu, sigma)还是rng.normal(loc, scale),传入的第二个参数均严格代表标准差 $\sigma$,而非方差 $\sigma^2$。如果目标分布方差为 25,传入函数的数值必须是 5。 -
指数分布参数方向倒置:
标准库
random.expovariate(lambd)接收的是到达率 $\lambda$;而 NumPy 的rng.exponential(scale)接收的是特征尺度 $\beta = 1/\lambda$(即均值)。在两套库之间迁移逻辑时,务必核对这一倒数对应关系。 -
多进程并发中的种子克隆陷阱:
在 Linux/macOS 环境下使用
multiprocessing执行fork时,子进程会全盘复制父进程的内存空间,导致所有子进程最初持有的随机数发生器内部状态一模一样,从而采样出完全重复的随机序列。正确的做法是:在每个工作进程启动的入口处显式调用np.random.default_rng(),或借助np.random.SeedSequence派生独立的子种子序列。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















