


Python中print与logging模块在字符串输出上的选择
深入解析Python中print函数与logging模块在字符串输出上的本质差异、选型维度、架构原理及迁移实践,提供工程级决策指南与内联图解。
在Python开发中,输出字符串信息是最基础、最频繁的操作之一。许多初学者和轻量脚本开发者习惯使用内置的 print() 函数,而在构建服务、数据处理流水线或长期维护的项目时,标准库的 logging 模块则成为行业标配。两者的本质差异并不在于“能否把字符打印出来”,而在于对信息流向的管理方式、元数据丰富度、运行时过滤能力以及对系统性能的影响。本文将通过底层机制分析、场景对比、规范配置与迁移步骤,帮助你在开发中做出清晰且符合工程标准的输出选择。
一、底层机制差异:单向输出与可路由管道
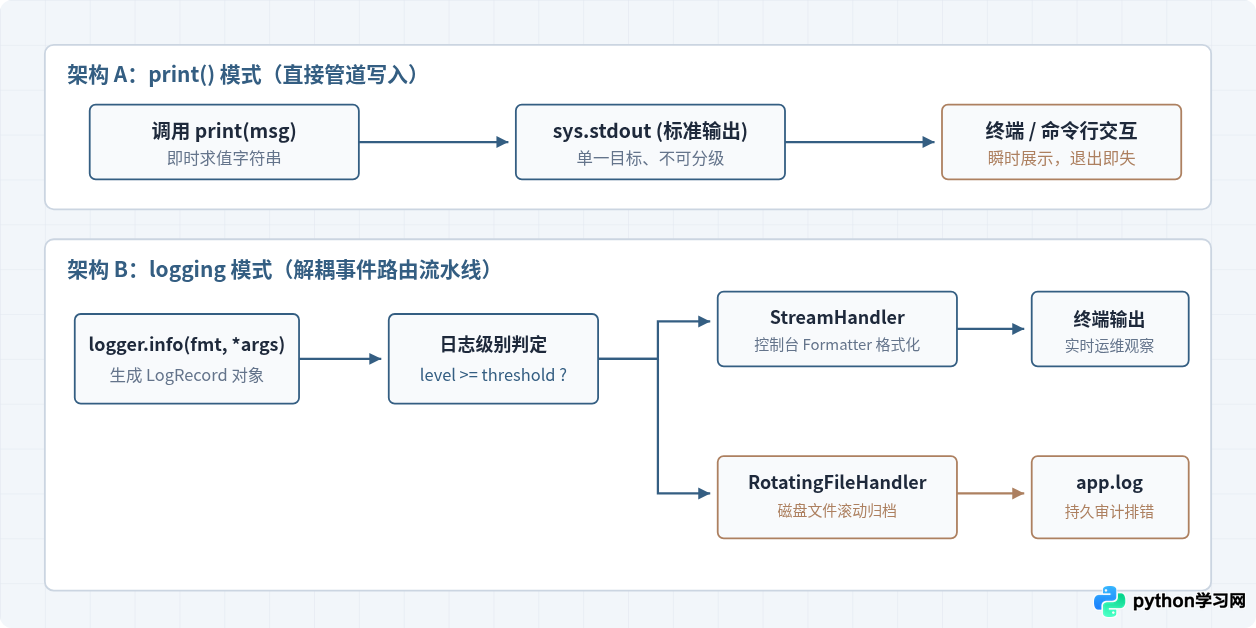
从底层结构来看,print() 与 logging 承担的是完全不同的软件工程职责。print() 本质上是标准输出管道的快速写入接口,它默认直接向操作系统层面的 sys.stdout 发送文本流。而 logging 是一个完整的解耦事件流框架,由事件生成器(Logger)、分发判定(Level)、格式解析器(Formatter)以及输出目标通道(Handler)组成。
当你执行 print("订单支付完成") 时,解释器会立即将字符串编码并通过标准输出写入控制台。如果程序没有在调用层重定向输出流,这段信息将无法被按级别过滤,也无法在不修改源代码的情况下转存到物理磁盘、集中式日志分析平台或静默忽略。
相对而言,logging 采用事件驱动的流水线架构。当调用 logger.info("订单支付完成: id=%s", order_id) 时,模块首先创建一个 LogRecord 实例,该实例不仅包含主体字符串,还自动捕获时间戳、文件名、行号、进程号与线程名。随后,系统逐层比对预设严重级别;只有达到输出阈值的记录,才会被分发至绑定的一个或多个 Handler,分别完成向控制台标准输出、文件轮转写入或网络套接字投递的操作。
二、字符串输出的四个关键评估维度
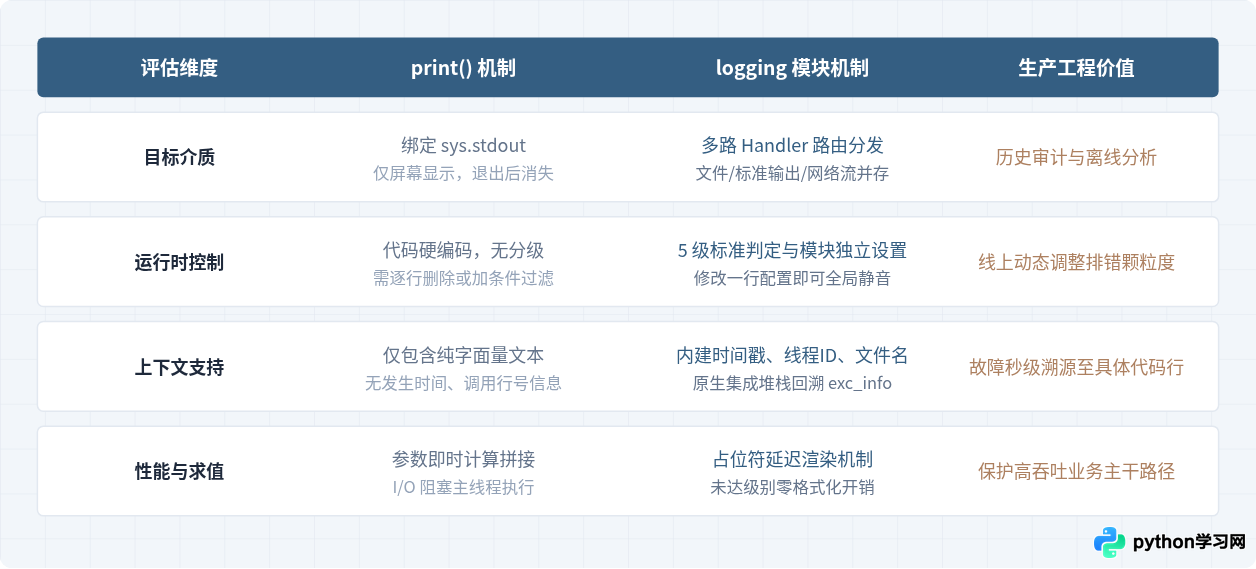
在决定使用 print() 还是 logging 时,不能仅凭个人习惯,而应从目标介质、运行期流控、元数据上下文以及格式化性能四个维度进行综合权衡。
1. 目标介质与持久化支持
标准输出流 sys.stdout 通常只在当前交互式终端可见。如果程序部署在后台守护进程、容器环境或多任务异步服务器中,未受捕获的 print() 内容会直接与系统的控制台输出混杂在一起,容易被终端清屏或容器重启抹去。logging 允许配置多种不同的 Handler,在不需要改变业务逻辑的前提下,将关键信息同步写入带有大小上限和自动轮转的日志文件(如 RotatingFileHandler),保障生产环境的历史故障具备复现与追溯凭证。
2. 运行时分级控制与静默能力
print() 函数一旦写入代码,在不加侵入式 if 判定时会无差别执行。如果在核心循环中插入大量 print() 进行排错,排错结束后必须手动查找并删除或注释掉这些语句。稍有遗漏,就会污染正常输出甚至影响交互。而 logging 预置了 DEBUG、INFO、WARNING、ERROR、CRITICAL 五种标准严重等级。在开发测试阶段可以将级别设置为 DEBUG 输出全部过程;在生产上线时仅需修改配置中的 level=logging.WARNING,所有调试与信息级语句便会在运行时被静默忽略,无需改动任何源码。
3. 元数据上下文注入
线上排查问题时,单纯的一句“连接数据库超时”通常毫无用处,排查人员需要确切知道这条消息产生于哪个模块、哪一行代码、具体时间戳以及哪个执行线程。若使用 print(),开发者必须手动在每个打印处拼接 datetime.now() 或模块标识。logging 在创建 LogRecord 时,利用 Python 运行时的栈帧内省机制自动填充这些字段,配合统一的 Formatter 可以全局输出规范的结构化记录。
4. 格式化求值时机与性能开销
在字符串拼接和格式化方面,两者存在极易被忽视的性能差异。在日常编写代码时,开发者常使用 f-string 或 format():
# print 模式:无论是否需要查看,括号内的 f-string 都会立即执行拼接
print(f"处理任务矩阵: {calculate_heavy_matrix(data)}")

# logging 错误写法:同样会立即执行昂贵的高开销计算与拼接
logging.debug(f"处理任务矩阵: {calculate_heavy_matrix(data)}")

# logging 推荐规范:传递占位符与参数,享受延迟求值保护
logging.debug("处理任务矩阵: %s", calculate_heavy_matrix(data))
当日志级别设为 INFO 时,logging.debug(...) 在检测到当前严重等级低于阈值后,会直接放弃字符串格式化计算。这种“延迟格式化”特性在大规模数据遍历或高并发网络服务中,能有效避免不必要的内存分配与 CPU 浪费。
三、标准日志配置与输出示例
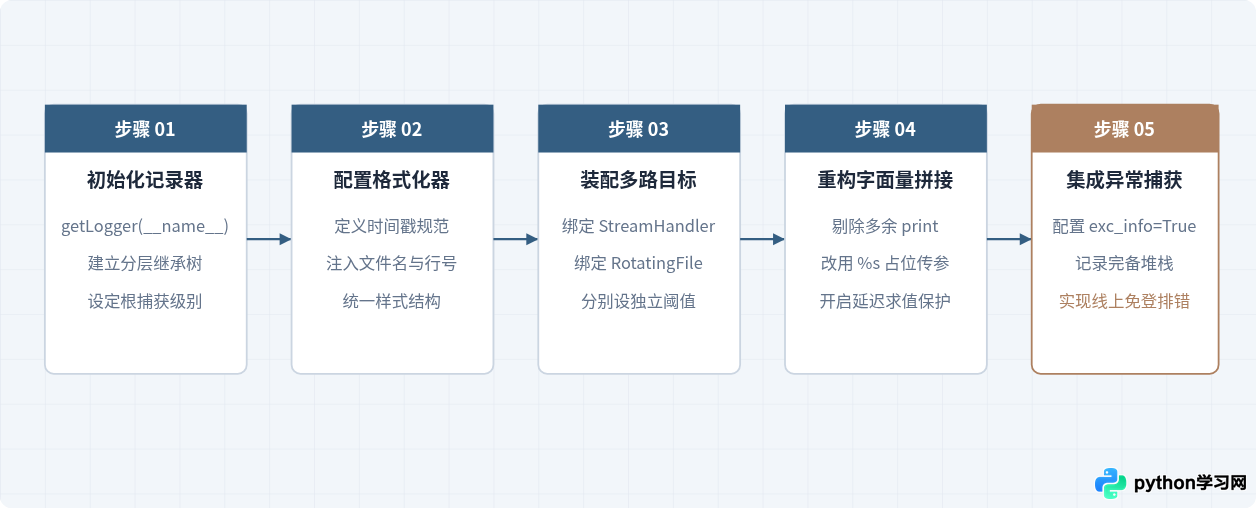
许多开发者之所以退回到 print(),往往是因为对 logging 的配置方式不熟悉。直接调用 logging.basicConfig() 适合脚本级应用,而生产服务建议使用清晰的层级记录器与专用 Handler。
1. 生产级日志初始化配置
以下示例展示了如何在应用入口构建一个同时输出控制台彩色诊断信息和持久化轮转文件的标准 Logger:
import logging
from logging.handlers import RotatingFileHandler
import sys

def setup_application_logger(name: str = "app") -> logging.Logger:
    logger = logging.getLogger(name)
    logger.setLevel(logging.DEBUG)  # 捕获该 Logger 下所有级别的事件

    # 避免重复添加 Handler 导致日志倍增
    if logger.handlers:
        return logger

    # 1. 统一格式定义:时间戳 [级别] (模块名:行号) 消息正文
    formatter = logging.Formatter(
        fmt="%(asctime)s [%(levelname)s] (%(filename)s:%(lineno)d) %(message)s",
        datefmt="%Y-%m-%d %H:%M:%S"
    )

    # 2. 控制台 Handler:面向实时终端观察,只展示 INFO 及以上信息
    console_handler = logging.StreamHandler(sys.stdout)
    console_handler.setLevel(logging.INFO)
    console_handler.setFormatter(formatter)
    logger.addHandler(console_handler)

    # 3. 轮转文件 Handler:记录 DEBUG 细节,每个文件最大 5MB,保留 3 个备份
    file_handler = RotatingFileHandler(
        filename="app_runtime.log",
        maxBytes=5 * 1024 * 1024,
        backupCount=3,
        encoding="utf-8"
    )
    file_handler.setLevel(logging.DEBUG)
    file_handler.setFormatter(formatter)
    logger.addHandler(file_handler)

    return logger

# 模块内部获取命名记录器
logger = setup_application_logger("order_service")
2. 业务调用与异常回溯
在业务逻辑中,替代 print() 的标准写法如下:
def process_payment(order_id: str, amount: float) -> bool:
    logger.debug("开始处理订单支付流程: 订单号=%s, 金额=%.2f", order_id, amount)

    try:
        if amount <= 0:
            raise ValueError("支付金额非法,必须大于零")
        # 模拟业务操作
        logger.info("订单支付完成: 订单号=%s", order_id)
        return True
    except Exception as exc:
        # exc_info=True 会自动在日志末尾附加完整异常堆栈信息,无需手动打印 Traceback
        logger.error("订单支付失败: 订单号=%s, 错误详情=%s", order_id, exc, exc_info=True)
        return False
logging.basicConfig(),这会强行覆盖顶层调用者的全局日志配置。子模块应该始终使用 logger = logging.getLogger(__name__) 获取基于当前 Python 命名空间的子记录器,交由顶层主程序统一配置 Handler 与级别。
四、场景决策指南与选择边界
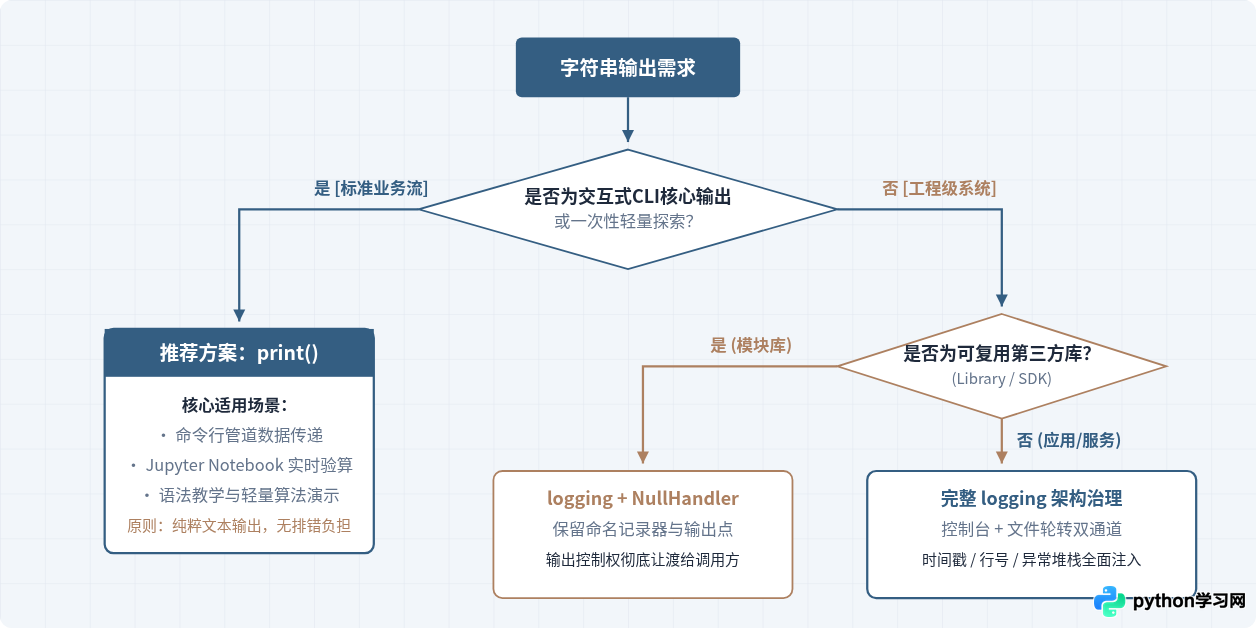
这并不意味着 print() 已经完全过时。在特定的场景下,print() 依然是正确且高效的选择;而在另一些场景下,使用 print() 则可能带来严重的维护隐患。
1. 什么时候坚决使用 print()?
- 交互式命令行工具(CLI)的主业务输出:例如编写一个类似
ls、cat或格式化计算工具。当工具的核心功能就是把最终计算出的文本呈现给用户或供管道符号|重定向给下游进程解析时,必须使用print()(或显式写入sys.stdout)。此时如果输出带有时间戳和级别的日志格式,反而会破坏自动化脚本的管道解析。 - 一次性本地探究与快速验证脚本:在 Jupyter Notebook 或本地临时探究某个算法逻辑、查看字典键名时,
print()零配置、零心智负担,是最直观的工具。 - 教学演示与核心概念讲解:在面向初学者的代码教学中,重点在于算法与语法机制,过度引入日志配置反而分散注意力。
2. 什么时候必须全面转向 logging?
- Web 后端接口与微服务(如 FastAPI、Django、Flask):并发请求下,所有业务事件必须按会话或请求 ID 进行追踪,且需写入中央日志收集器。
- 长时间运行的批处理与后台守护任务:服务可能会在无人值守的情况下连续运行数周,任何非预期错误、性能突增都必须有持久化文件作依据。
- 开源类库或公共 SDK 开发:对外发布的库不能擅自向终端
print()任何内容,这会打乱调用者的控制台排版。必须在库中获取命名 Logger 并挂载logging.NullHandler(),将输出控制权完全转交给使用该库的应用。
五、总结
在 Python 中,print() 与 logging 绝非单纯的语法偏好之争,而是体现了不同的设计意图与工程边界:
- 职责划分:将
print()严格限制在“用户交互与标准终端数据交付”的范围内,确保其输出始终是软件的核心业务产物。 - 运维治理:将系统运行状态、调试细节、异常跟踪与审计线索全面委托给
logging,充分利用其日志级别、Handler 路由与堆栈跟踪能力。 - 性能防护:在使用
logging输出高频字符串时,优先采用logger.debug("val: %s", v)的占位符语法,发挥惰性求值特性,避免无效计算拖慢核心业务执行。
建立这一清晰的分工意识,不仅能让初期的调试代码易于维护,更能保证系统在平滑演进到生产环境时具备可靠的观测性与稳定性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















