


Python入门100例代码详解:典型题目的思路分析与实现
针对经典Python入门100例中的核心典型题目,深入拆解排列组合、数列递推、数论判断与数据结构等题目的解题思路、代码实现与常见误区。
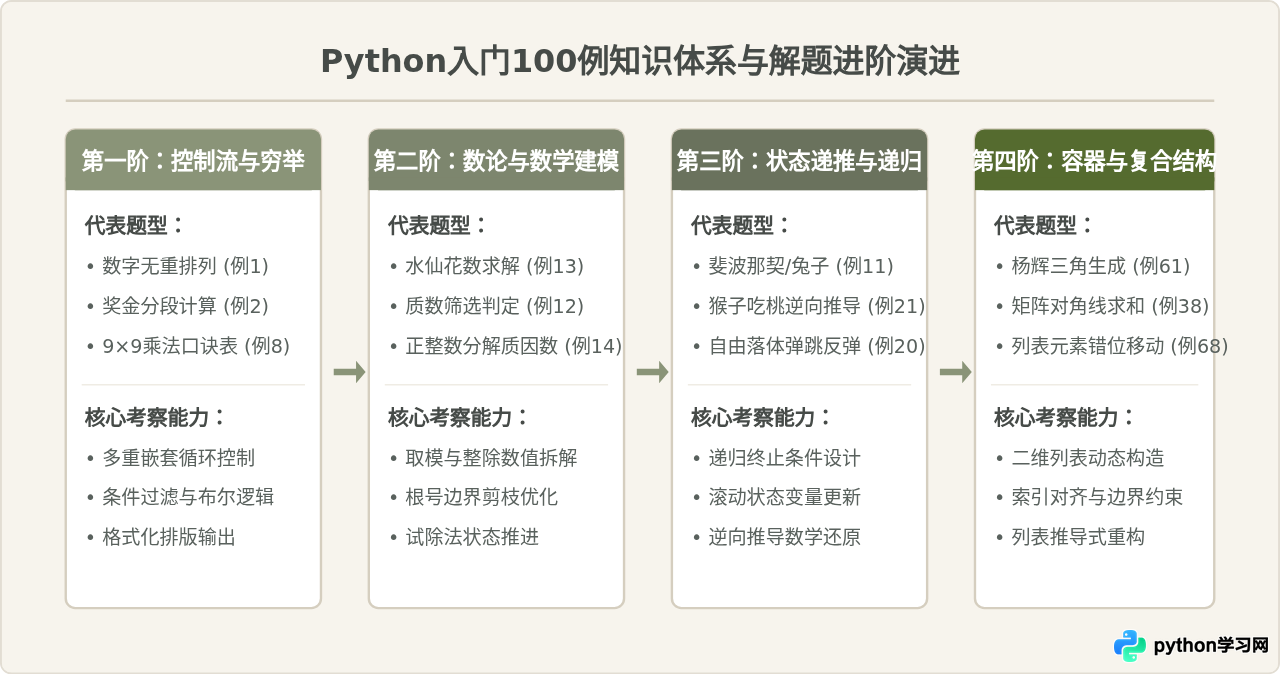
“Python入门100例”改编自经典的通用编程练手题库,涵盖了条件分支、循环结构、数学建模、递归调用以及基础数据结构等初学者必须掌握的知识模块。许多初学者在刷题时容易陷入“看答案觉得简单,合上代码自己写不出”的困境,其根源在于缺乏对题目约束条件的拆解能力与算法推导过程。本文选取100例中最高频、最具代表性的四大类核心题目,通过“问题本质分析—基础实现方案—Pythonic优化进阶—边界陷阱规避”的路径,带领读者理清代码背后的解题逻辑,从机械模仿过渡到自主编程。
一、题目剖析的标准工程思维
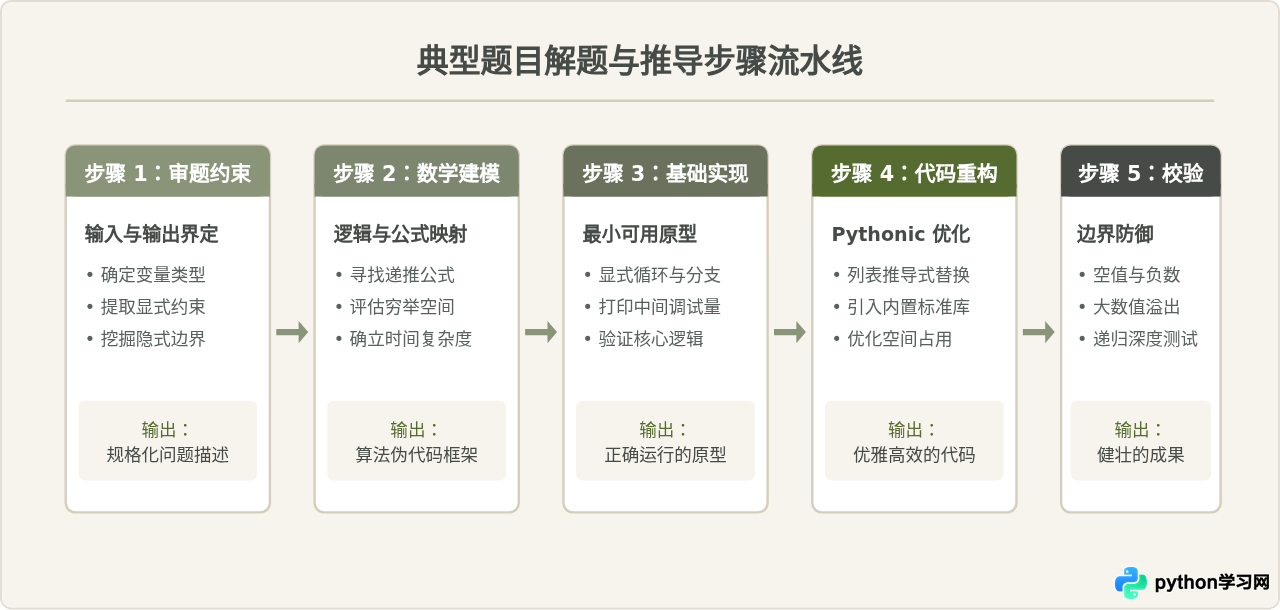
面对入门题目时,很多读者的习惯是立刻在编辑器里键入代码,边写边试。这种方式在简单题目中尚可凑出结果,但一旦遇到嵌套约束或边界条件,极易陷入逻辑混乱。标准的解题流程应当分为五个阶段:明确输入输出约束、建立数学或逻辑模型、使用基础语法编写最小可用原型、运用语言特质进行优化、最后通过边界用例进行验证。
二、典型题目一:排列组合与约束过滤
【原题复现·例1】 有 1、2、3、4 四个数字,能组成多少个互不相同且无重复数字的三位数?各是多少?
1. 思路推导
这是一个典型的有限离散空间穷举问题。三位数的百位、十位、个位分别来自数字集合 {1, 2, 3, 4}。若没有任何限制,排列总数为 4 × 4 × 4 = 64 种。但题目施加了一个硬性约束:“互不相同且无重复数字”。这意味着当百位选定后,十位不能与之相同;个位则既不能等于百位,也不能等于十位。因此在数学上其排列数为 P(4, 3) = 4 × 3 × 2 = 24 种。
2. 基础多重循环解法
最直接的思路是使用三重嵌套 for 循环分别枚举百位、十位和个位,然后在循环最内层通过 if 条件语句过滤掉重复项:
def generate_three_digits_basic():
    results = []
    # 百位数字
    for i in range(1, 5):
        # 十位数字
        for j in range(1, 5):
            # 个位数字
            for k in range(1, 5):
                # 过滤条件:三个位置互不相同
                if i != j and i != k and j != k:
                    number = i * 100 + j * 10 + k
                    results.append(number)
    return results

numbers = generate_three_digits_basic()
print(f"符合条件的三位数共 {len(numbers)} 个:")
print(numbers)
3. Pythonic 优化进阶
在 Python 中,标准库 itertools 专门用于处理迭代器与排列组合逻辑。使用 itertools.permutations 可以将算法的生成开销直接降到排列空间本身(只生成 24 种),完全跳过对无效三元组(64 - 24 = 40 种)的判断:
from itertools import permutations

def generate_three_digits_pythonic():
    digits = [1, 2, 3, 4]
    # 直接在生成器层面剔除重复项
    return [i * 100 + j * 10 + k for i, j, k in permutations(digits, 3)]

numbers_opt = generate_three_digits_pythonic()
print(f"优化版生成数量:{len(numbers_opt)}")注意事项:很多初学者在写条件过滤时习惯写 if i != j != k:。需要警惕的是,Python 支持链式比较,i != j != k 等价于 (i != j) and (j != k),它并没有检验 i != k!例如当 i=1, j=2, k=1 时,1 != 2 != 1 判定为 True,但这显然违反了三数互不相同的约束。因此必须显式写全 i != j and i != k and j != k,或者转换为集合长度判断 len({i, j, k}) == 3。
三、典型题目二:递推序列与状态转移
【原题复现·例11】 古典问题(兔子繁衍):有一对兔子,从出生后第 3 个月起每个月都生一对兔子,小兔子长到第三个月后每个月又生一对兔子。假如兔子都不死,问每个月的兔子总数为多少?
1. 数学模型解析
将每个月的兔子总对数按月份列出:1, 1, 2, 3, 5, 8, 13, 21... 这正是著名的斐波那契数列。其数学递推关系式为:当 n = 1 或 n = 2 时,F(n) = 1;当 n > 2 时,F(n) = F(n-1) + F(n-2)。
2. 递归实现与性能瓶颈
很多教材在讲解该题时会直接给出如下递归代码:
def fib_recursive(n: int) -> int:
    if n <= 0:
        raise ValueError("月份必须是正整数")
    if n == 1 or n == 2:
        return 1
    return fib_recursive(n - 1) + fib_recursive(n - 2)
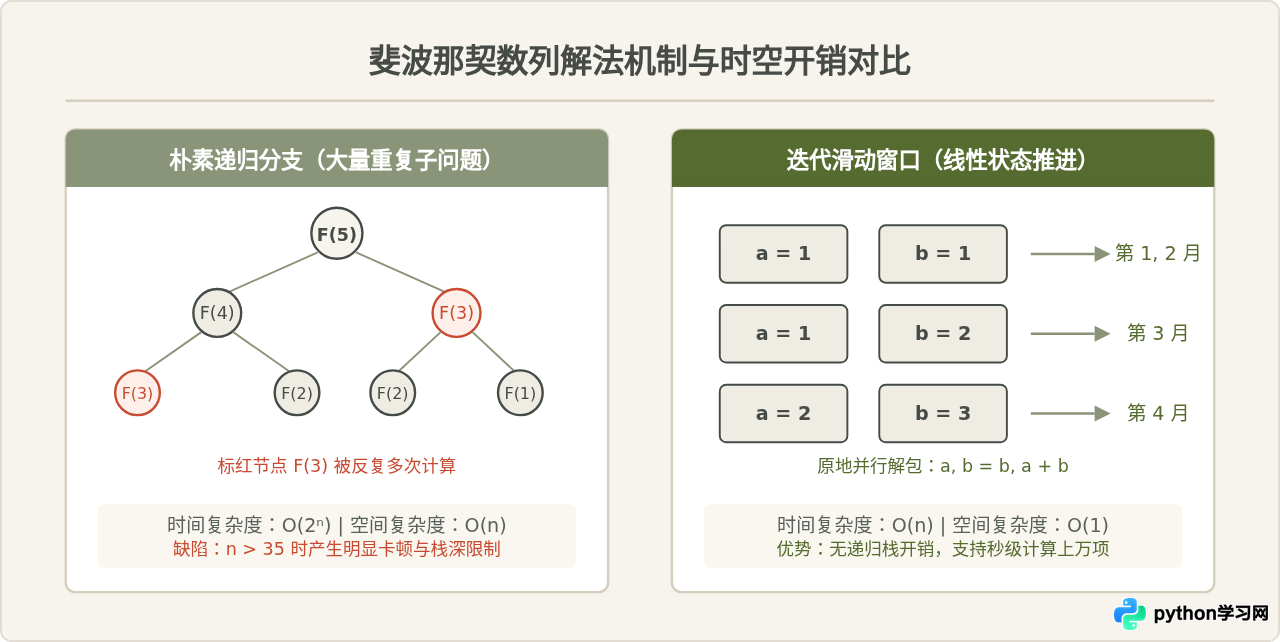
该实现完全还原了数学定义,但在工程上极不可取。由于每一层递归都裂变为两个子分支,计算过程中存在大量的重复求值(如图3所示,计算 F(5) 时 F(3) 被计算了两次,F(2) 被计算了三次)。其时间复杂度呈指数级 O(2ⁿ)。当计算 n = 40 时,函数调用次数已超过 20 亿次,耗时极长。
3. 原地迭代的最优实现
通过维护两个滚动变量,只需经过一次线性循环即可在 O(n) 时间与 O(1) 空间下得出结果。利用 Python 独有的多重赋值特性,可以避免引入临时变量 temp:
def fib_iterative(month: int) -> int:
    if month <= 0:
        return 0
    a, b = 1, 1
    for _ in range(month - 1):
        a, b = b, a + b
    return a

# 验证前 10 个月的繁衍结果
months_result = [fib_iterative(m) for m in range(1, 11)]
print("第 1 至 10 个月兔子总对数:", months_result)
四、典型题目三:数论判定与因数分解
【原题复现·例12】 判断 101 到 200 之间有多少个素数,并输出所有素数。
1. 素数判定的数学边界优化
素数是指在大于 1 的自然数中,除了 1 和它本身以外不再有其他因数的数。判断一个数 n 是否为素数,最原始的做法是从 2 一直测试到 n - 1。但如果存在因数分解 n = p × q,其中较小的因数 p 必然满足 p ≤ √n。因此,只需检查从 2 到 ⌊√n⌋ 的整数能否整除 n 即可,这直接将时间复杂度从 O(n) 降低至 O(√n)。
2. Python 特色 for...else 结构的应用
在其他语言中,通常需要设置布尔标记变量 is_prime = True,循环内发现整除则设为 False 并 break,循环结束后再判断该标记。Python 提供了专有的 for...else 语法:当且仅当 for 循环完整遍历且未触发 break 时,执行 else 块。这使得代码异常简练:
import math

def find_primes(start: int, end: int) -> list[int]:
    primes = []
    for num in range(start, end + 1):
        if num < 2:
            continue
        # 边界只取到 int(sqrt(num)) + 1
        limit = int(math.isqrt(num))
        for factor in range(2, limit + 1):
            if num % factor == 0:
                break  # 发现非素数,提前退出
        else:
            # 循环正常走完,说明没有遇到因子
            primes.append(num)
    return primes

result = find_primes(101, 200)
print(f"101 到 200 之间共有 {len(result)} 个素数:")
print(result)
五、典型题目四:结构化数据与杨辉三角
【原题复现·例61】 打印出杨辉三角形(要求打印出前 10 行)。
1. 结构与规律解析
杨辉三角的每个数字等于它上一行的左右两个数字之和。具体规则如下:
- 第 1 行仅有 1 个元素:
[1] - 每一行的两端均为 1。
- 从第 3 行开始,中间第 j 个元素满足递推关系:
row[j] = prev_row[j - 1] + prev_row[j]。
2. 代码构建与错位相加法
构造杨辉三角通常有两种思路:一是预先分配固定大小的双重数组并更新内部值;二是利用错位相加法。例如第 3 行是 [1, 2, 1],如果将其分别在两端补 0,得到 [0, 1, 2, 1] 和 [1, 2, 1, 0],对应位相加恰好就是第 4 行 [1, 3, 3, 1]。下面使用通俗易懂的逐行递推法:
def generate_pascal_triangle(num_rows: int) -> list[list[int]]:
    if num_rows <= 0:
        return []
    triangle = [[1]]
    for i in range(1, num_rows):
        prev = triangle[-1]
        # 首尾为1,中间元素由上一行相邻两数相加而成
        current = [1] + [prev[j] + prev[j + 1] for j in range(len(prev) - 1)] + [1]
        triangle.append(current)
    return triangle

def print_pascal_triangle(triangle: list[list[int]]):
    # 计算最底行的最大宽度用于居中排版
    max_len = len("   ".join(map(str, triangle[-1])))
    for row in triangle:
        row_str = "   ".join(map(str, row))
        print(row_str.center(max_len))

pascal = generate_pascal_triangle(8)
print_pascal_triangle(pascal)
六、新手高频易混淆概念深度辨析
在练习 100 例的过程中,初学者最常犯的错误并非源自算法思路本身,而是对 Python 的底层对象机制理解偏差。以下是三个典型误区及其纠偏:
| 混淆场景 | 直觉误区 | 实际底层运行机制 | 正确规范做法 |
|---|---|---|---|
| 二维列表初始化 | 写 [[0]*3]*3 快速生成 3×3 矩阵 |
外层列表包含了 3 个对同一个子列表的浅拷贝引用,修改一个元素会导致整列一起变动 | 使用列表推导式:[[0 for _ in range(3)] for _ in range(3)] |
| 循环遍历中删除元素 | 在 for item in my_list: 中直接执行 my_list.remove(item) |
删除元素后列表内部索引立即前移,迭代器游标漏检相邻的后继元素 | 遍历切片副本 for item in my_list[:]: 或直接使用推导式过滤 |
| 函数默认参数设为容器 | 在函数定义中设置 def func(val, target=[]) |
默认参数对象在模块加载时被初始化一次,后续多次调用会持续共享同一个列表 | 设置为不可变占位符:def func(val, target=None): if target is None: target = [] |
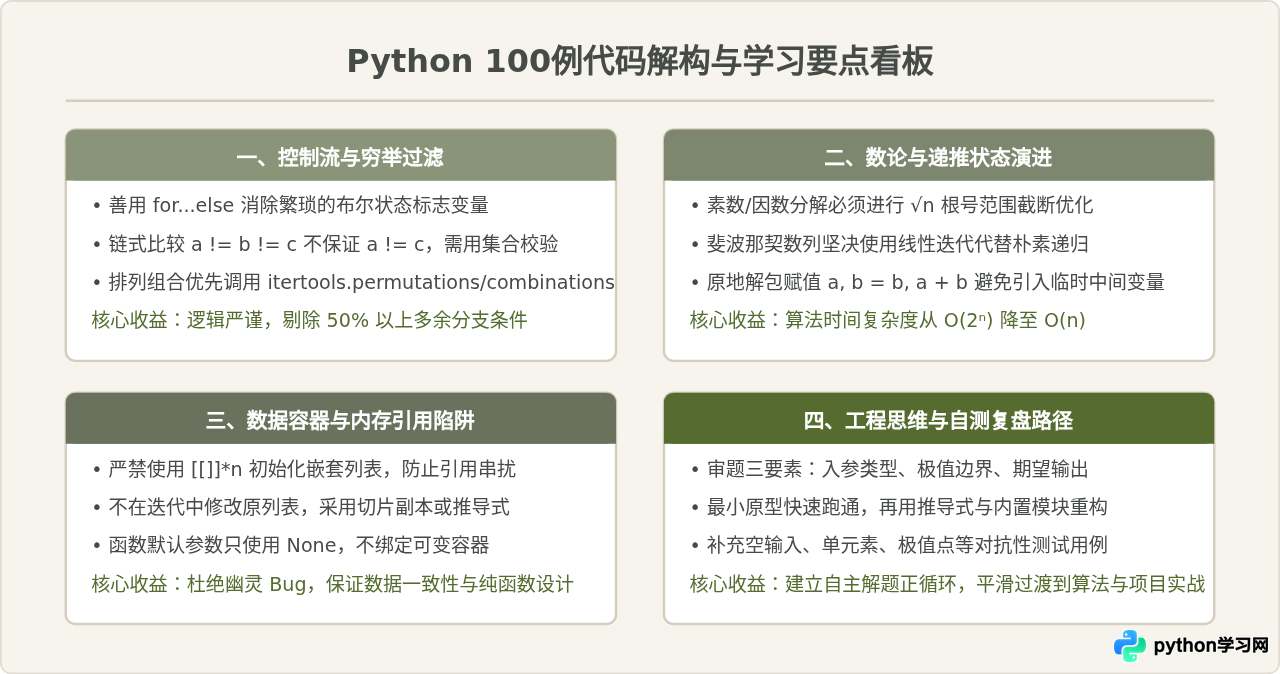
七、总结:如何高效刷完100例并跃迁到实际开发
完成 Python 100 例的目标绝不是为了背诵 100 份标准答案,而是为了形成规范的算法与编码反射。每做一道题,建议读者按照以下四个步骤复盘:
- 脱离答案手写原型:仅凭题目描述,用最直白的循环与判断语句在本地运行通过。
- 空间与时间度量:观察代码中有无不必要的多重循环?是否有重复计算的子问题?范围是否能够进一步压缩?
- Pythonic 重构:尝试将传统写法替换为 Python 的特色语法(如列表推导式、生成器表达式、内置的高阶函数或
collections/itertools模块)。 - 防御性测试:主动传入 0、负数、空列表、极大数值等边界参数,检验函数是否具备充分的健壮性。
通过这套系统化的解题方法,100 道练习题将成为读者打通 Python 基础语法与工程化算法思维的坚实跳板。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















