


Python生成指定范围内不重复随机数的方法
详细讲解在Python中生成指定范围内不重复随机数的标准方法与工程实践,涵盖random.sample、random.shuffle及NumPy等方案的适用场景、代码实现与常见陷阱。
random.sample() 结合 range() 对象。对于需要将整个区间全部元素完全打乱的场景,可以使用 random.shuffle();若处于科学计算或超大规模数据抽样场景,则推荐使用 numpy.random.choice(replace=False)。
一、核心标准方法:random.sample()
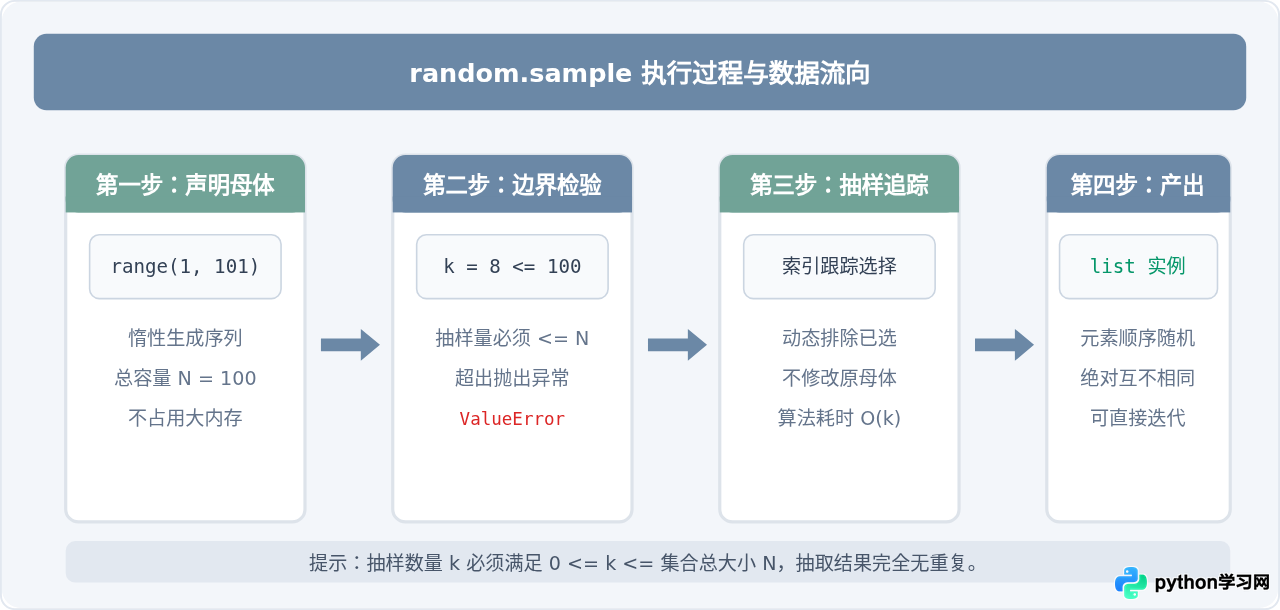
当读者需要在某一范围内(例如 1 到 100 之间)抽取固定个数(例如 10 个)不重复的整数时,random.sample(population, k) 是 Python 官方推荐的首选方案。该函数执行的是“无放回抽样”(Sampling without replacement),确保抽出的每一个元素在结果列表中只出现一次。
import random

# 目标:在 [1, 100] 闭区间内抽取 8 个不重复的随机整数
# 注意 range(1, 101) 包含 1,不包含 101
start = 1
end = 100
count = 8

# 执行无放回抽样
result = random.sample(range(start, end + 1), count)

print("生成的不重复随机数列表:", result)
# 示例输出:[73, 14, 92, 5, 38, 61, 84, 29]
这里有一个关键的技术细节:range() 在 Python 3 中是一个惰性求值的序列对象,它只保存起始点、终点和步长,并不会在内存中创建包含成千上万个数字的真实列表。random.sample() 内部针对 range 对象做了深度优化,即使区间范围是 range(1, 100000000),也不会产生巨大的内存占用。
二、新手常见陷阱:为什么不要用 while 循环和 set
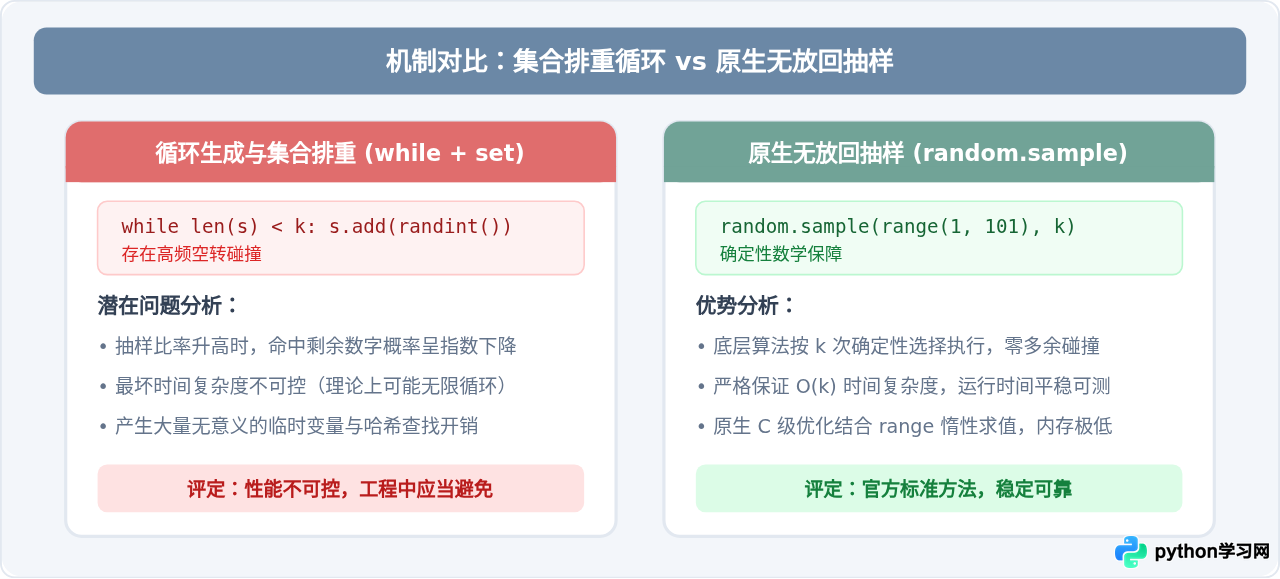
初学者在实现这一需求时,经常会下意识写出如下逻辑:使用 while 循环不断调用 random.randint(),将生成的数字加入 set 集合中排重,直到集合长度达到目标数量:
# !!!不推荐的低效写法!!!
import random

target_count = 95
result_set = set()

# 在 [1, 100] 范围内抽取 95 个不重复数字
while len(result_set) < target_count:
    num = random.randint(1, 100)
    result_set.add(num)  # 当集合接近饱和时,大量随机数发生碰撞并被丢弃
这种写法存在严重的哈希碰撞与死循环风险。当抽样数量较小(如 100 个里抽 3 个)时碰撞概率尚不明显;但当抽取数量接近范围总数(如 100 个里抽取 98 个)时,集合中已存在大部分数字,后续每一次 randint() 命中未抽取数字的概率急剧下降。
三、其他业务场景的扩展方法
除了从母体中抽取部分样本外,实际开发中还有另外两种常见衍生需求:需要全量打乱区间、以及数据科学中的大规模并行随机采样。针对不同需求,应选择最契合的工具函数。
1. 全量乱序排列:random.shuffle()
如果需求不是“从指定范围里取几个”,而是“把指定范围里的每一个数字全部取出,但顺序必须打乱”(例如洗牌、随机播放整个歌单),使用 random.shuffle() 是最直接的方法。该函数会对传入的列表进行原地就地乱序(In-place Shuffle),无需创建新列表。
import random

# 创建包含范围内全部数字的真实列表
num_list = list(range(1, 11))
print("初始列表:", num_list)

# 原地打乱元素顺序(注意:shuffle 直接修改原列表,返回值为 None)
random.shuffle(num_list)

print("乱序后列表:", num_list)
# 示例输出:[4, 8, 1, 9, 2, 7, 10, 3, 5, 6]
2. 科学计算与大规模数组:numpy.random.choice()
如果工程项目中已经引入了 NumPy,或者需要从千万级范围中抽取海量不重复样本,NumPy 提供了更高性能的向量化支持。在 NumPy 新版 API 中,推荐通过 default_rng() 使用 choice(..., replace=False):
import numpy as np

# 创建推荐的独立随机数生成器
rng = np.random.default_rng()

# 在 [10, 100) 区间内无放回抽取 6 个数字
# replace=False 表示不重复抽取
samples = rng.choice(np.arange(10, 100), size=6, replace=False)

print("NumPy 随机抽样结果:", samples)
# 示例输出:array([45, 88, 12, 63, 79, 31])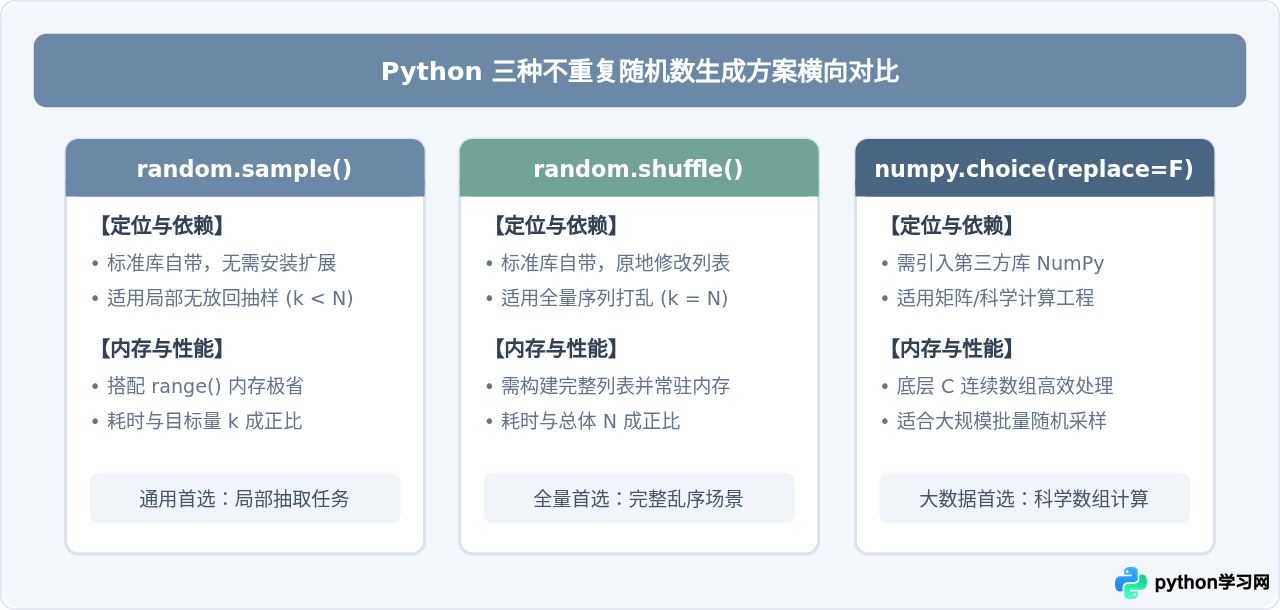
四、关键细节与工程注意事项
在实际生产环境中,处理随机数还必须防范由于参数越界、类型不符或不可复现带来的潜在隐患:
1. 抽样数量超出母体容量(ValueError)
无放回抽样的数学前提是:样本抽取量不能大于总体元素个数。例如在 1 到 10 之间总共只有 10 个整数,如果你请求抽取 11 个不重复随机数,Python 会直接抛出 ValueError: Sample larger than population or is negative。在封装通用函数时,应当先对参数做前置校验:
import random

def safe_random_sample(start, end, count):
    """安全获取指定闭区间内的不重复随机整数列表"""
    # 计算区间包含的整数总数
    population_size = end - start + 1

    if count < 0:
        raise ValueError("抽取数量 count 不能为负数")
    if count > population_size:
        raise ValueError(
            f"抽取数量 {count} 超出区间容量 {population_size},无法保证不重复"
        )

    return random.sample(range(start, end + 1), count)

# 正常调用
print("安全抽样结果:", safe_random_sample(1, 20, 5))
2. 结果的可复现性(设置随机种子)
在编写单元测试、模拟实验或教学演示时,如果希望每次运行程序时生成完全一致的“随机数序列”,可以使用 random.seed() 固定随机发生器的初始状态:
import random

# 固定随机种子
random.seed(42)
print("第一次抽取:", random.sample(range(1, 100), 5))

# 重新设置相同的种子
random.seed(42)
print("第二次抽取:", random.sample(range(1, 100), 5))
# 输出结果将完全一致:[64, 4, 28, 23, 68]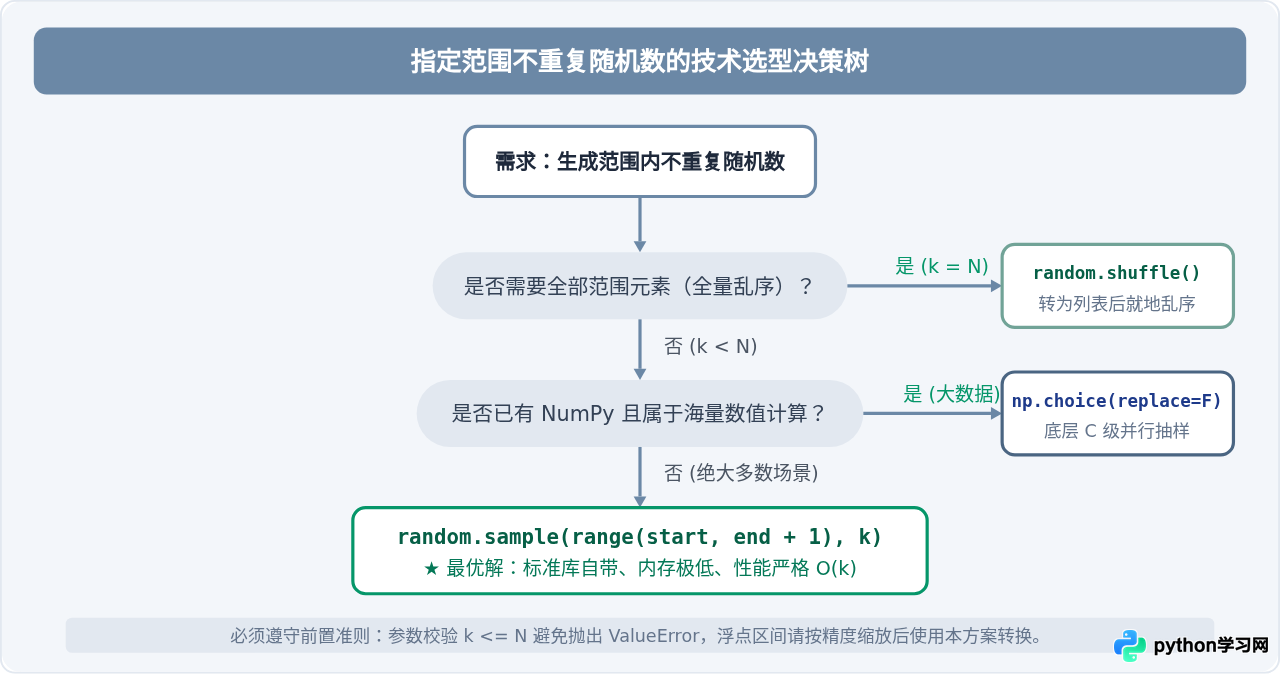
五、总结
在 Python 中生成指定区间内不重复的随机数,核心结论可以归纳为三句话:
- 常规抽样首选:使用
random.sample(range(start, end + 1), k),无需额外依赖,时间复杂度平稳,内存开销最小。 - 全量乱序使用:先通过
list(range(...))构建列表,再调用random.shuffle()进行原地洗牌。 - 严禁反模式写法:不要使用
while循环结合集合set进行碰撞排重,以免因碰撞率失控导致程序性能严重衰减甚至假死。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















