


零基础学Python能从事哪些工作
针对零基础学习Python的就业方向与职业路径进行实用深度解析,涵盖数据分析、自动化测试、Web后端开发以及复合型效率岗位的技能要求、真实工作流与避坑建议。
一、零基础切入的四类核心工作方向
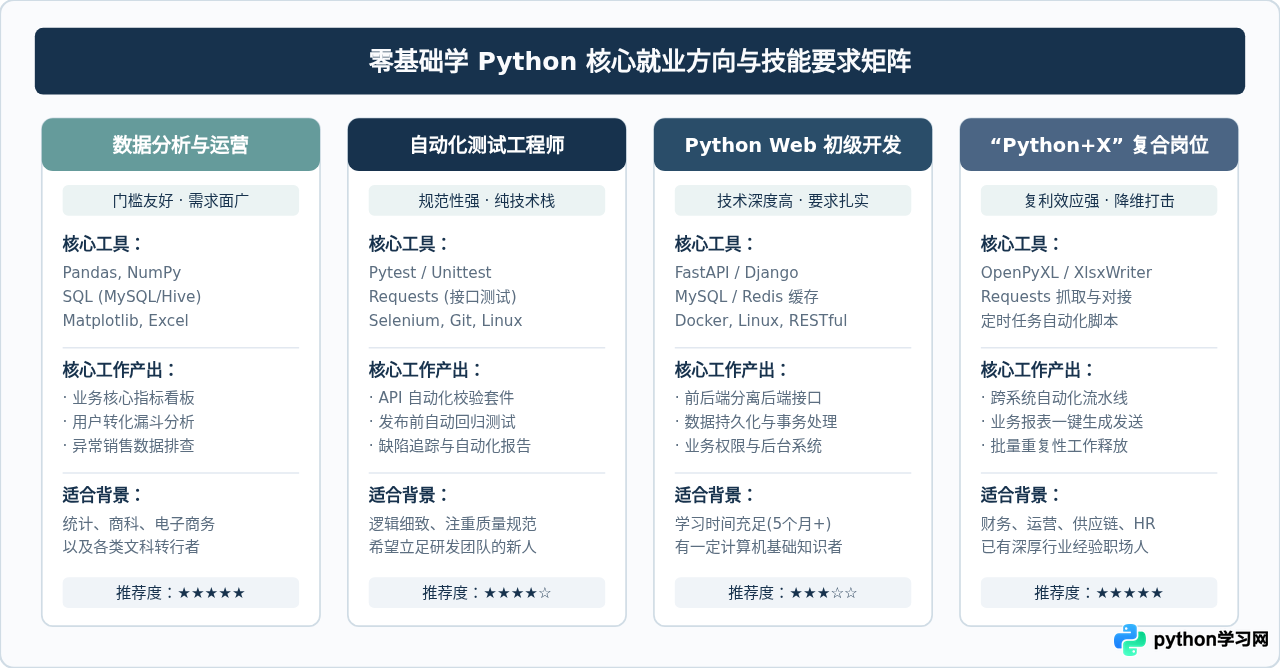
很多零基础初学者容易产生一个误解,认为学了 Python 必须成为全职软件工程师。实际上,Python 凭借其极高的表达效率和强大的第三方生态,在职场中覆盖的就业空间远比传统软件工程更广阔。根据技术深度与业务关联度,主要有以下四个切入方向:
1. 数据分析与数据运营(最广泛的跨专业切入点)
数据分析是目前接纳非计算机专业学习者最多的方向。企业每天产生大量订单、访问、库存和营销流水,传统的 Excel 在处理超过数十万行数据时容易卡顿崩溃,且难以建立自动化的处理流水线。
- 岗位职责:负责日常业务数据的提取、清洗合并、异常值剔除、指标体系计算,并制作可视化报表输出业务洞察。
- 必备技术栈:Python 核心语法、Pandas、NumPy、Matplotlib 或 Seaborn、SQL 查询语言。
- 适合人群:商科、财务、统计、市场或电商背景的跨专业学习者,熟悉业务逻辑能极大弥补纯编程经验的不足。
2. 自动化测试工程师(门槛相对平缓的技术岗位)
软件测试正在由纯手工的点点点向自动化转变。自动化测试工程师的工作不是编写庞大的系统,而是编写测试脚本来验证系统功能是否稳定。
- 岗位职责:编写接口测试脚本与 UI 自动化脚本,搭建持续集成的测试用例集,执行回归测试并输出测试报告。
- 必备技术栈:Python 基础、Requests、Pytest/Unittest 测试框架、Selenium 或 Playwright、Git 版本管理。
- 适合人群:逻辑严谨、细致、希望从事纯 IT 研发团队工作但短期内算法与系统架构能力较弱的新人。
3. Python Web 初级开发工程师(标准软件研发岗)
负责 Web 应用、企业内部后台系统或 SaaS 平台的服务端接口开发。该岗位对计算机基础要求较为全面,适合投入时间充分、学习扎实的求职者。
- 岗位职责:编写 RESTful 风格的 API 接口,设计关系型数据库表结构,实现鉴权、业务逻辑处理与三方接口对接。
- 必备技术栈:FastAPI 或 Django、MySQL/PostgreSQL、Redis 缓存基础、Linux 常用操作命令。
- 适合人群:脱产学习时间充足(通常需 5-6 个月以上)、乐于深究计算机网络与软件工程架构的学习者。
4. “Python + X” 复合型业务岗位(阻力最小的高收益路径)
无需从零更换行业赛道,而是留在原有的财务、人事、供应链或跨境电商领域,将 Python 作为“超级计算器与自动化助手”。
- 岗位职责:编写跨系统对账脚本、自动批量提取发票与凭证、定时抓取竞品公开行情、自动化批量生成报告。
- 优势:在懂业务的人里你懂自动化,在懂代码的人里你懂业务痛点,招聘和晋升时往往更具独特竞争力。
二、零基础到就业的技术能力成长阶梯
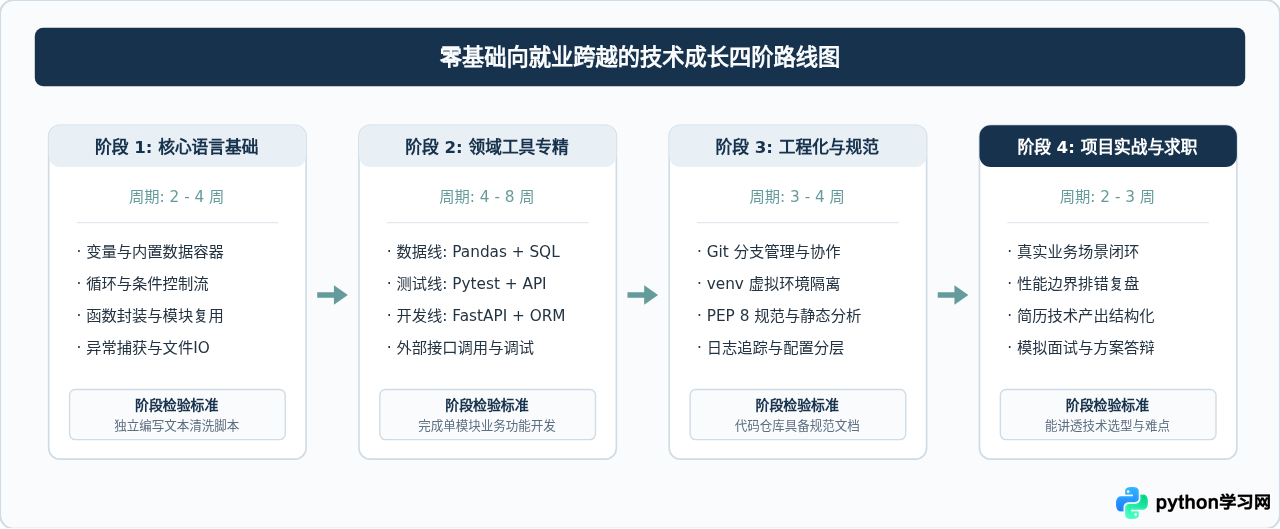
明确了目标岗位后,零基础学习者必须遵循一套循序渐进的进阶路线。避免一上来就接触深度学习算法或复杂的分布式微服务,把有限的精力聚焦在真正能形成生产力的核心环节:
- 第一阶段:语言核心与编程思维(建议周期:2-4 周)
掌握变量、基本数据结构(列表、字典、集合)、分支与循环控制、函数封装以及模块导入。检验标准:能够不借助外部模板,独立编写处理文本文件、计算统计数值或批量重命名文件的脚本。 - 第二阶段:方向专精工具链(建议周期:4-8 周)
根据求职方向做减法:- 走数据分析:重点精通
Pandas数据框切片、分组聚合(groupby)、缺失值处理与 SQL 联合查询; - 走自动化测试:重点掌握
Requests库的参数传递与响应解析,熟练编写Pytest断言规则与 fixture 装置; - 走后端开发:重点学习
FastAPI的依赖注入、Pydantic 数据验证模型以及关系数据库 ORM(如 SQLAlchemy)。
- 走数据分析:重点精通
- 第三阶段:工程化素养与项目规范(建议周期:3-4 周)
零基础求职者与正规开发者的最大差距往往不在代码逻辑,而在工程习惯。必须掌握虚拟环境管理(venv)、版本管理工具(Git)、代码规范(PEP 8)以及日志模块(logging)。检验标准:具备把一个项目规范打包、撰写清晰 README、配置依赖文件(requirements.txt)并在另一台干净机器上运行起来的能力。 - 第四阶段:业务项目沉淀与求职交付(建议周期:2-3 周)
完成 1-2 个端到端的完整项目。数据分析岗需附带可视化看板与业务结论报告;开发/测试岗需在 GitHub 提交结构规范的代码仓库与持续集成运行截图。
三、核心岗位日常技术工作流与代码实现
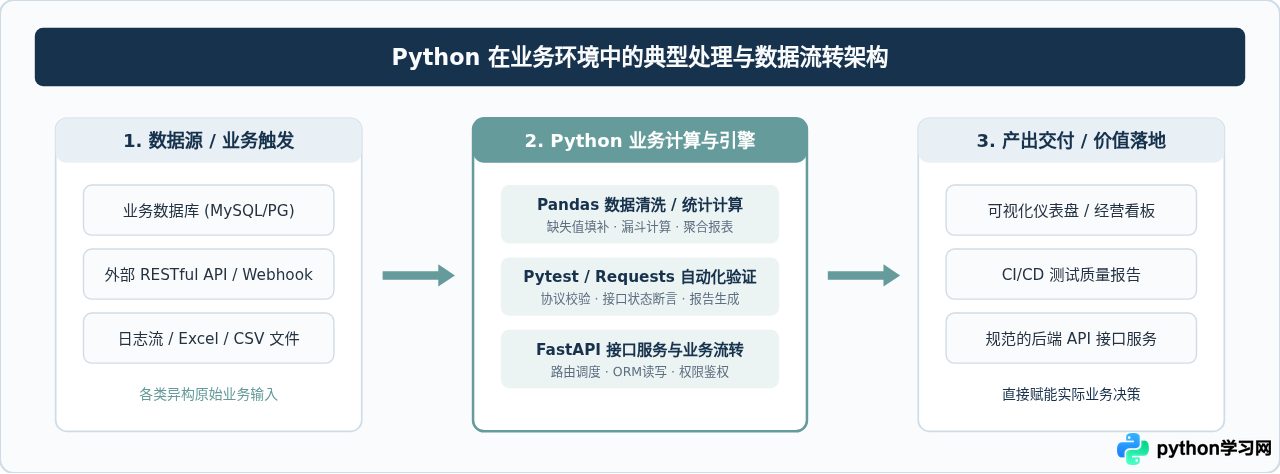
为了让读者对这些岗位的工作内容有具象的认识,下面通过两个最主流方向的真实代码任务,演示初级从业者在实际业务中究竟在写什么。
场景 1:数据分析师的日常——多源数据聚合与指标核算
在电商业务中,销售数据往往散落在不同的流水表中。初级数据分析师需要快速提取特定品类的订单,剔除退款数据,并计算各销售渠道的实付金额与客单价:
import pandas as pd

def calculate_channel_performance(orders_file: str) -> pd.DataFrame:
    # 1. 加载订单源数据并过滤退款状态
    df = pd.read_csv(orders_file, encoding='utf-8')
    valid_orders = df[df['status'] != 'REFUNDED'].copy()

    # 2. 清洗数值字段,计算实付金额
    valid_orders['pay_amount'] = valid_orders['price'] * valid_orders['quantity'] - valid_orders['discount']

    # 3. 按渠道汇总:订单量、总销售额、平均客单价
    summary = valid_orders.groupby('channel').agg(
        total_orders=('order_id', 'nunique'),
        gmv=('pay_amount', 'sum'),
        avg_order_value=('pay_amount', 'mean')
    ).reset_index()

    # 4. 格式化并按销售额降序排序
    summary['gmv'] = summary['gmv'].round(2)
    summary['avg_order_value'] = summary['avg_order_value'].round(2)
    return summary.sort_values(by='gmv', ascending=False)

if __name__ == '__main__':
    # 执行分析并输出结果
    result = calculate_channel_performance('sales_october.csv')
    print("渠道经营数据汇总:")
    print(result.to_string(index=False))
代码解析:这段代码运用了 Pandas 的核心切片与 groupby().agg() 聚合机制。相比手动操作表格,脚本具备完全的可复用性,下个月新数据产生时只需一秒钟即可重新生成报告,这就是技术为业务带来的核心价值。
场景 2:自动化测试工程师的日常——核心接口自动化断言
软件产品每次上线发布前,测试人员需要确保登录、鉴权与核心下单接口完全正常运行。通过编写自动化断言脚本,可省去数十次重复的手工点击:
import requests
import pytest

BASE_URL = "https://api.example.com/v1"

class TestOrderAPI:
    @pytest.fixture(autouse=True)
    def setup_session(self):
        # 统一准备测试会话与测试凭据
        self.session = requests.Session()
        self.headers = {"Authorization": "Bearer test_token_xyz"}

    def test_create_order_success(self):
        # 1. 构造请求载荷
        payload = {
            "sku_id": 100203,
            "quantity": 1,
            "coupon_code": "DISCOUNT10"
        }

        # 2. 发起 POST 接口调用
        response = self.session.post(f"{BASE_URL}/orders", json=payload, headers=self.headers, timeout=5)

        # 3. 严格断言:HTTP状态码、业务返回码及核心字段完整性
        assert response.status_code == 201, f"预期 201 但返回了 {response.status_code}"
        data = response.json()
        assert data.get("code") == 0, f"业务错误: {data.get('message')}"
        assert "order_id" in data.get("data", {}), "响应报文缺失 order_id"
        assert data["data"]["status"] == "PENDING_PAY", "订单创建初始状态异常"
代码解析:结合 requests 与 pytest,脚本对网络状态、数据协议格式与业务状态字段进行了多层防御式校验。自动化测试工程师的核心技能便是将产品业务逻辑翻译成这样严密的断言规则。
四、零基础求职必须避开的四个认知误区
在跨行业学习 Python 的过程中,不少初学者因为信息不对称踩进死胡同,浪费了宝贵的求职时间窗口。以下四个误区需要高度警惕:
.py 脚本,更不了解 Linux 基本指令与关系型数据库 SQL。企业真实的生产环境运行在云端服务器与关系数据库之上,掌握基础的 SQL 查询与 Linux 命令是求职的硬性门槛。
| 求职方向 | 初级薪资与门槛预期 | 最关键的敲门砖 | 核心风险与挑战 |
|---|---|---|---|
| 初级数据分析师 | 门槛中等 / 需求基数大 | SQL 熟练度 + 业务理解能力 + Pandas 清洗报告 | 容易沦为单纯取数工具人,需培养商业洞察 |
| 自动化测试 | 门槛中等 / 薪资待遇稳定 | Pytest 框架 + 接口规范 + 缺陷追踪严密性 | 前期需要积累手工业务测试经验才能写好用例 |
| 初级 Web 后端 | 门槛偏高 / 竞争较激烈 | 数据库设计与优化 + FastAPI/Django + Linux部署 | 大厂校招偏好科班,中小厂注重即战力 |
| 业务复合岗 (Python+X) | 门槛最低 / 稳定性极高 | 原行业业务深度 + 自动化提效脚本案例 | 需在企业内部主动发掘痛点,自我驱动 |
五、求职路径决策自测指南与总结
面对不同的背景条件与时间预算,应当如何科学规划个人的切入点?可以通过以下决策树来梳理你的最佳求职策略:
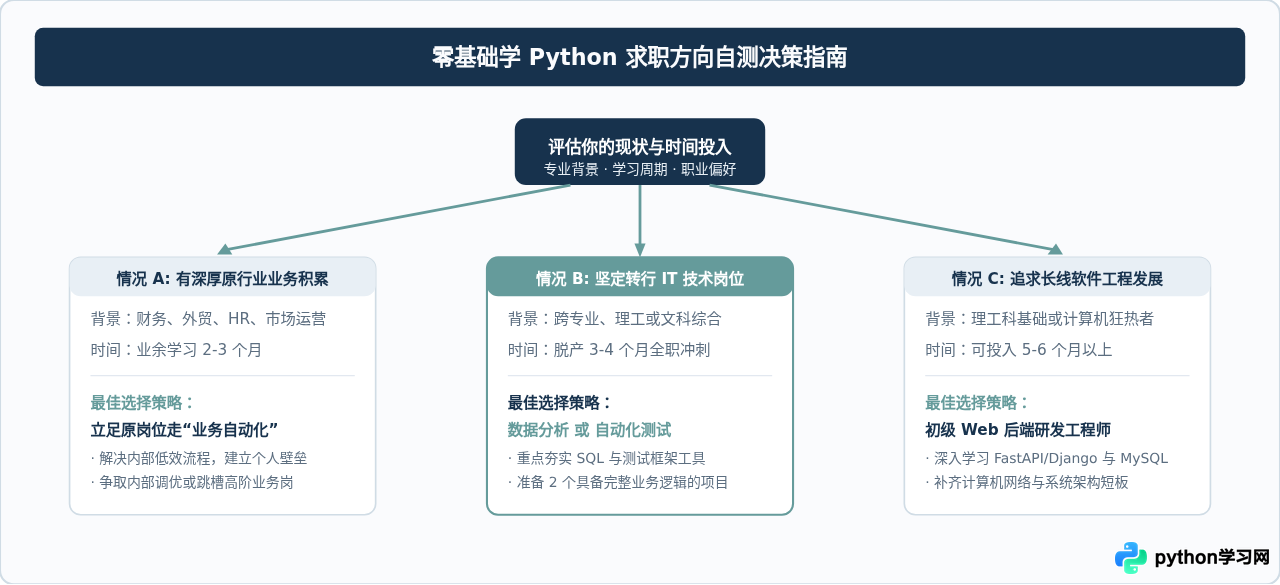
综上所述,零基础学 Python 不必背负“必须成为全栈架构师”的沉重压力。Python 最大的魅力在于它将编程从一门孤立的技术工种,变成了人人可用的现代效率工具。先从与自己原有优势结合最紧密的领域切入,用代码真正解决一个具体、真实的问题,这才是零基础学习者最具确定性、也最稳健的就业之路。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















