


Python遍历数字时怎么同时获取索引
详细讲解在Python遍历数字或数字序列时如何同时获取元素索引。介绍内置函数enumerate的运行原理、操作步骤、自定义起始下标及与传统遍历方式的对比。
在 Python 中遍历数字时,无论是遍历包含具体数值的列表,还是遍历由 range() 生成的数字序列,最直接且符合语言设计规范的做法是使用内置函数 enumerate()。它会在每次迭代时将“当前下标位置”和“当前数值”打包成一个二元元组返回,开发者可以通过循环变量直接进行解包,完全不需要额外定义外部计数变量或通过下标反查元素。
一、核心机制:enumerate() 是如何工作的
许多初学编程的开发者习惯用一个外部变量记录当前循环次数,或者通过类似 C 语言的方式先计算长度再用下标访问。而在 Python 中,迭代器是直接产生元素本身的。为了同时获取元素在序列中的位置,Python 提供了 enumerate() 函数。
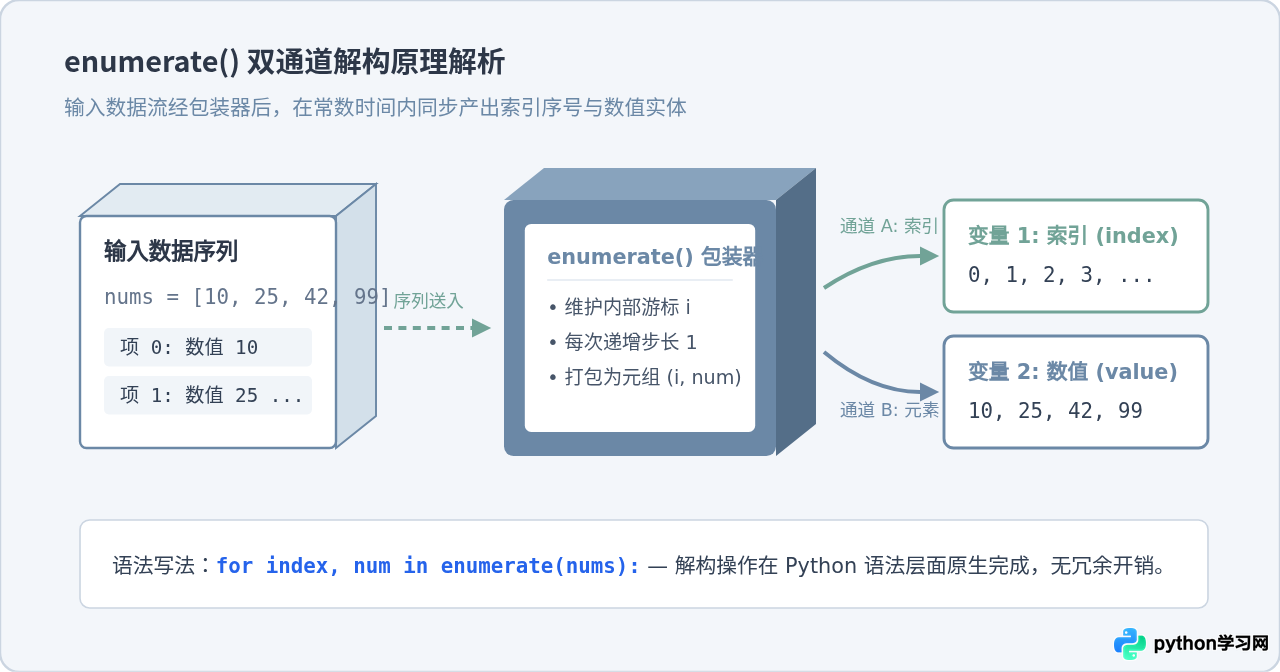
enumerate() 接受任意可迭代对象作为输入,在底层维护一个自增计数器。每当循环请求下一个元素时,它会输出一个形如 (index, element) 的元组。通过在 for 语句中使用两个变量,即可一次性完成元组解包。
二、标准调用步骤与典型场景
在日常开发中,遍历数字通常分为两类场景:一是遍历已有的“数字集合”(如温度、价格、编号列表);二是遍历由 range() 动态生成的“连续数字区间”。两种场景的处理方式保持高度一致。
1. 遍历数字列表的基础用法
假设我们有一个记录每周温度数据的列表,在遍历时既需要打印具体的温度,又需要标明是第几天或第几个位置:
# 场景一:遍历数字列表
temperatures = [21.5, 23.0, 19.8, 25.4, 22.1]

for index, temp in enumerate(temperatures):
    print(f"索引位置: {index}, 对应温度: {temp}℃")
运行结果示例:
索引位置: 0, 对应温度: 21.5℃
索引位置: 1, 对应温度: 23.0℃
索引位置: 2, 对应温度: 19.8℃
索引位置: 3, 对应温度: 25.4℃
索引位置: 4, 对应温度: 22.1℃
2. 遍历 range() 生成的纯数字区间
如果当前没有预先存好的列表,而是通过 range() 生成一系列等差数字,同样可以直接传入 enumerate()。这在需要记录“第几次执行某段步长计算”时非常有用:
# 场景二:遍历步长为 5 的数字区间
for step, num in enumerate(range(100, 130, 5)):
    print(f"执行轮次: {step}, 当前计算数字: {num}")
运行结果示例:
执行轮次: 0, 当前计算数字: 100
执行轮次: 1, 当前计算数字: 105
执行轮次: 2, 当前计算数字: 110
执行轮次: 3, 当前计算数字: 115
执行轮次: 4, 当前计算数字: 120
执行轮次: 5, 当前计算数字: 125
在这里,变量 step 始终从 0 顺序递增(代表循环轮次),而 num 则是 range 产出的实际目标数值(100, 105, 110...)。两个变量分工清晰,互不干扰。
3. 自定义起始索引参数 start
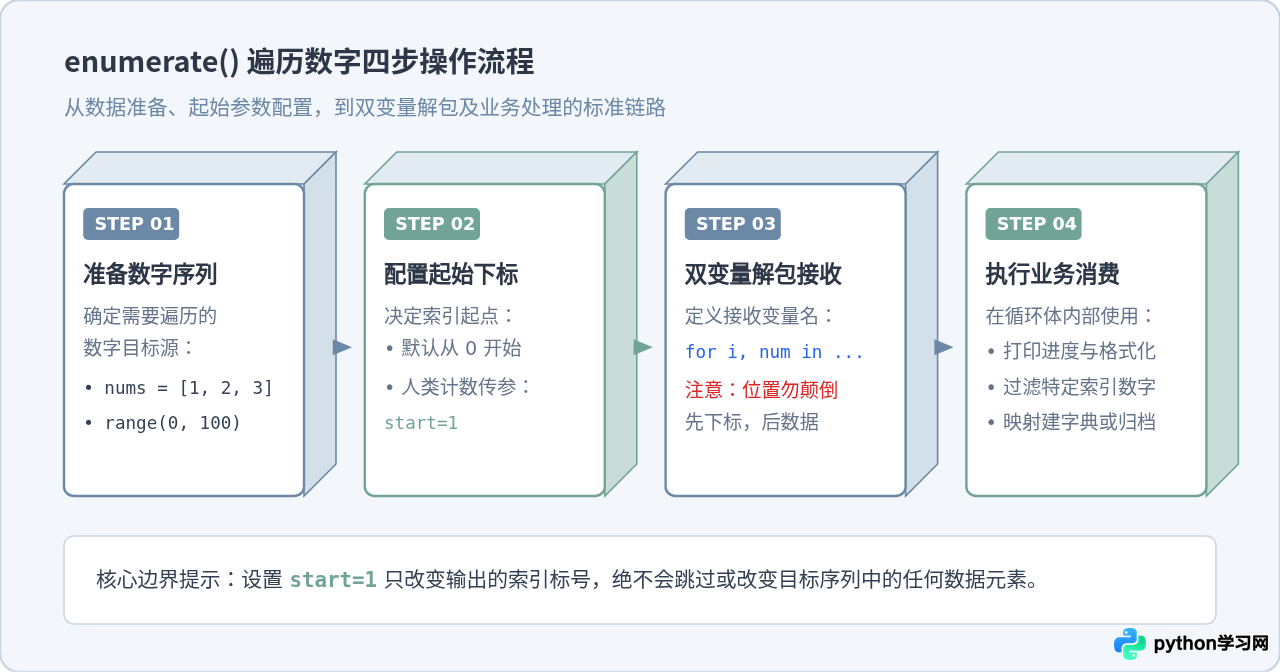
在展示排版或面向人类阅读的输出时,序列往往从 1 开始编号。很多开发者会习惯性在打印时写 index + 1,但更规范优雅的做法是直接利用 enumerate() 的第二个参数 start:
scores = [88, 92, 79, 95]

# 指定 start=1,计数从 1 开始
for rank, score in enumerate(scores, start=1):
    print(f"第 {rank} 名得分: {score}")
三、方案对比:为什么不推荐下标反查或手动计数
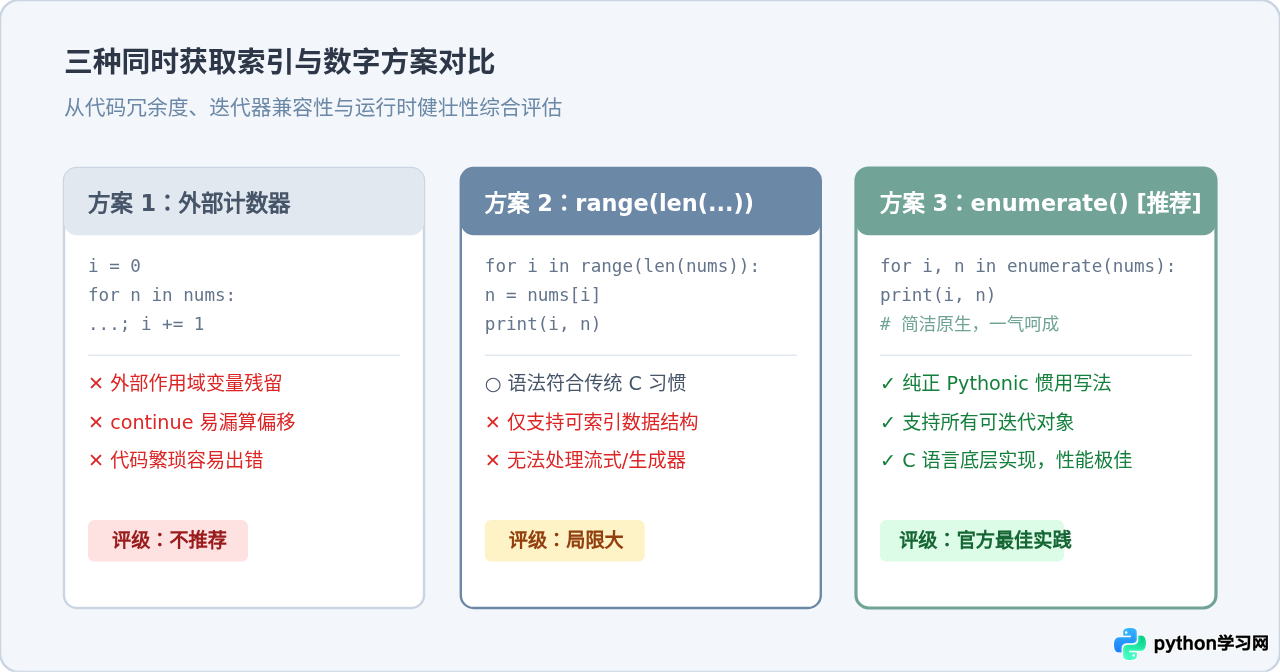
除了 enumerate(),在实际代码中还经常能看到另外两种实现方式:手动递增计数器和 range(len(nums))。了解它们的局限性有助于建立良好的编码直觉。
1. 外部手动累加计数器
# 方式 A:外部维护计数器(不推荐)
i = 0
for num in nums:
    print(i, num)
    i += 1  # 一旦遇到提前 continue 或分支跳转,极易漏写导致计数错误
这种写法的缺点显而易见:首先,需要在循环外部定义一个游离变量 i,循环结束后该变量依然滞留在当前作用域中;其次,如果循环体内存在复杂的 continue 或异常捕获,很容易漏掉 i += 1,从而导致严重的逻辑隐患。
2. range(len(nums)) 下标反查
# 方式 B:下标间接反查(不够 Pythonic)
for i in range(len(nums)):
    num = nums[i]  # 必须二次通过下标寻址
    print(i, num)
这种写法是许多来自 C/Java 背景的程序员的常见习惯。它虽然能完成任务,但存在明显缺陷:它强制要求数据源支持索引访问(如列表),如果数据源是一个生成器、文件迭代流或数据库游标,len() 会直接抛出 TypeError。此外,每次循环都进行一次 nums[i] 的取值操作,代码冗长且降低可读性。
四、进阶应用:列表推导式与键值对构造
除了在常规 for 循环中单行处理,enumerate() 还可以自然地融入到 Python 的推导式和内建映射构造中,用极短的代码解决实际问题。
1. 在列表推导式中筛选特定位置的数字
例如,筛选出所有“偶数索引位置上的数值”:
nums = [100, 205, 308, 410, 520, 633]

# 只保留索引为偶数(0, 2, 4)的数字
even_idx_nums = [val for idx, val in enumerate(nums) if idx % 2 == 0]
print(even_idx_nums)
# 示例输出: [100, 308, 520]
2. 快速生成数字位置索引字典
有时我们需要将数字序列转换为“下标 -> 数值”或“数值 -> 首次出现下标”的哈希映射,配合 dict() 转换极其迅速:
values = [55, 66, 77, 88]

# 直接将 enumerate 生成器转化为字典
idx_to_val = dict(enumerate(values))
print(idx_to_val)
# 示例输出: {0: 55, 1: 66, 2: 77, 3: 88}

# 通过字典推导式反向构造:数值到下标的映射
val_to_idx = {val: idx for idx, val in enumerate(values)}
print(val_to_idx)
# 示例输出: {55: 0, 66: 1, 77: 2, 88: 3}
五、避坑提醒与常见问题
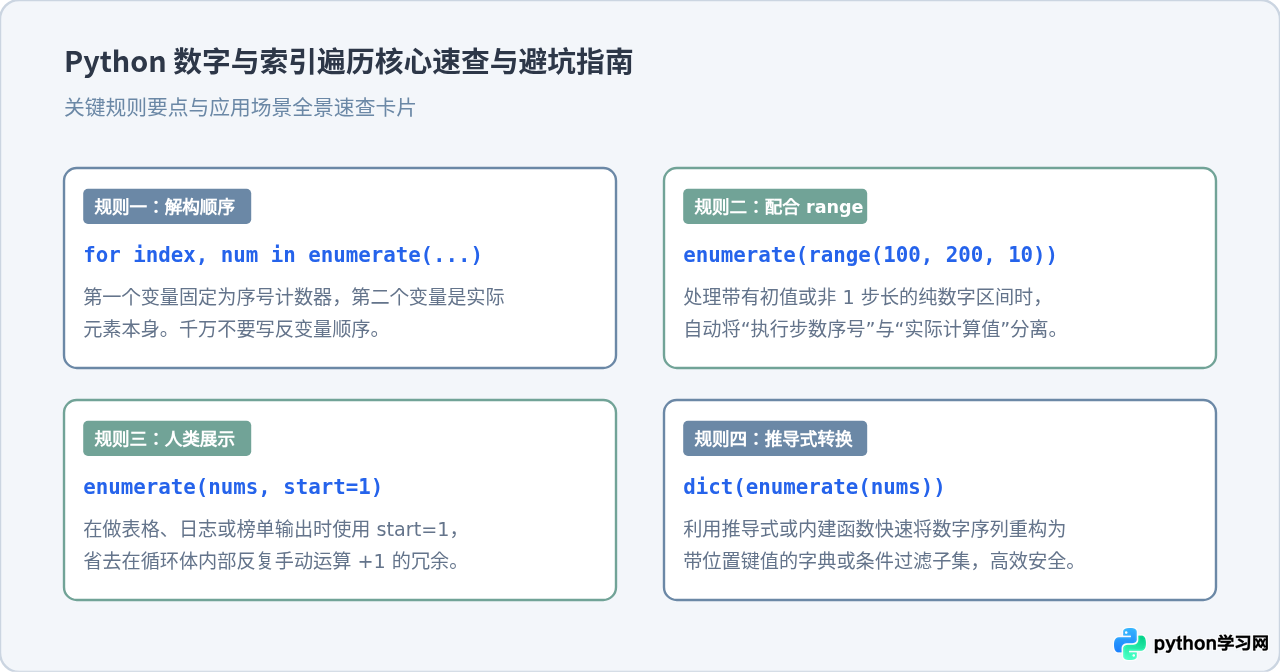
enumerate() 每次返回的二元组固定是 (index, value)。如果随手写成 for num, index in enumerate(...),Python 并不会报错,但 num 会接收到 0, 1, 2,而 index 会接收到实际数字,从而引发完全颠倒的业务逻辑错误。务必牢记:左侧是索引,右侧是数值。
如果只需要数字本身(例如
range(10) 本身就是 0 到 9),直接 for x in range(10): 即可;只有当 range 产生的是带偏移量、带特定步长的数字(例如 range(100, 200, 15)),而你又需要知道当前是第几个循环步数时,才需要使用 for step, num in enumerate(range(100, 200, 15)):。
总结
在 Python 中同时获取数字与其索引,enumerate() 是唯一的官方推荐标准解法。它不仅省去了维护外部变量的复杂度和出错可能,还能与生成器、推导式等高级特性无缝配合。掌握 for index, num in enumerate(iterable, start=0) 的标准范式,能让你的代码更简洁、稳健且充满 Pythonic 风格。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















