


Python怎么去除字符串中的非英文字符
在Python中去除字符串中的非英文字符,最常用的方法包括使用正则表达式re.sub、列表推导式配合isascii与isalpha,以及str.translate。本文详细讲解各种方法的实现步骤、核心原理及适用场景。
在 Python 中去除字符串中的非英文字符,最直接且通用的方法是使用标准库中的正则表达式模块 re.sub(r'[^a-zA-Z]', '', text)。如果你更倾向于不引入额外模块,可以使用列表推导式配合 c.isascii() and c.isalpha() 进行过滤;而在需要处理超长文本或极高吞吐量的场景下,str.translate 则能提供极致的执行性能。
一、核心解决方案快速上手
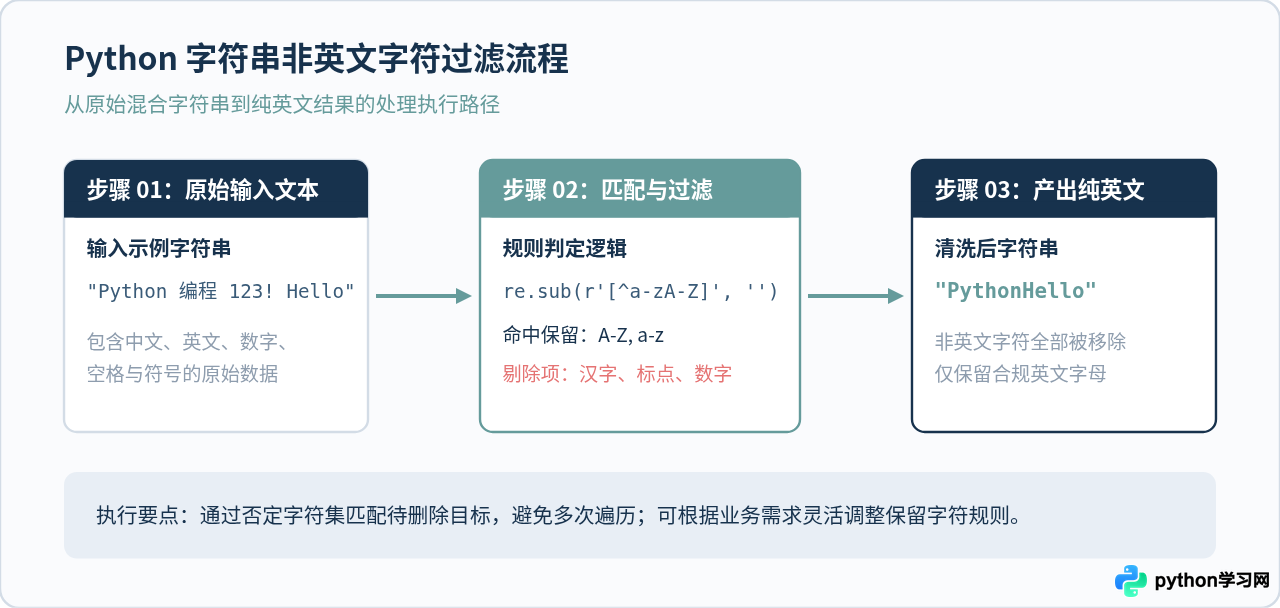
日常开发中,我们经常会拿到混合了汉字、数字、特殊符号、标点及 Emoji 的原始字符串。若目标是只保留其中的纯英文字母(包括大写 A-Z 与小写 a-z),使用内置的 re 模块只需两行代码:
import re

text = "Python 编程:123 Hello, World! 这是一个测试 456。"
result = re.sub(r'[^a-zA-Z]', '', text)

print("处理结果示例:", result)
# 示例输出:PythonHelloWorld
这里的核心在于模式 [^a-zA-Z]:方括号表示字符集合,开头的 ^ 代表取反操作,a-zA-Z 则囊括了全部 26 个大小写英文字母。整个表达式的语义是“匹配所有不是英文字母的字符”,并将它们替换为空字符(即将其删除)。
二、方法一:使用正则表达式灵活清洗
re 模块的优势在于高度灵活。在真实的业务场景下,“去除非英文字符”常常会有不同的细分诉求,例如是否需要保留单词之间的空格、是否需要保留常见的英文标点符号等。
1. 仅保留英文字母与空格
如果直接把所有非字母字符都删掉,原本用空格隔开的英文单词会被拼接在一起(如 Hello World 变成 HelloWorld)。若希望保留英文单词之间的空格,可以在字符集中加入 \s:
import re

text = "Hello 世界! Welcome to Python 3.10."
# 匹配所有既不是英文字母也不是空白符的字符并替换
result = re.sub(r'[^a-zA-Z\s]', '', text)

# 去除连续多余空格并修剪首尾
clean_result = ' '.join(result.split())
print("保留空格结果示例:", clean_result)
# 示例输出:Hello Welcome to Python
2. 预编译提升循环性能
当需要在循环中处理成千上万条文本时,每次调用 re.sub 都会重新解析正则模式。使用 re.compile 提前编译正则表达式可以显著提升执行效率:
import re

# 提前编译正则对象
pattern = re.compile(r'[^a-zA-Z]')

lines = [
    "文本 1: First Line, 测试中",
    "文本 2: Second Line, 处理完",
    "文本 3: Third Line, 完成"
]

cleaned_lines = [pattern.sub('', line) for line in lines]
print("批量处理示例:", cleaned_lines)
# 示例输出:['FirstLine', 'SecondLine', 'ThirdLine']
三、方法二:列表推导式与字符串判定(避坑指南)
如果不希望引入 re 模块,很多开发者的第一反应是使用字符串的 isalpha() 方法结合列表推导式。但这里存在一个极其隐蔽的技术陷阱。
在 Python 3 中,字符串遵循 Unicode 标准。汉字、法文注音字符、希腊字母等在 Unicode 范畴内均属于“文字”(Letter),因此对汉字执行 '中'.isalpha() 会返回 True!如果仅写 [c for c in text if c.isalpha()],中文字符将无法被剔除。
正确的做法是同时使用 c.isascii() 与 c.isalpha()。isascii() 确保字符位于 ASCII 编码范围(0-127)内,isalpha() 确保字符属于字母类别。两者结合,即可严格锁定英文字母。
text = "Python 语言 2026 年,Hello!"

# 正确写法:同时满足是 ASCII 字符且是字母
result = ''.join(c for c in text if c.isascii() and c.isalpha())

print("双重判定过滤示例:", result)
# 示例输出:PythonHello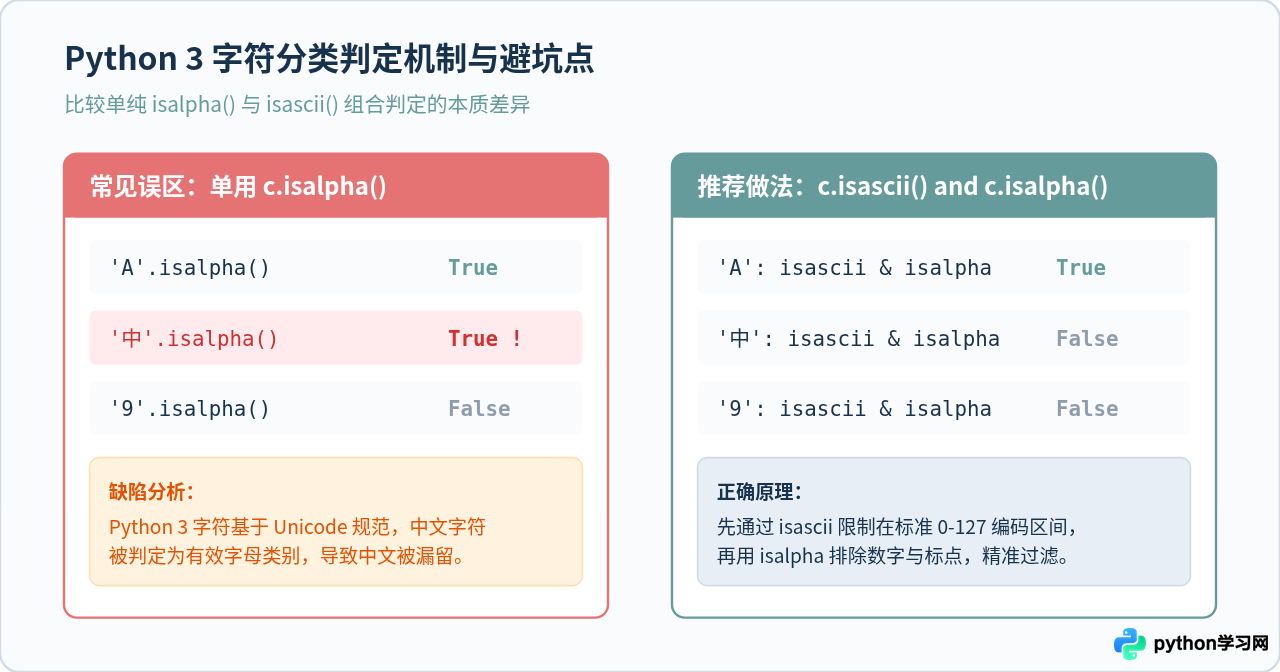
四、方法三:使用 str.translate 打造极致性能
如果你正在编写高频数据处理流水线,或者单次需要清洗数以百万计的字符,str.translate 是运行速度最快的方式。它直接调用底层 C 语言函数完成映射与剔除,避免了 Python 层面的循环开销和正则状态机回溯。
实现方式是建立一个字符映射字典,将所有需要删除的非英文字符映射为 None。借助 string.ascii_letters,我们可以快速生成该映射表:
import string

# 收集所有合法的英文字符集合
allowed_chars = set(string.ascii_letters)

# 对输入字符串中出现的非英文字符动态构建映射表
def remove_non_english(text: str) -> str:
    # 提取 text 中所有不在英文字符集里的字符
    to_remove = {ord(c): None for c in set(text) if c not in allowed_chars}
    return text.translate(to_remove)

text = "Python 高性能清洗:Data Pipeline 2026!"
result = remove_non_english(text)

print("translate 清洗结果示例:", result)
# 示例输出:PythonDataPipeline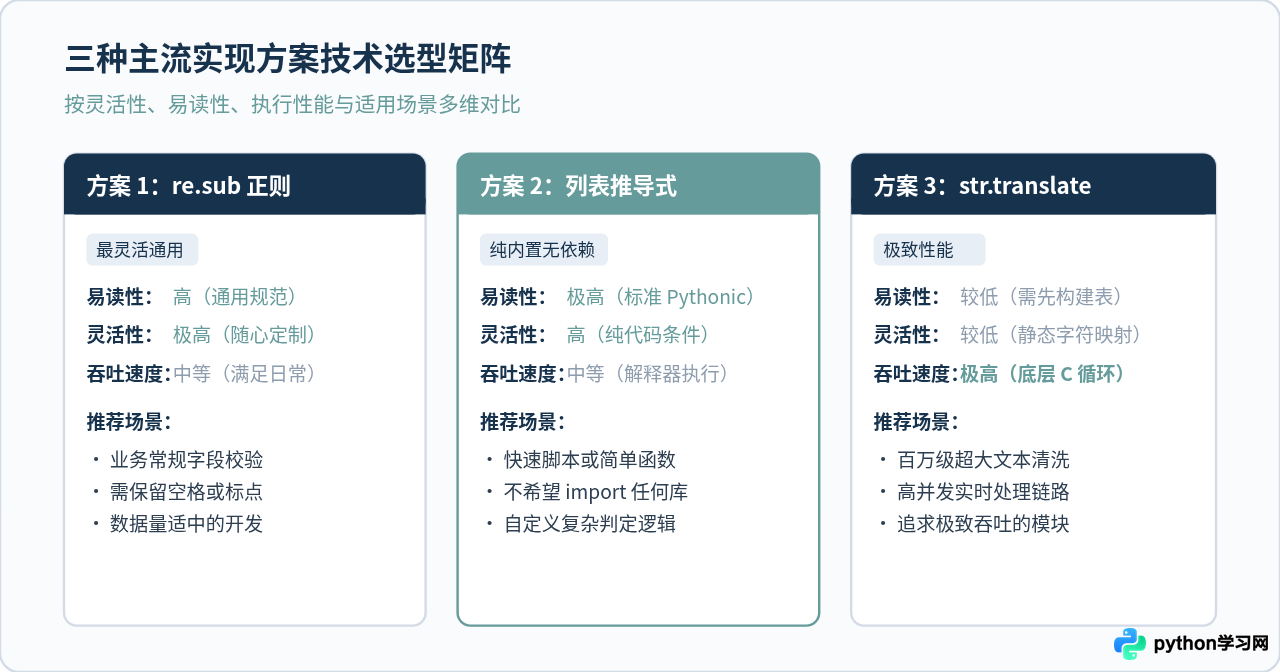
五、综合对比与选型建议
为了方便在实际项目中做出合理的技术选型,我们将上述三种方法的核心特征汇总如下:
| 实现方式 | 代码示例 | 依赖模块 | 核心优点 | 注意事项 |
|---|---|---|---|---|
| 正则表达式 | re.sub(r'[^a-zA-Z]', '', s) |
内置 re |
语法表达能力强,随需求快速扩充 | 大规模批量执行建议提前 re.compile |
| 推导式 + 双重判定 | ''.join(c for c in s if c.isascii() and c.isalpha()) |
无外部依赖 | 逻辑一目了然,无需记忆正则语法 | 切勿单独使用 c.isalpha(),会误留中文 |
| str.translate | s.translate(table) |
可配合 string |
运行速度极快,底层 C 语言处理 | 映射表构建稍显繁琐,规则变更灵活性稍弱 |
六、高频应用场景决策路径
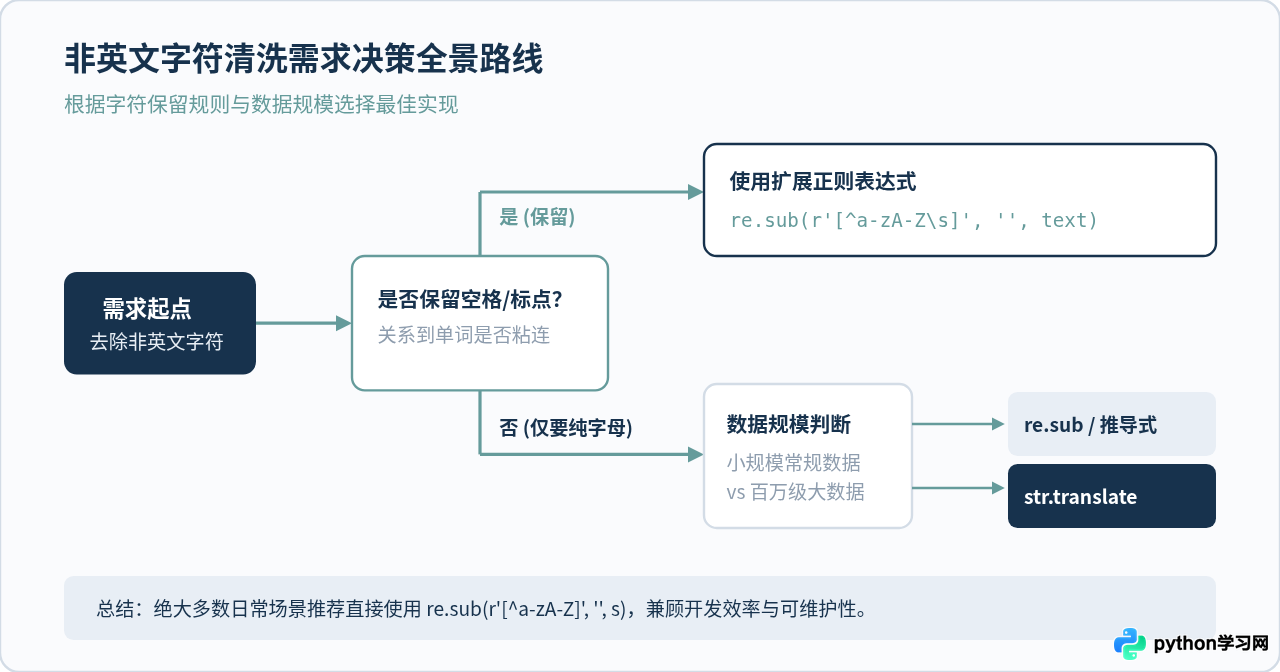
在落地到实际业务工程时,建议先厘清两个问题:第一是“目标文本中除了纯英文字母外,是否需要保留空格、换行或标点”;第二是“清洗任务的数据吞吐量级别”。通过这两步,即可明确最优实现方案。
七、总结
在 Python 中去除非英文字符并不复杂,但在编写代码前一定要明确业务边界:
- 首选方案:使用标准库的
re.sub(r'[^a-zA-Z]', '', text),规则清晰直观,非常适合绝大多数应用开发场景。 - 原生方案:使用列表推导式时务必牢记 Python 3 的 Unicode 特性,必须使用
c.isascii() and c.isalpha()组合判定,避免汉字被误判保留。 - 性能极限:面对大数据量清洗流水线,使用
str.translate进行字节级静态映射,能够获得数十倍的性能提升。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















