


Python字符串判断方法isalpha/isdigit/isnumeric使用指南
深入解析Python字符串判断方法isalpha、isdigit、isnumeric的区别、底层规则与实战使用指南,帮助开发者准确选择合适的校验手段。
假设你在开发一个用户注册或数据清洗模块,需要校验用户输入的“年龄必须是纯数字”、“姓名只能包含字母”。许多开发者会不假思索地调用 isdigit() 或 isalpha(),却在遇到中文姓名被判定为字母、上标数字 "²" 被当成数字,或者负数和浮点数全部返回 False 时陷入困惑。Python 提供了 isalpha()、isdigit() 和 isnumeric() 等内置字符串方法,它们基于 Unicode 字符标准设计,其判定规则远比简单的“英文字母”与“0-9数字”丰富。本文将直接拆解这三个核心方法的判定机制、涵盖范围、层级差异及适用边界,帮助你在实际开发中做出准确选择。
一、核心判定机制与字符层级划分
Python 中对字符类型的判断并不局限于 ASCII 字符集,而是依托 Unicode 字符数据库(UCD)。这就导致了它们与常规认知的差异:
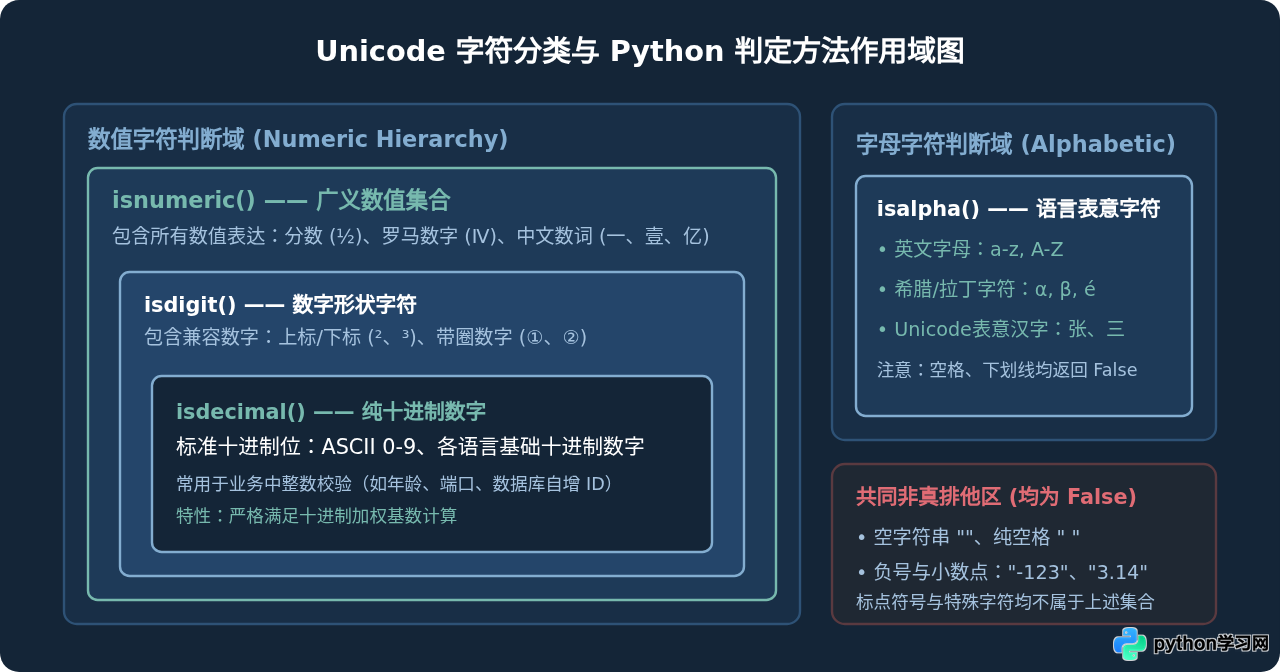
isalpha():判断字符串是否全部由字母(Alphabetic)字符组成,且长度至少为 1。在 Unicode 规范中,汉字属于“表意文字”(Letter, other 类别),因此中文汉字同样会被判定为True。isdigit():判断字符串是否全部由数字(Digit)字符组成,且长度至少为 1。它包含 ASCII 数字0-9,同时包含 Unicode 中的特殊单字符数字,例如上标、下标数字(如"²"、"³")以及圆圈数字(如"①")。isnumeric():判断字符串是否全部由数值(Numeric)字符组成,且长度至少为 1。它是范围最广的数值判断方法,不仅包含isdigit()的所有字符,还包含分数(如"½")、罗马数字(如"Ⅳ")以及汉字数字(如"一"、"壹"、"十")。
在理解这三者前,通常还需要引入 isdecimal()。isdecimal() 才是真正严格对应“十进制数字”(即能够直接组成十进制整数进制的字符,如 0-9)的方法。四者在数值领域的包含关系为:isdecimal() ⊆ isdigit() ⊆ isnumeric()。
二、isalpha() 的工作原理与实际表现
str.isalpha() 用于确认字符串中的每一个字符是否均属于 Unicode 字符集中的“字母”(Letter)分类。只有当所有字符均为字母且字符数大于 0 时,才返回 True。
1. 为什么中文字符也是 isalpha()?
在 Unicode 标准中,字符按通用类别(General Category)划分。中文字符被归入 Lo(Letter, other,其他文字/表意文字)。由于 isalpha() 检查的是字符是否属于 L(包含 Lu 大写、Ll 小写、Lt 词首大写、Lm 修饰符、Lo 其它文字)大类,因此中文汉字会被认定为字母:
# isalpha() 对不同语言字符的判定示例
print("Python".isalpha())      # 示例输出: True (标准 ASCII 字母)
print("你好世界".isalpha())    # 示例输出: True (Unicode 汉字归属 Letter 大类)
print("Résumé".isalpha())      # 示例输出: True (带重音拉丁字母)
print("Python3".isalpha())     # 示例输出: False (包含数字字符)
print("Hello World".isalpha()) # 示例输出: False (包含空格字符)
print("".isalpha()) # 示例输出: False (空字符串不满足至少一个字符的要求)如果你在处理国内用户注册时使用 name.isalpha() 校验姓名,虽然它能允许“张三”和“Alice”通过,但遇到包含分隔点“·”(如“买买提·吐尔逊”)或空格时会直接返回 False。因此涉及姓名或复合文本时,不能直接单纯依赖 isalpha()。
三、isdigit() 与 isnumeric() 的差异及判定边界
多数开发者在检查整数时习惯使用 isdigit(),但在面对国际化字符、公式上标或特殊计数符号时,isdigit() 和 isnumeric() 表现出截然不同的包容度。
1. isdigit():数字形态字符
str.isdigit() 判定字符是否具备数字形状。它涵盖两部分:
- 所有十进制数字(0 到 9);
- 具有数字属性的 Unicode 字符,如兼容数字(Compatibility Characters):上标数字(
"²"、"³")、带圈数字("①"、"②")。
2. isnumeric():广义数值概念
str.isnumeric() 的判断标准不是“字符看起来像阿拉伯数字”,而是“该字符在数学语义上是否表达一个确切的数值”。因此:
- 分数符号(如
"½"、"¼"、"¾")拥有明确的数值含义,isnumeric()返回True,而isdigit()返回False; - 罗马数字(如
"Ⅰ"、"Ⅱ"、"Ⅳ")在 Unicode 中被分配为数词字符,isnumeric()返回True; - 汉字数词(如
"一"、"二"、"十"、"壹"、"万")属于中文数值表达,isnumeric()返回True。
以下代码清晰地展示了两者的行为边界:
# isdigit 与 isnumeric 的测试对比
s_digit = "123"
s_sup = "²"         # 上标平方 (Unicode U+00B2)
s_frac = "½"        # 常见分数 (Unicode U+00BD)
s_roman = "Ⅳ"       # 罗马数字4 (Unicode U+2163)
s_cn = "三"         # 中文数字

print(f"{s_sup}: isdigit={s_sup.isdigit()}, isnumeric={s_sup.isnumeric()}")
# 示例输出: ²: isdigit=True, isnumeric=True

print(f"{s_frac}: isdigit={s_frac.isdigit()}, isnumeric={s_frac.isnumeric()}")
# 示例输出: ½: isdigit=False, isnumeric=True

print(f"{s_roman}: isdigit={s_roman.isdigit()}, isnumeric={s_roman.isnumeric()}")
# 示例输出: Ⅳ: isdigit=False, isnumeric=True

print(f"{s_cn}: isdigit={s_cn.isdigit()}, isnumeric={s_cn.isnumeric()}")
# 示例输出: 三: isdigit=False, isnumeric=True
四、方法选型与逻辑判断决策流程
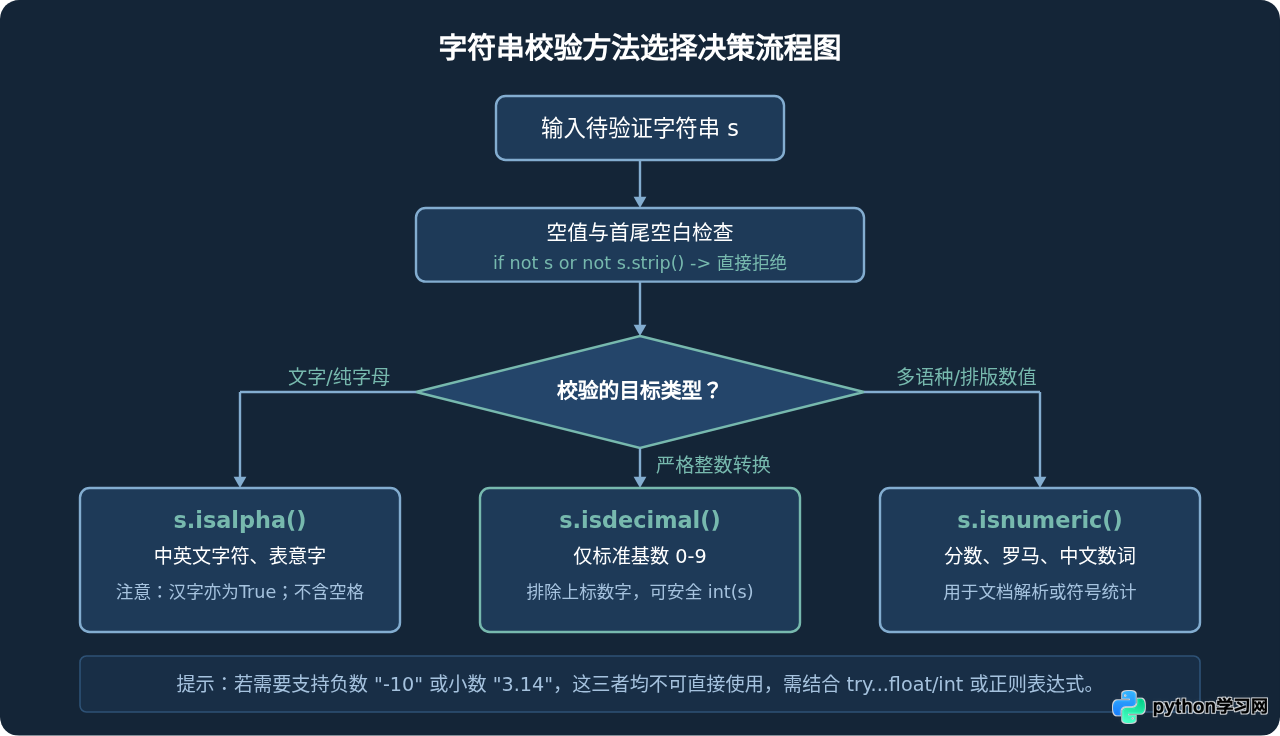
在面对来自用户端或外部文件的字符串时,如何选用合适的方法?下面的操作流程图展示了面对不同校验目标时的决策路径:
五、常见输入用例多维度测试对比
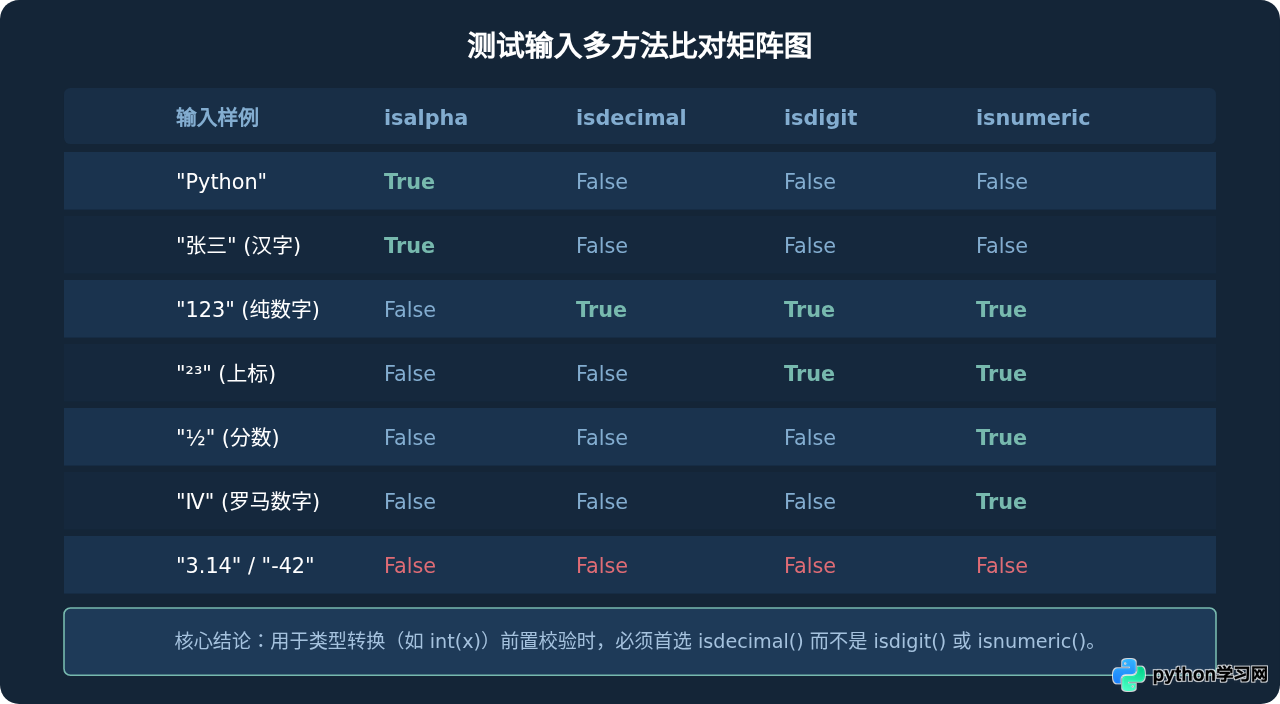
为了直观说明不同输入在各个方法下的真实结果,下表汇总了 8 种最具代表性的测试样本:
| 测试输入 | 样本说明 | isalpha() | isdecimal() | isdigit() | isnumeric() | 能否 int(s) |
|---|---|---|---|---|---|---|
"Python" |
纯 ASCII 英文字符 | True | False | False | False | 否 (ValueError) |
"张三" |
Unicode 表意文字(汉字) | True | False | False | False | 否 (ValueError) |
"123" |
标准十进制数字 | False | True | True | True | 是 (123) |
"²³" |
Unicode 上标数字 | False | False | True | True | 否 (ValueError) |
"½" |
Unicode 分数字符 | False | False | False | True | 否 (ValueError) |
"Ⅳ" |
罗马数词 | False | False | False | True | 否 (ValueError) |
"3.14" |
包含小数点的浮点字符串 | False | False | False | False | 否 (ValueError) |
"-42" |
包含负号的整数字符串 | False | False | False | False | 是 (-42) |
六、实战中的陷阱防范与推荐方案
陷阱 1:使用 isdigit() 进行安全的 int() 转换可能崩溃
很多代码中存在类似 if s.isdigit(): val = int(s) 的写法。在大多数仅输入普通数字时没有问题,但一旦用户输入或文本爬取中包含 "²","²".isdigit() 会返回 True,随后的 int("²") 将抛出 ValueError: invalid literal for int() with base 10: '²'。
修复做法:
# 正确做法 1: 严格校验十进制整数使用 isdecimal()
raw_str = "²"
if raw_str.isdecimal():
    val = int(raw_str)
else:
    # 安全拦截,不会抛出异常
    print("不是标准十进制整数,跳过转换")

# 正确做法 2: 直接通过异常处理捕获转换
try:
    val = int(raw_str)
except ValueError:
    print("转换失败")
陷阱 2:无法判断负数与浮点数
isdigit()、isnumeric()、isalpha() 针对每一个单字符进行独立检查。因为减号 - 和小数点 . 属于标点符号(Punctuation),所以只要字符串中含有它们,所有上述方法都返回 False。
校验负整数与浮点数的可靠写法:
def is_valid_integer(s: str) -> bool:
    """验证是否为合法整数(包含正整数、负整数、0)"""
    if not isinstance(s, str) or not s:
        return False
    # 若存在正负号前缀,去除后再进行 isdecimal 检查
    clean_s = s[1:] if s[0] in ('+', '-') else s
    return clean_s.isdecimal()

def is_valid_float(s: str) -> bool:
    """验证是否为合法浮点数表示"""
    try:
        float(s)
        return True
    except (ValueError, TypeError):
        return False

# 测试用例
print(is_valid_integer("-100"))  # 示例输出: True
print(is_valid_integer("100"))   # 示例输出: True
print(is_valid_float("-3.1415")) # 示例输出: True
print(is_valid_float("abc"))     # 示例输出: False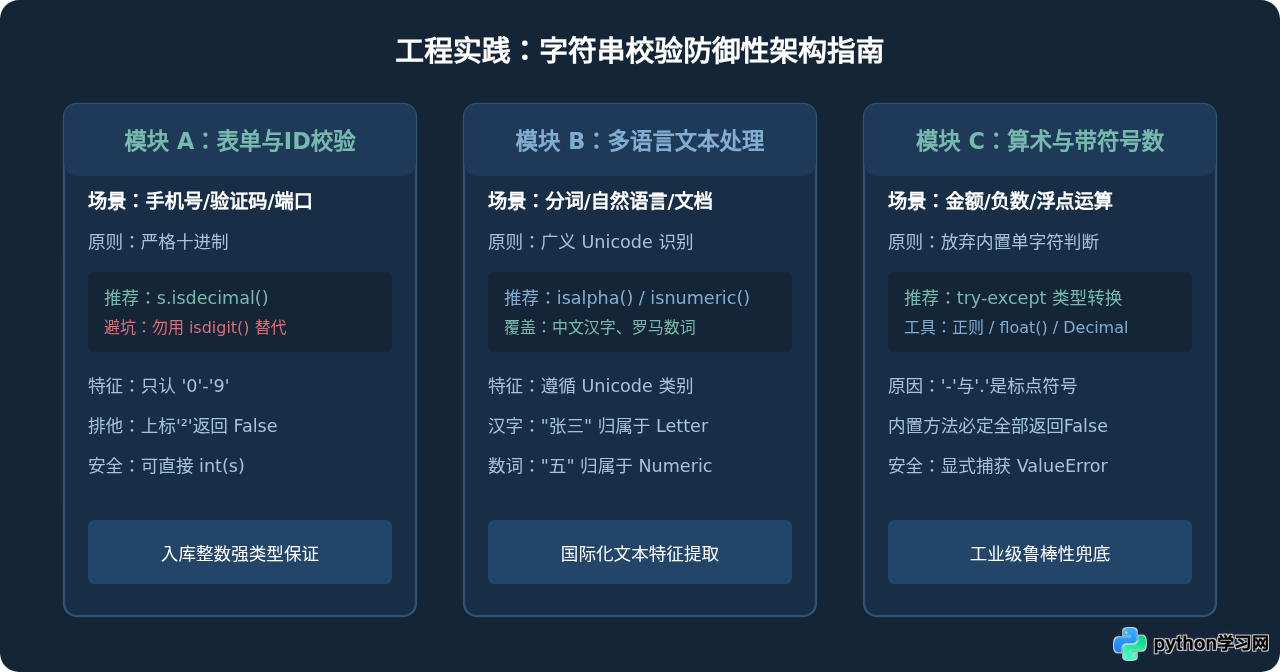
七、总结
在 Python 中做字符串字符判断时,请牢记以下三条核心准则:
- 如果要校验纯英文或普通文本:
isalpha()包含中文汉字与全球字母语言,若仅允许 ASCII 英文字符,应使用s.isascii() and s.isalpha()。 - 如果要确保字符串可安全转为 Python 整数:坚决使用
isdecimal(),避免使用isdigit()(会被上标数字带偏)或isnumeric()(会被分数和汉字带偏)。 - 如果要处理数学数值(包括负数和小数):果断放弃单字符级别的内置方法,采用
try...float()或明确规则的正则表达式进行判定。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















