


Python怎么获取字符串第N个字符并处理IndexError越界异常
详细讲解在Python中如何准确获取字符串的第N个字符,分析0基索引与人类顺序的换算规则,并深入介绍使用try-except捕获、事前边界检查以及利用切片容错处理IndexError越界异常的实用方法与最佳实践。
s[n - 1] 实现(因为日常生活中的“第1个”对应编程中的下标 0)。当目标位置超出字符串实际长度时,Python 会主动抛出 IndexError: string index out of range。解决此问题通常有三种可靠路径:使用 try-except 捕获异常进行兜底、在访问前用 0 <= index < len(s) 预先检查长度,或利用切片特性 s[n-1:n] 获得天然不报错的安全容错。
一、理解 Python 索引机制:人脑习惯与 0 基索引转换
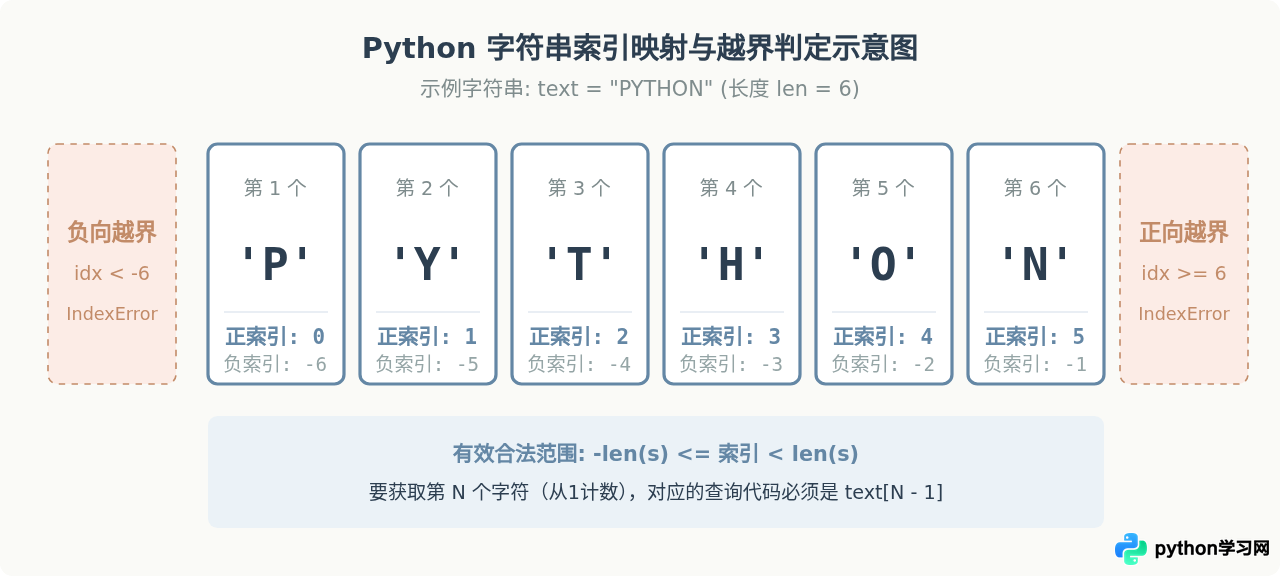
日常交流中,我们常说“取第 1 个字符”或“取第 3 个字符”,这是以 1 为起点的自然计数习惯。而在 Python 等大多数编程语言中,序列的索引(Index)是从 0 开始计数的。因此,对于长度为 L 的字符串:
- “第 1 个字符”对应的计算机索引为
0; - “第 N 个字符”对应的索引是
N - 1; - 最后一个字符的索引为
len(s) - 1; - 倒数第 N 个字符可以直接利用 Python 负索引特性表示为
-N(例如倒数第一个字符为s[-1])。
如果直接将人类理解的数字 N 直接传给字符串索引 s[N],不仅实际获取到的是后一位字符(即第 N+1 个),而且在访问最后一个位置时极易直接触发越界异常。
二、IndexError 产生的本质原因与触发边界
当 Python 执行 s[index] 这种单字符提取操作时,底层会执行严格的边界校验。如果给定的 index 落在以下两个范围之外,解释器会立即中断后续流程并抛出 IndexError: string index out of range:
- 正向越界:
index >= len(s)。例如长度为 5 的字符串,有效正索引为0, 1, 2, 3, 4。传入s[5]就会越界。空字符串s = ""的长度为 0,无论取s[0]还是任何索引都会立即越界。 - 逆向越界:
index < -len(s)。例如长度为 5 的字符串,合法负索引范围为-5到-1。传入s[-6]同样会越界。
# 典型报错复现场景
text = "hello"

# 用户试图获取第6个字符(人类直觉 6,换算索引 5)
try:
    char = text[5]
except IndexError as e:
    print(f"捕获到异常: {e}")
# 运行输出: 捕获到异常: string index out of range
三、处理越界异常的核心方案
针对字符串按序取值时的越界风险,Python 社区有三种主流应对模式,分别适用于不同的工程场景:
方案一:EAFP 风格的 try-except 异常捕获
Python 极其推崇 EAFP 哲学(Easier to Ask for Forgiveness than Permission,请求原谅比事前许可更容易)。在大多数情况下,假定目标字符存在并直接读取;若发生越界,则由 except IndexError 捕获,并赋予预设的默认值或执行后置逻辑。
def get_nth_char_try(s: str, n: int, default: str = "") -> str:
    """获取字符串 s 的第 n 个字符(从 1 开始计数)"""
    if n <= 0:
        return default  # 第0个或负数序号不符合自然计数,返回默认值
    try:
        return s[n - 1]
    except IndexError:
        return default

# 示例调用
message = "Python"
print("第3个字符:", get_nth_char_try(message, 3))   # 输出: 't'
print("第10个字符:", get_nth_char_try(message, 10, "N/A")) # 越界,输出: 'N/A'
方案二:LBYL 风格的事前长度检查(if 条件判断)
另一种经典思路是 LBYL(Look Before You Leap,三思而后行)。在调用索引之前,先通过 len(s) 获取字符串的实际长度,校验 0 <= n - 1 < len(s) 是否成立。只有在确认索引合法后才执行提取。
def get_nth_char_check(s: str, n: int, default: str = "") -> str:
    """通过提前检查边界安全获取第 n 个字符"""
    idx = n - 1
    if 0 <= idx < len(s):
        return s[idx]
    return default

# 示例调用
short_str = "Hi"
print("第1个字符:", get_nth_char_check(short_str, 1))  # 输出: 'H'
print("第5个字符:", get_nth_char_check(short_str, 5))  # 输出: ''
方案三:利用切片特性优雅容错(天然不报错)
这是 Python 语言中极具特色且优雅的技巧:切片语法(Slice)在越界时不会抛出 IndexError。如果切片范围超过了字符串边界,Python 只会自动将其截断到实际边界,并返回相应子串或空字符串 ""。
例如,若要获取第 N 个字符(索引 idx = N - 1),切片 s[idx:idx + 1]:
- 若
idx处于合法区间,切片切取单字符,返回长度为 1 的字符串; - 若
idx >= len(s),切片不会报错,而是直接返回空字符串""; - 结合
or运算符,可以非常轻便地提供备选默认字符:(s[idx:idx+1] or default)。
def get_nth_char_slice(s: str, n: int, default: str = "") -> str:
    """利用切片容错机制安全获取字符"""
    if n <= 0:
        return default
    idx = n - 1
    # s[idx:idx+1] 越界时返回 "",不会抛出 IndexError
    return s[idx:idx + 1] or default

text = "Code"
print("第2个字符:", get_nth_char_slice(text, 2))      # 输出: 'o'
print("第8个字符:", get_nth_char_slice(text, 8, "-")) # 越界,输出: '-'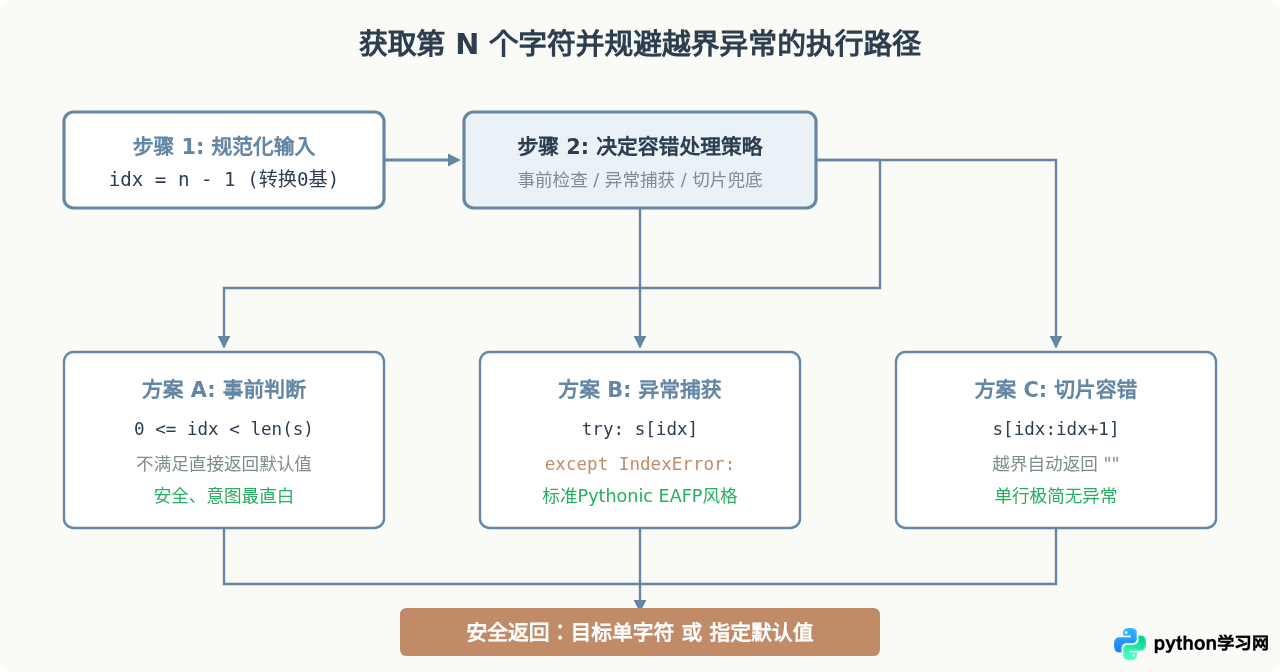
四、方案对比与选型考量
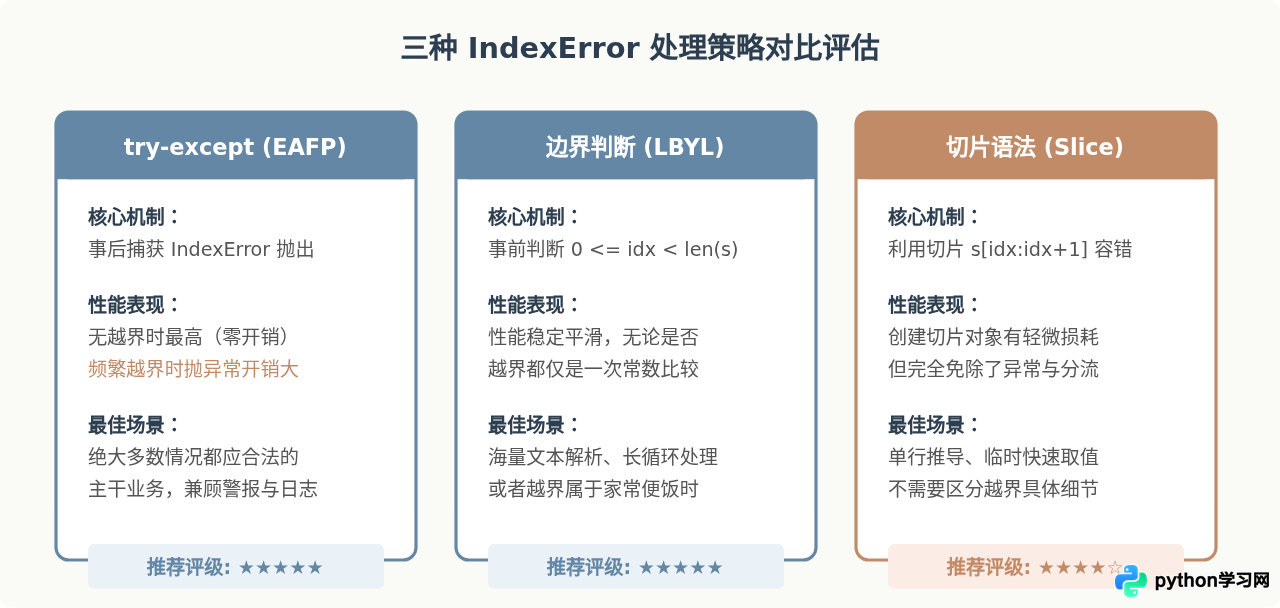
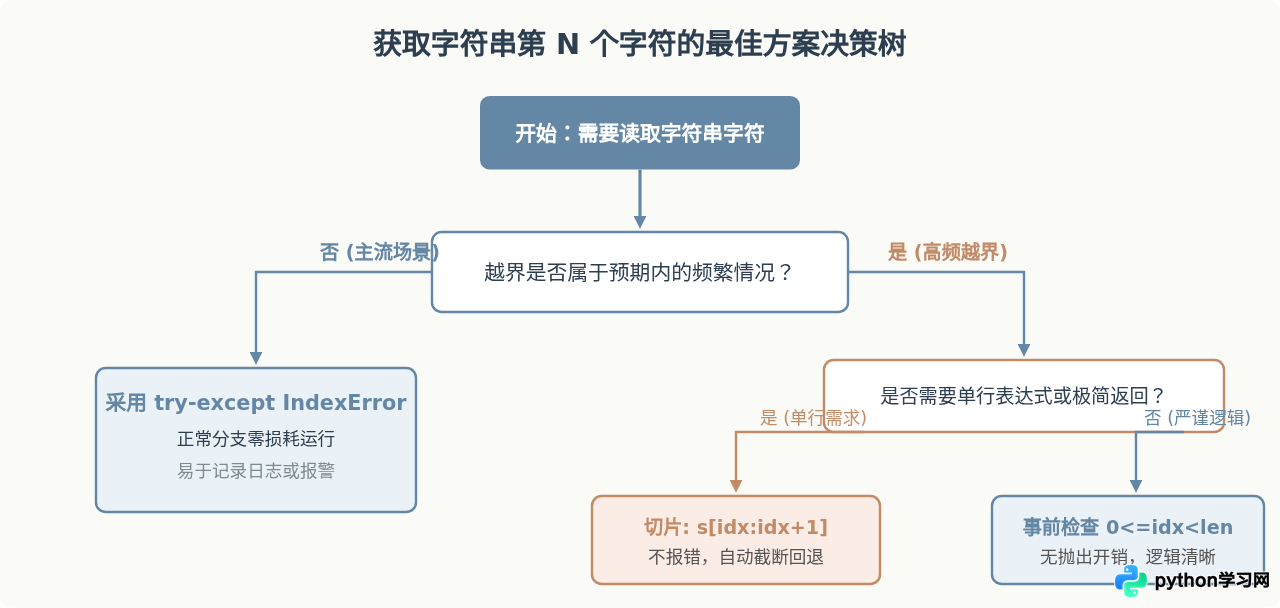
在实际工程中,选择哪种方法主要取决于三个维度的权衡:性能表现、业务语义清晰度以及是否需要记录异常日志。
- 正常命中率高、偶发越界时:推荐使用
try-except。在 Python 3.11+ 引入零成本异常(Zero-cost exception handling)后,只要没有触发异常,try块几乎没有任何额外开销,执行速度极快; - 越界频繁发生或处于高频紧凑循环中:推荐使用
if 0 <= idx < len(s)。因为在 Python 中创建和抛出异常对象的开销相对较大,如果在热点循环中频繁触发异常,会导致显著的性能抖动; - 要求单行表达式或极简兜底时:推荐切片
s[n-1:n]。适合在列表推导式、lambda 表达式或参数传递时快速取出字符而不中断流程。
五、工程实用代码:封装健壮的安全取字符函数
在日常开发或数据清洗管道中,通常需要一个通用、鲁棒且行为可控的提取函数。以下是一个兼顾人类自然计数(第 N 个)、负向计数(倒数第 N 个)以及类型校验的工程级封装:
def safe_get_char(text: str, n: int, default: str = "", one_based: bool = True) -> str:
    """
    安全提取字符串中的指定字符,防止抛出 IndexError。

    参数:
        text: 目标源字符串
        n: 目标序号。当 one_based=True 时,1 代表第 1 个字符,-1 代表倒数第 1 个字符
        default: 越界或入参非法时返回的安全默认值
        one_based: 是否启用人类习惯的从 1 开始计数(默认为 True)

    返回:
        成功提取到的单字符,或者默认值
    """
    if not isinstance(text, str):
        return default

    if not isinstance(n, int) or n == 0:
        # 在 1-based 语义下,第 0 个是不合法的定义
        return default

    # 将 1-based 自然序转换为 Python 的 0-based 计算机索引
    if one_based:
        if n > 0:
            target_idx = n - 1
        else:
            # 负数保持 -1 对应倒数第一个,无需再偏移
            target_idx = n
    else:
        target_idx = n

    # 使用边界判断规避 IndexError
    length = len(text)
    if -length <= target_idx < length:
        return text[target_idx]

    return default


# === 实际测试示例 ===
sample = "Hello, World!"

# 1. 正常正向获取第 1 个和第 5 个字符
print("第1个字符:", repr(safe_get_char(sample, 1)))  # 'H'
print("第5个字符:", repr(safe_get_char(sample, 5)))  # 'o'

# 2. 正常获取倒数第 1 个字符(感叹号)
print("倒数第1个:", repr(safe_get_char(sample, -1))) # '!'

# 3. 越界测试:源字符串长度 13,请求第 100 个字符
print("第100个字符:", repr(safe_get_char(sample, 100, default="[EMPTY]"))) # '[EMPTY]'

# 4. 越界测试:负向越界
print("倒数第50个:", repr(safe_get_char(sample, -50, default="None")))     # 'None'

# 5. 空字符串测试
print("空字符串取首字符:", repr(safe_get_char("", 1, default=""))) # ''None 的情况。如果直接对 None 执行索引操作,抛出的将是 TypeError: 'NoneType' object is not subscriptable 而不是 IndexError。因此在做异常捕获时,若不能确保变量绝对是字符串,建议同时捕获 (IndexError, TypeError)。
六、总结与排查决策树
获取字符串指定位置字符是日常编码中最基础的操作之一,但也是生产环境抛出空指针或越界错误的高发点。要保障代码稳健运行,请牢记以下要点:
- 牢记 0 基偏移:人类所谓的“第 N 个字符”,在代码中必须转换为
n - 1下标访问; - 边界闭区间:正向合法边界为
0 <= index < len(s),逆向合法边界为-len(s) <= index < 0; - 防御优于奔溃:在对外接口或不可信入参中,始终通过
try-except IndexError或预检查设定降级默认值; - 巧用切片:在不需要抛出异常也不需要区别越界原因的简单场景下,
s[idx:idx+1]是最轻快简短的防御式手段。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















