


Node.js子进程、Pyodide与API交互方案对比
深入对比Node.js子进程、Pyodide与独立API服务三种跨语言交互方案的核心机制、性能生命周期、避坑指南与选型决策路径。
当现代全栈或服务端应用需要将 JavaScript/Node.js 生态与 Python 的科学计算、机器学习模型或既有算法库融合时,架构师和开发者通常面临三种主流的技术集成路径:利用 Node.js 原生 child_process 派生系统子进程、借助 WebAssembly 运行时 Pyodide 在单进程内存中直通执行,或者将 Python 独立构建为网络 API 微服务。这三者在通信开销、环境隔离、库兼容性及运维复杂度上存在截然不同的权衡。本文将针对这三种跨语言方案展开全方位的技术机制剖析、性能生命周期比对与落地选型指引。
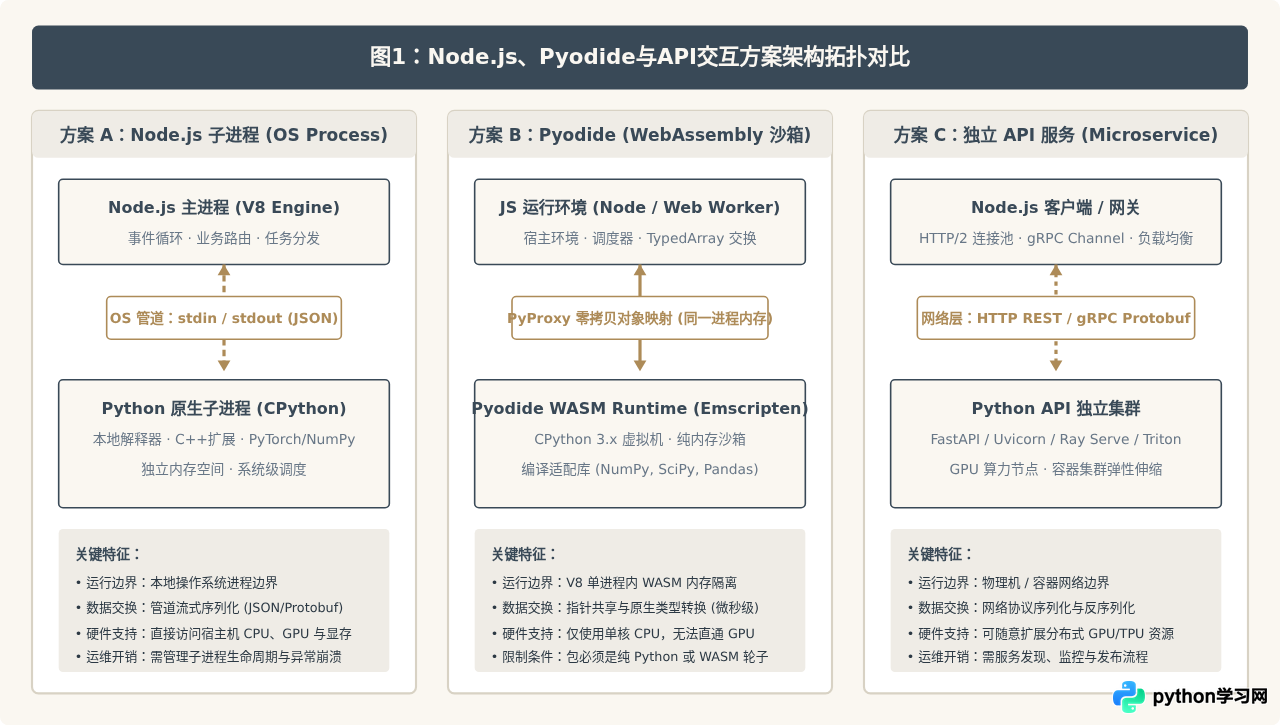
一、三种方案的核心运作机制与架构拓扑
不同集成方案的根本区别在于语言边界划在哪里:是划在操作系统进程边界、WebAssembly 虚拟机内存边界,还是划在远程网络协议边界。
1. Node.js 子进程(Child Process)
Node.js 子进程方案依赖主机操作系统环境。主进程通过调用 child_process.spawn 或 child_process.execFile 创建独立的 OS 进程来运行 Python 解释器。双方通常通过标准输入输出管道(stdin/stdout)传递 JSON 格式流,或者通过本地 Unix 域套接字/临时文件交换数据。这种方式的优势在于 Python 拥有宿主机的完整原生能力,可以无损调用 PyTorch、NumPy、C 拓展库及多线程计算。
2. Pyodide(WebAssembly 内存沙箱)
Pyodide 是基于 Emscripten 将 CPython 核心及通用科学计算库编译为 WebAssembly(WASM)的运行时。它既可以在前端浏览器运行,也可以直接在 Node.js 环境中通过 worker_threads 加载。其核心特性是宿主 JavaScript 与 WASM 实例共享同一进程的线性内存空间,通过 PyProxy 接口实现双向对象映射与直接调用,完全免去了进程间通信与跨网络传输序列化,但其依赖包受限于纯 Python 或已适配编译为 WASM 的轮子。
3. 独立 API 服务(FastAPI / gRPC)
API 方案将 Python 逻辑完全解耦并封装在独立的后端服务中(如基于 FastAPI、Uvicorn 的 HTTP/2 REST 服务,或基于 gRPC 的 RPC 服务)。Node.js 通过标准网络协议(HTTP/gRPC/WebSocket)向 Python 节点发起异步请求。该方案将语言交互问题彻底转化为分布式微服务通信问题,允许 Python 服务部署在专有 GPU 算力集群中并进行独立扩缩容。
二、典型代码实现与数据流交互示例
为了让差异更加具象,下面分别演示在这三种方案中执行相同计算(输入数组,调用 Python 进行数据归一化计算,并返回结果)的完整工程代码与关键结构。
1. Node.js 子进程代码范式(避免阻塞与缓冲区溢出)
直接调用 exec 存在默认 1MB 缓冲区上限及进程冷启动开销。正规实践应使用长驻守护子进程,借助标准输入输出按行写入 JSON:
// Node.js 端:child_worker.js
const { spawn } = require('child_process');
const readline = require('readline');

// 启动常驻 Python 进程,关闭输出缓冲(-u 参数至关重要)
const pyProcess = spawn('python3', ['-u', 'worker.py'], {
  stdio: ['pipe', 'pipe', 'pipe']
});

const rl = readline.createInterface({ input: pyProcess.stdout });

// 发送计算任务
function computeNormalize(data) {
  return new Promise((resolve, reject) => {
    const payload = JSON.stringify({ action: 'normalize', values: data }) + '\n';

    rl.once('line', (line) => {
      try {
        const response = JSON.parse(line);
        if (response.error) reject(new Error(response.error));
        else resolve(response.result);
      } catch (err) {
        reject(err);
      }
    });

    pyProcess.stdin.write(payload);
  });
}

// 示例调用
computeNormalize([10, 20, 30, 40, 50]).then(console.log);
对应 Python 常驻工作进程实现:
# Python 端:worker.py
import sys
import json

def normalize(values):
    min_v = min(values)
    max_v = max(values)
    if min_v == max_v:
        return [0.0] * len(values)
    return [(v - min_v) / (max_v - min_v) for v in values]

# 按行持续读取标准输入,防止进程频繁创建与销毁
for line in sys.stdin:
    if not line.strip():
        continue
    try:
        req = json.loads(line)
        if req.get("action") == "normalize":
            res = normalize(req["values"])
            print(json.dumps({"result": res}), flush=True)
    except Exception as e:
        print(json.dumps({"error": str(e)}), flush=True)
2. Pyodide 代码范式(基于 Worker 隔离与对象映射)
Pyodide 在主线程直接加载会阻塞 UI 渲染或主事件循环,最佳实践必须将其置于 Web Worker(前端)或 worker_threads(Node.js 服务端):
// Node.js 或 Web Worker 端:pyodide_worker.js
import { loadPyodide } from "pyodide";

let pyodideInstance = null;

async function init() {
  if (!pyodideInstance) {
    pyodideInstance = await loadPyodide();
    // 注册 Python 核心函数
    await pyodideInstance.runPythonAsync(`
      def normalize(values):
          min_v = min(values)
          max_v = max(values)
          if min_v == max_v:
              return [0.0] * len(values)
          return [(v - min_v) / (max_v - min_v) for v in values]
    `);
  }
  return pyodideInstance;
}

export async function runNormalize(data) {
  const py = await init();
  // 获取 Python 函数代理
  const pyNormalize = py.globals.get('normalize');
  // 传参并转换结果
  const resultProxy = pyNormalize(data);
  const result = resultProxy.toJs();

  // 务必手动释放 PyProxy 避免 WASM 内存泄漏
  resultProxy.destroy();
  pyNormalize.destroy();

  return result;
}
3. API 交互服务代码范式(FastAPI 与 HTTP 连接池)
将 Python 包装为微服务,Python 侧采用高性能异步框架 FastAPI:
# Python 侧:server.py
from fastapi import FastAPI
from pydantic import BaseModel
from typing import List

app = FastAPI()

class NormalizeRequest(BaseModel):
    values: List[float]

@app.post("/api/normalize")
async def handle_normalize(req: NormalizeRequest):
    vals = req.values
    if not vals:
        return {"result": []}
    min_v, max_v = min(vals), max(vals)
    if min_v == max_v:
        return {"result": [0.0] * len(vals)}
    return {"result": [(x - min_v) / (max_v - min_v) for x in vals]}
Node.js 侧通过 HTTP Keep-Alive 连接池发起快速调用:
// Node.js 客户端:client.js
const http = require('http');

// 配置长连接 Agent 避免重复 TCP 握手
const keepAliveAgent = new http.Agent({ keepAlive: true, maxSockets: 50 });

async function callNormalizeApi(data) {
  const payload = JSON.stringify({ values: data });

  const response = await fetch('http://127.0.0.1:8000/api/normalize', {
    method: 'POST',
    agent: keepAliveAgent,
    headers: { 'Content-Type': 'application/json' },
    body: payload
  });

  const json = await response.json();
  return json.result;
}
三、请求生命周期与性能开销深度对比
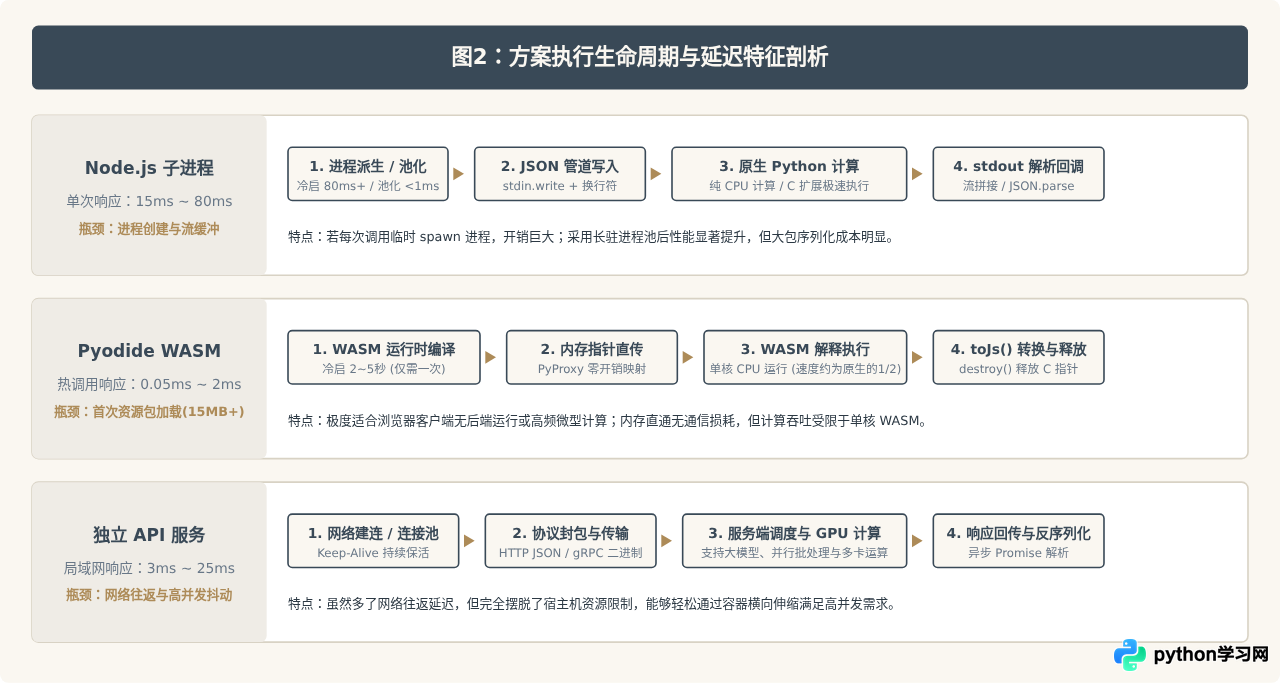
为了直观评估不同方案在高频或计算密集任务下的表现,需要分解每一个请求的完整执行阶段。图 2 详细拆解了冷启动与热请求状态下,三种方案的时间消耗与开销瓶颈。
四、工程落地常见误区与避坑指南
跨语言交互在实际生产落地中存在诸多隐蔽的架构陷阱,开发者如果未能充分理解底层原理,极易引发内存泄漏、死锁或雪崩。
1. Node.js 子进程方案避坑指南
- 死锁与管道阻塞:标准 Node.js 的
child_process.exec默认设置maxBuffer: 1024 * 1024(1MB)。一旦 Python 打印大量日志或输出大型 JSON 超过上限,子进程将被操作系统挂起并造成静默挂起。生产环境必须采用spawn,并通过流式监听消费stdout与stderr。 - Python 输出未刷新(Buffering):Python 在重定向标准输出到管道时默认启用行缓冲甚至全缓冲。如果不显式传递
-u命令行参数或在输出时调用print(..., flush=True),Node.js 端将收不到任何响应事件。 - 孤儿进程与僵尸进程:当 Node.js 主服务崩溃或触发重启信号(如 SIGTERM)时,子进程默认不会自动退出。必须在主进程注册退出钩子,向子进程进程组显式发送
tree-kill信号。
2. Pyodide 方案避坑指南
- 内存泄露(PyProxy 悬挂):当通过 JavaScript 访问 Python 内部对象时,Pyodide 会在底层分配 C 指针维护引用计数。垃圾回收器(V8 GC)无法感知 Emscripten 堆内存压力。因此,所有通过
globals.get()或函数返回值获取的对象,使用完毕后必须显式调用.destroy(),否则 WASM 堆内存将持续增长直至溢出崩溃。 - 阻塞事件循环:尽管 WASM 运行在 V8 内部,但它默认在同一线程上执行同步计算。如果运行超过 50ms 的计算任务,将直接阻塞 Node.js 的网络 IO 或前端浏览器的 UI 渲染。务必使用 Web Worker 或 Node.js
worker_threads进行线程级卸载。 - 依赖包壁垒:Pyodide 无法直接安装含有未经 WASM 交叉编译的 C++ 扩展包(如纯 C 编写的专有驱动或深度绑定特定架构的二进制)。
3. 独立 API 服务方案避坑指南
- 连接复用与 TIME_WAIT 积压:在高吞吐调用下,如果 Node.js 每次调用 API 均重新发起未经连接池管理的基础请求,会迅速耗尽系统的本地端口并产生海量
TIME_WAIT状态连接。必须在客户端强制启用keep-alive连接池。 - 大包序列化 CPU 开销:当传输矩阵或高维向量数据时,JSON 的文本序列化和反序列化开销往往远高于 Python 算法本身的计算时间。推荐在跨网络交互中采用二进制 Protobuf 或 Apache Arrow 格式进行零拷贝流式传输。
五、架构选型决策路径
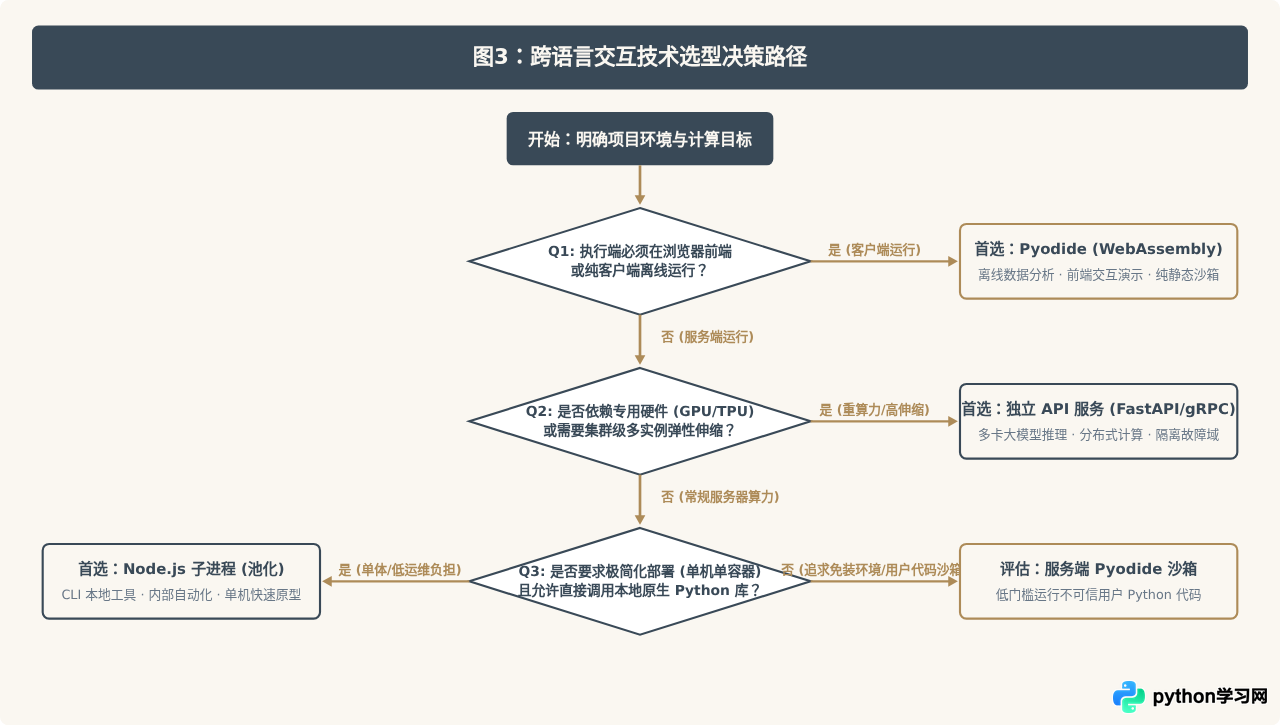
面对具体的工程需求,如何在这三者之间做出清晰、严谨的决策?图 3 给出了自顶向下的判断路径:
六、全维度对比总结与选型矩阵
为了让不同方案的技术特征更加清晰地横向呈现在系统设计评审中,下表汇总了三个维度的核心指标,随后图 4 提供了杂志级的信息矩阵图示。
| 评估维度 | Node.js 子进程方案 | Pyodide (WebAssembly) 方案 | 独立 API 服务方案 (FastAPI/gRPC) |
|---|---|---|---|
| 调用延迟与开销 | 毫秒级(若进程已池化常驻);大包 JSON 序列化带来轻微 CPU 负担 | 微秒级至极低毫秒级(共享内存直通);冷启动较重(需预加载 WASM) | 几毫秒至几十毫秒(受网络物理延迟、TCP/TLS 握手及代理路由影响) |
| 生态与第三方库兼容 | 100% 完全兼容(原生 CPython 环境,支持一切 C/C++/CUDA 库) | 受限(仅支持纯 Python 代码及官方预编译的 WASM 库) | 100% 完全兼容(运行于独立 Python 主机容器,支持全套工具栈) |
| 安全与资源隔离 | 较低(子进程拥有宿主机本地文件系统与进程权限,需额外加固沙箱) | 极高(WASM 天然在内存沙箱内运行,无法突破操作系统权限) | 高(网络边界物理隔离,具备独立的 VPC 网络策略与容器限制) |
| 基础设施与运维成本 | 中等(需维护本地宿主机的 Python 环境版本,单机部署) | 极低(零环境配置,直接作为前端或 NPM 依赖分发打包) | 较高(需要容器编排、服务注册发现、探针、日志监控与网关维护) |
| 弹性伸缩与算力上限 | 受限于单机 CPU 核心数与物理内存,无法跨物理节点扩展 | 受限于运行环境的单核 WASM 内存上限(典型上限 2GB~4GB) | 极高(可借助 K8s HPA 实现成百上千节点的平滑水平扩缩容) |
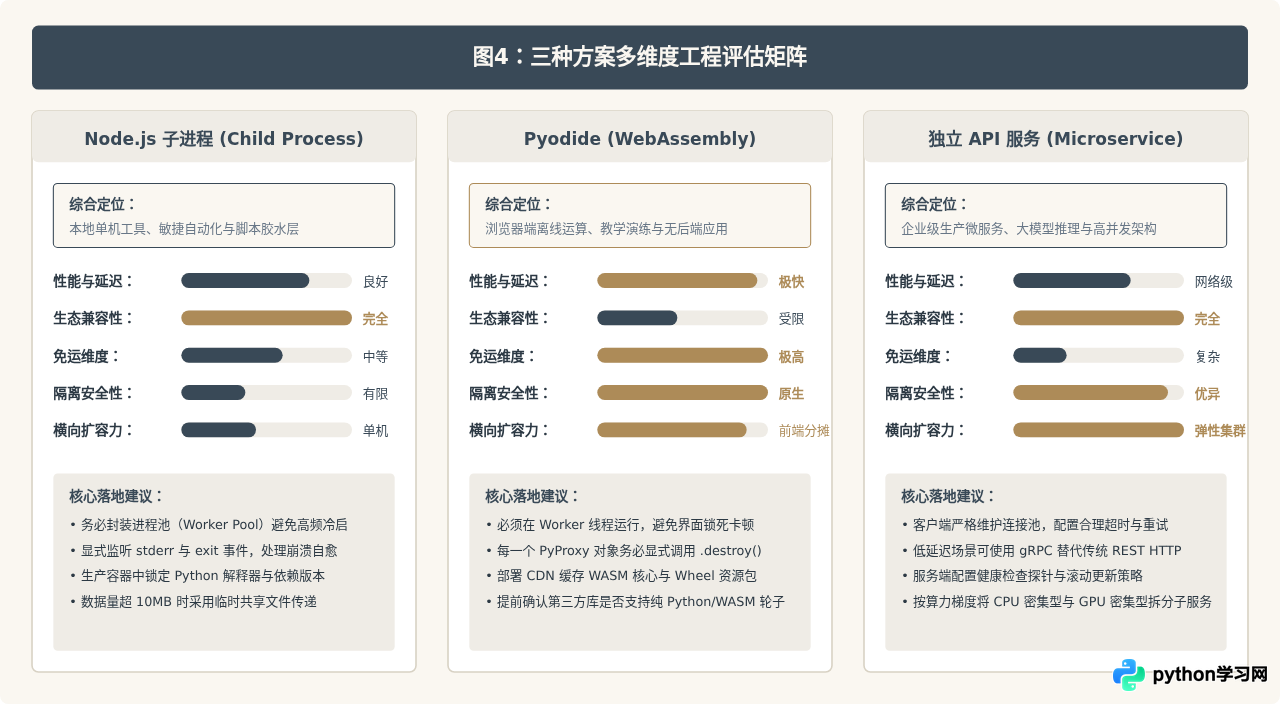
没有绝对优胜的技术方案,只有与业务约束契合的最佳架构:
如果你的应用属于单机运行的本地桌面工具(如 Electron)、开发者 CLI 或内部轻量脚本,且算法逻辑需要无缝依赖本地庞大的 Python 库,使用预热的 child_process 进程池是最快达成业务闭环的务实选择;
如果你的目标是纯前端交互式数据分析、教育演示、静态博客或边缘端隐私沙箱,希望零后端依赖且免去云端算力成本,选用 Pyodide 在 Web Worker 中执行能够提供极高的响应速度与优雅的用户体验;
当系统迈入高并发、多团队协作的复杂业务系统,或者需要调度 GPU、分布式模型推理集群时,坚决将 Python 封装为独立的 API 微服务(HTTP/gRPC),利用成熟的容器化与服务网格基础设施实现真正的故障解耦与弹性伸缩。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















