


Python list.count()报错解决:参数缺失与类型不匹配问题
深入解析 Python 中 list.count() 常见报错的产生原因,针对参数缺失引起的 TypeError、参数过多误用切片、以及由于类型不匹配或隐式等值转换引发的统计异常提供详细解决方案与代码示例。
在 Python 列表操作中,list.count() 是统计指定元素出现频次的基础内置方法。虽然调用形式看似简单,但在实际开发和新手学习过程中,该方法常引发两类典型问题:一是由于忽略了其单一形参约束而导致的 TypeError: list.count() takes exactly one argument(参数缺失或切片参数误传);二是由动态类型相等性匹配(==)引发的逻辑漏洞、统计偏差或复杂对象比对异常。本文将从具体报错场景切入,逐一剖析底层机制,并给出清晰规范的排查与防御式修复方案。
一、参数错误排查:参数缺失与多传切片引发的 TypeError
Python 官方文档中,列表的 count 方法原型定义为 list.count(value, /)。该方法仅接收一个位置参数,表示待匹配的目标值。如果调用时漏传参数,或者误以为它与字符串的 str.count(sub[, start[, end]]) 一样支持范围索引,Python 解释器就会直接抛出类型异常。
1. 参数缺失报错重现与修复
当调用 lst.count() 而未传入任何参数时,解释器无法获知比对目标,从而中断执行:
numbers = [10, 20, 30, 20, 10]

# 错误示例:未传参数
result = numbers.count()
终端报错输出示例:
TypeError: list.count() takes exactly one argument (0 given)修复方法:直接补全待统计的目标参数值,例如 numbers.count(20),返回值为 2。
2. 误传多参数(模仿切片行为)
在处理文本数据时,开发者常使用 text.count("a", 0, 10) 统计前 10 个字符内子串出现的次数。当转到列表操作时,容易形成惯性思维,试图在 list.count() 中传入起始与结束索引:
items = ["apple", "banana", "apple", "orange", "apple"]

# 错误示例:误把列表当字符串,传入起止范围
count_val = items.count("apple", 1, 4)
终端报错输出示例:
TypeError: list.count() takes exactly one argument (3 given)修复方法:列表的 count() 本身不支持区间参数。若需在特定区间内计数,必须先通过列表切片截取子序列,再执行计数操作:
# 正确写法:切片后调用 count
count_val = items[1:4].count("apple")
print(count_val)  # 输出示例: 1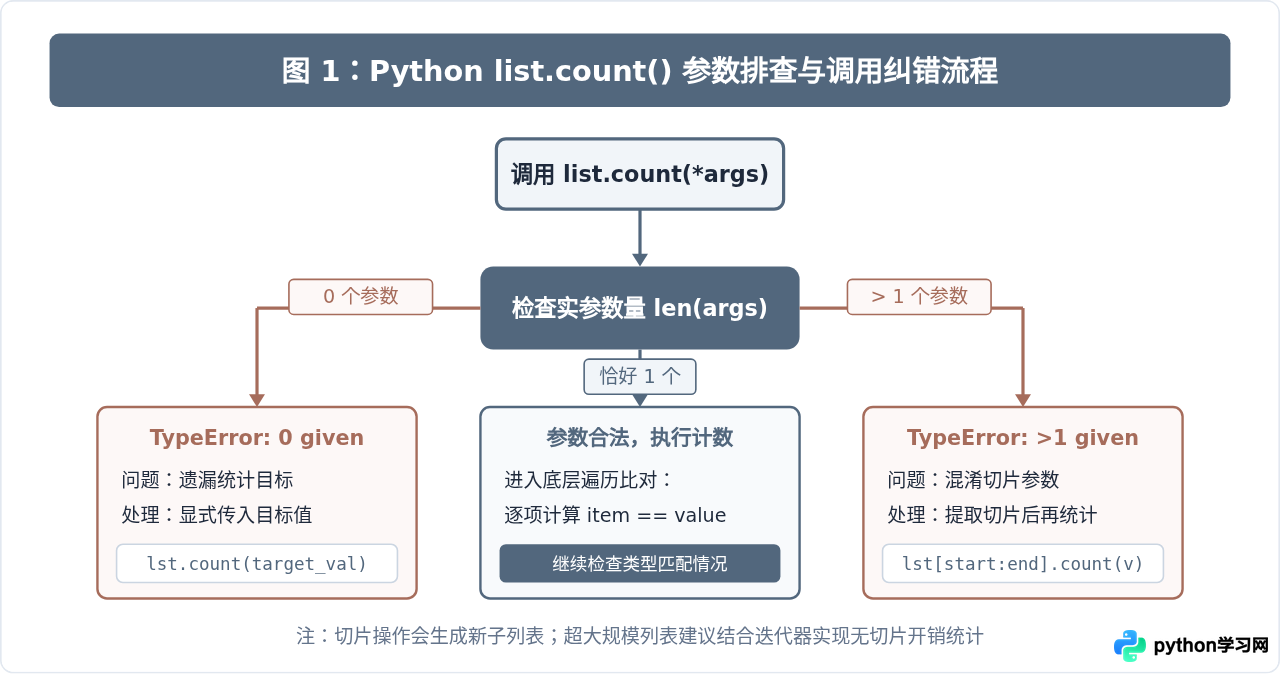
二、底层机制剖析:list.count() 如何进行遍历与相等性判定
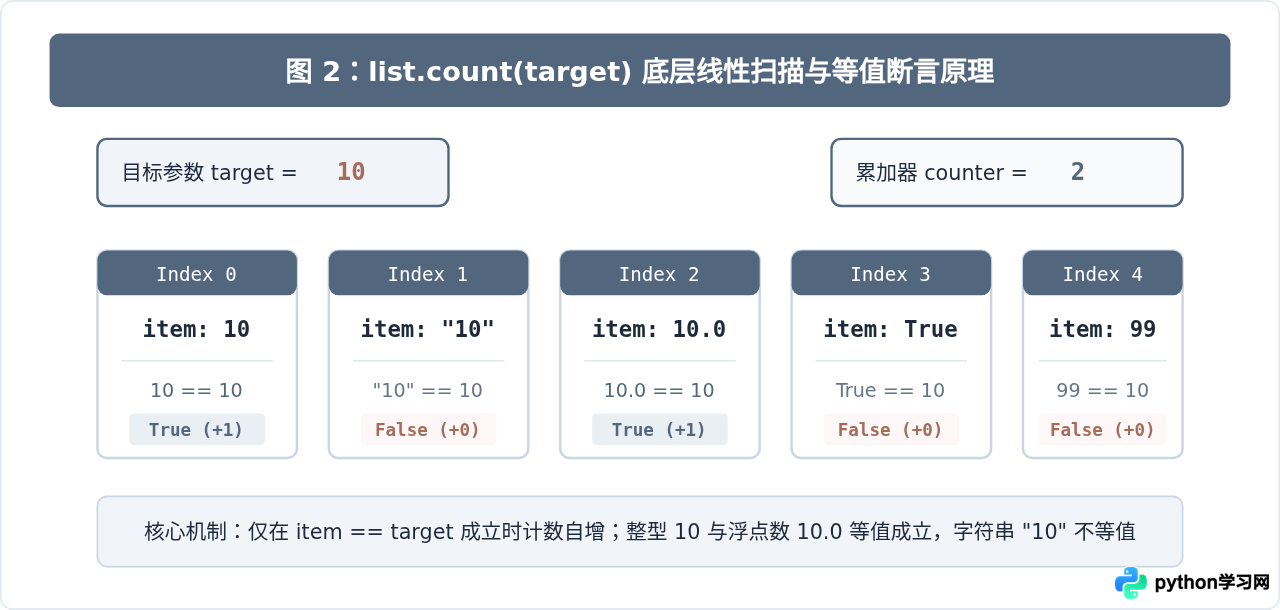
很多开发者在遇到统计结果不符时,会怀疑“Python 是否因为类型不匹配抛出了隐藏异常”。实际上,list.count() 的底层实现(在 CPython 中对应 listcount 函数)遵循简单的线性循环:遍历列表中的每个对象指针,依次执行 PyObject_RichCompareBool(item, value, Py_EQ)。
这意味着:
- 它不要求元素必须是同一类型:Python 允许列表中混合存放不同类型对象(如整数、浮点数、字符串、对象实例)。在比对时,并不会仅因类型不同就抛出
TypeError。 - 它是基于“等值判定”(
==),而非“同一性判定”(is):即使目标对象与列表中的对象属于不同的内存引用,只要其__eq__方法返回真,计数器就会自增 1。 - 若类型不同且无法等值比较:通常情况下,不同类型间的
==比较直接返回False,导致统计计数为0,不会产生控制台报错。
三、类型不匹配引发的“隐性故障”与特殊异常
类型不匹配在 list.count() 中往往不直接显式抛出 TypeError,而是以更加隐蔽的“逻辑异常”或特定库抛出的比较异常形式呈现。以下是开发中常见的三大陷阱:
1. 跨类型隐式相等陷阱:布尔值与整数混淆
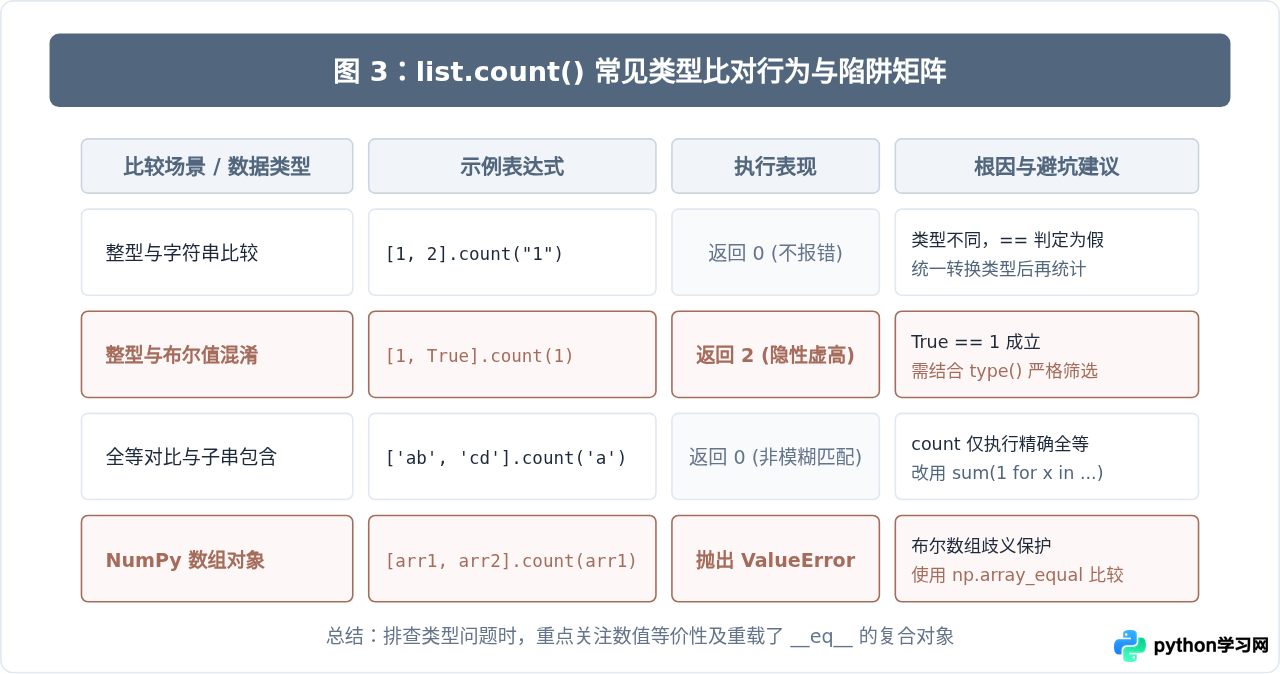
在 Python 中,bool 是 int 的子类,且在数值层面 True == 1 以及 False == 0 恒成立。如果列表中混合存在整数与布尔值,直接调用 count(1) 会将 True 也计入统计:
mixed_data = [1, 2, True, 0, False, 1]

# 预期统计整数 1 的个数,期望为 2
actual_count = mixed_data.count(1)
print(actual_count)  # 实际输出: 3 (因为 True == 1)
这种现象虽然不会报错,但会导致统计数据虚高。如果需要进行严格的类型限定,必须同时比对对象的值和类型。
2. 粒度不匹配:列表元素与子串检索混淆
开发者有时会将“统计包含某子串的元素个数”与“统计匹配元素”搞混:
filenames = ["report_2024.csv", "summary_2024.csv", "raw_data.xlsx"]

# 错误期望:统计包含 2024 的项
result = filenames.count("2024")
print(result)  # 输出: 0
因为列表中没有任何一个元素全等于 "2024",count() 逐项比较均为 False。针对这种需求,应当使用列表推导式配合 in 关键字进行统计:
# 正确统计子串匹配项
match_count = sum(1 for name in filenames if "2024" in name)
print(match_count)  # 输出: 2
3. 特殊数据结构引发的显式异常:NumPy 数组
如果列表中存放了包含多个元素的 NumPy 数组,在调用 count() 时,由于 NumPy 重载了 == 操作符以返回逐元素的布尔数组,Python 的内部逻辑在评估其真假时将引发崩溃:
import numpy as np

arr1 = np.array([1, 2, 3])
arr2 = np.array([4, 5, 6])
matrix_list = [arr1, arr2]

# 抛出 ValueError
matrix_list.count(arr1)
报错输出示例:
ValueError: The truth value of an array with more than one element is ambiguous. Use a.any() or a.all()这是因为 arr1 == arr1 返回的是 array([True, True, True]),在被作为单个布尔真值校验时触碰了 NumPy 的歧义保护机制。
四、防御式编程与工程解决方案
为了在工程项目中彻底避免参数缺失和类型混淆带来的异常,建议根据具体业务需求引入更严谨的计数范式。
1. 针对严格类型匹配的计数方案
若需要准确区分 1 与 True,或者 10 与 10.0,应结合 type() 校验进行统计:
def strict_count(seq, target):
    """同时校验值相等与类型一致的严格计数函数"""
    target_type = type(target)
    return sum(1 for item in seq if item == target and type(item) is target_type)

data = [1, True, 1.0, 2, 1]
print("默认 count:", data.count(1))          # 输出: 3 (1, True, 1.0 均匹配)
print("严格 count:", strict_count(data, 1))  # 输出: 2 (仅统计 int 类型的 1)
2. 针对范围与切片统计的最佳实践
如果列表极长(如包含数百万个元素),使用 lst[start:end].count(target) 会产生可观的内存切片开销。推荐使用 itertools.islice 实现零内存拷贝切片统计:
from itertools import islice

def slice_count(lst, target, start=0, stop=None):
    """无额外内存开销的切片统计"""
    it = islice(lst, start, stop)
    return sum(1 for item in it if item == target)

big_list = [5] * 1000000
result = slice_count(big_list, 5, 100, 200)
print(result)  # 输出: 100
3. 大批量不同元素的频次统计
如果需要在一个列表内多次调用 count() 统计不同元素,应避免多次遍历列表带来的 $O(k \times n)$ 时间复杂度,转而使用标准库 collections.Counter 实现 $O(n)$ 线性统计:
from collections import Counter

items = ["apple", "orange", "apple", "banana", "banana", "apple"]

# 一次遍历建立频次字典
counts = Counter(items)

print(counts["apple"])   # 输出: 3
print(counts["banana"])  # 输出: 2
print(counts["pear"])    # 不存在时安全返回 0,无异常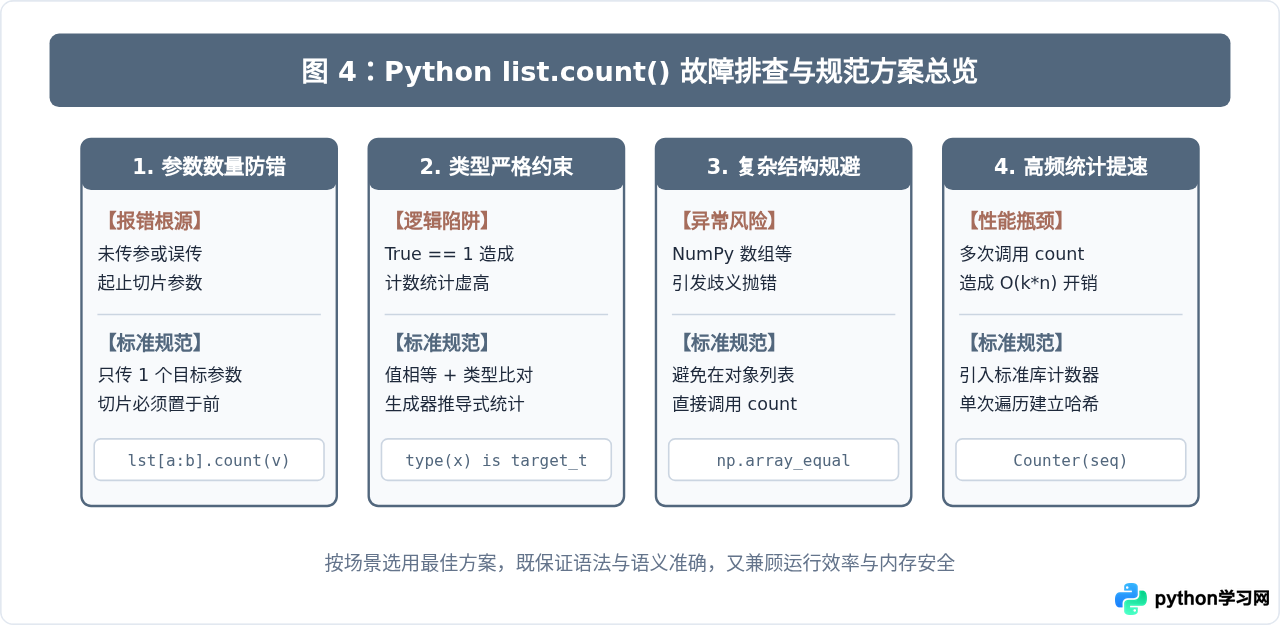
五、核心排查速查表
| 异常现象 / 报错信息 | 产生根因 | 规范修复方案 |
|---|---|---|
TypeError: list.count() takes exactly one argument (0 given) |
漏传目标参数 | 显式传入目标值,如 lst.count(val) |
TypeError: list.count() takes exactly one argument (3 given) |
误将切片起止索引直接作为参数传入 | 对原列表切片后再计数:lst[start:end].count(val) |
统计结果返回 0,但确定“存在相似内容” |
类型不一致(如字符串 vs 数值),或误以为是子串匹配 | 统一类型转换,或改用 sum(1 for x in lst if sub in x) |
统计结果偏大(例如 count(1) 统计到了 True) |
Python 中 True == 1 等值比较成立 |
加入类型过滤:sum(1 for x in lst if x == 1 and type(x) is int) |
ValueError: The truth value of an array... is ambiguous |
列表中包含 NumPy 数组等多值容器,重载的 == 返回布尔数组 |
改用列表推导式配合 np.array_equal 判定 |
掌握以上机制后,在日常编写 Python 代码时便能准确预判 list.count() 的行为边界,快速定位参数传递与类型判定中的异常,写出更加健壮的列表处理逻辑。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















