


怎么用Python标准库执行基本的XPath节点查找
详细讲解如何使用Python标准库xml.etree.ElementTree执行基础XPath节点查找,涵盖核心方法、支持语法、实战示例、命名空间处理与常见注意事项。
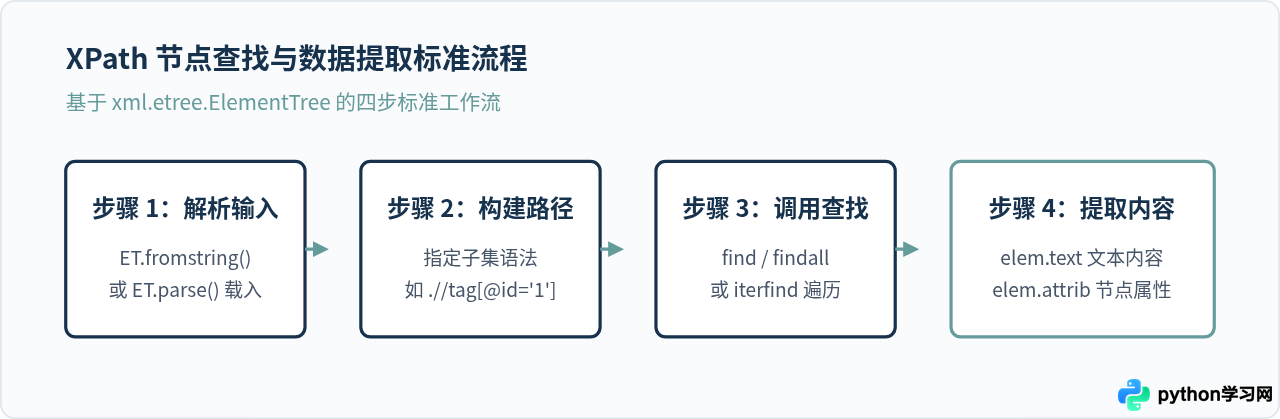
在Python中解析和提取XML数据时,并不一定要依赖第三方库(如lxml)。Python官方标准库自带的 xml.etree.ElementTree 模块原生提供了对基础XPath语法的支持。通过使用其内置的 find()、findall() 和 iterfind() 方法,你可以无需安装任何外部依赖,直接在XML文档中精准定位并提取所需的元素与属性。
一、标准库中的XPath处理机制
Python标准库实现的XPath并不是完整的XPath 1.0或2.0规范,而是一个专为轻量级解析设计的精简子集。这个子集涵盖了路径层级导航、属性精确匹配、父子关系定位和位置索引等高频核心操作,能够满足绝大多数常规XML配置读取与数据提取任务。
在开始编写代码前,我们需要了解标准库提供了三个核心的查找方法,它们均接收一个XPath表达式作为参数:
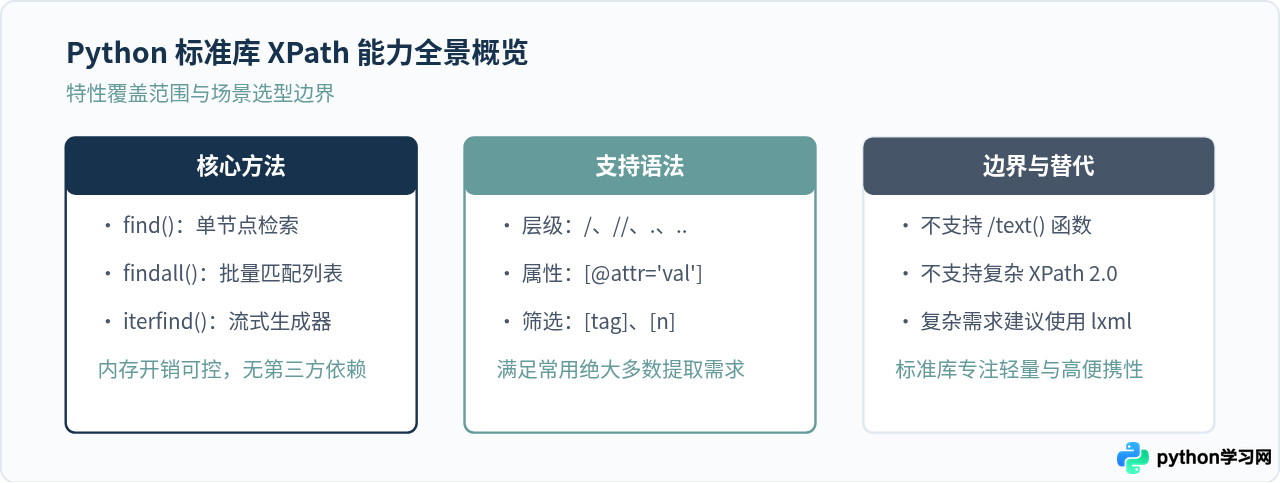
find(xpath):在当前节点及其子树中搜索,返回第一个匹配到的元素对象(Element),若未找到则返回None。findall(xpath):返回包含所有匹配元素的普通Python列表(list),若无匹配项则返回空列表[]。iterfind(xpath):以生成器迭代器形式依次产出匹配的元素,适合处理包含大量同名标签的大文件,能够节省内存开销。
二、标准库支持的常用XPath语法速查
标准库所支持的语法集中在最常用的路径定位逻辑上。下表梳理了官方支持的核心语法表达:
| 语法表达式 | 匹配含义 | 典型示例 |
|---|---|---|
tag |
匹配名称为 tag 的直接子元素 |
book(当前节点下的所有直接子标签 book) |
* |
匹配所有直接子元素(通配符) | book/*(book 下的所有直接子标签) |
. |
表示当前节点本身 | ./title(当前节点下的直接子标签 title) |
// |
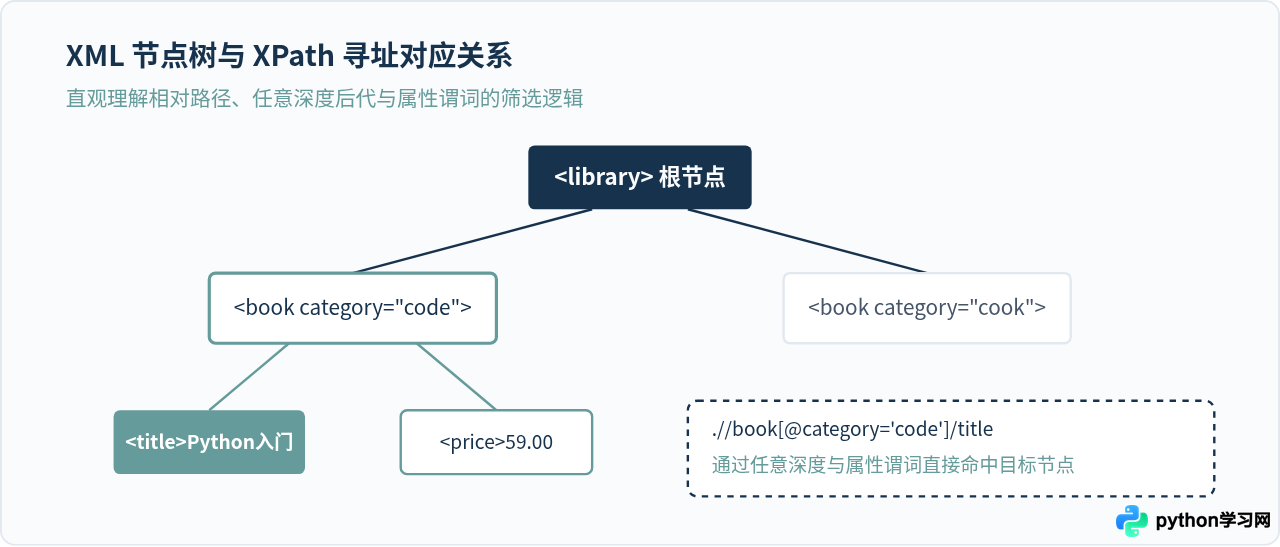
匹配当前节点下任意深度的后代元素 | .//author(文档中任意层级的 author 标签) |
.. |
选择当前节点的父元素 | ../category(父节点下的 category 兄弟节点) |
[@attrib] |
筛选具有指定属性名称的所有元素 | .//book[@isbn](所有具有 isbn 属性的 book 标签) |
[@attrib='value'] |
筛选指定属性严格等于给定值的元素 | .//book[@category='web'] |
[tag] |
筛选包含指定直接子元素的节点 | .//book[price](含有 price 子标签的 book) |
[position] |
筛选符合前面条件的第几个子元素(注意:从 1 开始计数) | book[1](第一个直接子元素 book) |
Python标准库不支持以下高级XPath功能:
- 不支持直接提取文本或属性值,如
//title/text()或//book/@id(表达式末尾必须是节点自身,提取内容需在Python中通过.text或.get()完成)。 - 不支持XPath内置函数,例如
count()、contains()、string-length()等。 - 不支持复杂的轴运算符,如
following-sibling::、ancestor::。
三、实战:从一段XML中定位并提取目标数据
下面通过一段完整的可运行代码,演示如何使用标准库解析XML字符串,并利用基础XPath语法完成不同维度的节点查找。
import xml.etree.ElementTree as ET

# 准备示例 XML 数据
xml_data = """


            Python编程核心
            张三
            89.00


            Expert Python Programming
            John Doe
            120.00


            现代Web实战
            李四
            65.00


"""

# 步骤 1:解析 XML 文本为根节点对象
root = ET.fromstring(xml_data)

# 步骤 2:使用 find() 定位第一个符合条件的单一节点
# 场景:查找整篇文档中的第一本图书标题
first_title = root.find(".//book/title")
if first_title is not None:
    print(f"第一个书名: {first_title.text}")

# 步骤 3:使用 findall() 按照属性精准查找多个节点
# 场景:提取所有语言为中文(lang='zh')的图书
zh_books = root.findall(".//book[@lang='zh']")
print(f"找到中文图书数量: {len(zh_books)}")

for book in zh_books:
    book_id = book.get("id")  # 获取节点属性
    title = book.find("title").text  # 获取子节点文本
    price = book.find("price").text
    print(f"[{book_id}] {title} - 价格: {price}元")

# 步骤 4:根据包含子节点的条件过滤
# 场景:查找包含 author 节点的 book
books_with_author = root.findall(".//book[author]")
print(f"包含作者信息的图书共计 {len(books_with_author)} 本")
运行上述代码,可以得到明确的输出:
第一个书名: Python编程核心
找到中文图书数量: 2
[b1] Python编程核心 - 价格: 89.00元
[b3] 现代Web实战 - 价格: 65.00元
包含作者信息的图书共计 3 本
四、关键场景:处理带有命名空间(Namespace)的XML
初学者在使用 ElementTree 进行 XPath 查找时,最常遇到的问题就是“明明路径写对了,却什么都查不出来”。这几乎都是由 XML 命名空间引起的。
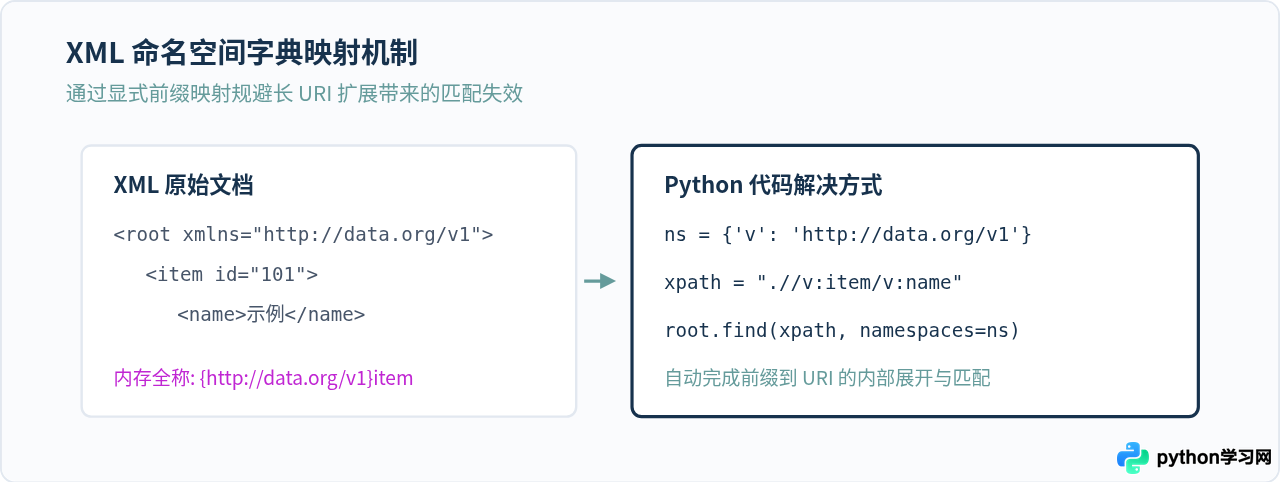
当 XML 声明了命名空间(例如 xmlns="http://example.com/ns")时,每个标签在内存中都会被展开为 {URI}tag 的格式。直接搜索 .//book 会无法匹配 {http://example.com/ns}book。
标准库给出的优雅解决方案是:定义一个命名空间映射字典,并在调用 find() 或 findall() 时传入 namespaces 参数。
import xml.etree.ElementTree as ET

xml_with_ns = """

    技术博客推送

        tag:101
        Python标准库技巧


"""

root = ET.fromstring(xml_with_ns)

# 定义前缀与 URI 的映射关系
ns_map = {"atom": "http://www.w3.org/2005/Atom"}

# 使用前缀:标签名进行 XPath 查找
entry_title = root.find(".//atom:entry/atom:title", namespaces=ns_map)

if entry_title is not None:
    print(f"成功命中带命名空间的节点: {entry_title.text}")
五、常见易错陷阱与优化建议
在日常使用中,除了命名空间之外,还有两个常见陷阱需要引起注意:
-
Element 对象的布尔值判断陷阱:
不要写if element:,而必须写if element is not None:。
在早期Python版本及Element规范中,一个Element对象如果没有任何子元素(即len(element) == 0),它的布尔值会评估为False。因此,即使成功找到了该节点,if element:也会判断为假,导致逻辑错误。 -
相对路径与递归查找的选择:
使用.//tag与tag的性能有较大差异。.//tag会递归遍历整棵子树中的每一个分支,在超大型XML文档中可能消耗较多时间;如果节点层级固定,建议尽可能使用精确的直接路径(如./section/book),不仅检索速度更快,意图也更加明确。
六、总结
使用 Python 标准库 xml.etree.ElementTree 执行基础 XPath 查找的核心要点可以归纳为三点:一是善用 find() 与 findall() 搭配 .//tag[@attr='val'] 语法进行定位;二是牢记表达式返回的是 Element 节点本身,取文本用 .text,取属性用 .get();三是遇到命名空间时主动传入 namespaces 前缀映射字典。掌握这套方法后,在标准 Python 环境中即可快速完成绝大多数 XML 数据的检索与处理任务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















