


Python数据分析开发指南:Pandas、NumPy与Matplotlib核心用法
一份聚焦实战的Python数据分析核心指南,系统拆解NumPy多维数组运算、Pandas数据清洗与分组统计、Matplotlib数据可视化规范及三者协同工作流。
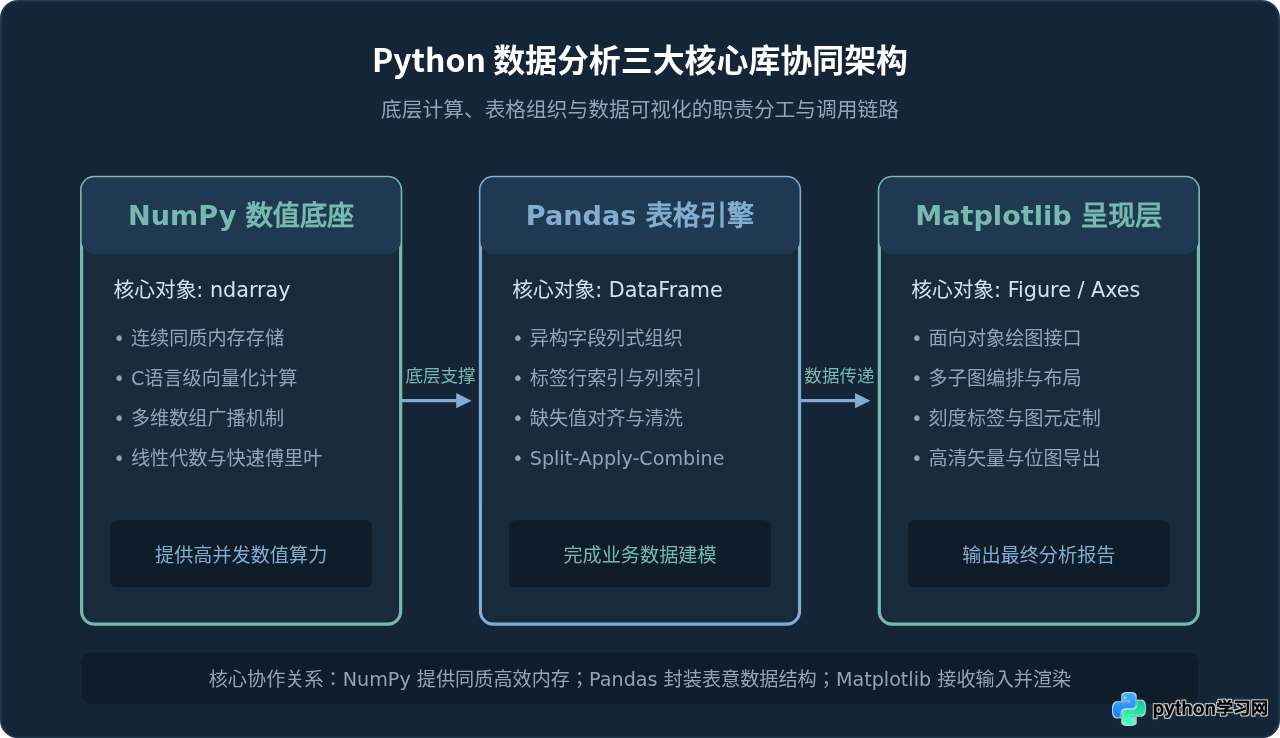
在日常数据开发工作中,我们常会遇到这样的情境:从系统导出了一批包含数万行交易明细的原始 CSV 文件,其中充斥着缺失的价格、不规范的日期时间字符串,以及未经汇总的用户属性。如果使用原生 Python 的字典和嵌套列表进行遍历与统计,不仅代码繁琐冗长,处理耗时也往往从几毫秒飙升到数分钟。解决这一痛点的关键,在于掌握 Python 数据分析工具链的三大基石:NumPy 负责底层高性能数组运算,Pandas 负责异构表格清洗与聚合统计,Matplotlib 则负责将核心结论直观转化为专业图表。本文将直接拆解这三个核心库的底层机制与高频用法,帮助你建立清晰连贯的分析链路。
一、NumPy 核心用法:高性能多维数组与矢量化
NumPy(Numerical Python)是整个 Python 科学计算生态的物理基石。很多开发者容易产生误解,认为它的功能可以通过原生 list 配合循环代替。然而,Python 原生列表存储的是指向对象的指针数组,元素在内存中分布离散,遍历时伴随着大量的类型解包与寻址开销。NumPy 的核心数据结构 ndarray 则在连续的内存空间中存储纯同质数据(例如全为 64 位浮点数),并借助底层的 C/Fortran 库直接调用 SIMD 指令集进行并行计算。
1. 数组创建与形状变换
在实际工程中,除了直接从已有列表转换,更常用的是使用内置生成函数快速初始化矩阵,并利用 reshape 调整维度。
import numpy as np

# 1. 快速创建指定形状的数组
arr_zeros = np.zeros((3, 4), dtype=np.float64)       # 3行4列的全0矩阵
arr_range = np.arange(0, 20, 2)                      # 类似range,步长为2:[0, 2, ..., 18]
arr_linspace = np.linspace(0, 1, 5)                  # 生成等间隔的5个数:[0., 0.25, 0.5, 0.75, 1.]

# 2. 形状调整与转置
matrix = np.arange(12).reshape((3, 4))
transposed = matrix.T                                # 转置为 (4, 3)
2. 向量化运算与广播机制(Broadcasting)
向量化运算指的是直接对整个数组执行算术或逻辑操作,避免书写任何显式 for 循环。当两个数组维度不匹配时,NumPy 会自动应用“广播规则”:从末尾维度开始向前比对,若各维度的长度相等,或其中一个维度的长度为 1,则可以沿长度为 1 的轴复制扩展后进行计算。
# 向量化加法与乘法
a = np.array([1, 2, 3])
b = np.array([10, 20, 30])
c = a * b  # 输出: array([10, 40, 90]),纯C语言级并发乘法

# 广播机制示例:(3, 3) 矩阵与 (1, 3) 向量相加
mat = np.ones((3, 3))
vec = np.array([10, 20, 30])
result = mat + vec  # 每行都加上 vec,输出形状依然为 (3, 3)
3. 布尔掩码与条件筛选
在数据清洗环节,我们经常需要找出大于某阈值或符合特定规则的值。NumPy 支持使用比较操作符生成布尔数组,并将布尔数组作为索引传入,从而瞬间完成提取或原地替换。
scores = np.array([78, 92, 55, 84, 46, 99])

# 生成布尔掩码
mask = scores >= 60
passing_scores = scores[mask]  # 提取及格分数:array([78, 92, 84, 99])

# 条件快速替换(类似于 SQL 的 CASE WHEN)
adjusted_scores = np.where(scores < 60, 60, scores)  # 低于60的分数统一补足为60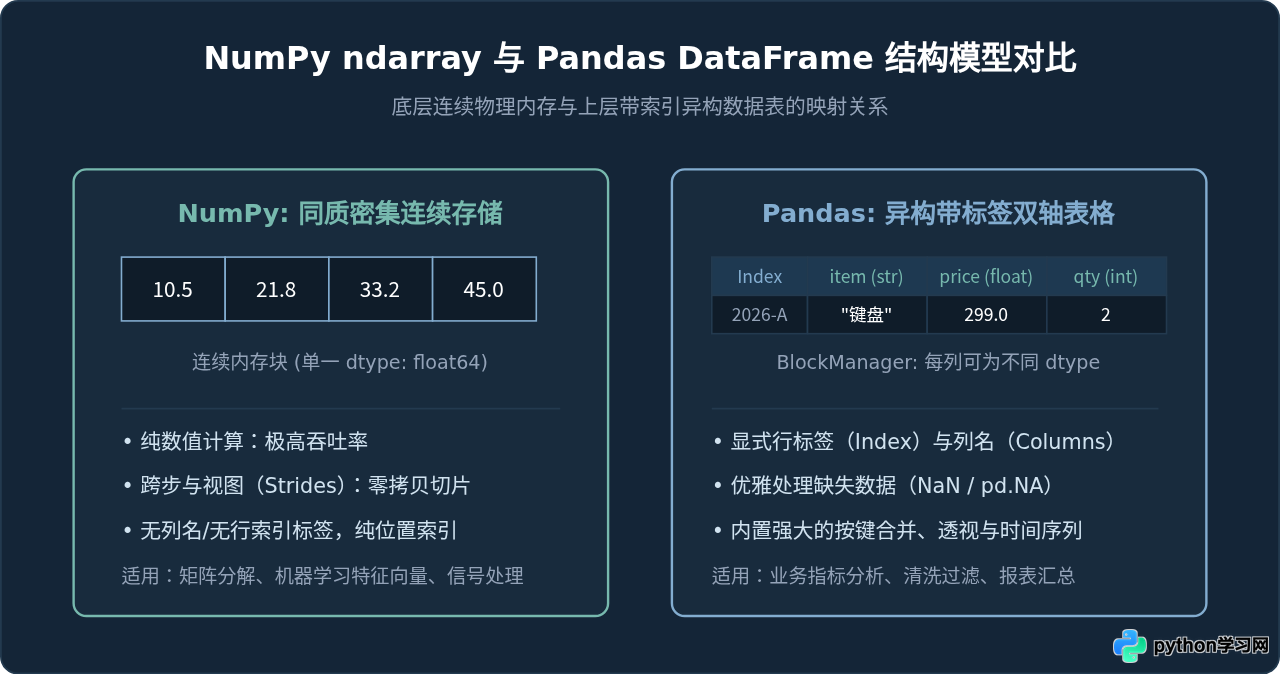
二、Pandas 核心用法:表格化数据清洗与分析
如果说 NumPy 解决的是“数学与矩阵”问题,那么 Pandas 则解决的是“业务与表单”问题。Pandas 构建在 NumPy 基础之上,将一维数组封装为带索引的 Series,将二维矩阵封装为包含行列名称的 DataFrame。日常数据分析中 80% 的清洗与统计工作都在这一层完成。
1. 核心索引方式:loc 与 iloc 的严格区分
在筛选和定位数据时,开发者最常踩的坑是直接使用链式方括号索引(如 df['col'][0]),这极容易触发臭名昭著的 SettingWithCopyWarning。生产级代码必须严格使用 loc 和 iloc:
df.loc[行标签, 列标签]:基于名称/标签(Label-based)索引。切片包含末尾边界。df.iloc[行位置, 列位置]:基于纯整数位置(Position-based)索引。切片遵循 Python 惯例,前闭后开(不包含末尾)。
import pandas as pd

df = pd.DataFrame({
    'category': ['数码', '数码', '日用', '食品', '数码'],
    'item': ['键盘', '鼠标', '纸巾', '坚果', '显示器'],
    'price': [299.0, 89.0, 19.9, 45.0, 1499.0],
    'sales_volume': [120, 350, 800, 260, 45]
}, index=['p1', 'p2', 'p3', 'p4', 'p5'])

# 正确示例 1: 使用 loc 提取 p1 到 p3 行的 category 和 price 列
sub_df1 = df.loc['p1':'p3', ['category', 'price']]

# 正确示例 2: 使用 iloc 提取前 2 行、前 3 列
sub_df2 = df.iloc[0:2, 0:3]

# 正确示例 3: 条件布尔索引与安全修改(避免 SettingWithCopyWarning)
mask = (df['category'] == '数码') & (df['price'] > 100)
df.loc[mask, 'tag'] = '高客单数码'
2. 缺失值诊断与清洗策略
外部数据源常见脏数据或空值。Pandas 提供了成体系的缺失值治理函数:
df.isna().sum():快速按列统计缺失数量。df.dropna(subset=['price'], how='any'):直接丢弃关键字段为空的行。df.fillna({'price': df['price'].median(), 'tag': '常规'}):对不同字段采用不同的填补策略(如数值列填充中位数,文本列填充默认值)。
3. 分组聚合:Split-Apply-Combine 模式
数据汇总的灵魂在于 groupby。它的底层遵循拆分(Split)、应用计算(Apply)和合并(Combine)三部曲。在实际业务中,推荐配合 agg() 字典传递不同的聚合规则,一次性产出多维度指标:
# 针对品类进行多指标聚合汇总
category_summary = df.groupby('category').agg(
    total_sales=('sales_volume', 'sum'),
    avg_price=('price', 'mean'),
    max_price=('price', 'max'),
    sku_count=('item', 'count')
).reset_index()

# 结果将生成包含每个类别的总销量、均价、最高价与商品数的汇总表
三、Matplotlib 核心用法:面向对象绘图与报表定制
在完成数据清洗与汇总后,最后一步是将结构化指标转化为能够驱动决策的可视化图表。Matplotlib 是 Python 中最成熟的绘图库,几乎所有高级可视化库(包括 Seaborn)都建立在其 API 之上。
1. 告别 pyplot,全面采用面向对象(Object-Oriented)接口
很多初学者习惯使用类似于 MATLAB 的 plt.plot() 全局命令,但在绘制复杂多图或多子图时,全局状态容易发生错乱。现代规范是显式创建 Figure(画布)和 Axes(坐标系子图),直接调用 ax 实例的方法完成渲染:
import matplotlib.pyplot as plt

# 规范写法:初始化画布与一个或多个子图坐标系
fig, ax = plt.subplots(figsize=(8, 4.5), dpi=100)

# 通过 ax 对象绘图并配置属性
ax.plot([1, 2, 3, 4], [10, 25, 18, 30], color='#83add0', lw=2, marker='o')
ax.set_title('月度订单增长趋势', fontsize=14, color='#ffffff')
ax.set_xlabel('月份', fontsize=11, color='#94a3b8')
ax.set_ylabel('成交量(单)', fontsize=11, color='#94a3b8')
ax.grid(True, linestyle='--', alpha=0.3)
2. 解决中文显示乱码与负号方块问题
Matplotlib 默认字体库为 DejaVu Sans,无法显示中文字符,会呈现为方块或问号(豆腐块)。必须在脚本开头配置系统内置中文字体:
# 配置中文字体与负号正常显示
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False  # 确保坐标轴负号正常渲染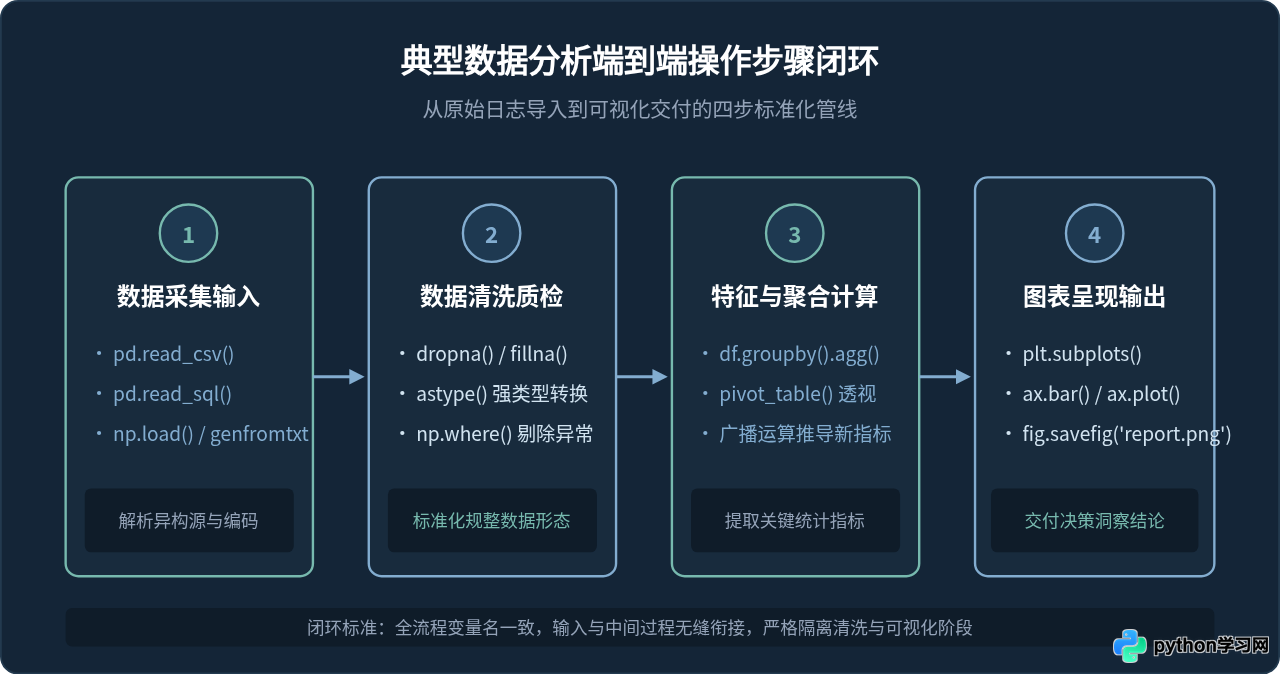
四、三库联动实战:从脏数据到多维度业务图表
下面通过一个完整的、可直接执行的代码示例,展示三个库在真实场景中如何紧密配合完成端到端分析:利用 NumPy 快速构建带波动的样本,利用 Pandas 进行空值修补与按品类汇总,最后利用 Matplotlib 输出双子图分析报表。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# 1. 设置中文字体与显示规范
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False

# 2. 模拟构建业务销售数据源(NumPy 矢量化生成)
np.random.seed(42)
n_rows = 1000
categories = np.random.choice(['数码产品', '生活家居', '生鲜食品', '图书文具'], size=n_rows)
base_prices = {'数码产品': 800.0, '生活家居': 120.0, '生鲜食品': 45.0, '图书文具': 60.0}

# 利用 NumPy 广播机制叠加正态波动
prices = np.array([base_prices[c] for c in categories]) + np.random.normal(0, 15, size=n_rows)
quantities = np.random.poisson(lam=3, size=n_rows) + 1

# 人为引入部分缺失数据以模拟现实
raw_prices = prices.copy()
raw_prices[np.random.choice(n_rows, 30, replace=False)] = np.nan

# 3. Pandas 数据建模与清洗
df = pd.DataFrame({
    'category': categories,
    'price': raw_prices,
    'quantity': quantities
})

# 清洗策略:缺失价格按品类均值填补
df['price'] = df.groupby('category')['price'].transform(lambda x: x.fillna(x.mean()))
# 计算衍生指标:总销售额
df['total_amount'] = df['price'] * df['quantity']

# 聚合统计:按品类汇总总销售额与平均订单量
summary = df.groupby('category').agg(
    revenue=('total_amount', 'sum'),
    avg_qty=('quantity', 'mean')
).sort_values(by='revenue', ascending=False)

# 4. Matplotlib 面向对象双子图绘制
fig, (ax1, ax2) = plt.subplots(nrows=1, ncols=2, figsize=(12, 5), dpi=100)

# 子图 1: 各品类总营收柱状图
bars = ax1.bar(summary.index, summary['revenue'] / 10000, color='#83add0', width=0.55)
ax1.set_title('各品类总营收规模(万元)', fontsize=12, fontweight='bold')
ax1.set_ylabel('营收(万元)', fontsize=10)
ax1.grid(axis='y', linestyle='--', alpha=0.3)
for bar in bars:
    yval = bar.get_height()
    ax1.text(bar.get_x() + bar.get_width()/2, yval + 0.1, f'{yval:.2f}', ha='center', va='bottom', fontsize=9)

# 子图 2: 均单购买件数对比
ax2.plot(summary.index, summary['avg_qty'], marker='o', lw=2.2, color='#77b9ae')
ax2.set_title('各品类平均客单购买件数', fontsize=12, fontweight='bold')
ax2.set_ylabel('件数', fontsize=10)
ax2.set_ylim(0, summary['avg_qty'].max() * 1.3)
ax2.grid(True, linestyle='--', alpha=0.3)

plt.tight_layout()
# 示例保存命令:fig.savefig('sales_summary.png', dpi=300)避坑提示:在上述代码中,使用了 transform(lambda x: x.fillna(x.mean()))。与普通 apply 改变数据维度不同,transform 会返回与原 DataFrame 长度严格一致的 Series,非常适合直接赋回原列,避免产生多重索引对齐错误。
五、核心用法与高频误区速查全景
为了在实际开发中少走弯路,以下整理了三库最容易用错的语法陷阱与最佳实践对应规则:
| 场景与诉求 | 低效/易错写法 | 规范与高性能写法 | 底层原因与解释 |
|---|---|---|---|
| 行筛选与赋值 | df[df.col > 0]['val'] = 1 |
df.loc[df['col'] > 0, 'val'] = 1 |
前者返回切片副本,赋值可能丢失并报 SettingWithCopy 警告 |
| 多条件过滤 | df[cond1 and cond2] |
df[(cond1) & (cond2)] |
Python 逻辑 and 无法逐元素求值,必须用位运算符 & 并为每个条件加括号 |
| 逐行求和遍历 | for idx, row in df.iterrows(): |
df['a'] + df['b'] 或 np.sum(axis=1) |
iterrows() 将每一行解包为 Series,速度慢百倍;向量化直接在连续内存计算 |
| 图表布局重叠 | 绘制多图后直接 plt.show() |
调用 fig.tight_layout() |
自动调整子图边距,防止 x 轴文字与相邻子图标题相互遮挡 |
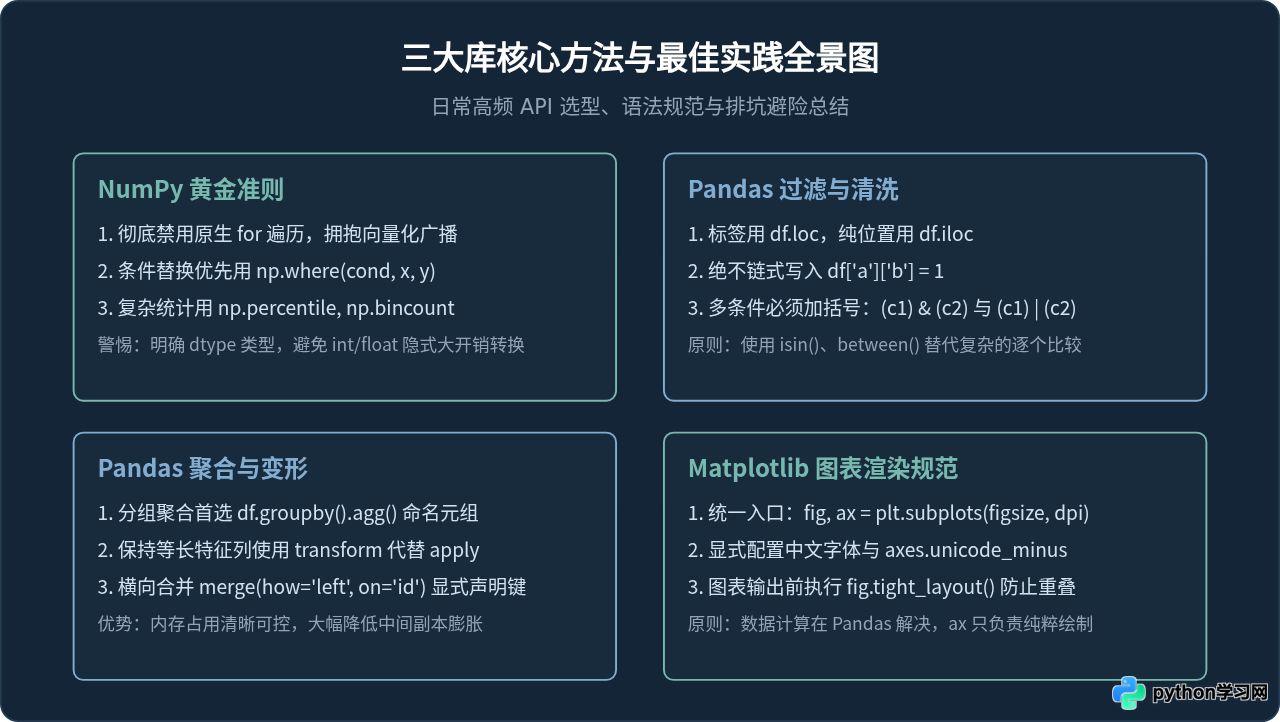
熟练掌握 NumPy、Pandas 和 Matplotlib 的协作范式,核心不在于死记硬背每个 API,而在于清楚数据在每个阶段的形态:当追求底层矩阵并行运算与数值处理时,使用 NumPy 的 ndarray 向量化;当面对包含多类型字段的业务明细、需要清洗、筛选和聚合时,调用 Pandas 的 DataFrame 工具箱;当需要将冰冷的数据结果呈现为业务洞察时,借助 Matplotlib 面向对象 API 进行精准绘制。按照这一链路组织代码,就能在保证分析效率的同时,写出高鲁棒、易维护的工程级数据分析项目。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















