


Google Colab与普通在线Python编译器有什么区别
深入对比Google Colab与普通在线Python编译器的本质区别,从执行模式、硬件算力、持久化存储到生态扩展,系统分析两者的技术架构与实际应用场景选择。
一、执行模式与交互形态的本质差异
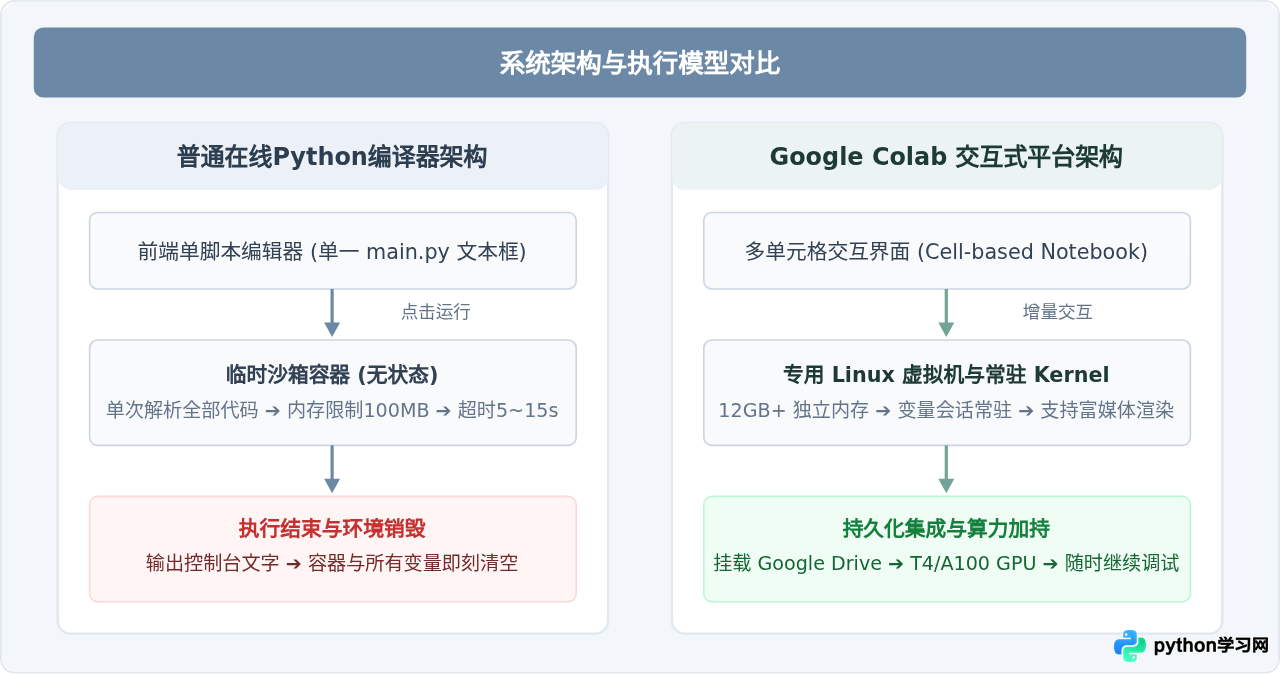
日常接触到的普通在线Python编译器(如各种菜鸟工具、各类在线运行沙箱)大多遵循“提交脚本—后端执行—全量输出”的工作流。用户在一个单一的代码编辑框中写好脚本,点击“运行”按钮,服务端临时分配微型容器,执行该脚本并把打印结果(stdout/stderr)返回到浏览器终端,随后该容器环境与内存即刻释放销毁。
与这种模式不同,Google Colab基于Jupyter Notebook交互形态构建。其工作空间被切分为若干个独立的“代码单元格(Code Cell)”与“文本单元格(Markdown Cell)”。当读者在Colab中执行某个单元格时,其计算结果与变量会直接保存在后台常驻的Python内核(Kernel)内存中。
这种交互模式带来了显著的工作流差异:如果在前面的单元格中加载了一个体量较大的CSV文件或构建了一个模型结构,后续所有单元格都可以直接访问该变量,无需像普通在线编译器那样每次修改微小逻辑就必须重新从头执行全部加载步骤。
二、计算硬件与底层环境权限
运行环境所分配的底层系统权限与硬件资源,是区分两者的另一项决定性指标。
普通在线编译器为了防范滥用并控制服务器成本,通常会对代码执行做极严苛的沙箱隔离。用户无法访问底层的操作系统Shell,不能随意安装系统层级软件包,CPU核心数一般限制在0.1至0.5核之间,内存通常只有几十兆到两百兆,而且不支持GPU加速,运行耗时超过十几秒就会直接报错中断。
Google Colab为每个连接的用户分配一个完整的Ubuntu Linux容器实例。用户不仅能够使用标准Python,还可以直接通过感叹号 ! 执行Linux终端Bash命令。例如在单元格中输入并运行以下命令,即可查看分配给当前实例的详细硬件信息:
# 示例:在Colab单元格中查看底层系统和GPU硬件配置
!cat /etc/os-release | grep "PRETTY_NAME"
!free -h
!nvidia-smi
此外,Google Colab最受开发者青睐的特性是其提供免费的硬件加速选项。在“修改运行时类型”设置中,用户可以自由切换为GPU(通常为NVIDIA Tesla T4)或Google专属的TPU芯片。这使得深度学习训练、大模型权重推理、图像处理等高算力需求任务在浏览器中成为可能。
三、数据挂载与持久化存储能力
编写程序离不开读写文件。在普通在线编译器中,文件系统的生命周期与程序进程严格绑定。虽然部分在线工具允许上传小型文本文件,但在页面刷新或代码执行完毕后,所有写入的文件都会被重置。这种机制决定了普通编译器无法用于处理大体量数据清洗、训练模型检查点保存等工作。
Google Colab提供了两种层级的文件管理机制:
- 本地临时存储:每个虚拟机分配了约100GB的临时磁盘空间,通过左侧侧边栏或代码直接读写,在当前会话存活期间始终可用。
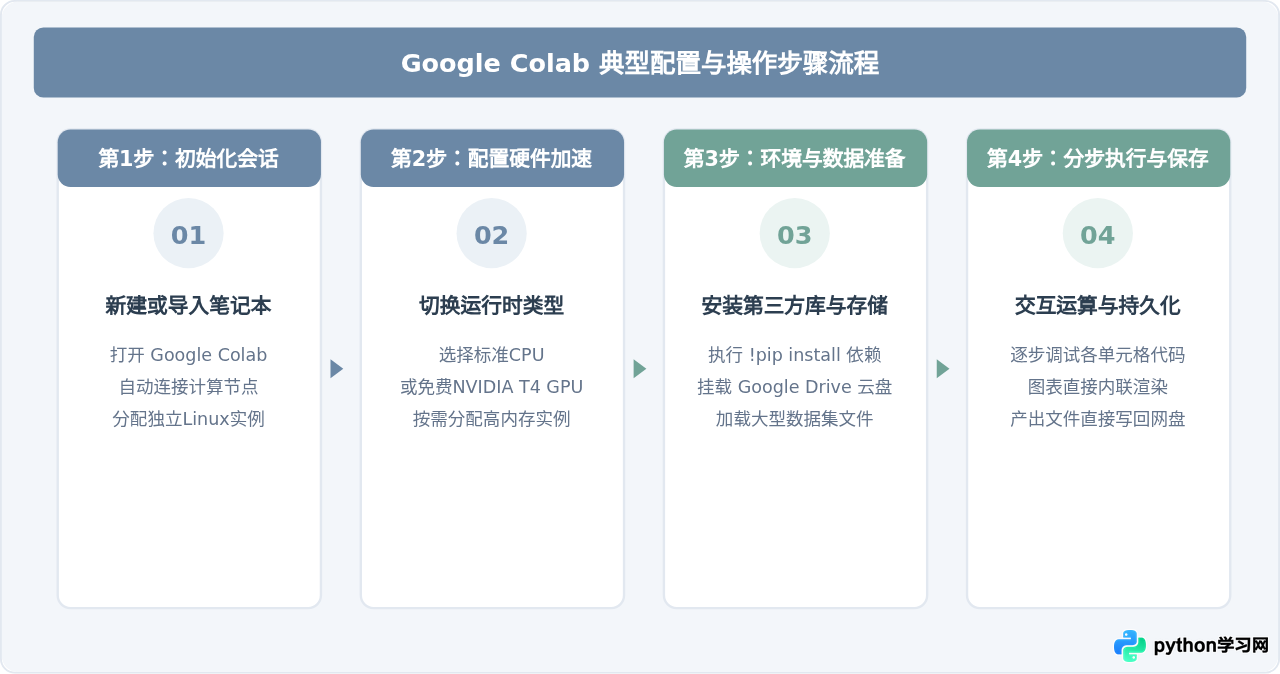
- Google Drive深度挂载:通过官方提供的挂载接口,两行代码即可将个人的Google云端硬盘映射为Linux文件系统的本地路径:
# 示例:将个人的Google Drive挂载到Colab虚拟机路径
from google.colab import drive
drive.mount('/content/drive')

# 挂载成功后,即可像操作本地目录一样读写持久化文件
with open('/content/drive/MyDrive/dataset.txt', 'r', encoding='utf-8') as f:
    content = f.read()
    print("数据读取成功,字符总数:", len(content))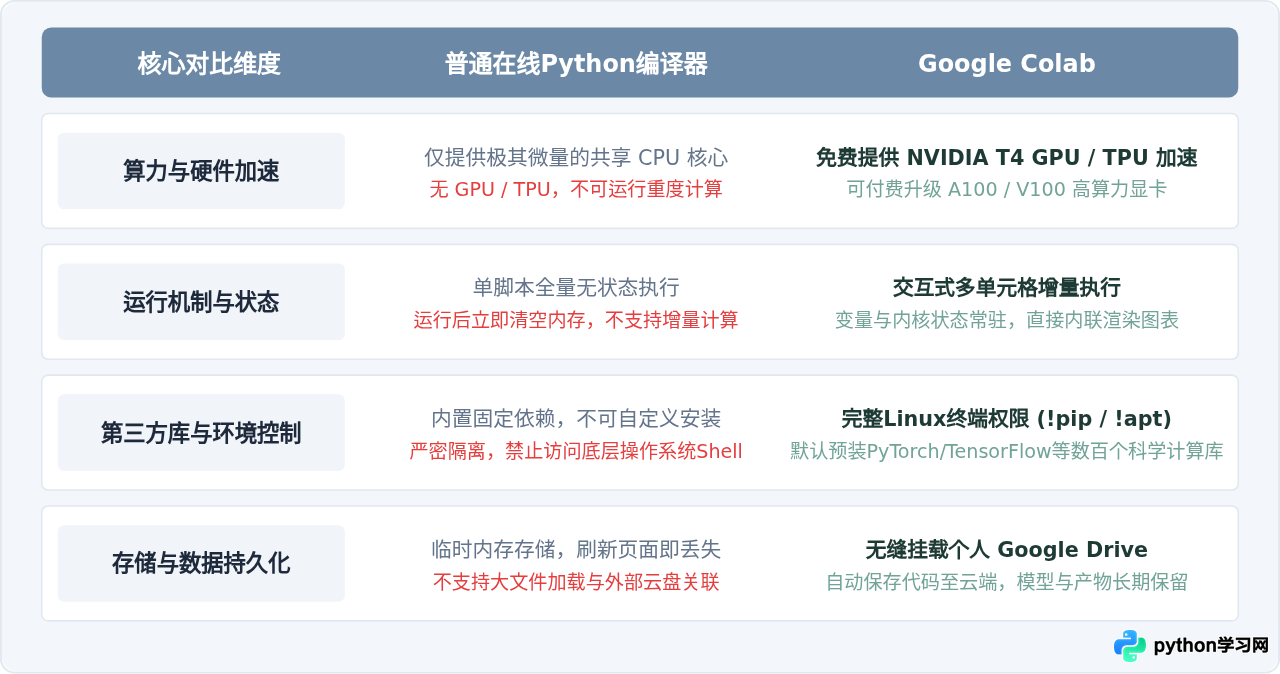
四、适用场景与选型决策
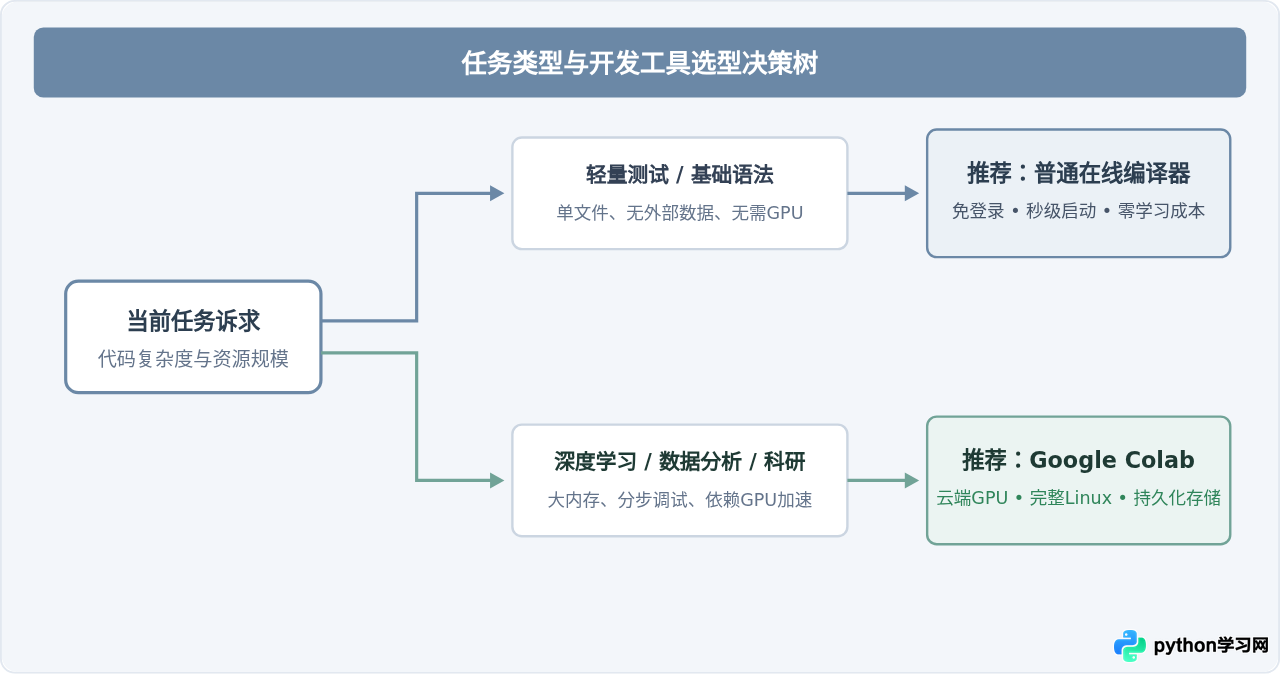
明确了两者在架构与性能上的分界线后,如何根据具体任务挑选合适工具便有了清晰的依据:
1. 适合选择普通在线编译器的场景
- 语法与函数快速验证:当你想测试一个正则表达式、验证字符串切片规则或确认某个内置函数(如
sorted()的key参数)的输出行为时,普通在线编译器无需登录、无需连接运行时,打开页面即可瞬间运行。 - 编程初学者的入门体验:对于完全没有编程经验的新手,无需理解虚拟机、Kernel内核和文件系统,仅需关注
print("Hello World")的直接输出。 - 跨设备轻量应急:在公用电脑或移动设备上临时排查一段纯算法逻辑。
2. 适合选择Google Colab的场景
- 机器学习与深度学习研发:需要调用 PyTorch、TensorFlow 或 Hugging Face 模型,且本地缺少高性能显卡时,Colab 是最便捷的高算力实验平台。
- 数据分析与可视化:使用 Pandas 处理千万行数据表格,配合 Matplotlib 或 Seaborn 绘制图表,笔记本的富文本渲染可以直接将图表与说明内嵌在代码下方。
- 论文复现与协作分享:支持将代码块、数学公式(LaTeX)与文字解释排版在一起,并能一键保存为 GitHub Gist 或分享给团队协同批注。
五、注意事项与限制条件
在享受Google Colab强大算力的同时,开发者需要关注其内在的资源配额机制:
/content/ 临时目录)中的数据在断开后将全部抹除。因此,长期运行的模型权重与数据集务必实时写入已挂载的 /content/drive/MyDrive/ 路径。
相比之下,普通在线编译器虽然没有会话长期保留的机制,但其优势在于没有任何身份绑定与前置等待成本,随用随走,是调试基础算法题和学习基本语法规则时效率最高的轻便工具。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















