


Python学习路线规划:Web开发、数据分析与自动化办公侧重点有何不同
深入对比Python在Web开发、数据分析与自动化办公三大主流方向的学习路线与核心侧重差异,梳理技能树演进、思维模型及真实工程落地要点,帮助学习者制定精准的学习规划。
许多初学者在学完 Python 变量、循环和函数等基础语法后,常误以为接下来只要顺着一条固定的“高级教程”就能通晓所有领域。事实上,Python 广泛应用于 Web 后端、数据分析与自动化办公三大方向,但它们在技术栈、思维模型、交付成果以及工程要求上有着截然不同的侧重点:Web 开发的核心在于“高可用架构与状态交互”,数据分析的核心在于“数据清洗与业务统计洞察”,而自动化办公的核心在于“跨格式异构对接与高容错执行”。理清这三者的分水岭,是制定合理学习规划的前提。
一、三大方向的核心分水岭:能力模型与思维差异
学习路线规划的前提是准确理解目标方向在实际生产中到底在解决什么问题。语法只是工具的表达方式,而各领域的核心逻辑决定了你该把有限的精力放在哪里。
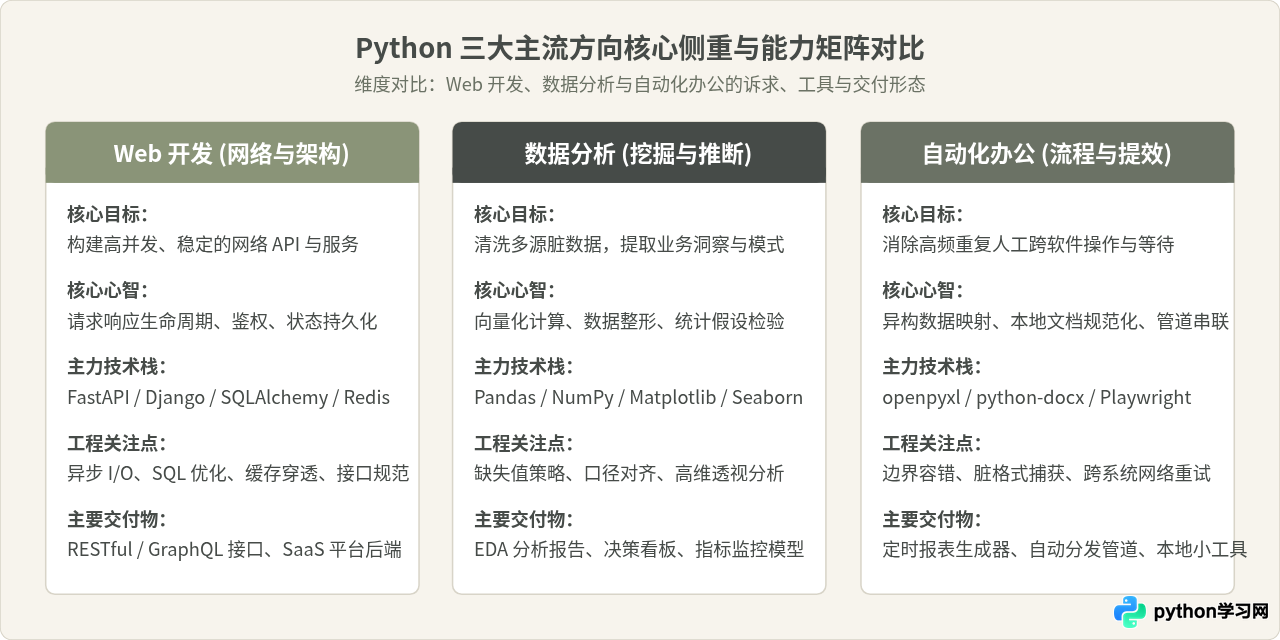
一个普遍的混淆认识是:“学会了循环和字典,写个脚本爬取数据是自动化,存入数据库是 Web,画个折线图就是数据分析,所以三者差不多。”这种观点看似合理,是因为它只看到了代码表层的语法相似性,却忽略了不同方向在面临“工程规模扩大”时的瓶颈所在。
当项目规模扩大时:
- Web 开发的瓶颈立刻转移到网络并发与数据一致性:如何处理 1000 个用户同时下单时的数据库锁?JWT Token 如何安全续期?如何通过 Redis 抵挡高频读取?
- 数据分析的瓶颈在于计算范式与统计有效性:数千万行日志下循环遍历必然崩溃,必须切换为矢量化矩阵运算;同时更要警惕辛普森悖论与数据采样偏差。
- 自动化办公的瓶颈在于非标输入与鲁棒性:某个业务员上传的 Excel 单元格被随意合并了该怎么读?第三方系统接口突然超时如何无损重试?这些工程边界才是自动化脚本能否长期稳定运行的关键。
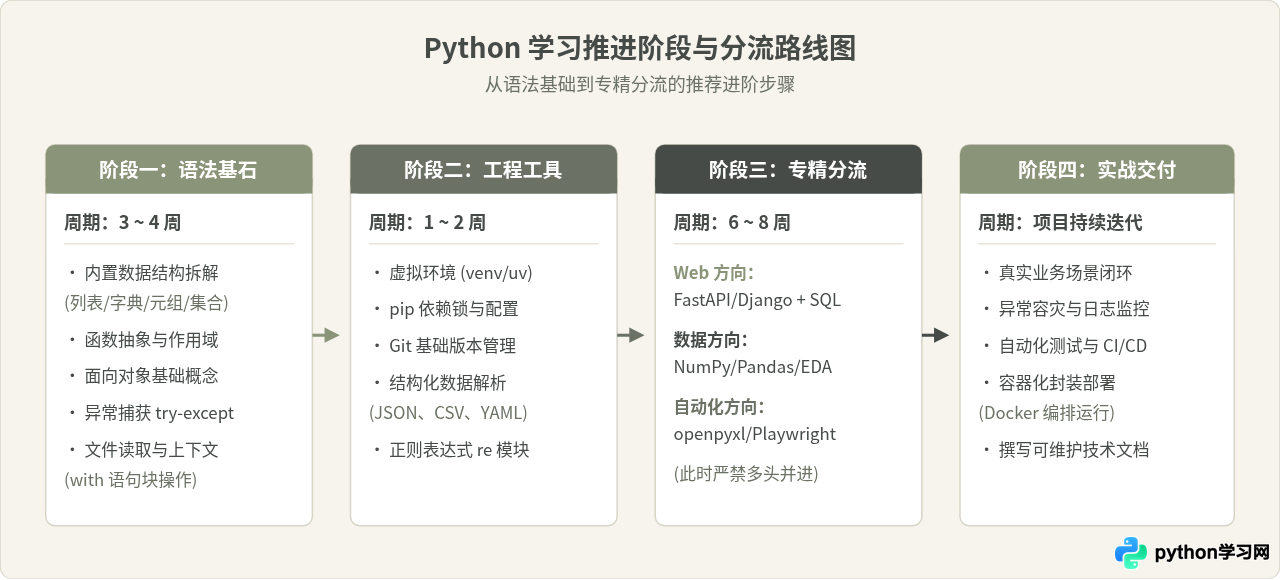
二、通用的演进路线:从语法基础到技术分流
无论未来选择哪个方向,前期的基础沉淀都是相同的。但在完成基础之后,应当迅速进行方向收敛,而不是无目的地刷题或泛读全栈教材。
三、三条主流路线的细化拆解与侧重点对比
1. Web 开发路线:侧重系统架构与服务持久化
Python Web 开发的核心任务是向网络客户端(浏览器、移动端 App 或微服务)提供稳定、安全的数据接口。学习这门路线的难点很少在 Python 语言本身,而在于底层网络协议与后端工程体系。
- 必须掌握的协议与基础:HTTP/HTTPS 请求头、状态码(如 200、401、404、500 的严格含义)、Cookie 与 Session、RESTful API 规范。
- 框架选型:目前推荐以
FastAPI(现代异步轻量、自动生成 OpenAPI 文档、类型提示完备)或Django(电池齐全、内置管理后台、全套 ORM 系统)作为主力。 - 数据持久化与数据库:熟练使用 SQL(PostgreSQL / MySQL),深刻理解主键、索引原理与事务隔离;掌握 ORM 映射(如 SQLAlchemy / Tortoise ORM),并学会规避严重的
N+1 查询性能陷阱。
下面是一个使用 FastAPI 实现简洁参数校验与业务返回的代码示例:
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field

app = FastAPI(title="用户任务状态服务")

class TaskUpdateRequest(BaseModel):
    task_id: str = Field(..., min_length=4, description="任务唯一标识符")
    status_code: int = Field(..., ge=0, le=5, description="状态代码 0-5")

@app.post("/api/v1/tasks/status", status_code=status.HTTP_200_OK)
async def update_task_status(payload: TaskUpdateRequest):
    # 模拟业务逻辑验证
    if payload.task_id == "error_id":
        raise HTTPException(
            status_code=status.HTTP_404_NOT_FOUND,
            detail="指定的任务未找到,无法更新状态"
        )
    return {"code": 200, "message": "状态更新成功", "data": payload.dict()}
2. 数据分析路线:侧重矩阵计算与业务推断
数据分析路线的目标是从杂乱无章的业务数据中发现规律并支持商业或科研决策。其核心心智是矢量化计算(Vectorization)和探索性数据分析(EDA)。
- 运算核心(NumPy 与 Pandas):抛弃传统的 for 循环思维。掌握多维数组切片、Series 与 DataFrame 结构、布尔索引过滤、多级索引(MultiIndex)以及
groupby、merge、pivot_table。 - 清洗与预处理:面对实际数据时,80% 的时间在处理缺失值(
fillna / dropna)、异常值截断、类型强制转换以及时间序列重采样(resample)。 - 业务逻辑与统计学:不仅要会调用库函数,更要知道均值、中位数、分位数的适用边界,掌握假设检验、A/B 测试评估及相关性分析。
下面是典型的 Pandas 向量化清洗与分组聚合示例:
import pandas as pd

# 示例:构建多渠道交易数据并计算核心转化指标
raw_data = {
    "channel": ["Organic", "Paid", "Paid", "Organic", "Social", "Paid"],
    "order_amount": [120.5, None, 450.0, 89.0, 210.0, None],
    "is_converted": [1, 0, 1, 1, 0, 0]
}

df = pd.DataFrame(raw_data)

# 1. 清洗缺失值:将未付款金额填充为 0.0 并统一类型
df["order_amount"] = df["order_amount"].fillna(0.0)

# 2. 向量化计算:按推广渠道分组聚合客单价与转化率
channel_summary = df.groupby("channel").agg(
    total_revenue=("order_amount", "sum"),
    avg_revenue=("order_amount", "mean"),
    conversion_rate=("is_converted", "mean")
).reset_index()

# 示例输出:明确查看统计计算结果
#    channel  total_revenue  avg_revenue  conversion_rate
# 0  Organic          209.5       104.75              1.0
# 1     Paid          450.0       150.00              0.33
# 2   Social          210.0       210.00              0.0
3. 自动化办公路线:侧重异构文件解析与高容错执行
自动化办公的目的是将繁杂、重复的人工跨软件流程脚本化。与其他两个方向相比,自动化办公面临的外部环境最为杂乱,必须时刻防范格式不规范、网络抖动和软件权限锁定。
- 本地文档处理库:Excel 批量读写(
openpyxl)、Word 模板填充(python-docx)、PDF 表格提取与合并(pypdf/pdfplumber)。 - 网页与跨端交互:使用
Playwright替代已经过时的 Selenium 进行网页无头自动化,稳定处理表单提交、动态渲染等待与验证码。 - 容错与调度:加入完善的错误重试(如
tenacity库)、日志记录(loguru)、定时任务调度(Windows Task Scheduler / Linux Cron)。
下面是批量处理 Excel 文件时加入容错与格式清理的典型代码示例:
from pathlib import Path
import openpyxl

def batch_process_excel_reports(source_folder: str, target_summary_file: str):
    folder = Path(source_folder)
    wb_out = openpyxl.Workbook()
    ws_out = wb_out.active
    ws_out.title = "汇总数据"
    ws_out.append(["文件名", "部门", "本月结算额"])

    for file_path in folder.glob("*.xlsx"):
        # 跳过临时锁文件
        if file_path.name.startswith("~$"):
            continue
        try:
            wb_in = openpyxl.load_workbook(file_path, data_only=True)
            ws_in = wb_in.active
            # 提取单元格数据(加入类型安全校验)
            dept = ws_in["B2"].value or "未登记部门"
            amount = ws_in["C2"].value or 0.0
            ws_out.append([file_path.name, str(dept).strip(), float(amount)])
        except Exception as exc:
            # 记录异常但保证整个批量进程不中断
            print(f"[警告] 处理文件 {file_path.name} 失败: {exc}")

    wb_out.save(target_summary_file)
四、三大方向典型工作流与处理管道架构
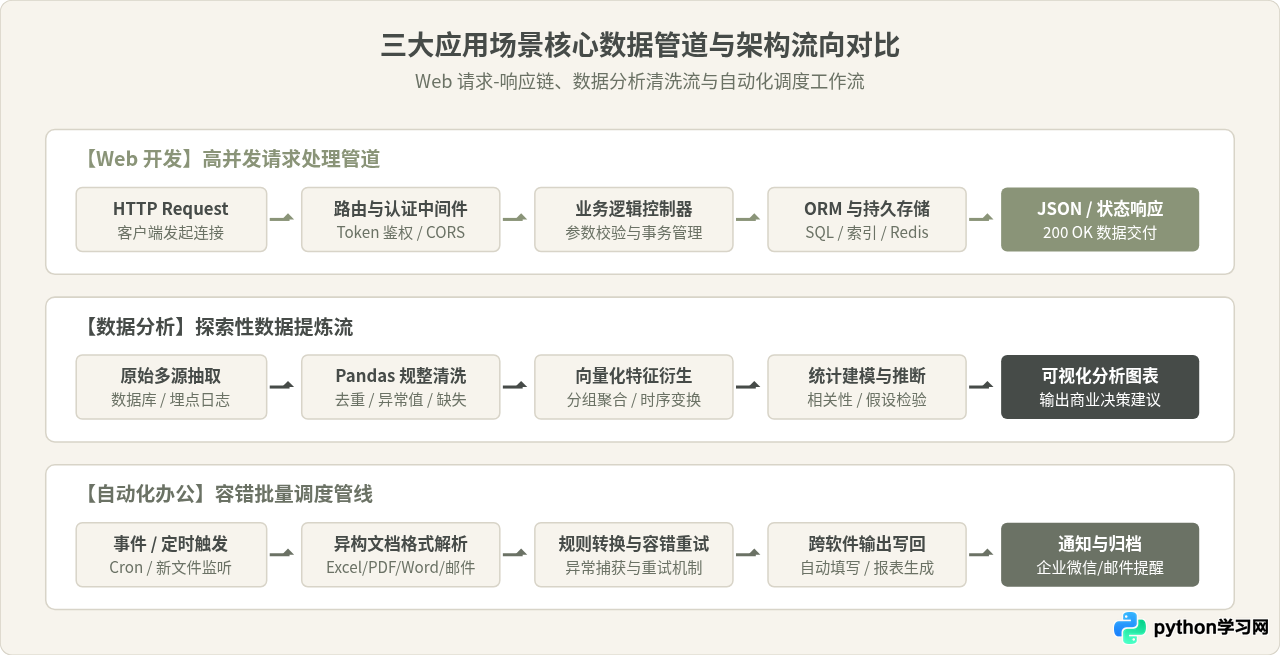
理解不同方向的本质差异,最直观的方法是观察它们日常处理任务时的数据流向。下面的架构图展示了请求流、数据处理流与自动化任务管道在运行机制上的不同。
五、常见认知误区与辨析
误区辨析一:“学自动化办公太低端,直接学 Web 或数据分析才算真正学编程”
这种说法看似合理,是因为自动化办公的代码量通常较小,脚本大多只有几十行到上百行。但它的不合理之处在于忽略了学习反馈周期对初学者的决定性影响。自动化办公能在几天内直接为你节省数小时的手工时间,提供即时正反馈;而且,处理真实办公脏数据的经历,是掌握数据清洗与异常处理最直接的跳板。
误区辨析二:“做数据分析就是学机器学习和深度学习算法调包”
在实际企业中,只有不到 15% 的岗位专注于核心算法模型训练。绝大多数数据分析师的核心日常,是理解复杂的业务指标(如 GMV 口径、漏斗流失率)、用 Pandas 进行脏数据清洗与多表对齐,以及撰写有洞察力的分析报告。如果在尚未熟练掌握数据重塑与 SQL 时就盲目深究神经网络,往往会导致理论与落地严重脱节。
误区辨析三:“Python Web 性能不如 Java 和 Go,所以没必要学”
在极限并发压测下,静态编译型语言确实具备更高的 CPU 密集型吞吐能力。但在现实世界的绝大多数互联网产品与初创项目中,瓶颈几乎全部在数据库 I/O 和外部网络延迟上,而非语言本身的运行速度。借助现代 FastAPI + AsyncIO,Python 的 I/O 吞吐足以支撑绝大多数业务需求,其开发速度与灵活度依然具有巨大优势。
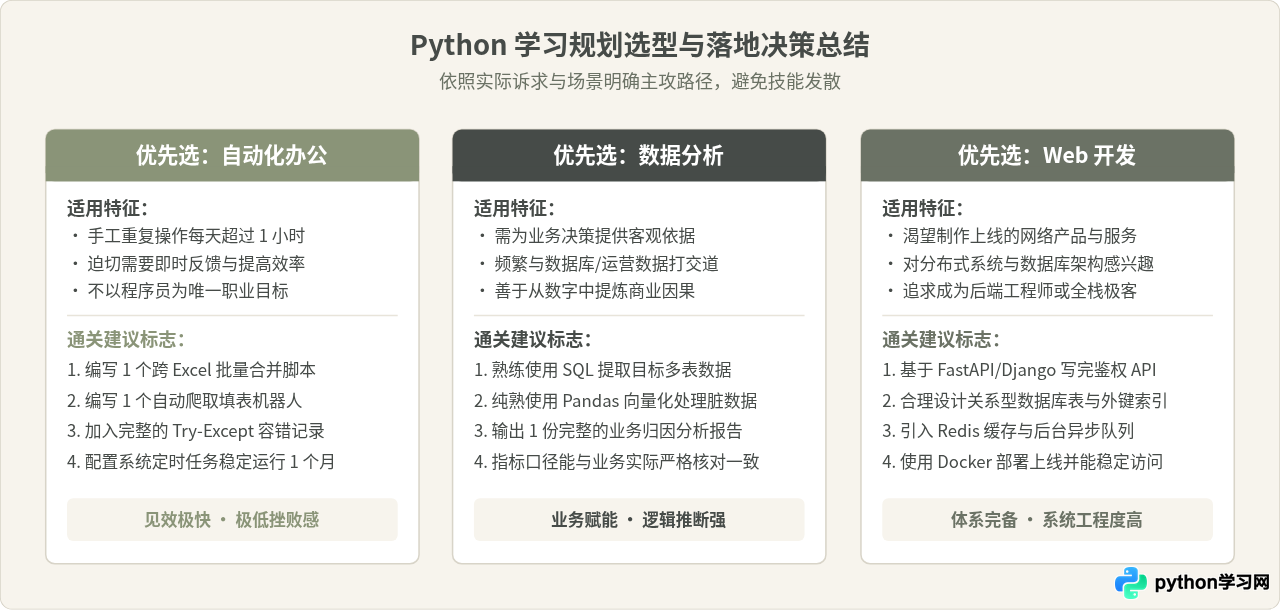
六、选型指南与学习决策矩阵
为了帮助你明确当下的主攻方向,下表从投入产出比、知识门槛与业务场景三个维度进行了系统收敛:
| 评估维度 | Web 开发 | 数据分析 | 自动化办公 |
|---|---|---|---|
| 典型适配人群 | 希望从事软件后端研发、独立开发者、SaaS 产品构建者 | 运营分析师、市场研究员、金融分析师、科研人员 | 行政财务、电商运营、日常有大量报表与重复流程的职场人 |
| 见效周期 | 3 ~ 6 个月(需补齐网络、数据库及前端通信基础) | 1 ~ 2 个月(需理解指标定义与统计学图表) | 1 ~ 2 周(写出一个脚本即可立即自动化一项工作) |
| 前置数学要求 | 极低(重在逻辑关系与离散系统设计) | 中等(需掌握初等统计学、概率论、矩阵维度) | 无特殊要求(只需要理解办公业务规则) |
| 核心配套知识 | Linux 基础、Docker、PostgreSQL、HTTP 协议 | SQL 查询、业务指标体系、数据可视化设计 | 正则表达式、文件系统路径操作、Office 文档对象 |
| 最容易踩的坑 | 沉迷框架语法,忽视了数据库事务与安全注入防范 | 直接上机器学习模型,却无法解释简单业务指标异动 | 脚本只在理想数据下运行,遇到空行或脏格式直接崩溃 |
七、常见学习疑惑解答(FAQ)
Pandas 的核心定位是“二维表格与矩阵计算”,它将 Excel 视作纯粹的行与列数据,在读取或写回时会丢失原始文件中的单元格颜色、边框、合并单元格以及图表排版。如果你的任务是生成给领导看的高保真格式化报表,或需要修改现有模板中特定位置的单元格,openpyxl 能够精确控制每个单元格的样式与格式,这是纯数据处理库无法替代的。
不需要。在现代前后端分离的开发体系中,Python 后端主要负责业务逻辑、API 输出与数据库交互。初学者只需了解基础的 HTML 结构和 HTTP 请求方式(GET/POST/PUT/DELETE),重点掌握 JSON 格式的数据传输与状态码规范即可。如果后续有全栈需求,可以配合现代组件库(如 Vue 或 React)进行渐进式学习。
完全不会。相反,这是非常推荐的平滑路径。通过自动化办公,你会建立起对“脏数据”、“文件编码问题”、“缺失字段”的直观敏锐度,同时掌握 Python 处理复杂业务规则的熟练度。当你对几万行 Excel 感到读写缓慢、想要更高效的分组分析时,无缝过渡到 Pandas 就会变得水到渠成。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















