


为什么Polars基于Arrow列式存储更快?
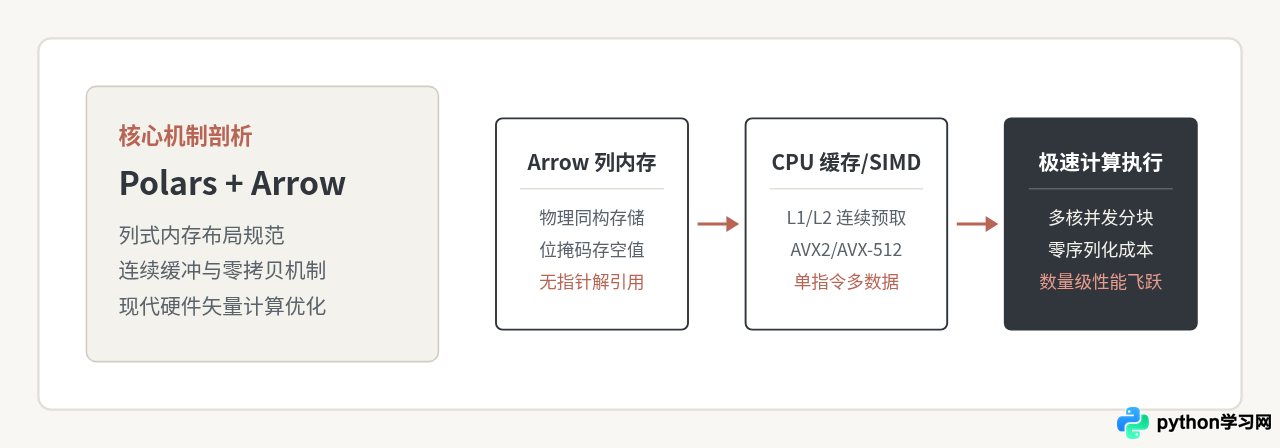
深入解析Polars基于Apache Arrow列式存储实现高性能计算的核心机理,剖析连续内存、缓存局部性、SIMD向量化加速与惰性推导优化的本质原理与实践边界。
一、从内存结构看本质:行式组织与Arrow列式布局的差异
在传统行式存储或基于通用对象引用的模型中,数据是以“一条记录”为单位存放在内存中的。每一行包含整条记录的所有属性字段,例如用户ID、姓名、年龄、消费金额等。当我们需要对某一列(如计算所有用户的“消费金额”均值)执行聚合计算时,CPU必须将包含该行所有无关字段的整块内存一并载入高速缓存。
更糟糕的是,如果底层使用了分散的对象指针(如Python原生列表或嵌套对象),每个元素在堆内存中的地址并不连续,CPU每次取值都会遭遇指针解引用,引发频繁的缓存缺失(Cache Miss)。
而Apache Arrow规范定义了一种标准化、跨语言的列式内存格式(Columnar Format)。在Arrow模型下,同一列的所有同类型数据都被紧密排列在一块连续的内存缓冲区(Buffer)中,不同列相互独立。这意味着在执行单列筛选或聚合时,内存读写效率获得了物理层面的提升。
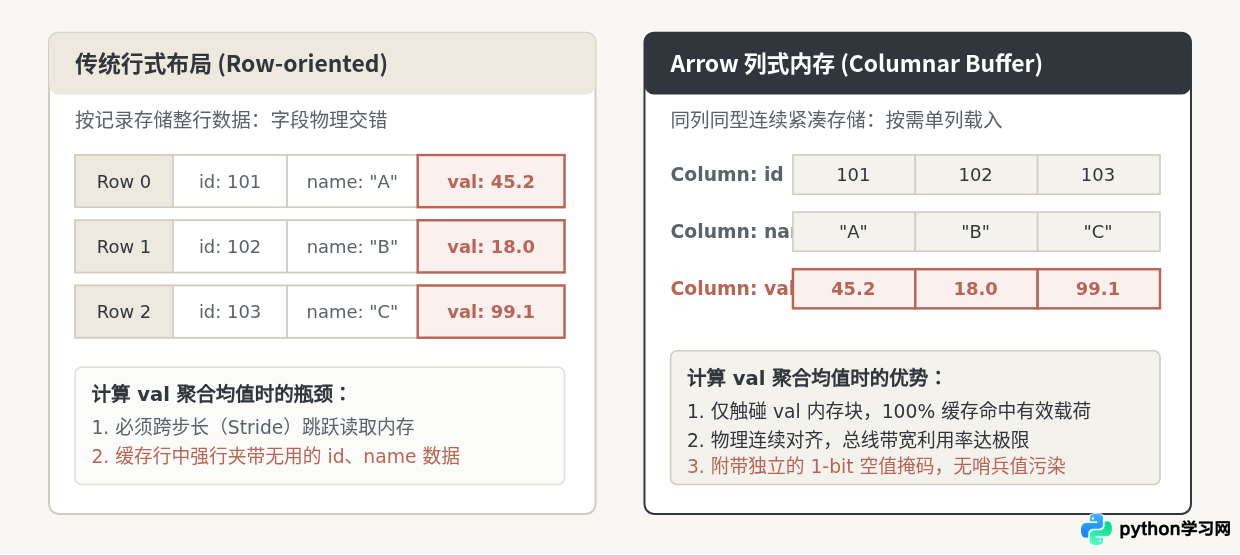
特别值得注意的是Arrow对缺失值(Null)的处理机制。在早期的Python数据分析库中,为了表示整数列中的缺失值,往往不得不将整列强制升级为浮点类型(用NaN充当哨兵值),或者引入包装对象,这不仅破坏了紧凑内存结构,还极大地增加了类型转换的开销。
Arrow则采用独立的有效性位掩码(Validity Bitmap):每一行是否为空仅用一个二进制位(bit)表示,8行数据仅需1字节。计算引擎在遍历数据时,可以通过位运算快速跳过Null,既不污染数据本身的连续物理存储,也不破坏原始数据类型。
二、硬件级加速:CPU缓存局部性与SIMD向量化
现代计算机处理器的计算速度远远高于从内存(DRAM)读取数据的速度,这一差异通常被称为“内存墙”。为了缓解这一矛盾,CPU配备了多级高速缓存(L1、L2、L3 Cache)。CPU与内存交换数据的最小基本单位是缓存行(Cache Line),在常见的x86和ARM架构上通常为64字节。
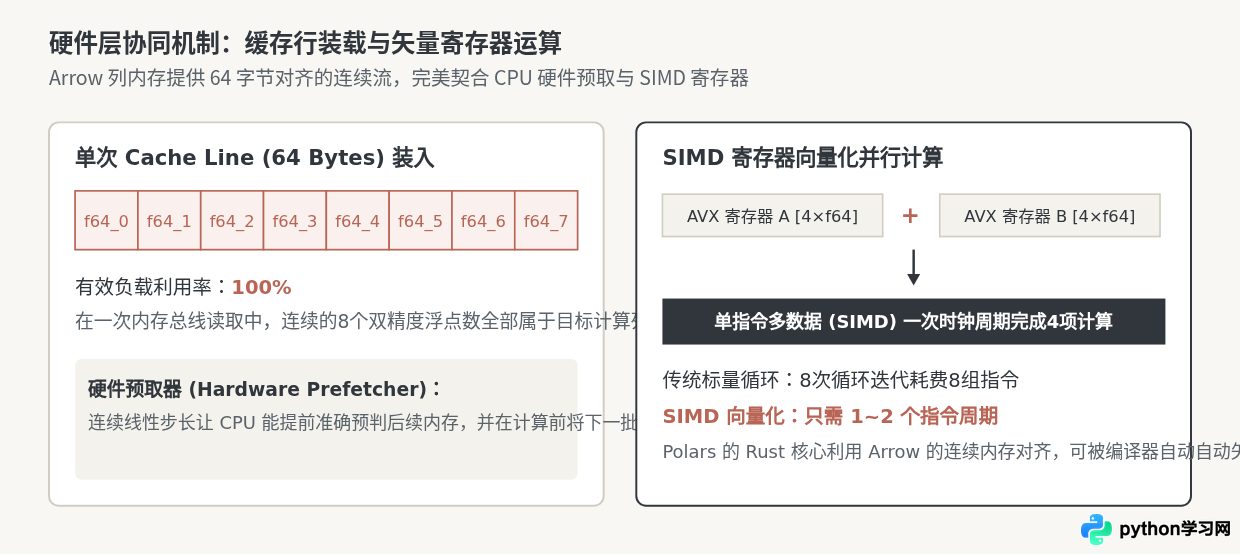
当数据以连续扁平的Arrow格式存放时,每次从内存读入一个64字节的缓存行,刚好包含8个连续的双精度浮点数(Float64)或16个32位整型(Int32)。CPU对该缓存行内的数据利用率达到了100%,不仅绝无冗余数据加载,而且硬件预取器(Hardware Prefetcher)能极具预见性地以恒定步长预加载后续数据,使等待内存的时间几乎降到零。
更为关键的是,这种平铺的同质数组格式直接为现代处理器的SIMD(Single Instruction, Multiple Data,单指令多数据)指令集铺平了道路。无论是在支持AVX2、AVX-512的x86芯片上,还是在搭载NEON指令集的ARM芯片上,Polars在Rust编译阶段即可将数学运算、比较过滤等操作直接编译为向量化汇编指令,一条CPU指令同时处理数个数值,性能相较逐个元素遍历获得数倍的直接提升。
三、Polars的执行引擎协同:多核并行与零拷贝切分
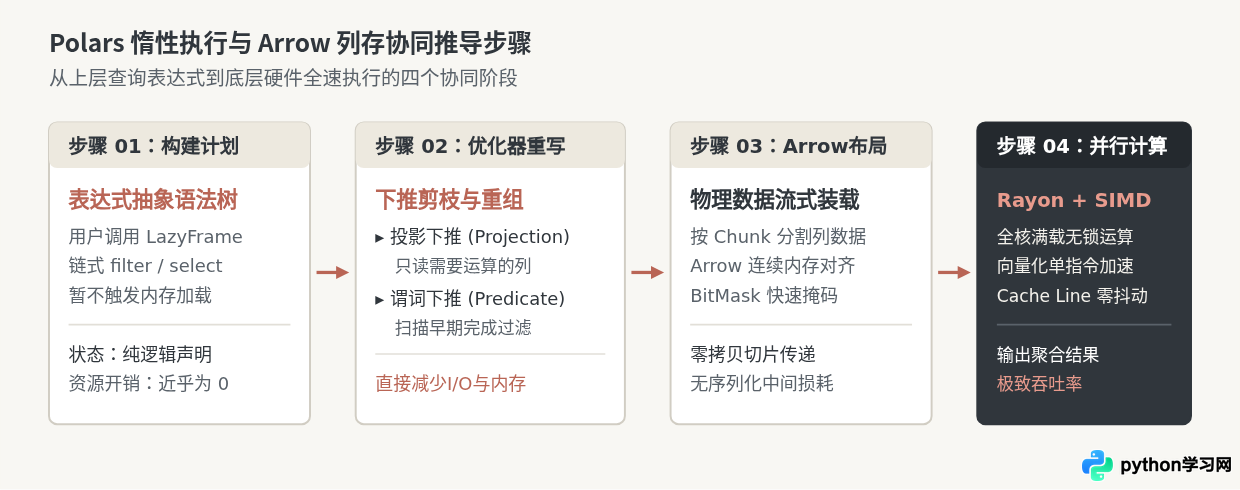
仅仅有优秀的列式内存结构并不足以产生极致的性能,还需要与之匹配的高性能计算引擎。Polars基于Rust语言编写,天然具备内存安全与细粒度并发控制能力。它与Arrow内存模型的结合在运行时展现出以下关键协作特性:
- 零拷贝(Zero-Copy)引用与切片:Arrow规范明确分离了内存数据缓冲区与元数据定义。在Polars中,对某一列执行切片(Slice)、重命名、类型视窗重构甚至跨进程传递时,仅仅需要生成一个新的包含偏移量(Offset)和长度(Length)的指针视图,不需要对原始数据进行任何内存拷贝或重新序列化。
- 基于Rayon的自动多核数据并行分块:由于Arrow列由连续的分块(Chunks)组成,Polars的内部调度器能够将一个庞大的列数组快速划分为多个不重叠的内存区间,无竞争地分派给不同的CPU核心并发执行。
- 惰性查询优化(Lazy API)的谓词与投影下推:结合列式存储特性,Polars在执行SQL或链式操作时首先构建逻辑计划,自动剔除后续计算不需要的列(投影下推),并将过滤条件尽可能推到最前端(谓词下推),从一开始就减少载入Arrow内存的数据规模。
四、具体代码操作:验证列式过滤与聚合流程
为了实际验证Polars基于Arrow的计算流程,我们可以通过一段完整的Python代码进行演示。这里展示如何创建一个包含缺失值与多列混合类型的DataFrame,并借助Lazy API观察列裁剪和向量化过滤的执行效果。
1. 环境准备与脚本编写
确保在Python环境中已安装Polars(若尚未安装,可执行 pip install polars)。以下代码在标准Python 3.8+环境中运行:
import polars as pl

# 1. 构造一个包含百万级记录的基础数据集
# 数据包含数值列、字符串列与可能存在的空值
df = pl.DataFrame({
    "user_id": range(1, 1_000_001),
    "category": ["Electronics", "Books", "Clothing", "Home", None] * 200_000,
    "amount": [99.5, 23.0, 150.0, 42.5, 300.0] * 200_000,
    "tax_rate": [0.08] * 1_000_000
})

# 2. 使用 LazyFrame 构建分析流水线
# 目标:仅对特定品类计算含税总金额的统计值
lazy_query = (
    df.lazy()
    .filter(pl.col("category") == "Electronics")
    .select([
        pl.col("user_id"),
        (pl.col("amount") * (1 + pl.col("tax_rate"))).alias("total_spent")
    ])
    .filter(pl.col("total_spent") > 100.0)
)

# 3. 打印逻辑计划(检查优化器是否成功执行下推)
print("=== 优化后的执行计划 ===")
print(lazy_query.explain())

# 4. 触发实际执行
result = lazy_query.collect()
print("=== 执行结果示例(前5行) ===")
print(result.head(5))
2. 运行结果示例与分析
FAST_PROJECT: [user_id, total_spent]
FILTER [(col("total_spent")) > (100.0)] FROM
SELECT [col("user_id"), ((col("amount")) * (1.08)).alias("total_spent")] FROM
FILTER [(col("category")) == (String(Electronics))] FROM
DF ["user_id", "category", "amount", "tax_rate"]
=== 执行结果示例(前5行) ===
shape: (5, 2)
┌─────────┬─────────────┐
│ user_id ┆ total_spent │
│ --- ┆ --- │
│ i64 ┆ f64 │
╞═════════╪═════════════╡
│ 1 ┆ 107.46 │
│ 6 ┆ 107.46 │
│ 11 ┆ 107.46 │
│ 16 ┆ 107.46 │
│ 21 ┆ 107.46 │
└─────────┴─────────────┘
从explain()生成的计划中可以清楚看到:虽然数据表中定义了4列,但由于最终仅需要user_id和计算结果,Polars的优化器仅扫描相关列的Arrow物理内存块。对category == "Electronics"的判断则是利用字符串偏移量(Offsets Buffer)与对应比特掩码在连续空间内一次性完成判定,随后的浮点数乘法计算则直接分派至SIMD寄存器,整个过程没有产生中间全量Python对象的封装。
for row in df.iter_rows(): 这样的逐行迭代操作。一旦使用逐行解包,Polars将不得不把连续存储的Arrow内存打散重组成单个Python元组,导致CPU缓存局部性与向量化优势全部丧失,执行速度往往会发生百倍级别的急剧下降。
五、适用边界与权衡:列式存储并不总是全能的
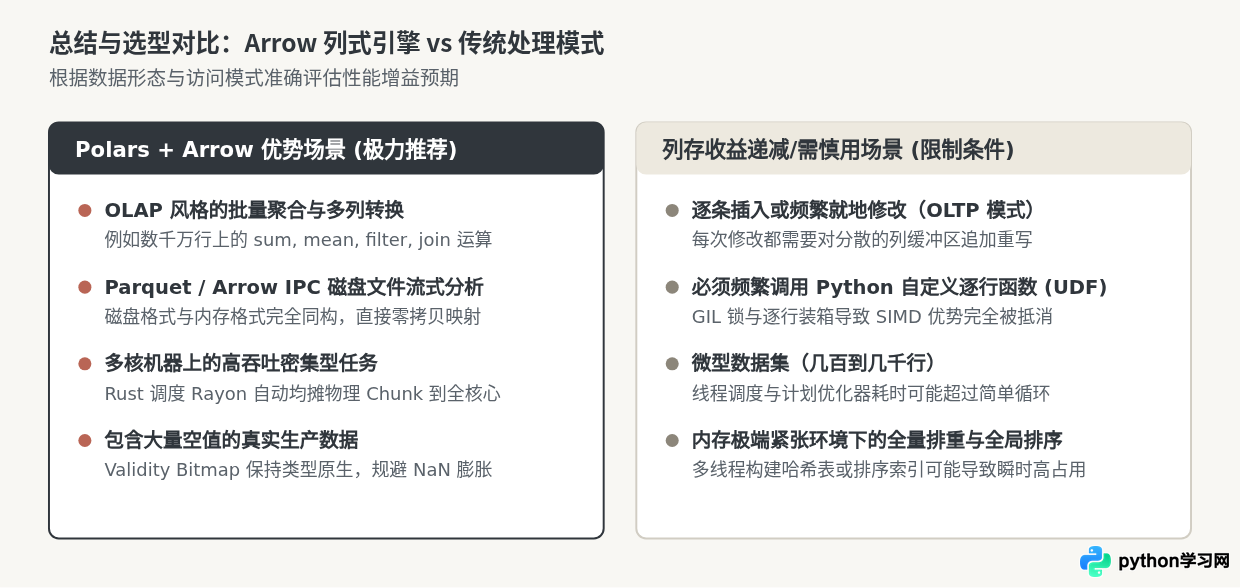
深入理解技术的优势,必须同时看清其适用前提与限制条件。Polars基于Arrow列存的加速机制,主要建立在“批量数据分析(OLAP)”和“整列扫描聚合”这一典型计算模式上。在某些特定场景下,列式结构反而会带来额外的开销:
- 频繁的单行增删改查(Point Lookup / Append):如果业务场景是类似于事务型数据库(OLTP)那样不断单条插入记录,或者根据主键高频更新某单行的某个字段,列式存储必须在所有不同列的缓冲区末尾分别开辟空间写入,其效率反而远低于一次性写入整行的行式结构。
- 超宽表且每次只读取完整单行:如果一张表拥有数千个字段,而下游业务总是需要打印“整条记录”的所有信息,此时在内存中拼凑完整行会涉及大量的跨列指针重组。
- 内存放大的临时中间态:虽然Arrow提供了零拷贝切片,但在进行大规模全局排序(Global Sort)或超大基数的重分组(Heavy GroupBy Rehash)时,为了维护连续性或重新排列表索引,仍可能瞬时占用数倍于原始数据大小的工作内存。
六、总结
回到文章最初的核心问题:“为什么Polars基于Arrow列式存储更快?”其本质答案并非单一魔法,而是数据结构与底层硬件体系结构的严丝合缝:
- 物理内存连续紧凑:Arrow规约消除了指针寻址与行间空隙,保证了内存读取的高有效负载。
- 充分释放现代CPU性能:64字节缓存行装入零浪费,硬件预取精准无阻,SIMD单指令实现多路并发计算。
- 独立的BitMask空值表示:保证了列数据的强类型纯粹度,彻底杜绝类型退化与装箱开销。
- Rust引擎与执行图协同:将下推优化、零拷贝切片与多核线程池与Arrow连续块深度绑定,消除层间传递的任何冗余开销。
理解这套协同原理,不仅有助于我们在面对大数据量分析时做出更理性的框架选型,更能促使我们在编写数据处理流水线时,自觉契合列式向量化设计范式,写出真正高吞吐、高效率的代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















