


Python数据分析常用库有哪些:Pandas、NumPy与Scikit-learn核心功能盘点
全面盘点Python数据分析领域三大核心基石库Pandas、NumPy与Scikit-learn的核心功能、架构定位、代码示例与端到端协作流程。
一、三大基石库的定位与协作架构
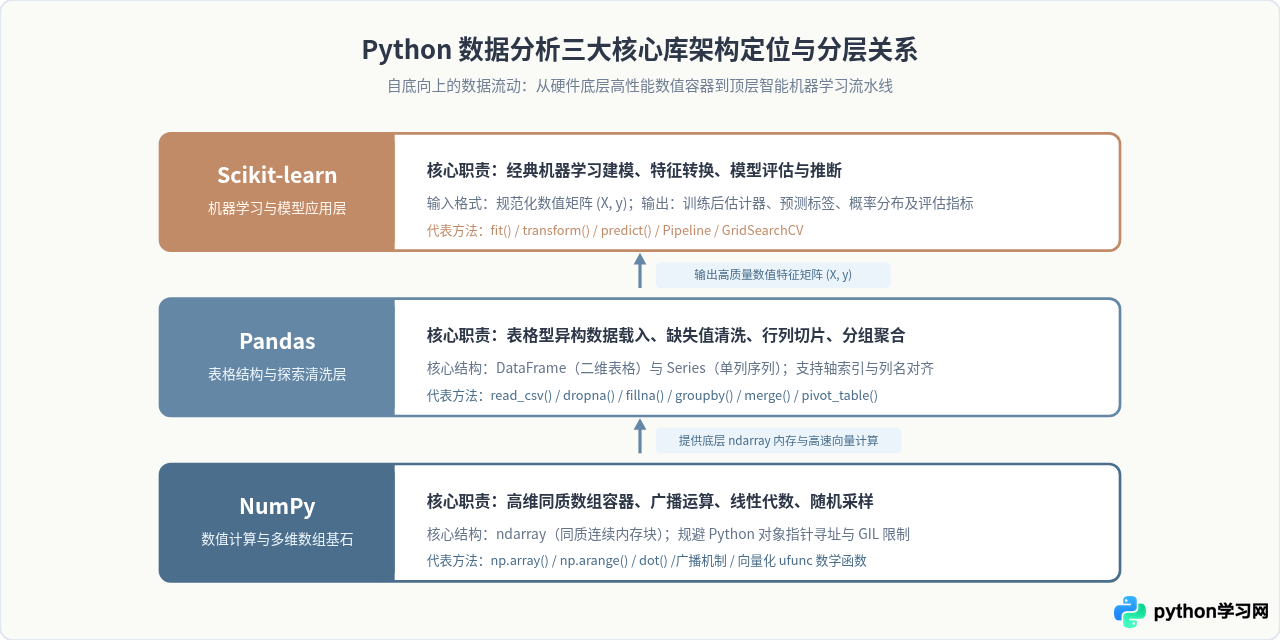
许多初学者在进入 Python 数据分析领域时,容易将这三个库混为一谈,或者不清楚何时该调用哪一个。其实它们在技术生态中处于不同的抽象层次:
- 底层计算层(NumPy):负责高性能的数学计算。它用 C 语言底层实现了连续内存存储的
ndarray结构,绕过 Python 原生列表低效的指针寻址与全局解释器锁(GIL)瓶颈,使高维矩阵运算达到近乎原生的 C 语言性能。 - 数据操作层(Pandas):负责结构化表格的探索与清洗。它以 NumPy 数组为底层容器,引入了行索引(Index)与列名(Columns),支持异构数据类型(数值、字符串、日期混存),提供类似于 SQL 和 Excel 的便捷切片与聚合接口。
- 算法与建模层(Scikit-learn):负责统计建模与机器学习。它以 NumPy 数组或 Pandas 数据帧作为标准输入输出,通过统一规范的接口模式,提供分类、回归、聚类、降维等算法,以及网格搜索和交叉验证评估工具。
二、NumPy:高性能数值计算与多维数组基石
NumPy(Numerical Python)是整个 Python 科学计算生态的核心支柱。在没有 NumPy 之前,Python 的原生列表(list)是一种存储对象引用的动态容器,列表中的每一个元素实际上是一个完整的 Python 对象(包含类型指针、引用计数等元信息),在内存中呈现离散分布。这种机制在处理百万级以上的大规模矩阵乘法或逐项运算时,内存占用极大且缓存命中率极低。
1. 核心对象:ndarray 与同质内存布局
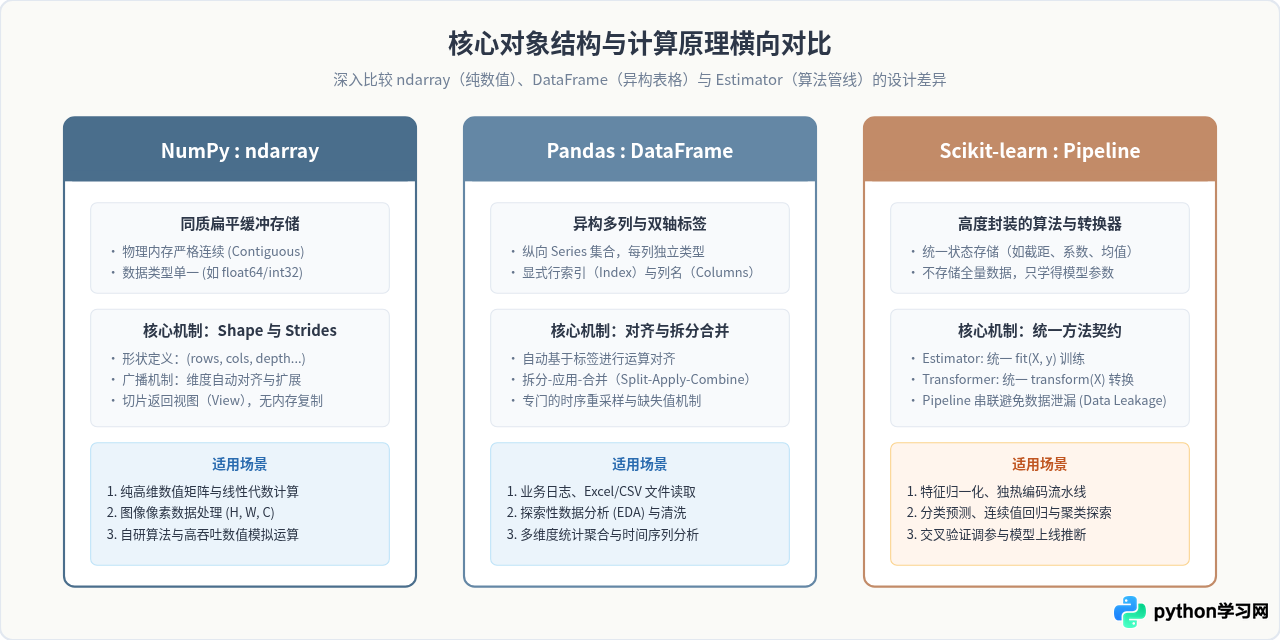
NumPy 引入了 ndarray(N-dimensional Array)对象。它具有两个关键特征:
- 同质性(Homogeneous):数组内所有元素必须具有相同的物理数据类型(如
float64、int32等),这省去了存储动态类型标签的开销。 - 内存连续性(Contiguous Memory):数组元素在物理内存中紧密连续排列,使得 CPU 能够充分利用 L1/L2 高速缓存,并允许底层 C/Fortran 编译代码直接按步长(strides)定位地址。
2. 核心特性:广播机制(Broadcasting)与向量化(Vectorization)
向量化允许开发者使用一行简单的数学表达式代替显式的 for 循环,底层自动调用预编译的 C 循环执行;而广播机制则定义了不同形状(shape)的数组如何在算术运算中自动扩展匹配。只要两个数组在每个维度上的长度相等,或者其中一个维度的长度为 1,广播即可自动发生。
import numpy as np

# 1. 创建同质二维数组 (3行, 4列)
matrix = np.array([[1.0, 2.0, 3.0, 4.0],
                   [5.0, 6.0, 7.0, 8.0],
                   [9.0, 10.0, 11.0, 12.0]], dtype=np.float64)

# 2. 向量化运算:全矩阵按标量放大并执行数学变换(无需写 for 循环)
scaled_matrix = np.log(matrix * 2.0 + 1.0)

# 3. 广播机制:形状为 (3, 4) 的矩阵与形状为 (4,) 的一维偏置向量相加
bias = np.array([0.1, 0.2, 0.3, 0.4])
result = matrix + bias  # bias 在第0轴自动复制扩展为 (3, 4)

print("原始形状:", matrix.shape)
print("计算结果示例:\n", result)
三、Pandas:表格数据清洗与探索性分析利器
尽管 NumPy 在矩阵数值运算方面性能极高,但现实世界中的业务数据往往是结构复杂的表格:包含列名称、行日期标签,同时存在字符串(如用户姓名)、布尔值、浮点数以及大量缺失值(NaN)。NumPy 要求数据完全同质,强行放入同一数组会导致所有字段被降级转换为字符串或 Object 类型,丧失数值计算优势。Pandas 正是为解决这一痛点而诞生。
1. 核心对象:Series 与 DataFrame
- Series(单列序列):带有显式索引的一维带标签数组。既具备类似字典的键值映射特性,又具备 NumPy 数组的连续运算能力。
- DataFrame(二维表格):由多个共用同一行索引的 Series 组成的矩形表格,每列可拥有完全不同的数据类型。它是商业数据分析和报表处理最常用的核心载体。
2. 数据清洗与分组聚合(Group By)
在真实业务场景中,数据清洗往往占据分析工作的 70% 以上时间。Pandas 提供了成熟的缺失值检测(isna()、fillna())、条件过滤、多表拼接(merge()、concat())以及 SQL 级别的分组聚合(groupby())功能。
下面展示一段典型的 Pandas 数据清洗与聚合统计代码:
import pandas as pd
import numpy as np

# 1. 模拟生成带有缺失值与异构类型的销售订单数据
raw_data = {
    'OrderID': [1001, 1002, 1003, 1004, 1005, 1006],
    'Category': ['Electronics', 'Clothing', 'Electronics', 'Home', 'Clothing', 'Home'],
    'Sales': [299.9, np.nan, 899.0, 45.5, 120.0, np.nan],
    'Quantity': [2, 1, 3, 4, 2, 1]
}
df = pd.DataFrame(raw_data)

# 2. 缺失值填补:按品类中位数填补缺失的 Sales 列
df['Sales'] = df.groupby('Category')['Sales'].transform(lambda x: x.fillna(x.median()))

# 3. 派生新指标:计算单笔订单总金额
df['TotalAmount'] = df['Sales'] * df['Quantity']

# 4. 分组聚合统计:按品类统计订单数、平均单价和总销售额
summary = df.groupby('Category').agg(
    OrderCount=('OrderID', 'count'),
    AvgSales=('Sales', 'mean'),
    TotalRevenue=('TotalAmount', 'sum')
).reset_index()

print("清洗与分组聚合结果:\n", summary)
四、Scikit-learn:规范化的经典机器学习工作流
在数据经过 Pandas 清洗完毕、得到规整的数值特征矩阵后,下一步通常是建立预测模型或探索模式规律。Scikit-learn(简称 sklearn)是 Python 生态中最流行、设计最优雅的经典机器学习库。它的成功很大程度上归功于其高度一致的 API 契约设计。
1. 统一的 API 哲学:Estimator、Transformer 与 Predictor
Scikit-learn 不对每种算法设计不同的调用规范,而是将所有算法归纳为极少数标准接口:
- 估计器(Estimator):任何能从数据中估计参数的对象都是 Estimator。核心方法为
fit(X, y),用于依据训练集拟合模型参数。 - 转换器(Transformer):用于对数据进行变换的估计器(如数据标准化
StandardScaler、独热编码OneHotEncoder)。核心方法为transform(X)或合并调用的fit_transform(X)。 - 预测器(Predictor):用于根据输入样本做出推断的估计器(如随机森林、逻辑回归)。核心方法为
predict(X)和predict_proba(X)。
2. 避免数据泄漏的 Pipeline(流水线)
初学者容易犯的严重错误是在划分训练集/测试集之前就对全局数据进行归一化,导致测试集的信息“泄漏”到了模型训练过程中。Scikit-learn 提供了 Pipeline 机制,将特征预处理和最终分类器封装为一个单一对象,在交叉验证时自动隔离训练折与验证折。
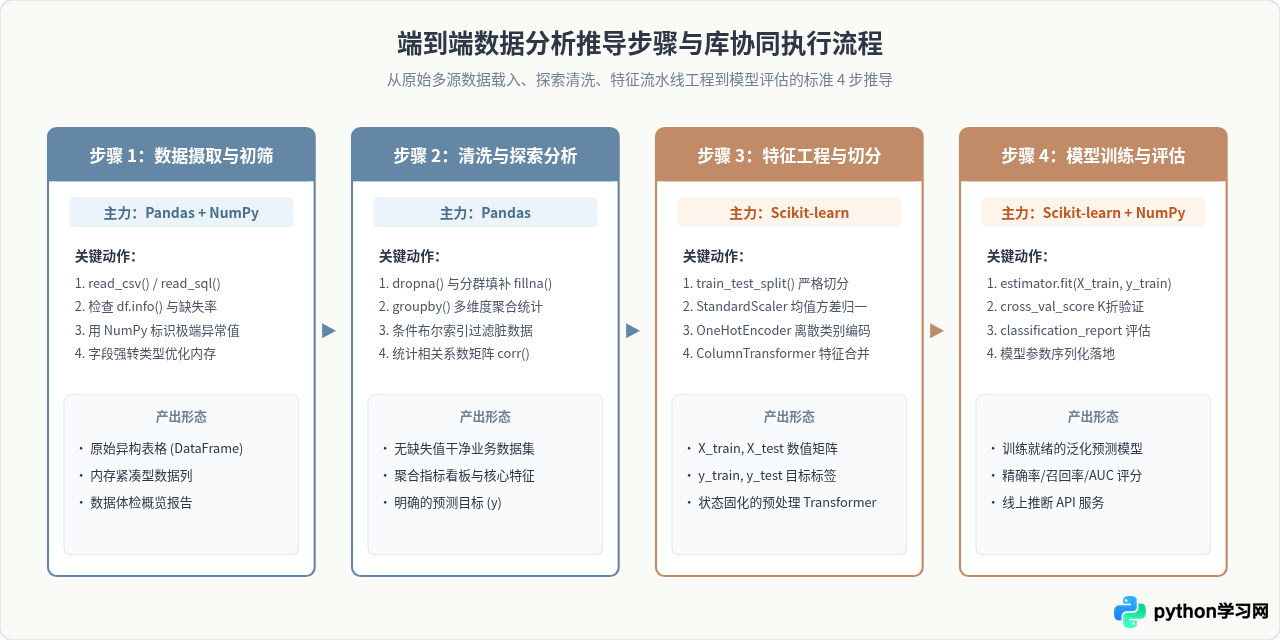
下面展示一段完整的 Scikit-learn 机器学习建模代码,使用统一的 API 构建特征预处理与随机森林分类器:
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.pipeline import Pipeline
from sklearn.metrics import classification_report

# 1. 生成模拟的分类数据集 (1000条样本,10个特征)
X, y = make_classification(n_samples=1000, n_features=10, random_state=42)

# 2. 划分训练集与测试集 (7:3 比例,固定随机种子保证可复现)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42, stratify=y
)

# 3. 构建规范化的模型流水线:标准化预处理 + 随机森林分类器
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('classifier', RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42))
])

# 4. 一键拟合:fit 阶段在训练集上学习均值方差,并训练树模型
pipeline.fit(X_train, y_train)

# 5. 测试集预测与指标评估
y_pred = pipeline.predict(X_test)
print("模型测试集分类评估报告:\n")
print(classification_report(y_test, y_pred, digits=4))
五、三大库的核心能力选型与使用场景总结
在实际项目落地时,开发者需要根据当前面临的具体问题选择最合适的工具,避免“拿着锤子找钉子”:
| 对比维度 | NumPy | Pandas | Scikit-learn |
|---|---|---|---|
| 核心数据容器 | ndarray(同质多维数组) |
Series(单列)、DataFrame(二维表格) |
基于 NumPy 数组 / SciPy 稀疏矩阵 |
| 支持数据类型 | 单一数值类型(int, float, complex 等) | 混合异构(数字、文本、日期、类别对象) | 纯数值化矩阵(非数值需先转化为数字) |
| 数据索引方式 | 整数下标(0, 1, 2...)与布尔掩码切片 | 双轴显式标签(行标签 Index、列名 Column) | 按样本行与特征列统一位置输入 |
| 主要操作任务 | 线性代数、傅里叶变换、底层科学计算、广播运算 | 数据合并、缺失值填补、SQL式聚合、数据过滤清洗 | 特征工程、降维、聚类、分类预测、网格调参 |
| 不擅长的领域 | 带标签的业务表格、复杂字符串与日期解析 | 高阶三维以上张量运算、高度密集的底层算法运算 | 原始未清洗脏数据的读取与自由数据探索 |
- 不要用
for循环遍历 Pandas 的行:使用df.iterrows()会将每一行打包为 Series,性能极其低下。应当优先使用向量化表达式或df['col'].apply()。 - 送入 Scikit-learn 前务必数值化:Scikit-learn 绝大部分算法无法直接处理字符串或文本标签,必须先用
OneHotEncoder或OrdinalEncoder转换为数值。 - 切片拷贝问题:在 Pandas 中对切片赋值时如果遇到
SettingWithCopyWarning,说明正在对视图修改,建议显式加上.copy()以规避潜在隐患。
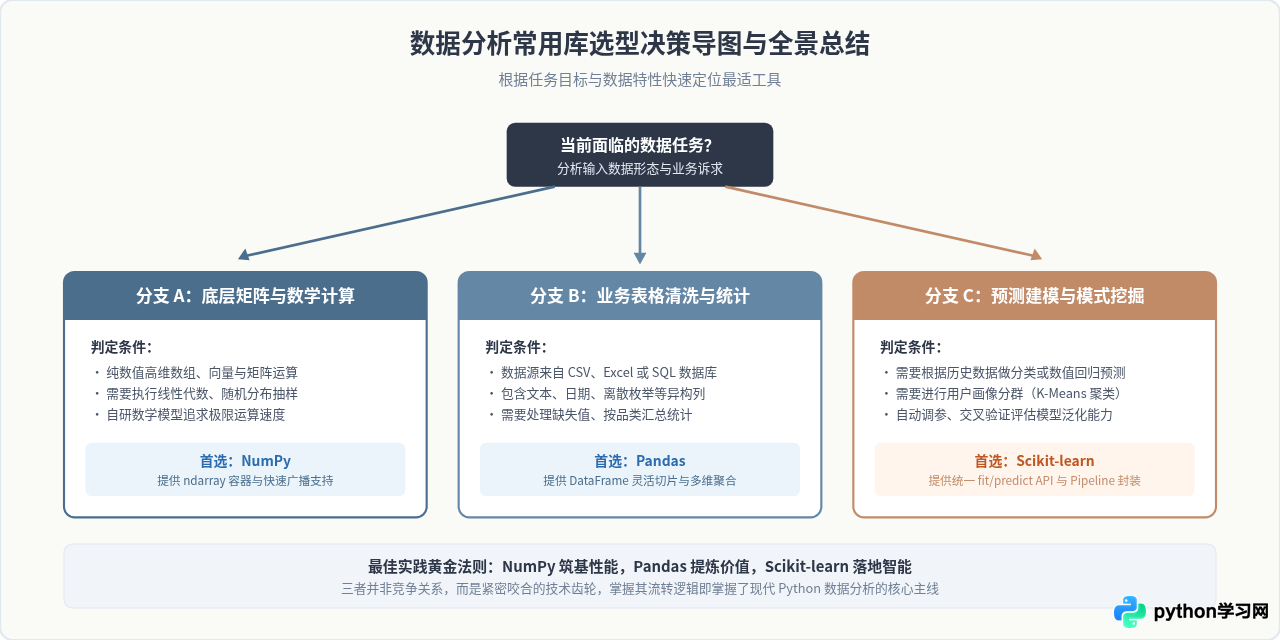
综上所述,Python 数据分析的强大之处正是在于这一高度模块化且无缝协作的生态:NumPy 解决了底层算力与高维内存抽象问题,Pandas 让现实中混乱多变的业务表格得以轻松驯服,而 Scikit-learn 则将复杂的数学建模降维为清晰规范的工程流水线。掌握这三大库的核心原理与边界协作,是每一位数据从业者从入门迈向熟练的必由之路。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















