


Python AI新手常犯的五个错误:从环境配置到模型评估的深度解析
深度解析Python AI开发初学者最常踩的五个核心陷阱,涵盖环境配置、数据预处理数据穿越、模型基准选择、评估指标偏差及验证集泄漏,提供规范代码与防御指南。
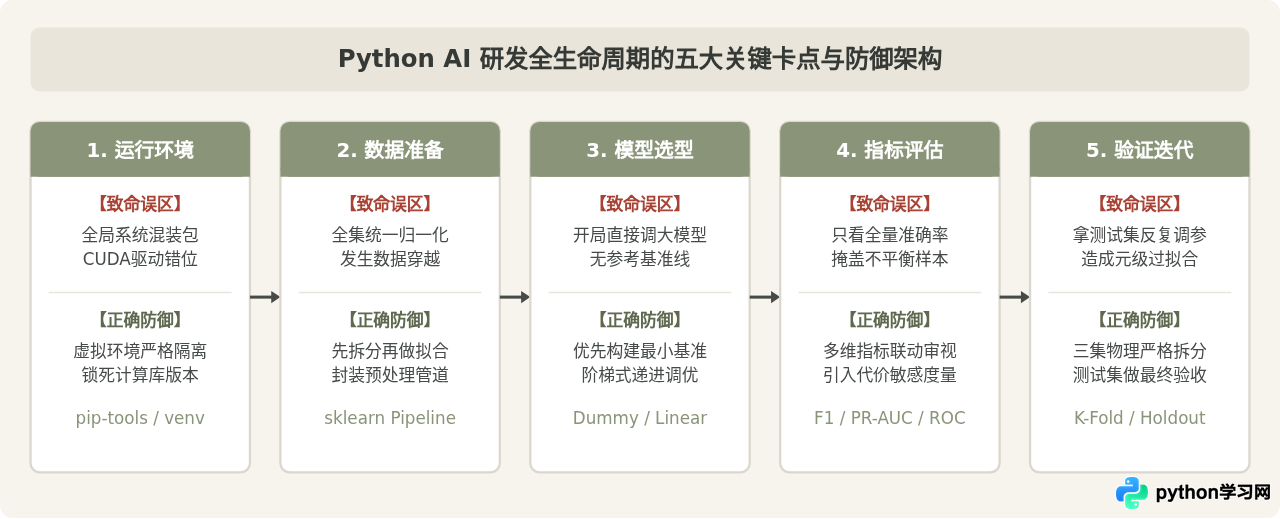
在 Python 人工智能与机器学习开发中,算法模型往往只占整个工程链路的一小部分。许多初学者常常在未建立稳定技术基石的情况下,直接调取复杂的深度学习模型,结果陷入训练速度缓慢、无法复现、线上崩溃或指标虚高的窘境。本文将沿着实际 AI 项目推进的自然顺序,深入剖析贯穿环境配置、数据预处理、基线构建、模型评估和验证划分的五个最典型错误,提供规范的工程防御策略与完整代码示例,帮助读者构建鲁棒、可复现的 AI 研发工作流。
错误一:混杂全局环境与计算框架硬件对齐失效
在所有初学者遇到的问题中,环境崩溃通常是最早出现的阻碍。新手往往习惯于在操作系统默认的 Python 环境中直接运行 pip install torch torchvision 或 pip install tensorflow。当后续因项目需要安装特定版本的库(例如从 NumPy 1.x 升级到 NumPy 2.x,或者安装旧版 Transformers)时,全局依赖冲突就会爆发,导致看似完全无关的其他脚本突然抛出动态链接库(DLL)加载失败或 C-API 二进制不兼容异常。
更为隐蔽的问题是深度学习计算框架与 GPU 硬件加速的错位。很多初学者误以为 pip install torch 就能自动调用本机的 NVIDIA 显卡。如果安装时未明确指定对应本系统 CUDA 驱动版本的安装源,pip 默认拉取的往往是纯 CPU 版本或驱动版本要求过高的编译包。代码虽然能够运行,却默默退化为 CPU 计算,单轮训练耗时从几十秒飙升到几小时,甚至抛出 CUDA driver version is insufficient for CUDA runtime version 的系统错误。
这种观点之所以看似合理,是因为当开发者只维护一个几百行代码的小脚本时,全局环境确实能给出即时反馈。然而在 AI 开发中,现代模型库高度依赖底层的 C++/CUDA 扩展与特定的编译器版本。一旦缺少沙箱隔离和依赖锁定清单,一旦换一台机器部署,或者两个月后更新了某个底层库,代码几乎必定无法复现。更严重的是,未锁定的无意识退化(如无报错却退化到 CPU 单线程模式)会直接误导算法效率评估。
规范的虚拟环境隔离与硬件对齐步骤
规范的工程实践应当包含三个核心环节:首先,针对每一个 AI 实验创建独立的虚拟环境;其次,查明本机的硬件驱动版本(Driver Version / CUDA Version),并从框架官方源安装精确匹配的二进制包;最后,编写轻量检查代码验证 GPU 是否成功挂载。
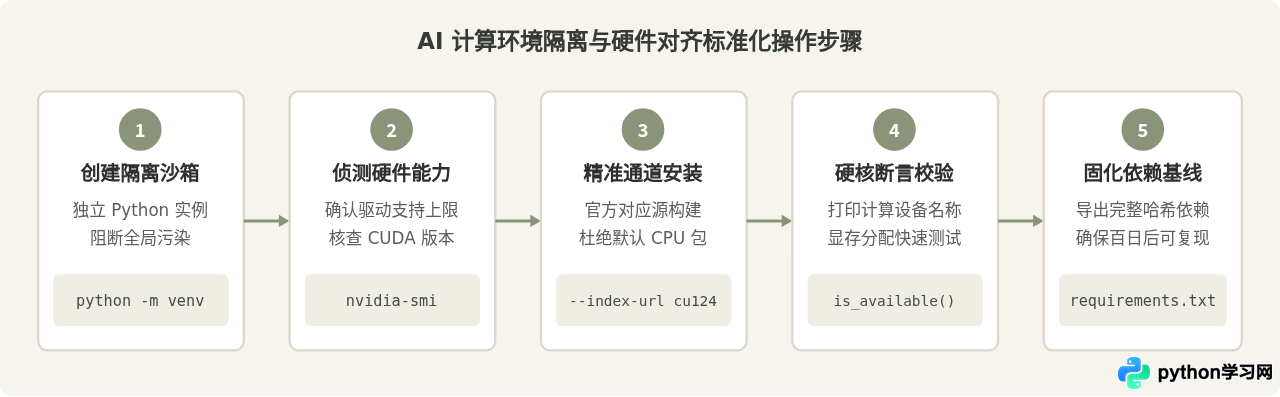
在终端中执行以下规范命令,建立独立的虚拟环境并验证 PyTorch 硬件加速支持:
# 1. 创建干净的独立虚拟环境(推荐在项目根目录下执行)
python3 -m venv .venv
source .venv/bin/activate  # Windows 用户使用: .venv\Scripts\activate

# 2. 升级基础打包工具
pip install --upgrade pip setuptools wheel

# 3. 安装与本机 CUDA 运行时精确匹配的 PyTorch(以 CUDA 12.4 为例)
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu124
环境安装完成后,切勿直接开始加载海量数据,务必先用以下独立自检脚本进行硬件诊断:
import sys
import torch

print(f"Python 解释器版本: {sys.version.split()[0]}")
print(f"PyTorch 核心库版本: {torch.__version__}")

is_cuda = torch.cuda.is_available()
print(f"CUDA 硬件加速可用: {is_cuda}")

if is_cuda:
    device_id = torch.cuda.current_device()
    gpu_name = torch.cuda.get_device_name(device_id)
    cuda_capability = torch.cuda.get_device_capability(device_id)
    print(f"默认计算设备: GPU [{device_id}] - {gpu_name}")
    print(f"硬件计算能力等级: {cuda_capability}")
    # 试分配极小张量到显存验证链路畅通
    x = torch.ones((2, 2), device="cuda")
    print(f"显存通信验证通过: 成功在 {x.device} 上分配张量")
else:
    print("【警告】未检测到有效 GPU 驱动或运行于 CPU 模拟模式,请核对驱动版本!")
错误二:预处理阶段的“数据穿越”(Data Leakage)
在机器学习项目中,最致命且隐蔽的错误莫过于数据穿越(也称数据泄漏)。它的典型表现是:在将整体数据集切分为训练集和测试集之前,直接对全量数据调用 fit_transform() 进行标准化(StandardScaler)、缺失值均值填充(SimpleImputer)或类别编码(TargetEncoder)。
数学层面上,标准化的核心计算公式为 \(z = (x - \mu) / \sigma\)。如果开发者在全量数据上计算均值 \(\mu\) 与标准差 \(\sigma\),那么测试集的分布特征、极值信息与离群点就被强行编码进了训练集的输入中。模型在训练阶段实际上“偷窥”到了测试集的数据边界。这会导致训练期和验证期损失极小,离线评测分数高达 98% 以上;一旦模型导出上线,面对真正从未出现过的生产环境样本,预测精度就会断崖式崩溃。
这个想法在统计学全样本推断中是有价值的,但在机器学习的预测任务中是根本性错误的。机器学习的核心目标不是描述手头已有的样本,而是评估模型面对未来未知分布时的泛化能力。现实世界中,模型进行线上推理时永远不可能提前拿到未来样本的平均值。任何引入全量统计的操作,都是用当前未来的信息去粉饰历史训练集,严重违背了因果独立性假定。
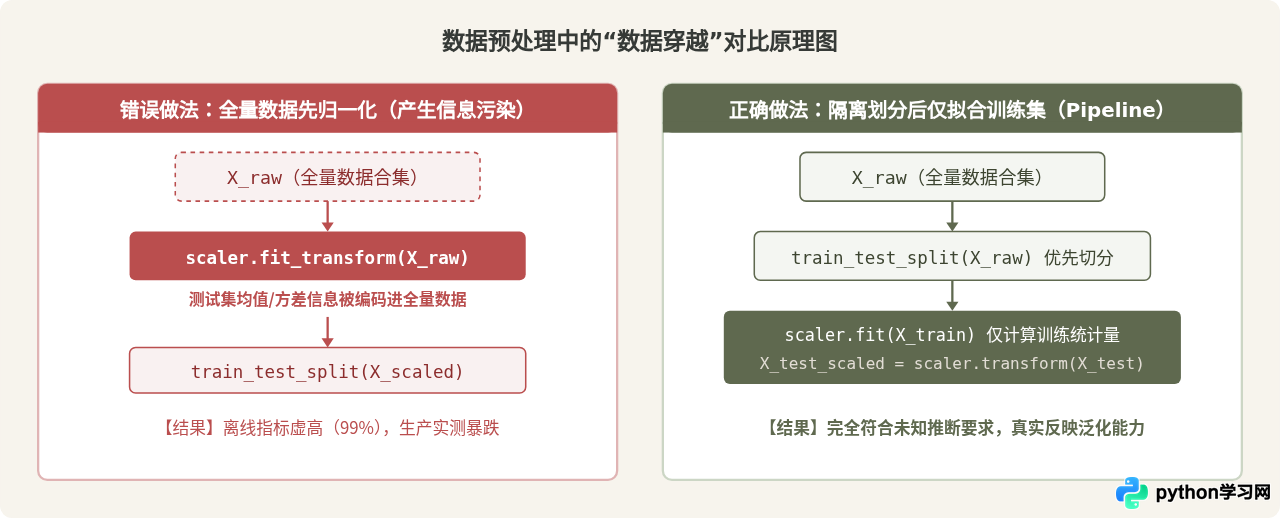
工程防御方案:使用 scikit-learn Pipeline 封装预处理
杜绝数据穿越最简洁、最稳健的方式是将预处理转换器与估算模型封装在 Pipeline 内部。在交叉验证或测试集评测中,Pipeline 会确保每一折(Fold)的统计参数仅在当折的训练集上通过 fit() 计算,而绝对不会触碰验证集:
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline
from sklearn.metrics import classification_report

# 1. 模拟生成带有缺失值与不同量纲的原始特征矩阵
np.random.seed(42)
X_raw = np.random.randn(500, 5) * [10.0, 1.0, 100.0, 0.5, 5.0]
# 注入部分缺失值
X_raw[np.random.rand(*X_raw.shape) < 0.05] = np.nan
y = (X_raw[:, 0] * 0.3 + X_raw[:, 2] * 0.02 > 0).astype(int)

# 2. 核心第一步:优先切分训练集与测试集,建立绝对物理防火墙
X_train, X_test, y_train, y_test = train_test_split(
    X_raw, y, test_size=0.25, random_state=42, stratify=y
)

# 3. 构造预处理与模型一体化 Pipeline
# 规则:Pipeline 外部只接受未经预处理的原始特征数据
ml_pipeline = Pipeline([
    ("imputer", SimpleImputer(strategy="median")),  # 缺失值填充
    ("scaler", StandardScaler()),                    # 标准化缩放
    ("classifier", LogisticRegression(random_state=42)) # 分类器
])

# 4. 在训练集上拟合:内部各阶段会依次执行 fit 与 transform
ml_pipeline.fit(X_train, y_train)

# 5. 在测试集上评估:仅应用已学习到的中位数与均值/方差做 transform
test_preds = ml_pipeline.predict(X_test)
print("Pipeline 严格隔离后的测试集分类表现:")
print(classification_report(y_test, test_preds, digits=4))
错误三:缺乏最简 Baseline,盲目追求复杂模型
很多 AI 初学者容易陷入一种“武器库崇拜”:拿到一个新业务分类任务或回归数据集,跳过所有基础分析,第一时间导入 10 层的深度全连接神经网络、复杂的 Transformer 架构或多模型 Stacking 集成。花费数天编写超参数调优脚本和分布式训练逻辑后,发现验证集准确率卡在 82% 无法继续提升。
此时开发者面临一个致命盲点:缺乏基准参照物(Baseline)。如果手头没有一个只需 5 秒即可训练完成的简单规则模型或简单逻辑回归(Logistic Regression / Ridge),开发者根本无法回答以下三个关键工程问题:
- 82% 的性能到底来自数据集本身不可分,还是来自深度模型的过拟合?
- 消耗了 100 倍计算资源与维护复杂度的复杂网络,相较于简单的线性模型究竟带来了多大实际净增益(0.5% 还是 15%)?
- 当前的特征工程是否真正有效?如果用全 0 预测器(DummyClassifier)都能获得 80% 的准确率,说明所谓的 82% 本质上毫无价值。
调用高级模型的确只需要几行代码,但定位问题、调试系统与上线维护却极其高昂。Baseline 的核心价值不是追求榜单高分,而是充当“系统的温度计与探针”。没有 Baseline,你就不知道数据中是否有标签泄漏(如果线性模型直接打到 99.9%,大概率是特征包含未来信息);没有 Baseline,你就无法做架构决策(是否值得为 0.3% 的提升承担 50 毫秒的线上推理延迟)。
规范的多级基线建立流程
在开展任何复杂的算法研发前,先花费 15 分钟建立一个由“规则基准 \(\rightarrow\) 线性基准 \(\rightarrow\) 简单树模型”构成的阶梯参照系。以下代码展示了如何快速构建参照阶梯:
from sklearn.datasets import make_classification
from sklearn.dummy import DummyClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score

# 构造模拟样本
X, y = make_classification(n_samples=2000, n_features=20, n_informative=10,
                           weights=[0.85, 0.15], random_state=42)

# 1. 第零级基线:常数预测器(输出出现频率最高的类别)
dummy_baseline = DummyClassifier(strategy="most_frequent")
dummy_score = cross_val_score(dummy_baseline, X, y, cv=5, scoring="balanced_accuracy").mean()

# 2. 第一级基线:简单线性模型(衡量特征的线性可分度与调试速度)
linear_baseline = LogisticRegression(max_iter=1000, random_state=42)
linear_score = cross_val_score(linear_baseline, X, y, cv=5, scoring="balanced_accuracy").mean()

# 3. 第二级基线:标准开箱即用树模型(捕获非线性交互与特征重要性)
rf_baseline = RandomForestClassifier(n_estimators=50, random_state=42)
rf_score = cross_val_score(rf_baseline, X, y, cv=5, scoring="balanced_accuracy").mean()

print(f"【第零基线】常数预测 Balanced Accuracy: {dummy_score:.4f}")
print(f"【第一基线】逻辑回归 Balanced Accuracy: {linear_score:.4f}")
print(f"【第二基线】随机森林 Balanced Accuracy: {rf_score:.4f}")
# 后续任何耗费大量算力研发的深度网络,都必须以 0.75+(树模型得分)为起跑门槛
错误四:单一准确率(Accuracy)引发的度量盲区
在分类场景中,最受新手青睐却最具欺骗性的指标就是整体准确率(Accuracy)。其定义为预测正确的样本数占全量样本数的百分比。在正负样本均衡(如 1:1)的任务中,准确率具备一定的参考价值;然而在现实的工业级 AI 场景中(如信用卡欺诈检测、设备故障预测、工业质检瑕疵、罕见疾病诊断),样本分布通常是严重倾斜的。
假设我们正在开发一个工业零件裂纹检测算法。在收集到的 10,000 个零件数据中,合格品为 9,900 个(99%),存在微小裂纹的次品仅有 100 个(1%)。如果一个初学者写出了一个“极其糟糕”的模型——该模型对任何输入都直接输出“合格”,这个模型在测试集上的准确率将高达 99.00%。单纯看报表,99% 的准确率极为惊艳,但它在生产线上的实际漏检率是 100%,不仅毫无实用价值,还会导致灾难性的质量事故。
业务决策者习惯于百分比式的直观感知,但这并不意味着算法工程师可以在评估体系上偷懒。面对不均衡数据,专业工程师应当建立“混淆矩阵(Confusion Matrix)+ 精确率/召回率(Precision / Recall)+ PR 曲线下面积(PR-AUC)”的联动度量网,并将业务关注的代价函数(例如漏判一个次品的损失是误报一个合格品的 50 倍)显式纳入评估结论。
| 评估指标 | 核心计算公式 | 核心关注点 | 适用业务场景 |
|---|---|---|---|
| 准确率 (Accuracy) | (TP + TN) / 全量样本 | 全部预测中做对的总体比例 | 仅适用于正负类别比例高度均衡(接近 1:1)的任务 |
| 精确率 (Precision) | TP / (TP + FP) | 预测为正例的样本中,到底有多少是真正例 | 误报代价极高的场景(如垃圾邮件拦截、内容风控封禁) |
| 召回率 (Recall) | TP / (TP + FN) | 实际的所有正例样本中,到底找出了多少 | 漏报代价极高的场景(如疾病初筛、零件缺陷质检、欺诈拦截) |
| F1 分数 (F1-Score) | 2 × (P × R) / (P + R) | 精确率与召回率的调和平均值 | 类别分布不均衡时的综合性能权衡标尺 |
| PR-AUC | PR 曲线下的积分面积 | 不同分类置信度阈值下的整体鲁棒性 | 正样本极端稀缺(< 5%)场景下的首选评估指标 |
多维评估指标计算实战
import numpy as np
from sklearn.metrics import confusion_matrix, precision_score, recall_score, f1_score, average_precision_score

# 真实标签:980 个正常样本(0),20 个异常缺陷样本(1)
y_true = np.array([0] * 980 + [1] * 20)

# 模型 A:盲目全猜 0 的无用模型
y_pred_dummy = np.zeros_like(y_true)

# 模型 B:真正具备判别能力,抓住了 16 个异常,但带来 10 次误报的模型
y_pred_smart = np.array([0] * 970 + [1] * 10 + [0] * 4 + [1] * 16)

def evaluate_model(name, true, pred):
    tn, fp, fn, tp = confusion_matrix(true, pred).ravel()
    acc = (tp + tn) / len(true)
    prec = precision_score(true, pred, zero_division=0)
    rec = recall_score(true, pred, zero_division=0)
    f1 = f1_score(true, pred, zero_division=0)
    print(f"--- 评估报告: {name} ---")
    print(f"混淆矩阵: TP={tp}, FN(漏报)={fn}, FP(误报)={fp}, TN={tn}")
    print(f"表面准确率 (Accuracy): {acc:.4f}")
    print(f"精确率 (Precision):    {prec:.4f}")
    print(f"召回率 (Recall):       {rec:.4f}  <-- 关键业务指标")
    print(f"综合 F1-Score:         {f1:.4f}\n")

evaluate_model("全猜 0 愚蠢模型", y_true, y_pred_dummy)
evaluate_model("具备判别能力的工业模型", y_true, y_pred_smart)
错误五:测试集被过度消费引发的“元过拟合”(Data Snooping)
在许多入门教材中,数据划分往往只展示 train_test_split 切分成 Train 与 Test 两部分。初学者最容易形成的坏习惯是:在 Train 上训练模型,在 Test 上测出指标;若 Test 指标不理想,便回过头去调整学习率、修改网络层数、删增特征,然后再在同一个 Test 上运行验证,如此往复数十次。
这种做法被称为测试集污染(Test Set Contamination)或数据窥探(Data Snooping)。虽然开发者并没有直接把测试集的数据送进反向传播更新梯度,但开发者的调优决策(挑选哪一个超参数、保留哪一个特征)完全受测试集的反馈驱动。长此以往,超参数集合对这批测试数据形成了高阶过拟合(即“元过拟合”)。此时的测试集已经退化为半个训练集,完全失去了对未来未知数据独立判决的能力。
这个假设在调整超参数次数极少(比如只跑了两次)时偏差可能不大;但一旦使用了自动化超参数搜索(如 Optuna 或网格搜索),模型在几百次尝试中总有一组超参数能“偶然契合”测试集的噪声分布。这种信息泄漏发生在元学习(Meta-level)阶段。严谨的科学实验必须确保:最终评估所用的测试集是“封存在保险箱里”的裁判,直到整个算法体系完全冻结、交付上线前的最后一次评测才能拆封。
标准的三集物理隔离架构(Train-Val-Test)
工程上杜绝测试集污染的黄金方案是维持严格的三方划分架构:
- 训练集(Training Set,通常占 70%):负责参数的学习与权重更新;
- 验证集(Validation Set,通常占 15% 或采用 K-Fold 交叉验证):用于调整超参数、模型架构选型、早停(Early Stopping)决策;
- 测试集(Test Set / Holdout Set,通常占 15%):在研发全周期严禁碰触,仅在模型即将打包上线前进行唯一一次终审评测。
from sklearn.model_selection import train_test_split

# 假设 X, y 为待划分的原始全集
# 第一步:先拆出 15% 的测试集,并彻底封存至独立文件或只读变量
X_train_val, X_test, y_train_val, y_test = train_test_split(
    X, y, test_size=0.15, random_state=42, stratify=y
)

# 第二步:在剩下的 85% 数据中,再次划分训练集与验证集(例如 70% 训练,15% 验证)
# 计算验证集在剩余数据中的比例: 0.15 / (1.0 - 0.15) ≈ 0.1765
X_train, X_val, y_train, y_val = train_test_split(
    X_train_val, y_train_val, test_size=0.1765, random_state=42, stratify=y_train_val
)

print(f"训练集规模 (用于学习权重):    {X_train.shape[0]} 样本")
print(f"验证集规模 (用于调参与早停):  {X_val.shape[0]} 样本")
print(f"测试集规模 (终审前严禁查看):  {X_test.shape[0]} 样本")

# 调参周期内:仅反复在 X_train 上 fit,在 X_val 上 score
# 研发定型日:调用唯一一次 model.predict(X_test) 输出最终交付报告
总结:工程化避坑决策与排错全景
Python AI 研发的进阶过程,本质上是从“唯算法论”向“严谨工程实践”蜕变的过程。算法模型的上限往往由数据质量和任务定义决定,而工程底座的严谨性则决定了项目能否真正落地交付。下表对本文解析的五个高频错误、典型现象与防御基准进行了总结整理,供开发者在项目启动时进行自检排查。
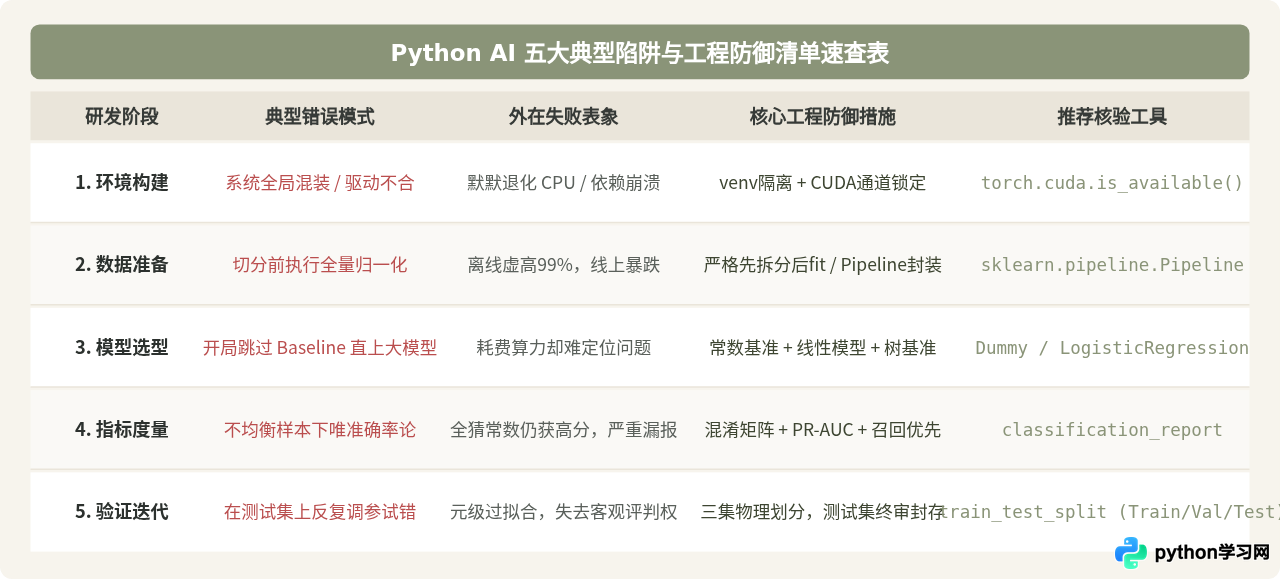
在日常研发中,建议读者将以上五条准则固化为项目启动清单(Checklist):在敲下第一行模型训练代码之前,确认环境已沙箱隔离且 GPU 通信畅通;确认特征工程已被规范打包进 Pipeline;确认拥有一个极速运行的简单 Baseline 作为参照物;确认业务评价指标能识别极度倾斜的类别;并将真正的测试集封存至最终阶段。建立起这样的工程直觉,能帮助开发者规避 90% 以上由不规范操作引发的系统性风险,真正发挥 Python 在人工智能领域的强大工程威力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















