


2026年Python数据科学框架趋势:PyTorch与TensorFlow怎么选
深入解析2026年Python数据科学与深度学习框架格局:PyTorch与TensorFlow/Keras 3的技术现状、核心运行机制、工业部署对比及具体选型决策指南。
在2026年的数据科学与深度学习实践中,如果你的主要方向是大语言模型研发、生成式AI应用或学术前沿探索,优先选择 PyTorch;如果你的团队需要编写通用算法模块,且希望代码能无缝在 JAX、PyTorch 和 TensorFlow 之间无感知切换,基于 Keras 3 的多后端抽象是最优路径;如果项目依存于已部署的传统工业生产管线(如 TFX、TF Serving)或受制于特定嵌入式固件环境,则应保留 TensorFlow。本文将针对当下的技术分工、运行与编译机制、端侧部署能力展开逐层说明,并给出明确的决策步骤。
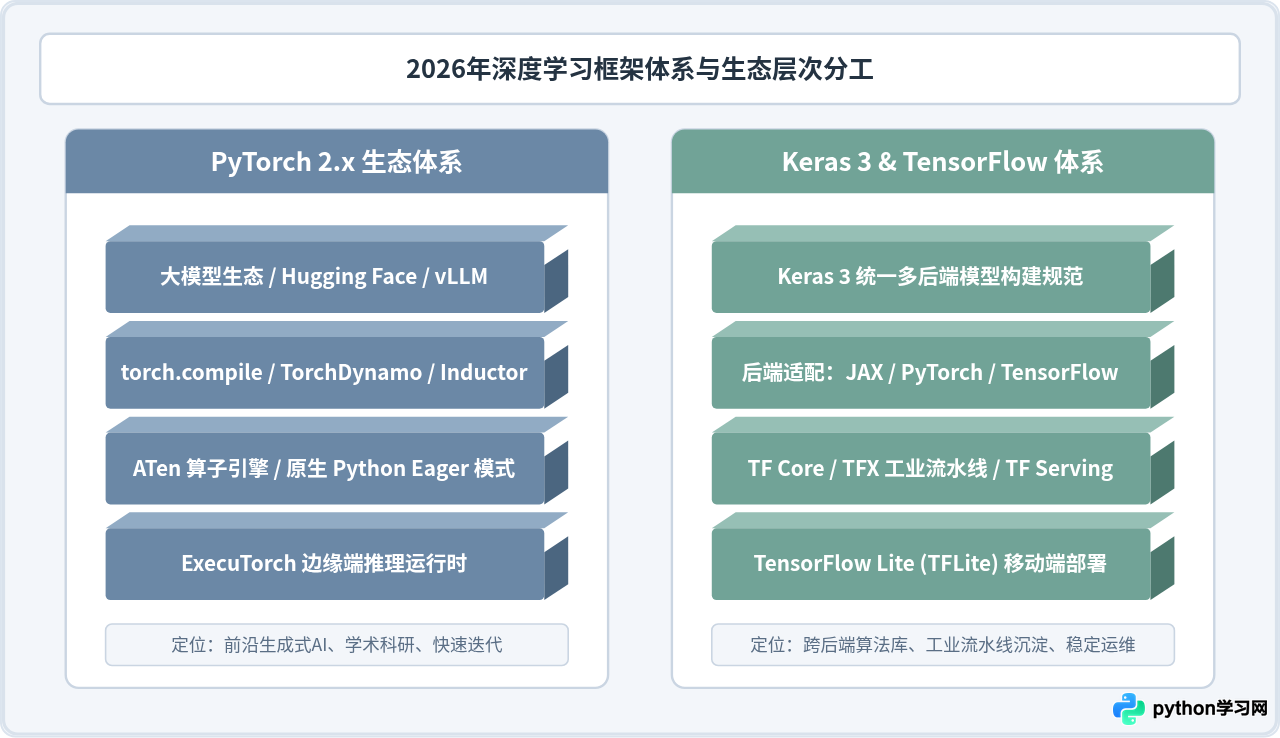
一、框架分工现状:PyTorch生态集中与TensorFlow的多后端演进
理解当下选型的首要前提,是厘清两个框架在生态中的真实定位。过去两者常被视作针锋相对的同类替代品,但经过数年演变,两者已经形成了差异化的分工格局。
PyTorch 已牢固确立了前沿研究与大模型领域的事实标准地位。从开源大语言模型微调库(如 Hugging Face Transformers、PEFT)、分布式训练加速引擎(如 DeepSpeed、Megatron-LM)到高性能推理部署后端(如 vLLM、TensorRT-LLM),核心开发与首发支持均优先基于 PyTorch 构建。PyTorch 2.x 引入的图编译器机制(torch.compile),让开发者在享受原生 Python 灵活调试体验的同时,获得了媲美静态图的执行性能。
TensorFlow 则经历了架构重组。在应用层,Keras 已全面升级为跨后端的独立框架(Keras 3),底层能够自由挂接 JAX、PyTorch 或 TensorFlow 引擎。TensorFlow 本身更多退居为底层的可靠计算运行时、企业已有流水线(TFX)的基础设施,以及嵌入式与移动端轻量推理(TFLite)的成熟载体。
二、开发机制与运行原理对比:动态图、编译加速与多后端支持
在开发与执行层面,两者的本质差异体现在代码执行路径与跨平台抽象能力上。
1. PyTorch 2.x 的动态图与即时编译(torch.compile)
PyTorch 传统上依靠即时执行(Eager Mode)著称,这使得代码易于使用标准 Python 调试器(如 pdb)进行单步跟踪。然而,过去 Eager 模式难以完全发挥硬件性能。PyTorch 2.x 通过 TorchDynamo 在 Python 字节码层面对计算图进行非侵入式捕获,经由 AOTAutograd 分解前向与反向图,最后交由 TorchInductor 自动生成面向 GPU 的高效 Triton 内核或针对 CPU 的 C++ 代码。
这意味着开发者无需重构模型代码,只需增加一行包装即可获得端到端的计算加速:
import torch
import torch.nn as nn

# 1. 定义标准的 PyTorch 模型
class DeepFeatureModel(nn.Module):
    def __init__(self, in_features: int, hidden_dim: int, num_classes: int):
        super().__init__()
        self.block = nn.Sequential(
            nn.Linear(in_features, hidden_dim),
            nn.LayerNorm(hidden_dim),
            nn.GELU(),
            nn.Linear(hidden_dim, num_classes)
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.block(x)

# 2. 运行时配置与硬件检测
device = "cuda" if torch.cuda.is_available() else "cpu"
model = DeepFeatureModel(in_features=128, hidden_dim=256, num_classes=10).to(device)

# 3. 启用 PyTorch 2.x 图编译器 (对执行流进行内核融合优化)
compiled_model = torch.compile(model, mode="reduce-overhead")

# 4. 执行推理验证 (输出仅作为示例验证代码通路)
sample_tensor = torch.randn(16, 128, device=device)
output = compiled_model(sample_tensor)
print("PyTorch 模型输出维度:", output.shape)
# 预期示例输出: PyTorch 模型输出维度: torch.Size([16, 10])
2. Keras 3 的跨后端通用范式
对于希望摆脱特定框架锁定的团队,Keras 3 改变了以往必须绑定 TensorFlow 的约束。开发者只需在加载模块前设置环境变量 KERAS_BACKEND,相同的模型逻辑即可在 JAX、PyTorch 与 TensorFlow 上一致运行:
import os
# 指定计算后端为 'torch',亦可随时替换为 'jax' 或 'tensorflow'
os.environ["KERAS_BACKEND"] = "torch"

import keras
from keras import layers

# 跨后端构建网络结构
def create_agnostic_network(input_dim: int, num_classes: int) -> keras.Model:
    inputs = keras.Input(shape=(input_dim,))
    x = layers.Dense(256, activation="gelu")(inputs)
    x = layers.LayerNormalization()(x)
    outputs = layers.Dense(num_classes, activation="softmax")(x)
    return keras.Model(inputs=inputs, outputs=outputs)

model = create_agnostic_network(input_dim=128, num_classes=10)
model.compile(
    optimizer=keras.optimizers.AdamW(learning_rate=1e-3),
    loss="sparse_categorical_crossentropy",
    metrics=["accuracy"]
)
print("Keras 3 当前底层激活引擎:", keras.backend.backend())
# 预期示例输出: Keras 3 当前底层激活引擎: torch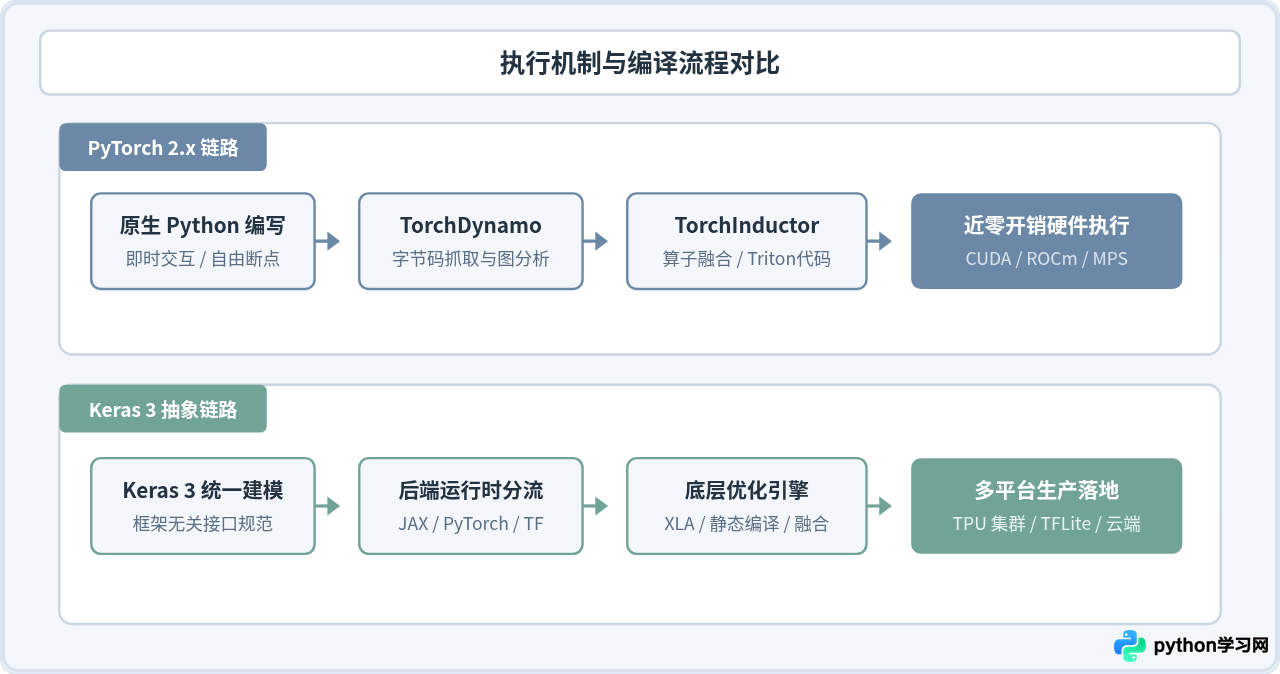
三、部署与端侧支持:云端服务与嵌入式运行时的抉择
在工程落地环节,框架选型不仅关乎模型训练,更决定了后期的运维成本:
- 大规模在线服务:在大语言模型和复杂生成式模型场景下,由于权重格式几乎均为 PyTorch 兼容结构(如
safetensors),选用vLLM、TGI或直接基于 PyTorch C++ 运行时的服务化框架,可以规避额外的格式转换开销。而传统的结构化数据、多任务推荐系统若已深度集成于 Google Cloud 或自建的TF Serving体系中,维持原有 SavedModel 格式依然具备极佳的高并发吞吐表现。 - 移动端与嵌入式设备:在此领域形成了两条明显的技术路线:
- TensorFlow Lite (TFLite):经过长期工业检验,算子覆盖极其完整,对各类 ARM 架构、低功耗微控制器(MCU)以及各类 NPU 厂商驱动有成熟的原生支持。
- ExecuTorch:PyTorch 官方推出的专用端侧运行时,专为在手机、平板及边缘终端部署 PyTorch 模型设计,具备极小的二进制体积与高度模块化的内存管理机制,尤其适合端侧运行小型视觉模型或端侧轻量语言模型。
torch.onnx.dynamo_export 导出接口,能够更准确地保留动态形状与控制流信息。
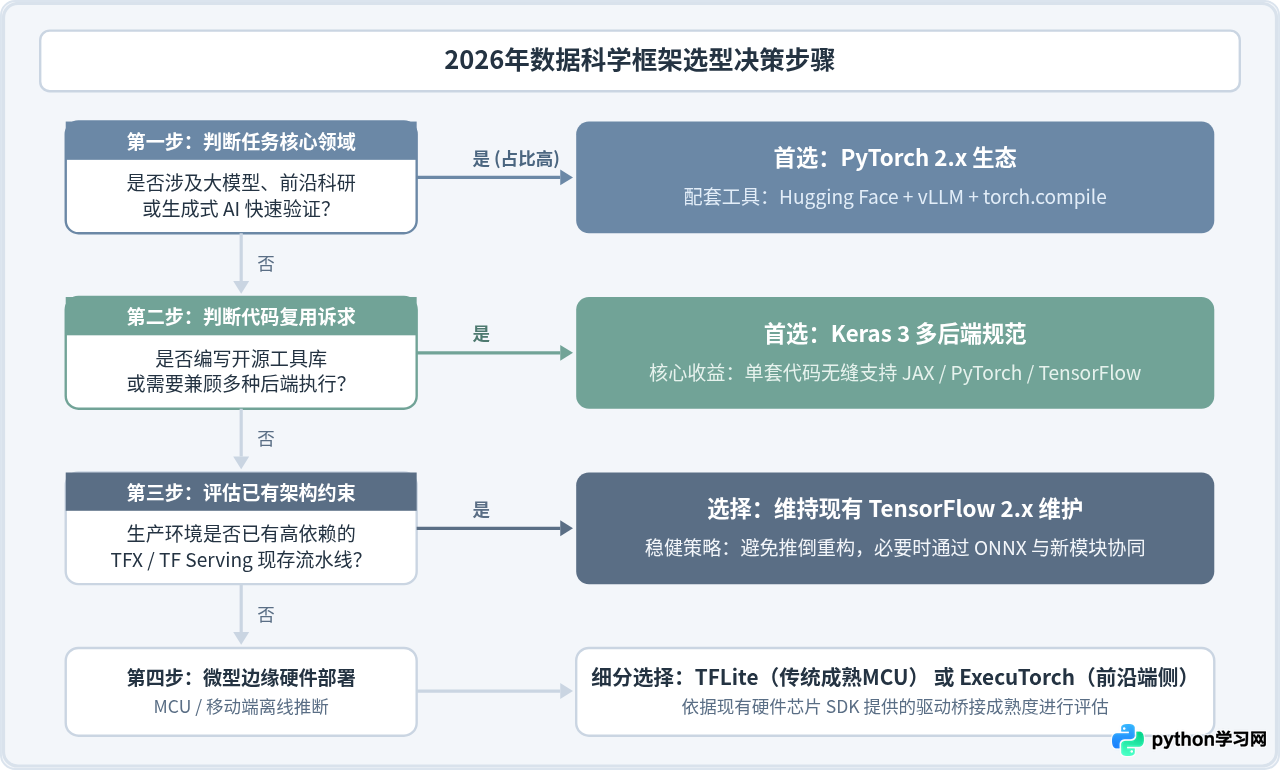
四、选型决策指南:具体场景匹配步骤
为了帮助你在实际项目中做出确定性决策,请按照以下四个判断步骤依次梳理需求:
五、综合指标对比与选型总结
为了让不同场景下的选型对比更加直观,下表汇总了关键维度的客观指标:
| 对比维度 | PyTorch 2.x | TensorFlow / Keras 3 |
|---|---|---|
| 核心主导领域 | 生成式AI、LLM微调与预训练、学术研究、前沿工程 | 跨平台算法库、企业现有数据流水线、传统工业运维 |
| 调试与开发体验 | 原生 Python 语法结构,支持 pdb 交互式单步调试 | Keras 抽象规范整洁统一;纯 TF 底层排错较为繁复 |
| 图编译加速技术 | torch.compile (基于 TorchInductor + Triton) |
XLA 全局优化器 / 各后端原生编译器 |
| 开源生态丰富度 | 极高(Hugging Face、vLLM、DeepSpeed、FlashAttention) | 中等(核心模型首发较少,但具备庞大的既有企业资产) |
| 多框架互操作性 | 主要聚焦自身生态,依靠 ONNX/SafeTensors 对外交互 | Keras 3 天生具备跨 JAX、PyTorch 与 TF 的能力 |
| 移动与端侧方案 | ExecuTorch(现代轻量运行时,积极发展中) | TensorFlow Lite(长期验证,MCU/低功耗芯片支持极广) |
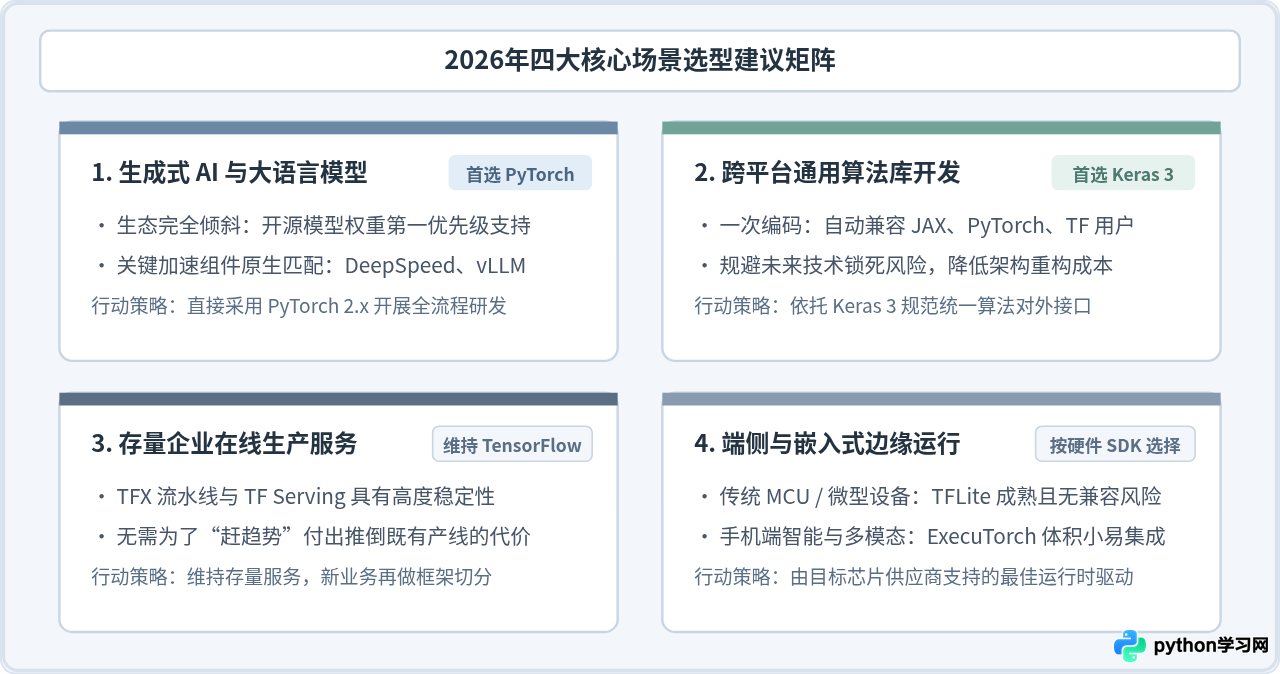
综上所述,2026年的 Python 数据科学框架选型已经从“非此即彼的优劣争论”转变为“以任务为中心的工程落地”:把握 PyTorch 在大模型与生成式前沿的主导优势,借助 Keras 3 保持跨后端的灵活性,并在已有的 TensorFlow 资产中维持高稳定性的生产服务,是当前最具实用价值的技术策略。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















