


Python for循环中break和continue的用法
深入解析Python for循环中break与continue语句的具体用法、执行机制、核心差异与典型应用场景。
for 循环用于顺序遍历列表、元组、字符串或范围等可迭代对象中的各项元素。通常情况下,循环会一直执行到所有元素处理完毕为止。但在实际业务中,我们往往需要在满足特定条件时主动干预执行流程:break 用于彻底终止当前所在循环,直接跳出循环体;而 continue 则用于跳过当次迭代的剩余语句,直接开始下一次循环判定与取值。
一、break 语句:提前终止并跳出循环
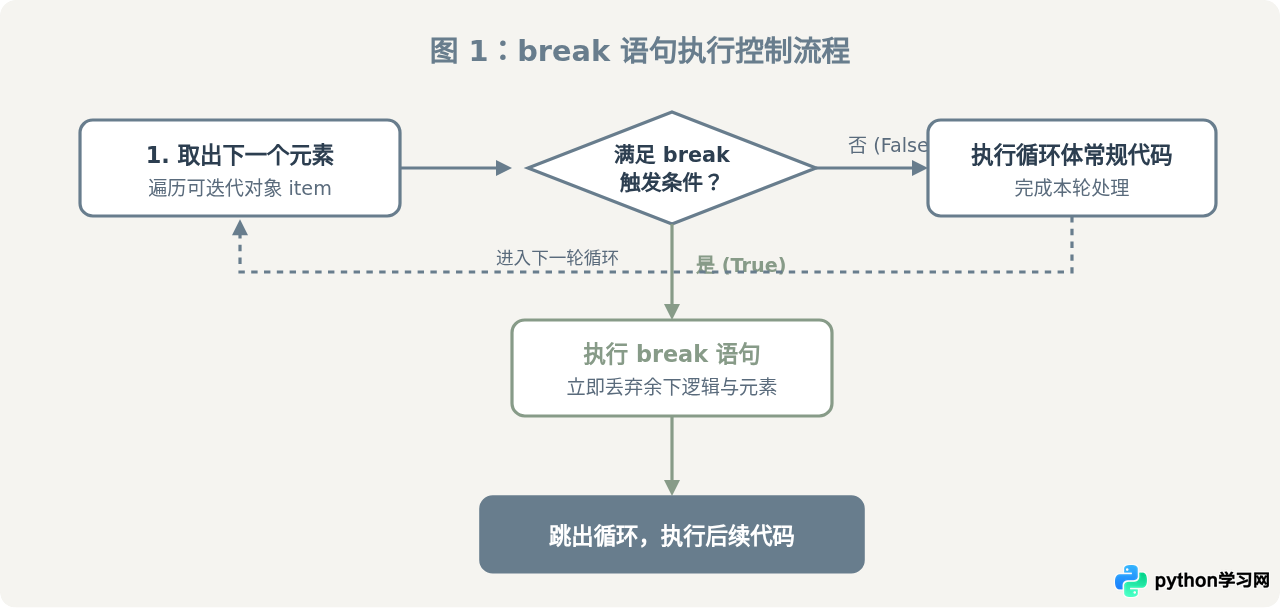
当程序在 for 循环体内部执行到 break 语句时,Python 解释器会立即中断该循环的执行过程。此时,当前这一轮循环中尚未执行的剩余语句会被直接丢弃,序列中剩余未遍历的元素也不会再被处理,程序指针直接移动到整个循环结构之后的第一行代码继续运行。
break 最常见的应用场景是“目标搜索与验证”。例如在一个大型集合中查找某条特定数据,一旦成功找到目标,后续数据的遍历便失去了实际意义。此时使用 break 提前退出,不仅能简化业务逻辑,还能显著节省不必要的计算开销。
示例代码:查找匹配项目并提前退出
# 目标:在用户列表中寻找首个封禁用户,记录并退出检查
users = [
    {"id": 101, "name": "张伟", "status": "active"},
    {"id": 102, "name": "李强", "status": "active"},
    {"id": 103, "name": "王芳", "status": "banned"},
    {"id": 104, "name": "赵磊", "status": "active"}
]

target_user = None

for user in users:
    print(f"正在检查用户: {user['name']}")
    if user["status"] == "banned":
        target_user = user
        print(f">> 发现封禁用户【{user['name']}】,终止后续检查。")
        break

print(f"最终检查结果: {target_user}")
示例输出:
正在检查用户: 张伟
正在检查用户: 李强
正在检查用户: 王芳
>> 发现封禁用户【王芳】,终止后续检查。
最终检查结果: {'id': 103, 'name': '王芳', 'status': 'banned'}
可以看到,当程序检查到第三个元素“王芳”并满足条件后,break 触发,第四个用户“赵磊”不会被打印或检查,循环彻底结束。
二、continue 语句:跳过本轮迭代,继续后续项
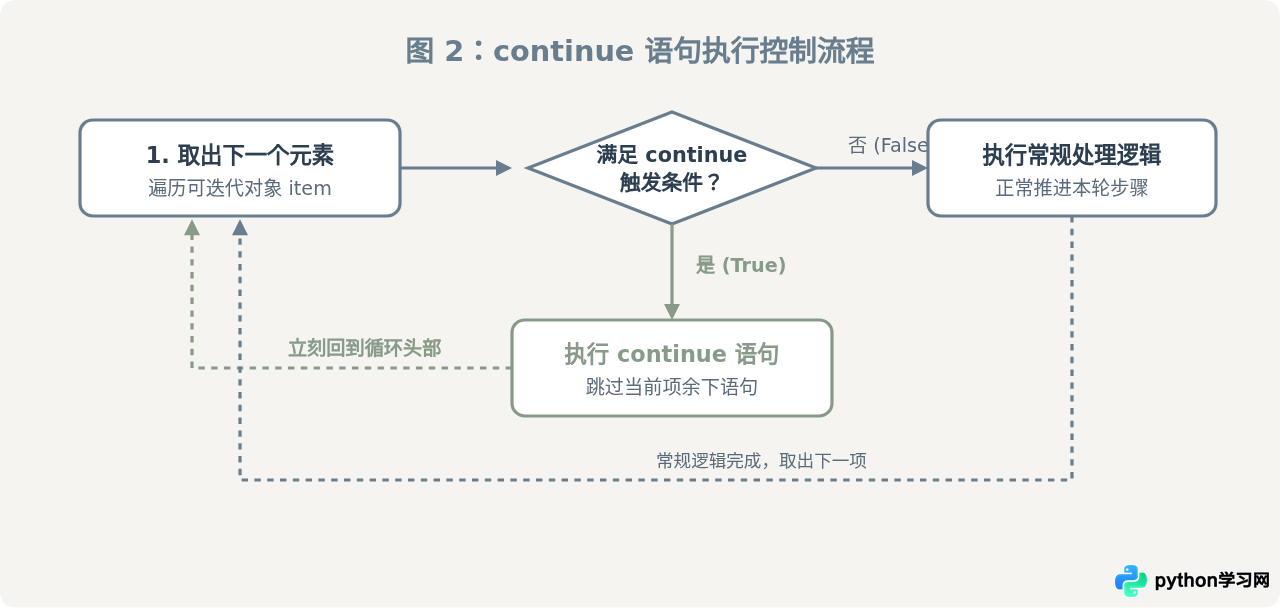
与彻底终止循环的 break 不同,continue 的作用仅限于“当前这一轮迭代”。当解释器遇到 continue 时,会跳过该语句之后的所有当前循环体代码,直接回到 for 循环头部,取出序列中的下一个元素并开启新一轮执行。
continue 非常适合用于数据过滤、异常值忽略或守卫式代码组织(Guard Clauses)。当某条数据不符合处理要求时,直接使用 continue 跳过,可以避免多层嵌套的 if-else 结构,使主流程逻辑保持平铺易读。
示例代码:清洗无效记录并汇总
# 目标:对成绩列表中的有效分数进行累计,忽略非法值(空值或负数)
scores = [85, None, 92, -5, 78, "缺考", 90]
valid_scores = []

for item in scores:
    # 守卫条件:类型不符或非正数直接跳过
    if not isinstance(item, (int, float)) or item < 0:
        print(f"跳过无效数据项: {item}")
        continue

    # 只有合法数据才会执行到这一步
    valid_scores.append(item)
    print(f"录入有效成绩: {item}")

print("-" * 30)
print(f"有效成绩集合: {valid_scores}")
print(f"平均分: {sum(valid_scores) / len(valid_scores):.1f}")
示例输出:
录入有效成绩: 85
跳过无效数据项: None
录入有效成绩: 92
跳过无效数据项: -5
录入有效成绩: 78
跳过无效数据项: 缺考
录入有效成绩: 90
------------------------------
有效成绩集合: [85, 92, 78, 90]
平均分: 86.2
三、break 与 continue 核心差异对照
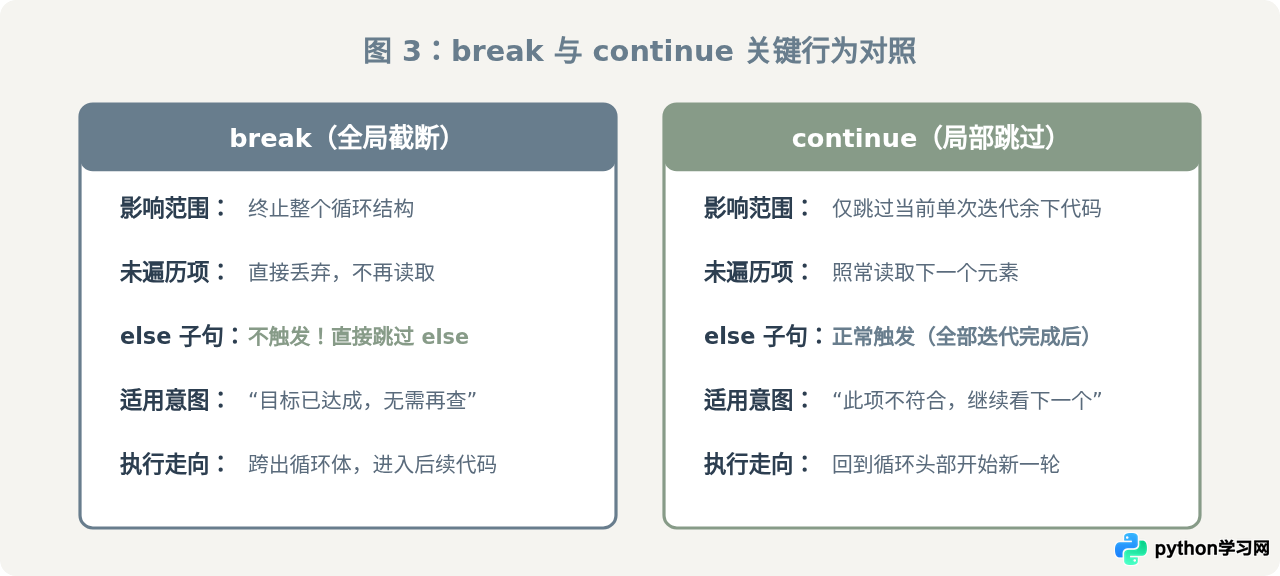
为了准确选用合适的控制语句,理解二者在执行生命周期和外部影响上的差异至关重要。
| 对比维度 | break 语句 | continue 语句 |
|---|---|---|
| 控制粒度 | 循环级别(终止整个循环体) | 迭代级别(终止当前这一次循环迭代) |
| 后续元素处理 | 立即丢弃,不再读取任何后续元素 | 继续正常读取下一个元素直至序列穷尽 |
| 对 for...else 的影响 | 破坏正常结束状态,else 块绝不执行 | 不破坏循环完整性,遍历结束后正常执行 else 块 |
| 典型应用模式 | 线性搜索命中、早退验证、达到阀值截断 | 数据预清洗、空值跳过、异常分流 |
Python 允许在
for 循环末尾添加一个 else 子句。很多人容易产生误解,其实 for...else 的含义是:“只有当循环自然遍历完所有元素且没有遭遇 break 时,才执行 else 块”。如果循环中执行了
break,else 块会被跳过;而无论执行了多少次 continue,只要所有元素都处理完毕,else 块依然会正常运行。
# 演示 for...else 与 break、continue 的配合机制
def search_number(numbers, target):
    for n in numbers:
        if n < 0:
            continue  # 负数不参与判定,继续看下一个
        if n == target:
            print(f"找到目标数值: {n}")
            break     # 命中目标,跳出循环,阻断 else 执行
    else:
        # 只有在完全没有触发 break 时才会运行
        print(f"列表中未找到有效目标: {target}")

search_number([1, -3, 5, 7], 5)   # 输出:找到目标数值: 5
search_number([1, -3, 4, 7], 9)   # 输出:列表中未找到有效目标: 9
四、嵌套循环与进阶注意事项
1. 仅作用于最内层循环
在多层嵌套的 for 循环中,无论是 break 还是 continue,都只对包含该语句的最直接、最内层循环生效,不会自动向外层穿透。
# 演示嵌套循环下的 break 范围
for outer in ["A", "B"]:
    print(f"进入外层: {outer}")
    for inner in [1, 2, 3]:
        if inner == 2:
            print("  - 触发内层 break")
            break  # 仅跳出 inner 循环,outer 循环不受影响
        print(f"  内层数值: {inner}")
输出结果:
进入外层: A
  内层数值: 1
  - 触发内层 break
进入外层: B
  内层数值: 1
  - 触发内层 break
若业务要求在内层满足条件时连同外层循环一同跳出,常见且规范的做法有两种:
- 使用标志变量(Flag):在内层设置
found = True,并在外层紧接着判定该标志并break。 - 将多层嵌套封装为独立函数:直接在内层使用
return语句退出函数,干净利落地终结所有嵌套循环。
2. 避免冗余与无意义的跳转
如果 continue 出现在循环体的最末尾且没有后续代码,该 continue 实际上是完全多余的,因为循环体本身就会自然进入下一轮。保持控制语句紧贴判定条件,能够让阅读者第一时间了解跳转意图。
五、流程控制决策指南与总结
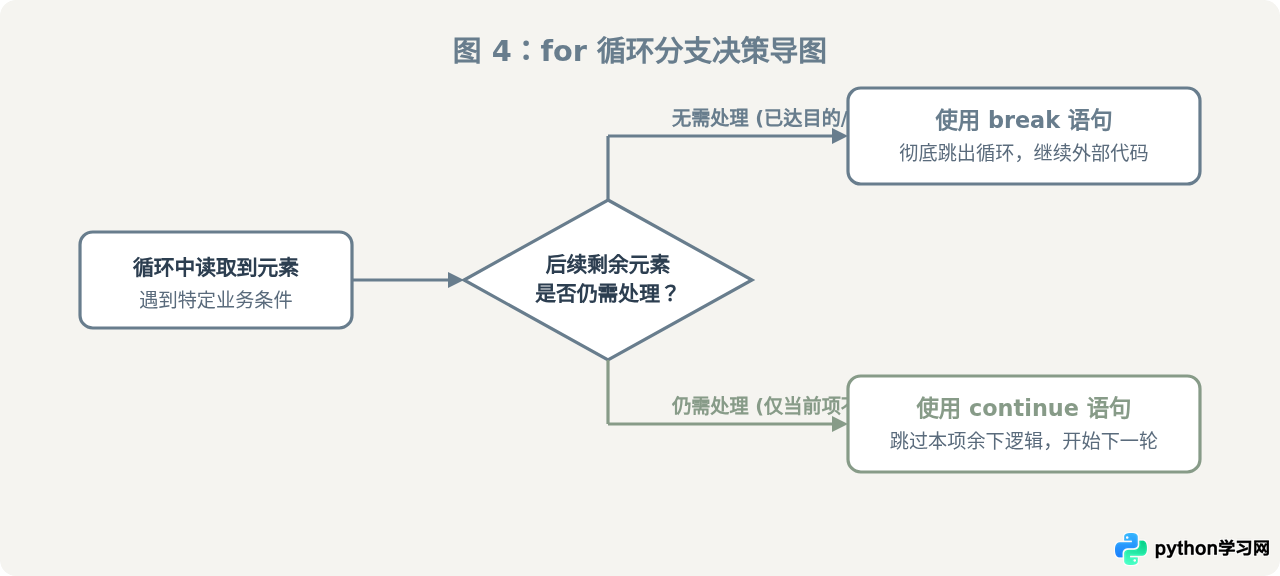
总结来说:
- 当你需要“叫停全局”——例如找到目标结果、检测到严重错误或达到处理上限时,使用
break。 - 当你需要“跳过个案”——例如遇到脏数据、不匹配的过滤条件或权限不足的单项记录时,使用
continue。
合理运用这两个语句,不仅能精简嵌套判断分支,还能让循环体的业务逻辑脉络更加清晰直观。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















