


mysqldump核心参数解析:--single-transaction与--master-data作用
深入解析mysqldump核心参数--single-transaction与--master-data的工作原理、底层执行时序、主从搭建应用与生产环境注意事项。
在 MySQL 数据库的日常运维与容灾设计中,mysqldump 是应用最广泛的官方逻辑备份工具。当面对高并发的生产环境时,数据库备份有两个核心诉求:第一是保证备份数据的一致性且不阻塞线上业务读写;第二是在搭建主从复制架构或进行时间点恢复(Point-in-Time Recovery)时,能够精准获取备份数据对应的二进制日志(Binary Log)位点。这两个关键职责分别由 --single-transaction 与 --master-data 两个核心参数承担。本文将从底层实现原理、执行时序、参数配合逻辑及典型避坑指南四个维度展开系统解析。
一、--single-transaction:MVCC一致性快照导出机制
--single-transaction 的主要作用是在导出数据前开启一个事务,利用 InnoDB 引擎的多版本并发控制(MVCC,Multi-Version Concurrency Control)机制,在不锁定整个数据库写操作的前提下,获取一份处于同一时间点的一致性数据视图。
在没有开启该参数时,为了防止备份过程中部分表写入新数据导致逻辑数据割裂(例如订单表已扣款,而流水表未导出最新记录),mysqldump 通常需要退回到锁定表(--lock-tables 或 --lock-all-tables)的方式,这会直接造成全库业务写停顿。而 --single-transaction 则优雅地解决了这一矛盾。
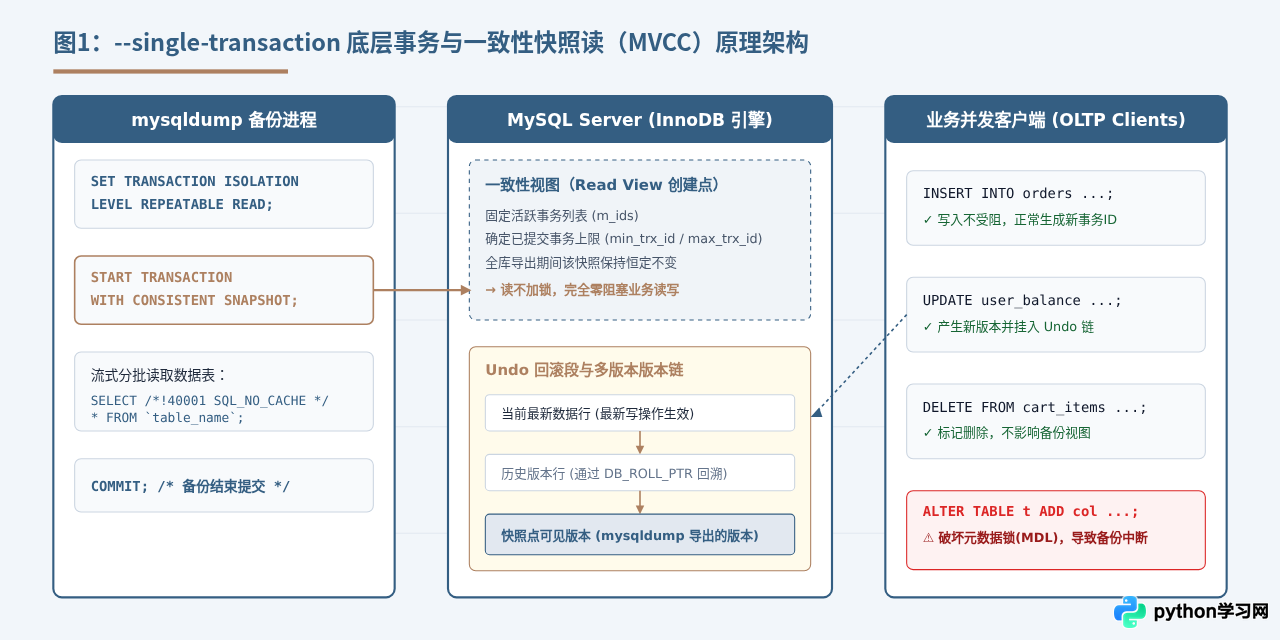
1. 底层 SQL 执行流剖析
当在命令行中加入 --single-transaction 后,查看 MySQL 的通用日志(General Query Log),可以观察到 mysqldump 执行了以下关键命令序列:
-- 1. 将当前客户端会话的事务隔离级别设置为可重复读(REPEATABLE READ)
SET SESSION TRANSACTION ISOLATION LEVEL REPEATABLE READ;

-- 2. 启动事务并立即创建一致性快照
START TRANSACTION /*!40100 WITH CONSISTENT SNAPSHOT */;

-- 3. 逐表设置保存点或流式导出数据
SAVEPOINT sp;
SELECT /*!40001 SQL_NO_CACHE */ * FROM `order_info`;
ROLLBACK TO SAVEPOINT sp;

-- 4. 导出结束,提交事务
COMMIT;
其中核心语句是 START TRANSACTION WITH CONSISTENT SNAPSHOT。普通的 START TRANSACTION 仅仅是显式开启事务,InnoDB 并不会立即生成快照,而是在执行第一条 SELECT 语句时才真正建立 Read View。添加了 WITH CONSISTENT SNAPSHOT 修饰后,MySQL 会在执行该语句的这一微秒内立刻冻结并创建 Read View,确保后续所有导出表的基准时间线完全对齐在事务开启的那一刻。
2. 核心限制与适用边界
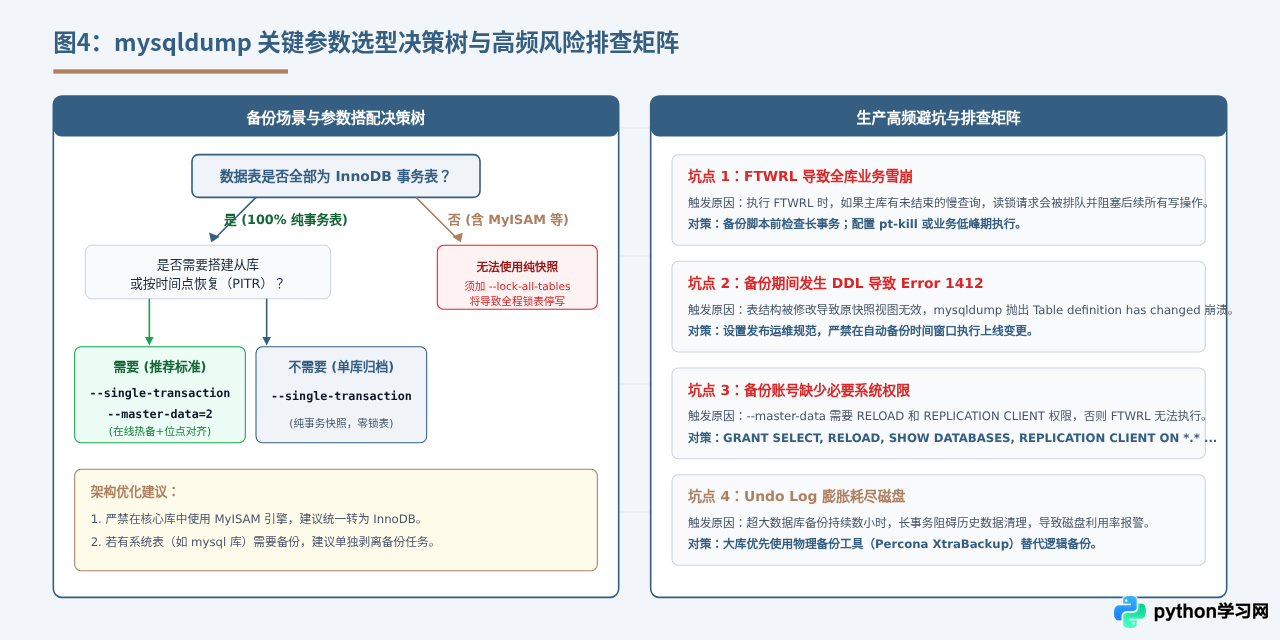
- 仅适用于事务型存储引擎:该参数完全依赖 InnoDB 等支持 MVCC 的引擎。如果库中存在 MyISAM、Memory 或第三方非事务引擎表,这些表在导出时无法使用快照读,其数据一致性将无法保障。
- DDL 操作破坏一致性:如果在备份期间执行了
ALTER TABLE、DROP TABLE或OPTIMIZE TABLE,由于元数据锁(MDL,Metadata Lock)机制,或者由于表定义缓存被清理,可能导致备份进程报错中断(例如常见的Error 1412: Table definition has changed, please retry transaction)。 - Undo 表空间压力增大:由于备份长事务持续存在,该事务之后发生更新所产生的所有 Undo 历史版本都不能被 Purge 线程清理,会导致 Undo 表空间显著膨胀,并在备份极长时拖慢数据库性能。
二、--master-data:捕获二进制日志位点(Binlog Position)
如果说 --single-transaction 解决的是“表数据自身的一致性”,那么 --master-data 解决的则是“备份数据与增量日志之间的对齐”。它的核心作用是在备份文件中记录下当前数据库正在写入的二进制日志文件名(Binary Log File)以及具体的偏移位置(Position)。
1. 为什么必须获取 Binlog 位点?
在基于物理或逻辑备份构建主从复制架构(Replication)时,从库导入完备份的全量数据后,必须知道从主库的哪一个位点开始同步增量数据。如果位点偏后,会导致中间这段时间产生的数据丢失;如果位点偏前,从库重复执行已经包含在备份里的 SQL,很可能触发主键冲突(Duplicate entry)导致复制线程中断。同理,当使用 mysqlbinlog 进行按时间点的恢复时,也必须从该位点开始重放增量日志。
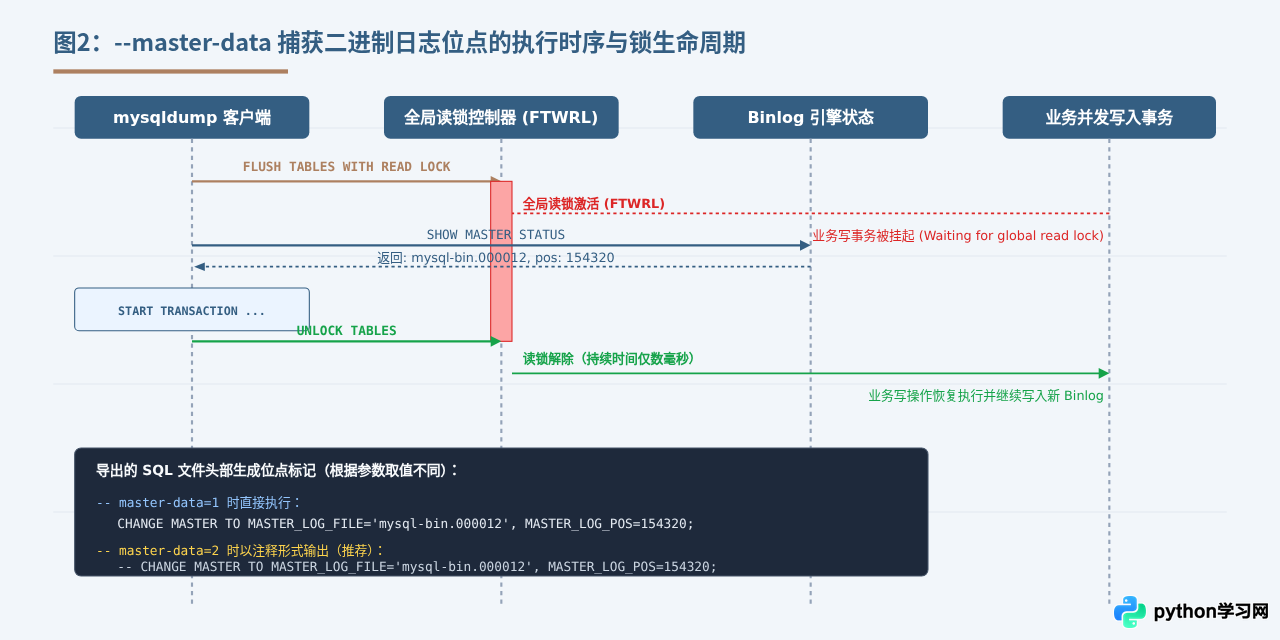
2. 选项差异:--master-data=1 与 --master-data=2
--master-data 接受两个有效的整数值:
| 参数值 | 在导出的 .sql 文件中的表现 | 适用场景与影响 |
|---|---|---|
--master-data=1 |
输出未被注释的 SQL 语句:CHANGE MASTER TO MASTER_LOG_FILE='...', MASTER_LOG_POS=...; |
导入该 SQL 文件的实例会直接执行这条语句并自动更新从库复制源。如果导入的目标是普通只读库或本地测试库,会导致无意中覆盖现存的主从复制配置。 |
--master-data=2 |
输出被注释掉的 SQL 语句:-- CHANGE MASTER TO MASTER_LOG_FILE='...', MASTER_LOG_POS=...; |
生产环境标准推荐。导入时作为普通注释跳过,不影响正常数据导入;DBA 可以通过 head 或 grep 直接查阅该文件获取准确位点,按需配置从库。 |
在 MySQL 8.0.26 及以上版本中,为使用更加包容性术语,
--master-data 参数被标记为过时(Deprecated),并引入了功能完全等价的替代参数 --source-data。其输出语句也相应演变为 CHANGE REPLICATION SOURCE TO SOURCE_LOG_FILE='...', SOURCE_LOG_POS=...;。目前 --master-data 仍完全兼容保留,但建议在新的自动化运维脚本中逐步替换为 --source-data。
三、黄金搭档:二者联合使用的底层协作时序
许多刚接触 MySQL 备份的工程师容易产生误解,认为“既然 --master-data 会锁表,那线上就不能加它”。实际上,单独使用 --master-data 确实会执行 FLUSH TABLES WITH READ LOCK 并且在整个备份导出期间一直持有该全局锁,直到所有数据导出完成才释放,这对于大型数据库而言是灾难性的。
然而,当 --single-transaction 与 --master-data=2 配合使用 时,mysqldump 的执行逻辑展现了精妙的协作机制:
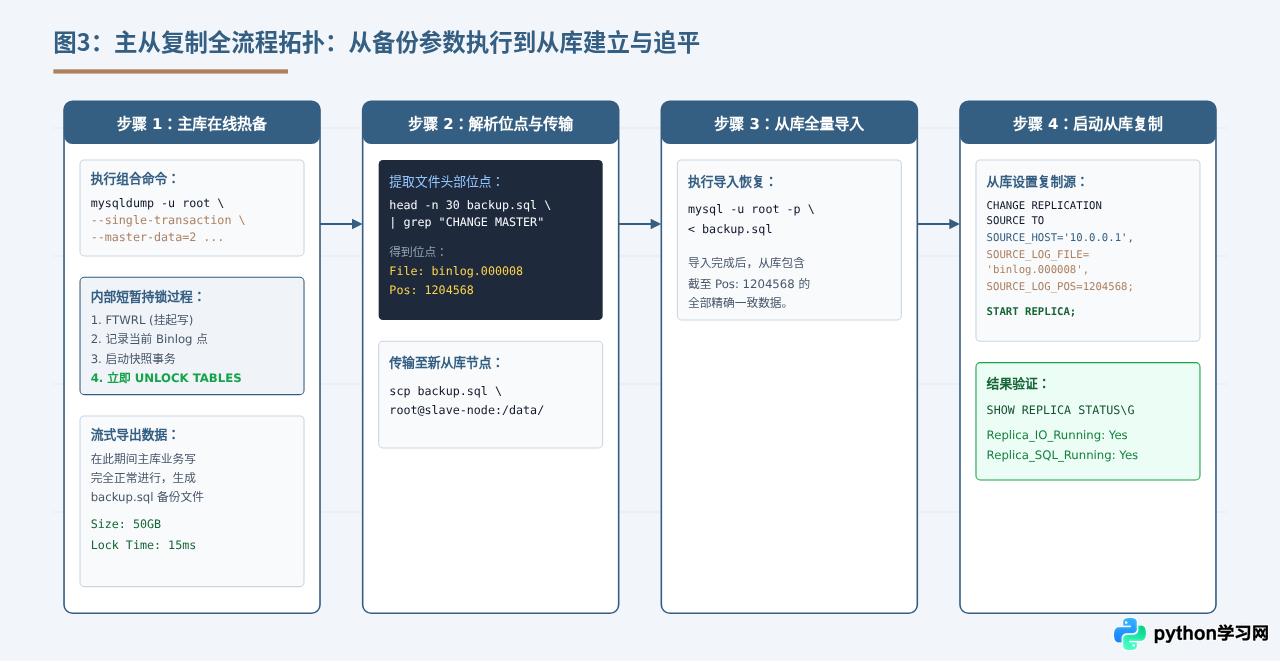
时序执行拆解:毫秒级持锁与一致性快照的衔接
- 第 1 步:客户端连接数据库,设置当前会话隔离级别为
REPEATABLE READ。 - 第 2 步:执行
FLUSH TABLES WITH READ LOCK。此时全库禁止写入,但这一步仅仅是为了定格瞬间状态。 - 第 3 步:在持有全局锁的安全环境下,执行
SHOW MASTER STATUS,获取当前写入的 Binlog 文件名与 Position。 - 第 4 步:紧接着执行
START TRANSACTION /*!40100 WITH CONSISTENT SNAPSHOT */。此时 InnoDB 的 MVCC 快照被成功建立,且该快照包含的数据状态与步骤 3 中抓取到的 Binlog 位点严丝合缝。 - 第 5 步:执行
UNLOCK TABLES。全局读锁立即释放!整个锁表时间通常仅持续数毫秒到十几毫秒。 - 第 6 步:在没有全局锁、业务读写完全恢复的情况下,
mysqldump按照刚才创建的一致性快照持续流式导出表数据,即使导出过程耗时数小时,也不会阻塞业务。
四、生产级备份命令与参数组合选型
在生产环境中进行逻辑备份时,除了这两个核心参数外,通常还需要搭配字符集、存储过程、触发器以及流式导出等配套参数。以下是经过生产检验的标准备份命令模板:
mysqldump -h 127.0.0.1 -P 3306 -u backup_user -p \
  --single-transaction \
  --master-data=2 \
  --default-character-set=utf8mb4 \
  --routines \
  --triggers \
  --events \
  --quick \
  --max-allowed-packet=1G \
  --databases my_business_db > /backup/mysql/my_business_db_$(date +%F).sql
核心配套参数的作用说明:
--quick(-q):强制mysqldump一行一行地从服务器检索行,而不是缓冲整表数据到客户端内存中。对于百万或千万级大表,能有效防止客户端 OOM(内存溢出)。--routines(-R)与--triggers:保证存储过程、存储函数和触发器一并导出。默认情况下触发器会导出,但存储过程不会,建议显式声明。--events(-E):备份 MySQL 定时事件调度器(Event Scheduler)任务。--max-allowed-packet:增大网络数据包上限,防止导出包含大文本字段(MEDIUMTEXT/BLOB)的单行记录时发生数据传输中断。
五、关键避坑要点与运维最佳实践
1. 备份账号的最小权限原则
为了让 --single-transaction 与 --master-data 顺利执行,专用的备份账号必须具备适当的全局特权:
-- 为备份用户授权最小必要权限集合
CREATE USER 'dumper'@'127.0.0.1' IDENTIFIED BY 'Strong_Password_123';
GRANT SELECT, RELOAD, LOCK TABLES, SHOW VIEW, PROCESS, REPLICATION CLIENT, TRIGGER ON *.* TO 'dumper'@'127.0.0.1';
FLUSH PRIVILEGES;其中,RELOAD 权限是执行 FLUSH TABLES WITH READ LOCK 的前置条件;REPLICATION CLIENT(在 MySQL 8.0 中也可使用 SHOW CHANNELS 或 REPLICATION SLAVE 相关子权限)用于允许执行 SHOW MASTER STATUS。如果缺少这两个权限,--master-data 会直接报错退出。
2. 防范长查询引起的“锁雪崩”
在执行 FLUSH TABLES WITH READ LOCK 时,MySQL 会等待所有当前正在运行的写事务和只读查询完全结束。如果数据库中存在一条耗时数分钟的慢查询,FTWRL 命令将会进入 Waiting for table flush 状态;更为严重的是,由于该全局锁处于等待队列的前列,它后面的所有普通业务写请求(INSERT/UPDATE)也都会被全线阻塞在队列中,导致数据库连接池瞬间被打满,造成系统雪崩。
实战建议:
- 确保备份任务在业务低峰期(如凌晨 2:00 ~ 5:00)运行。
- 在执行
mysqldump之前,备份脚本应主动检查information_schema.processlist,若存在耗时超过 60 秒的长查询,优先告警并延后备份,或者通过工具终止死锁查询。 - 对备份会话设置锁等待超时阈值(例如通过控制台参数或连接配置指定较低的
lock_wait_timeout)。
3. 物理备份与逻辑备份的适用边界
mysqldump 作为逻辑备份工具,由于其导出的 SQL 具备良好的可读性、跨平台迁移性以及引擎重构便捷性,在中小型数据库(通常数据量在 100GB 以内)中是首选方案。然而,当单库数据量达到几百 GB 甚至 TB 级别时,即便配合了 --single-transaction 与 --master-data,导出与恢复过程耗时极长,对 Undo 空间和 Buffer Pool 会产生较大扰动。此时应考虑切换为基于数据页复制的物理热备工具(例如 Percona XtraBackup 或官方 MySQL Enterprise Backup),以进一步降低对生产环境的冲击并实现分钟级极速恢复。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















