


Python主流数据库框架对比:SQLAlchemy、Django ORM与Peewee选型指南
深入对比Python三大主流数据库ORM框架:SQLAlchemy、Django ORM与Peewee。全面解析架构设计、CRUD语法、关联查询、迁移生态与生产选型决策路径。
一、选型困境与三者的核心定位
假设你正在主导一个新 Python 项目的底层数据持久层设计:面对即将来临的高并发接口、多表关联报表或是快速交付的业务原型,如果选型失当,往往会在后期付出高昂的架构重构代价——轻则被臃肿的框架机制拖垮响应吞吐,重则在复杂动态 SQL 面临“ORM 表达力不足”的严重阻碍。
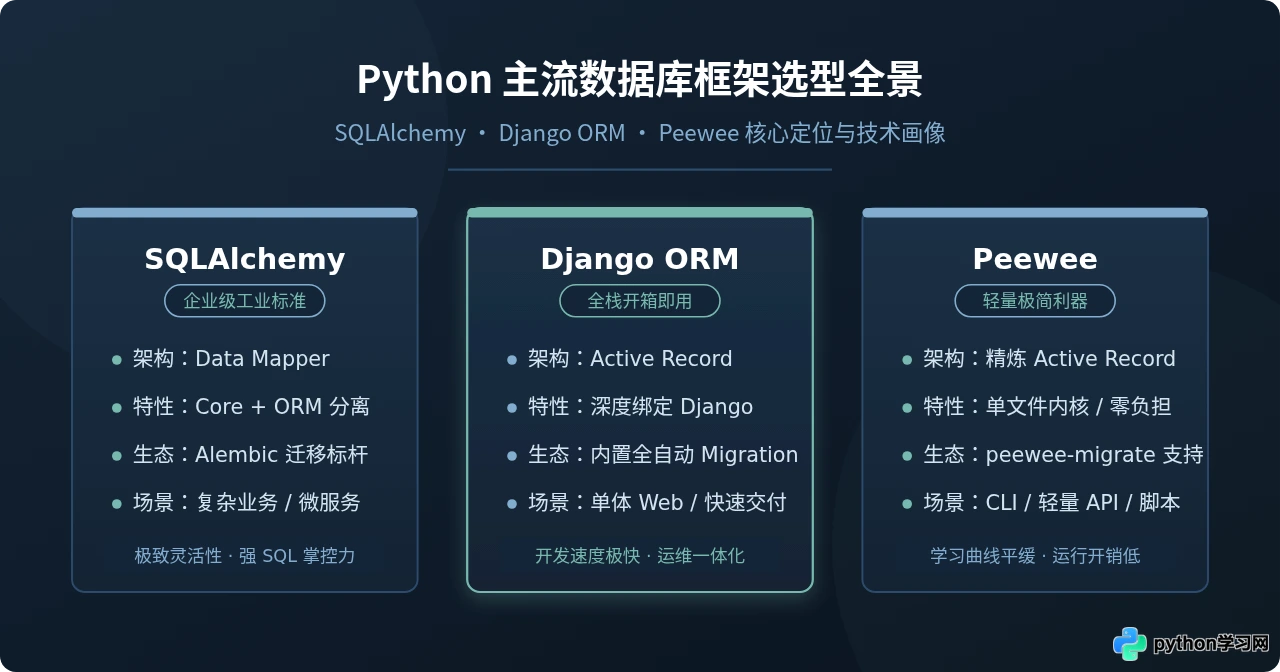
在 Python 的数据库访问生态中,SQLAlchemy、Django ORM 和 Peewee 占据了绝对主导地位,但它们从出生起就承载着截然不同的工程哲学与设计取舍。核心选型结论可以直接归纳为三条明确路径:
- Django ORM: 如果项目本身是基于 Django 体系构建的全栈 Web 应用,它是首选且唯一的自然选择。其与 Django Admin、认证系统、自动化表结构迁移深度咬合,开发效率无可替代;但如果你试图将其抽离到独立微服务或 FastAPI 项目中,其沉重的生态依赖将变成负资产。
- SQLAlchemy(推荐 2.0+): Python 工业级后端事实上的通用标准。采用 Data Mapper 模式与 Unit of Work 模式,严格将对象映射与底层 SQL 编译引擎解耦,拥有最完备的类型提示支持、异步生态(asyncio)以及最高级别的 SQL 精细掌控力,专为复杂业务、多数据源和企业中后台系统打造。
- Peewee: 专注轻量、表达直观的“微型”ORM。如果你正在构建 CLI 工具、基于 Flask/Bottle 的轻量级服务、嵌入式 SQLite 应用,或者希望在半小时内掌握全部核心用法并投入生产,Peewee 兼顾了类似 Django 的直观语法与极致的运行效率。
二、核心架构与设计哲学解构
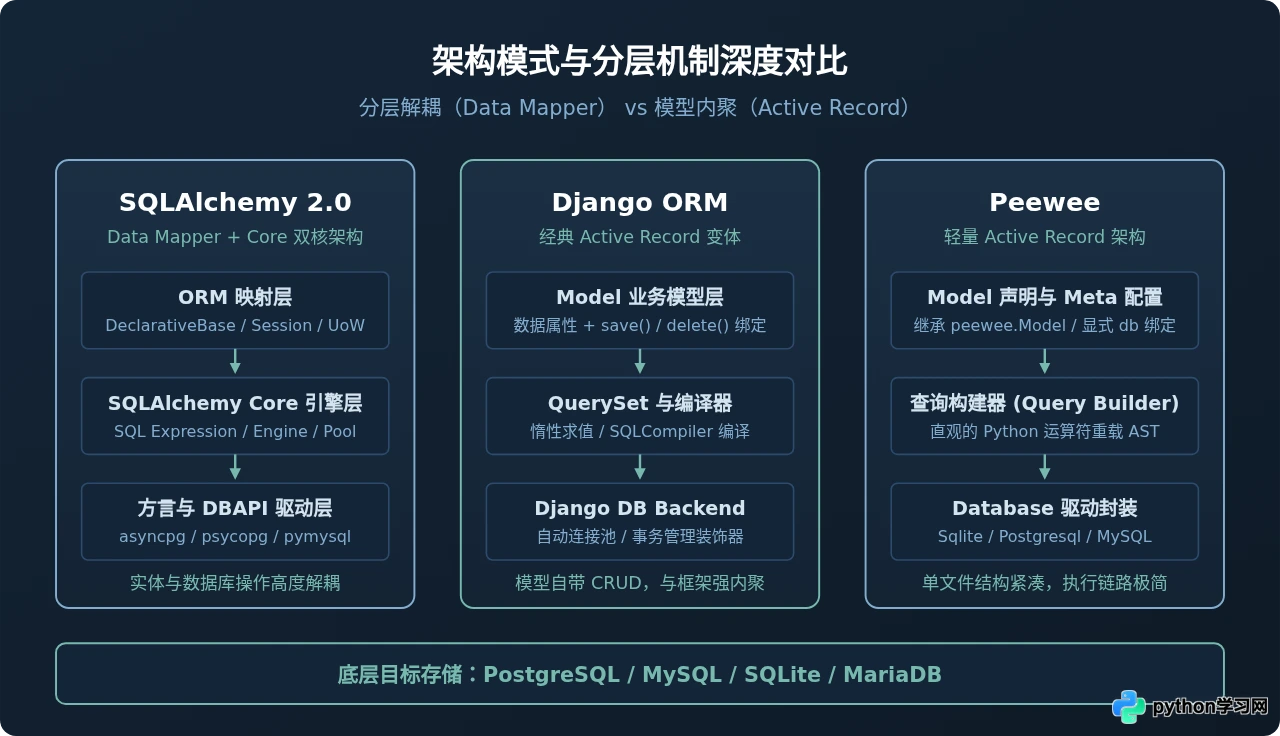
理解三大框架的差异,首先必须剖析它们在设计模式层面的根本分歧。ORM 的核心问题是如何在“面向对象的业务模型”与“关系型数据库的二维表”之间架设桥梁,而这三者给出了两种截然不同的架构答卷:Data Mapper(数据映射器)模式 与 Active Record(活动记录)模式。
1. SQLAlchemy 的 Data Mapper 哲学
SQLAlchemy 坚持“内存中的领域对象不应该关心自己如何存入数据库”。在 SQLAlchemy 2.0 中,数据模型类(通过 DeclarativeBase 声明)纯粹是领域数据容器,它本身并不包含 save() 或 delete() 等直接持久化方法。数据的增删改查完全交由外部的 Session(工作单元 Unit of Work) 负责调度。
这种分离的好处在于:业务逻辑与数据存储解耦,你可以在没有活动数据库连接的情况下自由实例化、传递和测试对象;同时,Session 会追踪所有实体状态变化,在事务提交(commit)时以最优的 SQL 批处理顺序执行,有效减少数据库往返延迟。
2. Django ORM 的 Active Record 实用主义
Django ORM 遵循经典的 Active Record 理念:一个模型类对应一张数据库表,一个模型实例对应表中的一行记录,同时该实例直接附带所有数据库持久化能力。在 Django 中,调用 user.save() 即可直接把当前实例写回数据库。
这种模式具有极高的直觉性和开发效率,极大降低了团队初期的理解门槛。然而它的代价在于紧耦合:模型实例与全局数据库连接强绑定,如果模型脱离了 Django 的生命周期上下文(如多线程、后台独立任务),连接管理与事务边界控制会变得相对隐晦。
3. Peewee 的精简化折中
Peewee 在架构上与 Django ORM 高度相似,同属 Active Record 派系,但它去除了 Django 庞大的组件包袱。Peewee 的核心代码极其凝练,模型通过内部 Meta 类显式指定绑定的数据库对象,既保证了 user.save() 的敏捷体验,又允许开发者以极小的成本手动切换数据库连接与管理事务上下文。
三、核心操作步骤与代码实现对比
在实际工程中,从定义实体模型到完成一次复杂的关联查询,通常需要经历五个严谨的步骤。下面以一个包含“用户(User)”与“文章(Article)”一对多关系的典型场景,完整展示三者在各个步骤中的具体代码实现与调用差异。
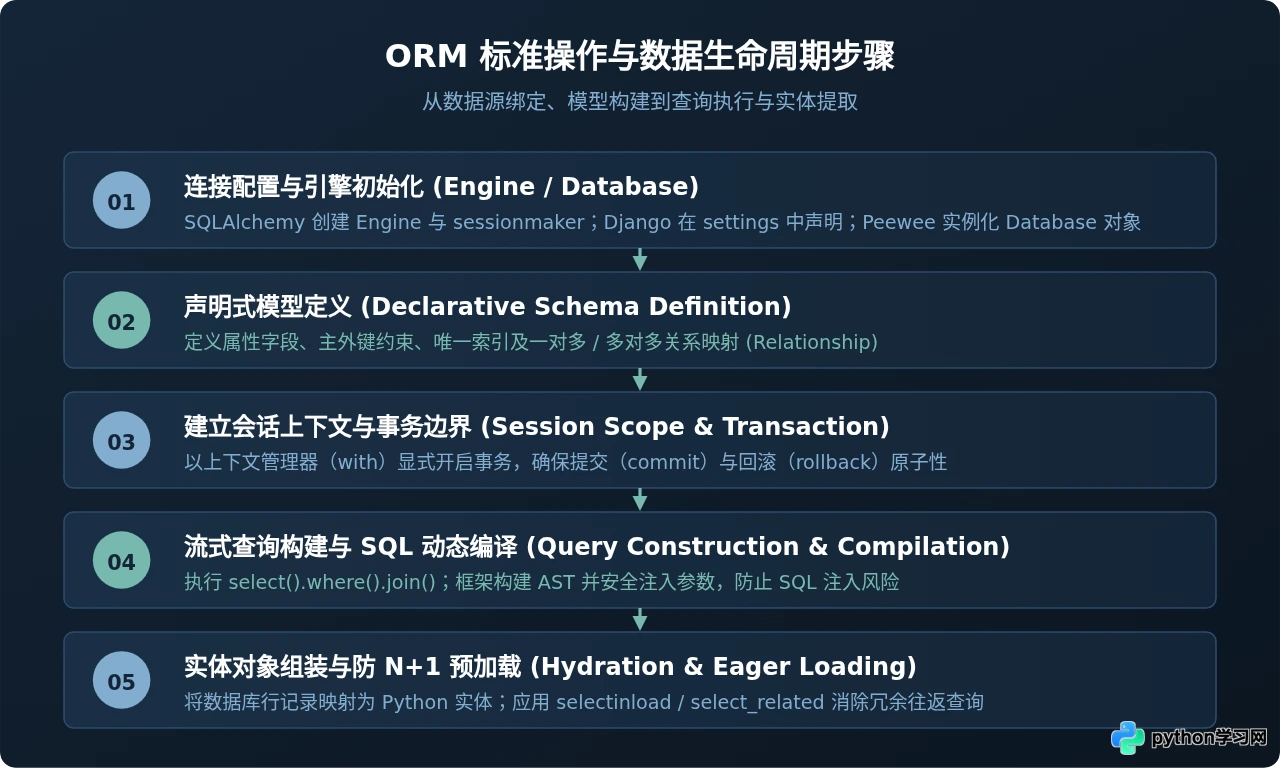
步骤 1 & 2:模型定义与字段映射对比
在 SQLAlchemy 2.0 中,官方引入了基于 Python 3.10+ 类型注解(Type Hints)的 Mapped 与 mapped_column 语法,使得 IDE 的自动补全与静态检查(Mypy)体验达到顶级:
# 1. SQLAlchemy 2.0 现代语法
from typing import List
from sqlalchemy import String, ForeignKey, create_engine
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, relationship

class Base(DeclarativeBase):
    pass

class User(Base):
    __tablename__ = "users"
    id: Mapped[int] = mapped_column(primary_key=True)
    username: Mapped[str] = mapped_column(String(50), unique=True)
    articles: Mapped[List["Article"]] = relationship(back_populates="author")

class Article(Base):
    __tablename__ = "articles"
    id: Mapped[int] = mapped_column(primary_key=True)
    title: Mapped[str] = mapped_column(String(100))
    user_id: Mapped[int] = mapped_column(ForeignKey("users.id"))
    author: Mapped["User"] = relationship(back_populates="articles")

engine = create_engine("sqlite:///app.db", echo=False)
Base.metadata.create_all(engine)
在 Django ORM 中,定义极其紧凑,且无需手动执行表创建,完全交由 makemigrations 命令处理:
# 2. Django ORM 语法
from django.db import models

class User(models.Model):
    username = models.CharField(max_length=50, unique=True)

class Article(models.Model):
    title = models.CharField(max_length=100)
    author = models.ForeignKey(User, on_delete=models.CASCADE, related_name="articles")
在 Peewee 中,模型继承自 peewee.Model,并在 Meta 内部类中指明数据库连接:
# 3. Peewee 语法
from peewee import SqliteDatabase, Model, CharField, ForeignKeyField

db = SqliteDatabase("app.db")

class BaseModel(Model):
    class Meta:
        database = db

class User(BaseModel):
    username = CharField(max_length=50, unique=True)

class Article(BaseModel):
    title = CharField(max_length=100)
    author = ForeignKeyField(User, backref="articles")

db.connect()
db.create_tables([User, Article])
步骤 3 & 4:数据插入与复杂关联查询
面对“查询某个用户下所有标题包含 'Python' 的文章”这一典型业务需求,三者的查询构造语法体现了明显的风格取舍:
# 1. SQLAlchemy 2.0 (显式、类型安全、语法严谨)
from sqlalchemy import select
from sqlalchemy.orm import Session, selectinload

with Session(engine) as session:
    # 构造 select 语句对象,配合 selectinload 解决 N+1 预加载
    stmt = (
        select(User)
        .options(selectinload(User.articles))
        .where(User.username == "alex")
    )
    user = session.scalars(stmt).first()
    if user:
        for article in user.articles:
            if "Python" in article.title:
                print(article.title)

# 2. Django ORM (基于双下划线的链式过滤,表达式极简)
# 使用 prefetch_related 进行一对多反向关联的批量加载
users = User.objects.filter(
    username="alex",
    articles__title__contains="Python"
).prefetch_related("articles")

# 3. Peewee (Pythonic 的运算符重载,直观自然)
# Peewee 使用 >> 或 ==,连接使用 join 显式声明
query = (
    Article.select(Article, User)
    .join(User)
    .where((User.username == "alex") & (Article.title.contains("Python")))
)
for article in query:
print(article.title)避坑提示:在 ORM 开发中,最普遍的性能杀手是 N+1 查询问题(即遍历 N 条主表记录时,每次访问关联属性都触发一次独立的 SQL 查询)。SQLAlchemy 必须显式搭配 selectinload 或 joinedload;Django 使用 select_related(单值外键)与 prefetch_related(多值关联);Peewee 则提供 prefetch() 辅助方法。在编写任何循环访问关联属性的代码前,务必核查对应的预加载策略。
四、数据库迁移、异步与生态集成
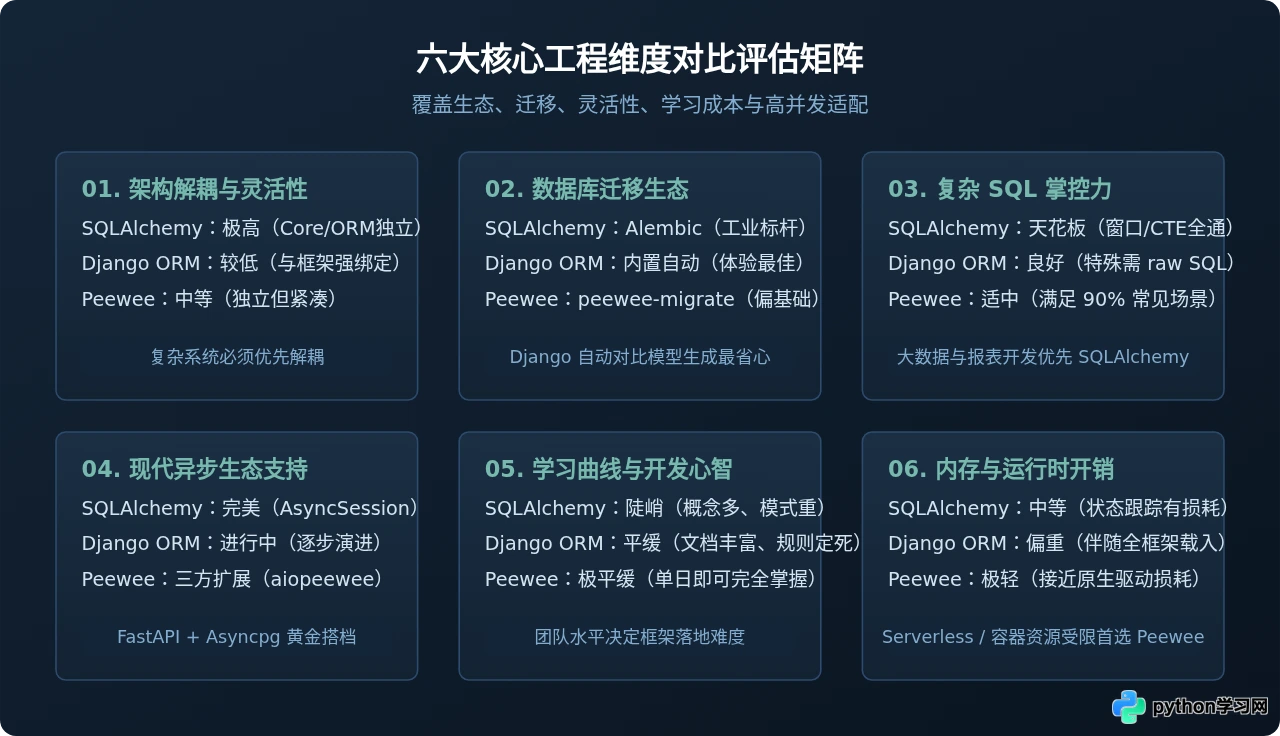
评估一个数据库框架,绝不能只看代码写起来是否舒服,更要考察其在生产环境长期演化中的周边工具链支撑:
1. 数据库迁移(Migration)的成熟度差异
生产系统必然伴随表结构的持续演进。在这一点上:
- Django Migrations: 无疑拥有全 Python 生态中体验最顺滑的迁移体验。只需修改
models.py,运行python manage.py makemigrations,Django 会自动通过模型历史依赖图对比生成精确的迁移文件,连外键重命名和默认值处理都能智能提示。 - Alembic(SQLAlchemy 生态): 工业级标准的迁移工具。支持自动对比模型元数据与当前数据库 schema 生成修订脚本(
alembic revision --autogenerate),但对于复杂的列类型变更或枚举转换,往往需要工程师手动检查并补充 SQL 逻辑。其分支迁移合并机制极其健壮,适合大型团队多人协作。 - peewee-migrate: 能够完成基础的新增表、增删列操作,但在面对复杂外键约束变更、复合索引调整时,自动化能力有限,经常需要编写原生 DDL 补充执行。
2. 异步生态(Asyncio)的适配现状
随着以 FastAPI、Sanic 为代表的高并发异步 Web 框架兴起,ORM 的异步能力成为关键考核点:
- SQLAlchemy 2.0: 原生构建了完整的
AsyncEngine与AsyncSession接口,底层可无缝对接asyncpg(PostgreSQL 极速异步驱动)与aiomysql,真正做到无阻塞 I/O,是现代异步微服务的黄金标配。 - Django ORM: 从 Django 3.0 开始逐步引入异步支持,但目前仍处于演进阶段(如
auser.asave(),async for)。底层部分数据库后端在异步上下文中仍依赖同步转异步适配层(sync_to_async),容易产生线程池调度开销。 - Peewee: 核心设计完全基于同步阻塞 I/O。虽然社区提供了
aiopeewee或peewee-async包装库,但维护活跃度较低,若项目强依赖高并发异步,不建议作为主要选择。
| 对比指标 | SQLAlchemy 2.0 | Django ORM | Peewee |
|---|---|---|---|
| 核心模式 | Data Mapper + Unit of Work | Active Record | Active Record |
| 解耦程度 | 完全解耦(可独立运行于任何环境) | 与 Django Web 框架强绑定 | 完全解耦(单文件微型内核) |
| 类型注解支持 | 卓越(Mapped / mapped_column) | 良好(需配合 django-stubs) | 基础(无深度静态推断) |
| SQL 掌控上限 | 极高(Core 拥有近乎原生灵活性) | 较高(受限于 QuerySet API 边界) | 中等(覆盖常规 CRUD 与常见 JOIN) |
| 数据库迁移 | Alembic(高度可靠、支持多分枝) | 内置 Migration(高度自动化) | peewee-migrate(功能偏基础) |
| 原生异步支持 | 原生完备(AsyncSession + asyncpg) | 渐进演进(部分操作仍需同步桥接) | 需依赖第三方包装库 |
| 适用工程体量 | 中大型微服务、企业级复杂中后台 | 全栈标准 Web 应用、内容管理系统 | 轻量脚本、CLI 工具、小型微服务 |
五、生产级选型决策指南与落地建议
选型不是盲目追求“功能最强”或“代码最少”,而是根据团队背景、系统规模、既有技术栈以及性能边界做出最稳妥的权衡。为了帮助开发者迅速落地,以下整理出清晰的决策分支流程图:
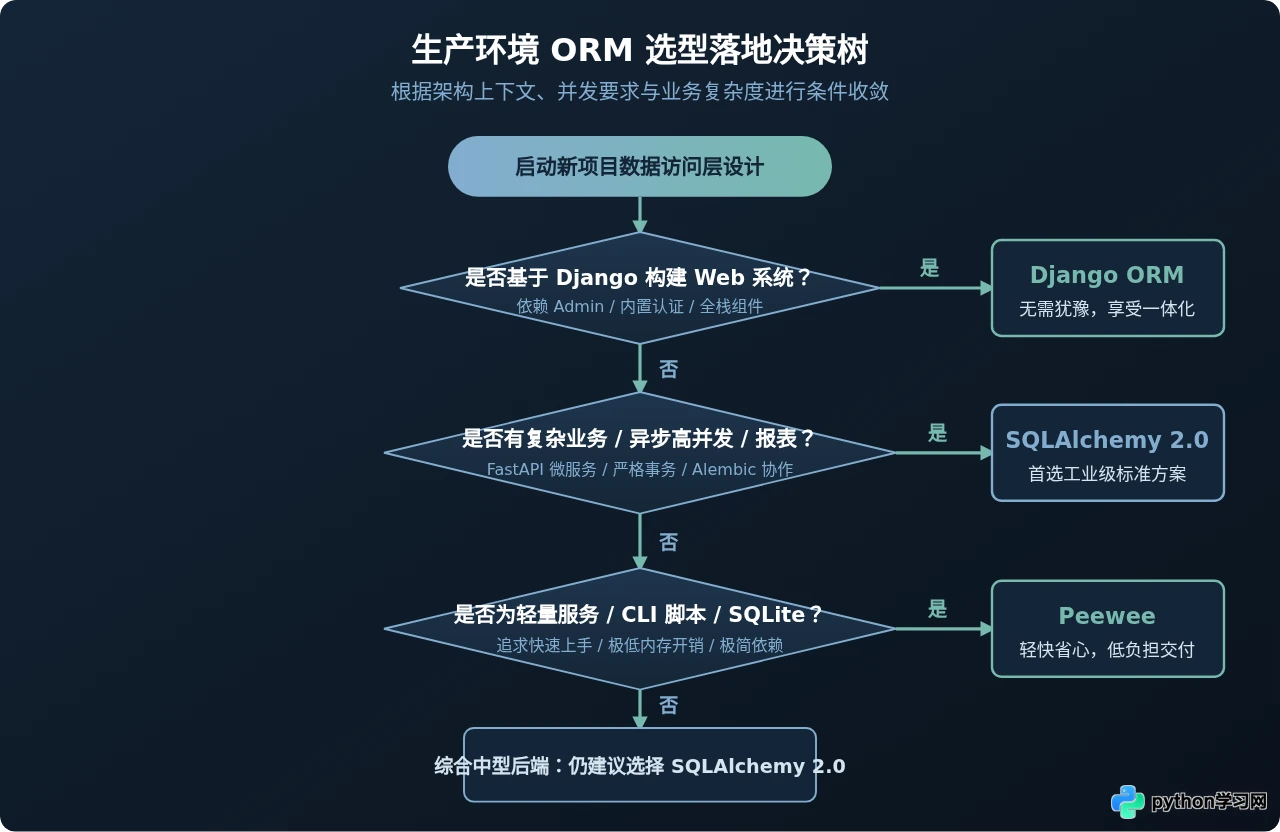
最终选型执行建议:
- 拒绝“过度剥离”Django ORM: 如果项目已经确定选用 Django 作为主框架,不要自讨苦吃去强行替换为 SQLAlchemy。Django 内置的迁移机制、表单验证器与后台管理系统的生产力优势远超过单一 ORM 细微的架构纯粹性。
- FastAPI / Flask 微服务默认对标 SQLAlchemy 2.0: 不要被 SQLAlchemy 1.x 时代的陈旧教程误导。升级到 2.0 后的 SQLAlchemy 凭借类型注解、
select()构造器以及原生的AsyncSession,与 Pydantic v2 和现代异步框架结合得天衣无缝,是可维护性最高的方案。 - 善用 Peewee 构建边缘与运维支撑工具: 当需要编写数据库数据迁移临时脚本、离线数据分析工具、桌面端 SQLite 读写软件,或者部署在极其严苛的轻量容器环境时,Peewee 几乎零心智负担的优势会让开发过程异常轻松。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















