


Python新手必学的8个标准库及核心函数用法
针对Python初学者精选的8个基础标准库全面解析,涵盖核心函数用法、运行代码示例与避坑指南,无需额外安装第三方包即可掌握常用开发能力。
Python被称为“开箱即用”(Batteries Included)的编程语言,其核心原因就在于随解释器一同打包的丰富标准库。很多初学者在需要处理文件、日期或数据时,习惯直接在命令行执行 pip install 下载第三方依赖,不仅增加了项目运行的环境负担,也容易因为引入过多外部包而产生兼容问题。本文梳理了初学阶段最常用、实用价值最高的8个原生标准库,讲解其核心函数与真实业务场景下的使用方式。
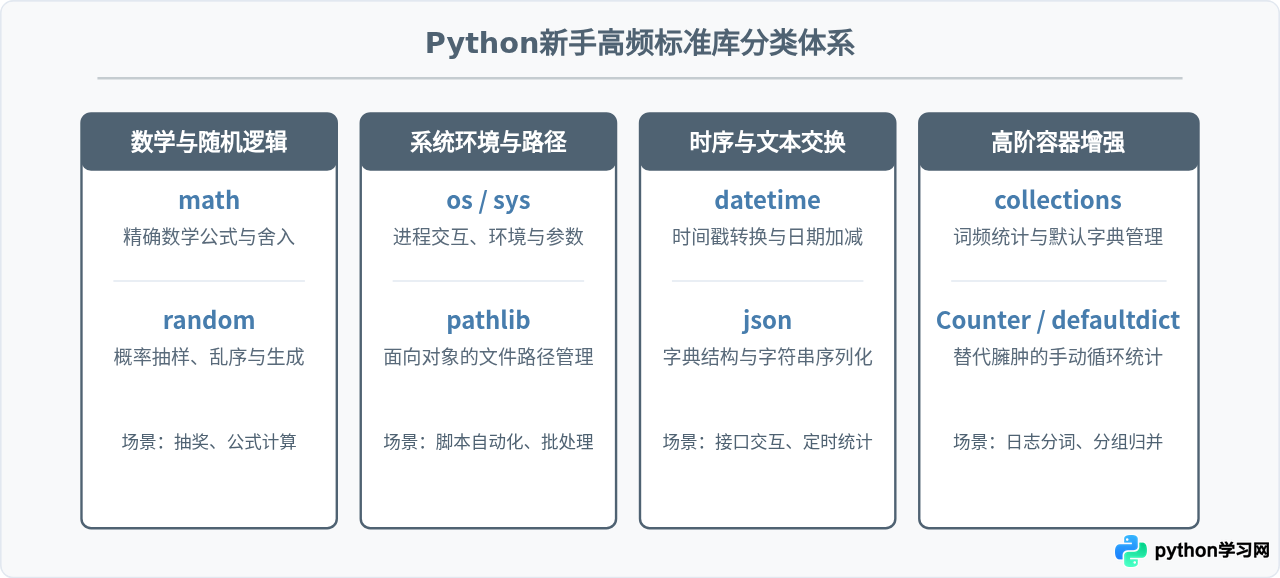
1. math:标准数学运算与边界处理
日常写代码时,内置的 +、-、*、/ 只能完成四则运算。当遇到向上取整、开平方或处理浮点数边界时,math 提供了经过 C 语言底层加速的标准化函数。
核心函数与代码演示
import math

# 1. 向上取整 (ceil) 与 向下取整 (floor)
order_count = 105
page_size = 20
total_pages = math.ceil(order_count / page_size)  # 6页

# 2. 开平方
root = math.sqrt(64)  # 8.0

# 3. 浮点数精确相加 (避免 0.1 + 0.2 != 0.3 的精度溢出陷阱)
values = [0.1] * 10
sum_val = math.fsum(values) # 1.0总页数: 6
精确累加和: 1.0
math 库中的所有函数仅支持普通的实数运算。如果需要处理复数(虚数),应该导入对应的 cmath 库,否则传入负数开根号会抛出 ValueError。
2. random:伪随机数生成与数据采样
在模拟数据、随机生成测试用例或打乱序列顺序时,random 是首选库。该库基于梅森旋转算法(Mersenne Twister)实现,适合常规开发任务。
核心函数与代码演示
import random

# 1. 生成指定范围内的随机整数 (包含左右端点 1 和 10)
random_id = random.randint(1, 10)

# 2. 从列表中随机抽取一个元素
prizes = ["代金券", "免单", "积分50", "谢谢参与"]
lucky_one = random.choice(prizes)

# 3. 不放回抽样 (从候选池中选出 k 个不重复的值)
sampled_items = random.sample(prizes, k=2)

# 4. 原地打乱列表顺序 (修改原列表,返回 None)
deck = [1, 2, 3, 4, 5]
random.shuffle(deck)random 生成的是伪随机数,只要获取到随机种子就可以推导后续数值。在涉及密码、登录令牌(Token)或支付验证码等安全性要求较高的场景中,必须使用 secrets 模块替代 random。
3. datetime:日期时间处理与时间戳转换
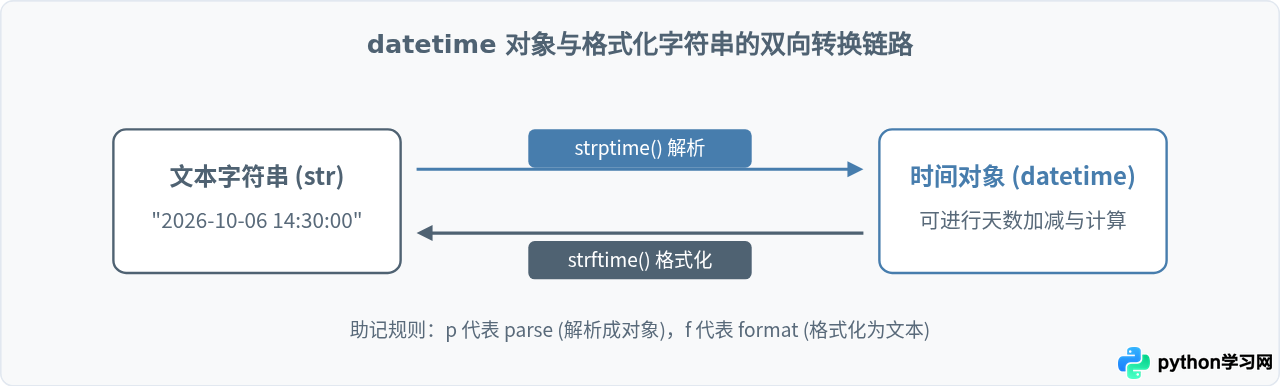
程序开发经常要记录事件发生时间、计算两个事件之间间隔的天数或转换时间格式。datetime 是控制时间维度的核心组件。
核心函数与代码演示
from datetime import datetime, timedelta

# 1. 获取当前系统时间
now = datetime.now()

# 2. 将字符串解析为 datetime 对象 (strptime)
date_str = "2026-10-06 08:30:00"
dt_obj = datetime.strptime(date_str, "%Y-%m-%d %H:%M:%S")

# 3. 将 datetime 对象格式化为字符串 (strftime)
clean_date = now.strftime("%Y年%m月%d日 %H点")

# 4. 时间加减运算 (timedelta)
tomorrow = now + timedelta(days=1)
three_hours_ago = now - timedelta(hours=3)当前格式化输出: 2026年10月06日 23点
明日此时: 2026-10-07 23:44:21
4. pathlib:现代化文件与路径管理
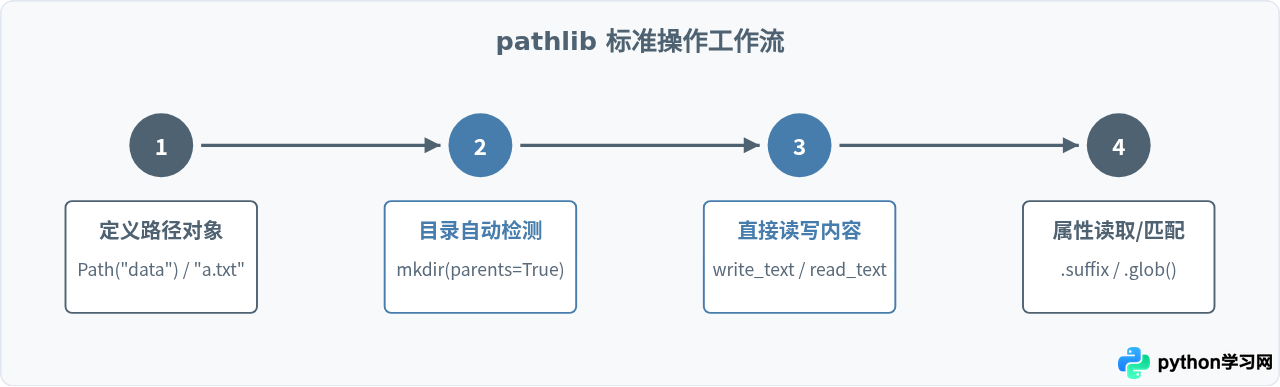
传统的 os.path 操作路径需要不断嵌套函数,代码冗长且不同系统的路径分隔符(Windows 为 \,Linux 为 /)容易引发错误。Python 3.4 引入的 pathlib 提供了面向对象的路径处理方式,完全支持斜杠操作符。
核心函数与代码演示
from pathlib import Path

# 1. 跨平台拼接路径 (使用 / 运算符代替 os.path.join)
base_dir = Path("my_project")
target_file = base_dir / "logs" / "app.log"

# 2. 递归创建父级目录 (如果存在则忽略异常)
target_file.parent.mkdir(parents=True, exist_ok=True)

# 3. 快速写入与读取纯文本 (不需要手动写 with open)
target_file.write_text("系统已启动", encoding="utf-8")
content = target_file.read_text(encoding="utf-8")

# 4. 获取文件关键信息
print(target_file.name)    # 输出: app.log
print(target_file.suffix)  # 输出: .log
print(target_file.exists())# 输出: Truewrite_text() 和 read_text() 在 Windows 下默认采用本地编码(如 GBK),读写中文时务必手动显式指定 encoding="utf-8"。
5. os:操作系统层面的环境与目录交互
虽然单路径操作推荐 pathlib,但在涉及读取系统环境变量、执行终端命令以及批量遍历多层文件夹时,os 仍然是无可替代的核心标准库。
核心函数与代码演示
import os

# 1. 读取系统环境变量 (如果不存在则返回预设默认值)
db_host = os.environ.get("DATABASE_HOST", "127.0.0.1")

# 2. 获取当前脚本工作路径
current_dir = os.getcwd()

# 3. 遍历目录树 (获取目录下的全部子文件)
for root, dirs, files in os.walk("."):
    for file in files:
        if file.endswith(".py"):
full_path = os.path.join(root, file)os;需要对具体某个路径进行创建、重命名、截取后缀时推荐使用 pathlib。
6. sys:解释器与运行环境交互
sys 模块负责维护与 Python 解释器本身的通信。当你的脚本需要在命令行接收参数,或者需要在特定条件下主动终止程序时,就需要使用该模块。
核心函数与代码演示
import sys

# 1. 获取命令行传递进来的参数列表
# 运行命令: python main.py upload test.txt
print("传入的所有参数:", sys.argv)
# sys.argv[0] 是脚本名称 'main.py'
# sys.argv[1] 是第一个外部参数 'upload'

# 2. 查看当前 Python 模块搜索路径列表
# 可通过 sys.path.append("自定义模块目录") 引入不在同级的文件
print("模块查找路径数量:", len(sys.path))

# 3. 主动安全终止退出 (返回退出码 0 表示正常,非0表示异常)
if len(sys.argv) < 2:
    print("错误:未提供必要的操作指令")
    sys.exit(1)
7. json:结构化数据与文本的序列化互转
网络请求返回的数据包或软件的配置文件大多以 JSON(JavaScript Object Notation)格式存储。json 库能在 Python 原始数据类型(字典、列表)与 JSON 字符串之间高效转换。
核心函数与代码演示
import json

user_info = {
    "name": "李强",
    "role": "admin",
    "active": True,
    "tags": ["Python", "后端"]
}

# 1. 字典转 JSON 字符串 (dumps)
# ensure_ascii=False 确保中文字符不被转码为 \uXXXX
# indent=2 设置缩进排版,提高可读性
json_str = json.dumps(user_info, ensure_ascii=False, indent=2)

# 2. JSON 字符串还原为 Python 字典 (loads)
parsed_dict = json.loads(json_str)

# 3. 直接将数据写入 json 文件 (dump) 与 读取文件 (load)
with open("config.json", "w", encoding="utf-8") as f:
    json.dump(user_info, f, ensure_ascii=False, indent=2)

with open("config.json", "r", encoding="utf-8") as f:
data_from_file = json.load(f)dumps / loads 中的 's' 代表 string,负责内存中字符串对象的转换;而 dump / load 负责接收文件流指针(File Object),用于读写磁盘文件。
8. collections:高性能专业数据结构容器
Python 原生内置了列表(list)、字典(dict)和元组(tuple),但在某些高频场景下,原生结构需要写很多样板代码。collections 提供了开箱即用的专业容器,其中最实用的就是计数器 Counter 与默认字典 defaultdict。
核心函数与代码演示
from collections import Counter, defaultdict

# 1. 自动计数统计 (Counter)
words = ["apple", "banana", "apple", "orange", "apple", "banana"]
word_counts = Counter(words)
print(word_counts["apple"])        # 3
print(word_counts.most_common(1))  # 出现频次最高的元素: [('apple', 3)]

# 2. 避免 KeyError 的默认字典 (defaultdict)
# 传统 dict 在遇到不存在的 key 时执行 append 会抛错,而 defaultdict 会自动初始化对应类型的默认值
student_groups = defaultdict(list)
student_groups["一班"].append("小明")
student_groups["一班"].append("小红")
student_groups["二班"].append("小华")

print(dict(student_groups))apple 频次: 3
分组结果: {'一班': ['小明', '小红'], '二班': ['小华']}
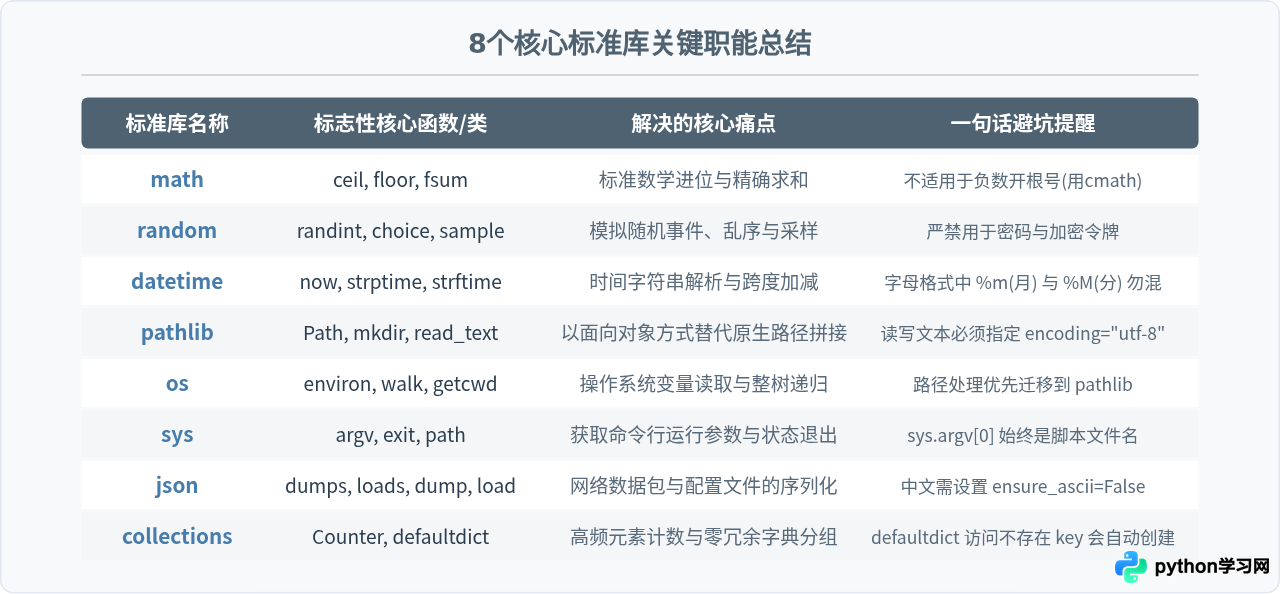
总结与日常学习建议
掌握这8个标准库的核心用法,足以应对日常脚本开发中 80% 以上的基础数据组织和环境交互需求。在实际编写代码时,可以先查阅官方标准库是否自带解决方案,再决定是否引入外部第三方模块。这样不仅能保持代码轻量、减少依赖冲突,也能让你的 Python 代码更加规范和地道。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















