


Python新手适合做哪些副业?自动化脚本与数据清洗接单指南
针对Python初学者梳理适合入手的副业方向,重点聚焦办公自动化脚本与数据清洗两类需求,提供技术要求、交付规范、接单渠道及风险防范实用指南。
Python初学者做副业,最现实的切入点不是周期长、逻辑复杂的商业系统开发,而是目标明确、交付周期短的“办公自动化脚本”与“表格数据清洗”。这类需求通常解决特定岗位的重复机械劳动,输入输出边界清晰,代码规模往往在几十行到数百行之间。本文将拆解适合新手的具体业务场景、掌握关键库的实际要求、标准交付规范,以及从接单沟通到规避风险的完整流程。
新手为什么应当聚焦自动化与数据清洗?
初学者在寻找编程兼职时,容易被网站全栈开发、自动化爬虫或机器学习等方向吸引。这些领域虽然单价相对较高,但对新手而言存在显著劣势:Web开发涉及前后端协同、数据库维护、生产环境部署和长期安全性;爬虫开发面临反爬机制升级、IP代理池成本与明确的数据合规法律边界;算法类任务则需要深厚的数学功底与模型调优经验。
相比之下,自动化脚本与数据清洗任务具备三个契合初学者的特征:
- 业务逻辑简单可控:客户通常会提供固定格式的原始文件(如Excel、CSV、Word或PDF),并明确要求产出格式。输入与输出之间往往只是数据过滤、合并、拆分或格式重构。
- 排错边界狭窄:处理的主要是客户本地环境下的静态数据,不依赖复杂的外部网络交互或高并发架构,绝大多数Bug可以通过查看控制台错误信息快速定位。
- 交付周期极短:多数单子能在1至3天内完成测试并交付,沟通链路短,资金结算周期也更平稳。
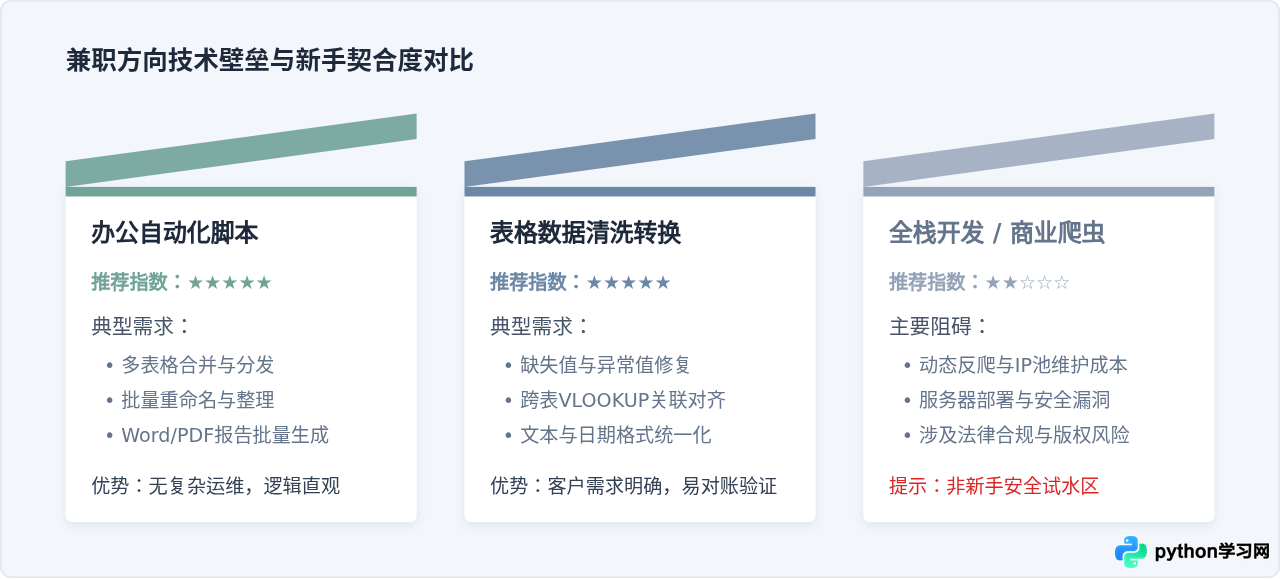
图1:常见兼职技术方向的新手匹配度与难度结构对比
必须掌握的核心技术栈清单
承接这两类任务,并不需要将Python所有内置模块与第三方工具倒背如流。重点是熟练运用几个专门处理表格、文件系统以及文本格式的成熟第三方库。
1. 表格与数据核心:pandas 与 openpyxl
pandas 是完成数据清洗的主力工具。新手必须掌握它的基础切片、按条件过滤(如剔除负数、筛选特定部门)、分组统计(groupby)、多表关联(merge)以及缺失值处理(fillna/dropna)。
openpyxl 主要用于对输出格式有特定样式要求的场景。当客户提出“保留原有表格的单元格背景色”、“设置特定表头字体”、“自动调整列宽”或“写入公式”时,单纯使用 pandas.to_excel 往往无法直接满足,需要通过 openpyxl 对生成的 Excel 文件做进一步样式补充。
2. 系统文件与自动化:os, pathlib 与 shutil
处理几十个甚至上百个零散文件时,自动化脚本需要准确找到目标。熟悉 Python 标准库中的 pathlib.Path 或 os.walk,能够实现对多层嵌套文件夹的遍历、匹配特定后缀(如 .xlsx、.csv)、提取文件名中的日期或编号,并使用 shutil 实现自动归档和重命名。
3. 文档批量填充:python-docx 与 pypdf
常见的行政、财务需求包括:根据 Excel 里的上百位员工信息,逐一生成聘用合同、通知单或发票汇总;或者将多页 PDF 文件按照特定规则切分并按工号命名。掌握基于模板占位符的 python-docx 文本替换,能覆盖大部分文书批量制作需求。
典型需求实战拆解
理解具体任务最好的方式是查看实际接单中常见的业务场景。以下给出“多表合并并去除脏数据”的完整处理流程与脚本示例。
需求场景:多分支机构日报批量汇总与格式清洗
某零售业务需要每月汇总30个门店提交的销售日报。常见的问题包括:
- 每个门店的文件命名存在差异(如“A店销售7月.xlsx”、“7月-B店日报.xlsx”)。
- 表头行数可能因人而异,有的第1行是标题,有的直接从第2行开始。
- 部分销售额列混入了逗号分隔符或空格(如
" 1,280.00 "),导致无法以数值求和。 - 存在重复录入行与全空行。
# 完整合并清洗示例脚本
import os
import glob
import pandas as pd

def clean_and_merge(input_folder, output_filepath):
    # 匹配目标目录下所有.xlsx文件
    search_pattern = os.path.join(input_folder, "*.xlsx")
    files = glob.glob(search_pattern)

    if not files:
        print("未在目标文件夹内找到任何 Excel 文件。")
        return False

    all_data = []

    for file_path in files:
        try:
            # 读取文件,指定header为0或根据实际情况跳过标题行
            df = pd.read_excel(file_path)

            # 基础结构校验:确保核心字段存在
            required_columns = ["门店名称", "销售日期", "商品名称", "销售金额"]
            if not all(col in df.columns for col in required_columns):
                print(f"跳过格式不规范文件: {os.path.basename(file_path)}")
                continue

            # 提取所需列,丢弃多余杂项列
            sub_df = df[required_columns].copy()
            all_data.append(sub_df)
        except Exception as e:
            print(f"读取文件出错 {file_path}: {e}")

    if not all_data:
        print("无可合并的有效数据。")
        return False

    # 纵向合并所有数据表
    merged_df = pd.concat(all_data, ignore_index=True)

    # 数据清洗步骤 1: 移除完全空白的行
    merged_df.dropna(how="all", inplace=True)

    # 数据清洗步骤 2: 清洗“销售金额”列中的字符串空格与千分位逗号,转为浮点数
    if merged_df["销售金额"].dtype == object:
        merged_df["销售金额"] = (
            merged_df["销售金额"]
            .astype(str)
            .str.replace(",", "", regex=False)
            .str.strip()
        )
        merged_df["销售金额"] = pd.to_numeric(merged_df["销售金额"], errors="coerce")

    # 数据清洗步骤 3: 填充异常缺失值,并去重
    merged_df["销售金额"] = merged_df["销售金额"].fillna(0.0)
    merged_df.drop_duplicates(inplace=True)

    # 格式化日期列,统一格式为 YYYY-MM-DD
    merged_df["销售日期"] = pd.to_datetime(merged_df["销售日期"], errors="coerce").dt.strftime("%Y-%m-%d")

    # 导出到指定目标
    merged_df.to_excel(output_filepath, index=False)
    print(f"清洗合并完成,共输出有效记录 {len(merged_df)} 条,保存至: {output_filepath}")
    return True

# 本地执行演示(运行前确保对应目录已创建)
if __name__ == "__main__":
    SOURCE_DIR = "./data_inputs"
    TARGET_FILE = "./汇总清洗结果.xlsx"
    clean_and_merge(SOURCE_DIR, TARGET_FILE)
终端执行后的标准输出反馈示例:
[输出示例]
读取文件出错 ./data_inputs/临时草稿.xlsx: [Errno 13] Permission denied
清洗合并完成,共输出有效记录 1420 条,保存至: ./汇总清洗结果.xlsx
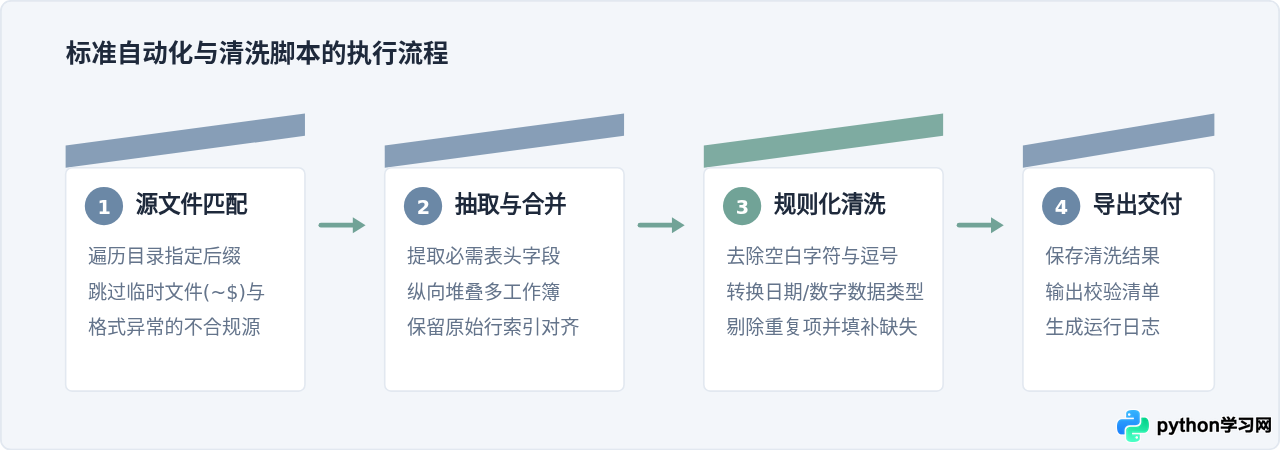
图2:自动化数据清洗脚本在内存中的四个核心处理节点
新手交付的关键门槛:非程序员客户如何使用?
编写好 Python 脚本只是完成了工作的一半。大多数付费客户是非技术人员(如行政、文员、财务、运营或电商卖家),他们的电脑上通常没有安装 Python 环境,更不会在命令行中通过 pip 安装第三方依赖。
如果仅仅给客户发一个 .py 文件,往往会导致大量的售后调试摩擦,例如“提示 Python 不是内部命令”、“缺少 pandas 模块”或“一闪而过无法打开”。因此,交付格式决定了接单的效率与客户满意度。
交付方案 A:只交付最终清洗好的“成品数据”
如果客户的需求属于一次性整理,例如“手头有80个表格,帮我合并洗好就行,以后不需要重复跑”。这类单子最适合新手:你只需在自己本地电脑上运行脚本,把清洗好的 Excel 或 CSV 文件发给客户即可,完全不需要考虑环境兼容性与打包问题。
交付方案 B:打包为独立执行程序(.exe)
当客户需要周期性使用该工具时(如每周自己跑一次),通常需要使用 PyInstaller 进行打包。
# 在虚拟环境下安装 PyInstaller
pip install pyinstaller

# 打包为单文件控制台程序,避免客户电脑配置Python运行环境
pyinstaller -F merge_tool.py
1. 避免在代码中写死类似 C:\Users\Administrator\... 的绝对路径。应当使用 os.path.dirname(os.path.abspath(__file__)) 或 pathlib.Path.cwd(),让程序默认读取当前目录下的文件。
2. 单文件打包(-F)在初次启动时会有几秒钟解压时间,且偶尔会被Windows Defender误报阻拦。在交付给客户时,必须附带一份简洁的《使用说明.txt》,写明放文件的文件夹名称、启动方式及防毒软件信任提示。
接单渠道与全流程沟通规范
新手起步阶段,获取前三个真实客户至关重要。建议按照“低门槛渠道积累经验,再过渡到熟人网络或专业众包平台”的节奏推进。
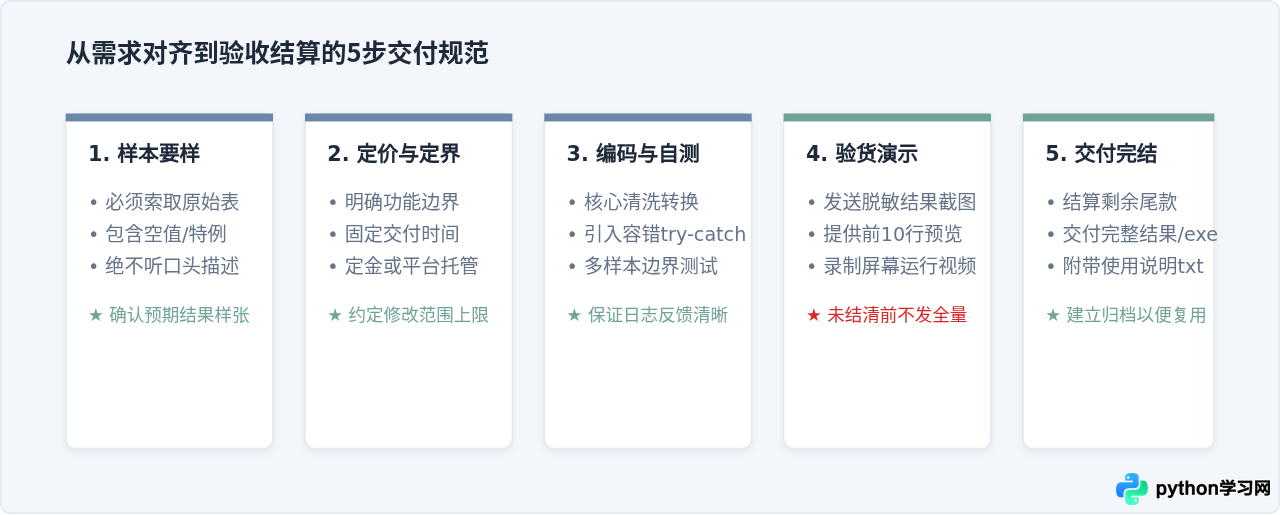
图3:防止烂尾、返工与纠纷的标准接单交付流程
主要渠道分布与起步策略
| 渠道分类 | 平台/形式 | 客单价区间 | 适用阶段与特点 |
|---|---|---|---|
| 二手交易平台 | 闲鱼、转转等 | 30元 - 150元 | 适合练手初期。需求零碎,沟通直接,能迅速体会真实用户的痛点。 |
| 专业外包众包 | 猪八戒、程序员客栈、码市等 | 200元 - 800元 | 需要有成熟作品展示,竞争相对激烈,适合具备独立封装与打包能力之后。 |
| 内容引流与社群 | 小红书、B站等平台分享案例 | 100元 - 500元 | 发布“批量处理Excel技巧”等真实案例短篇,吸引有同类痛点的职场人员主动咨询。 |
必须严格规避的风险与注意事项
进行技术副业时,保证安全与精力收益比同样重要。以下四条规则需要在接单时始终坚守:
- 严禁触碰数据爬虫的灰色边界:任何涉及绕过登录验证、批量获取平台用户敏感隐私信息、破坏接口访问频次限制或用于灰黑产转售的爬虫任务,绝不承接。
- 绝不轻信“口头无歧义”:客户如果说“很简单,就是把表格规整一下”,绝不能直接答应报价。必须要求对方提供1-2份包含真实极端情况的脱敏样本文件,并明确给出一张人工制作的“理想产出表格样式”。缺少这两项,后续极易发生扯皮。
- 验收环节做好防跑单防线:在客户支付全部费用前,不要将全量清洗完的 Excel 文件或完整的源代码直接发送。可以通过提供清洗前后的前10行截图、操作视频,或先交付打乱了顺序的部分脱敏预览数据。
- 代码必须包含基础的容错日志:新手常犯的错误是没有写
try...except。一旦遇到某个单元格写了乱码字符导致程序崩溃,客户在没有控制台提示的情况下只能认为程序失效。在每个关键环节打印出中文执行进度和明确的跳过提示,能避免大量不必要的售后沟通。
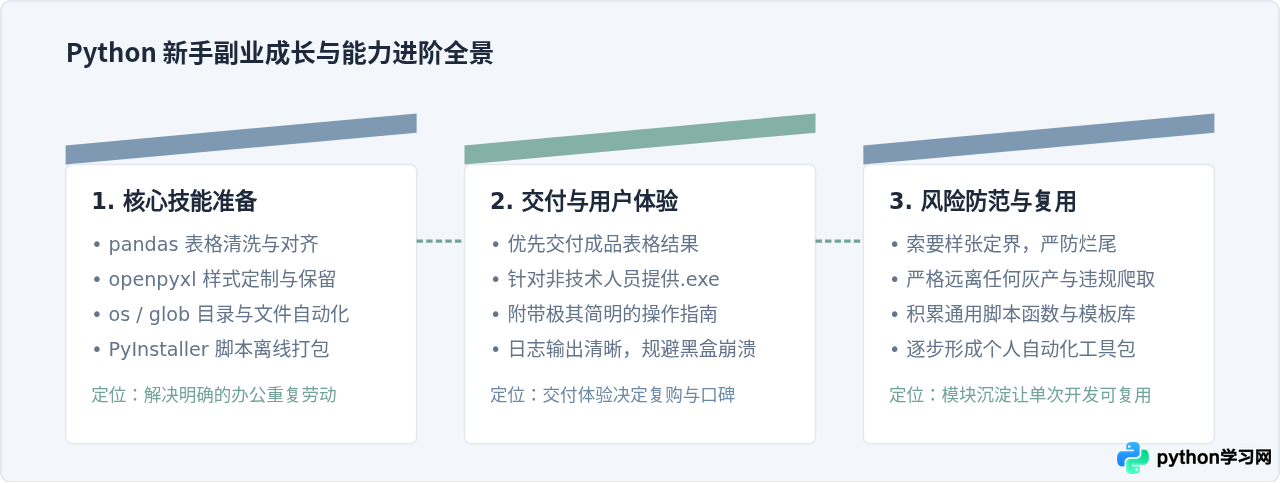
图4:Python副业从技能准备、交付落实到模块化沉淀的闭环总结
结语与起步建议
副业不是盲目承接大项目,而是用自己已经掌握的技术,帮非技术背景的人解决那些令他们头疼的繁琐事务。从合并几个分散的表格、批量整理一批混乱的文件开始,写出健壮、容错性好的脚本,先积累三到五个真实案例的代码库。随着通用代码模板的沉淀,后续遇到同类需求时,往往只需要微调核心清洗规则即可快速交付,这才是 Python 初学者兼顾技术提升与实际收益的最稳健路径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















