


用Python能做什么?数据分析、Web开发与自动化应用场景介绍
深入拆解Python在数据分析、Web开发与自动化三大核心领域的具体应用场景、核心工具链、工作流实现与典型代码示例,帮助读者建立清晰实用的技术选型依据。
在实际项目和日常工作中,很多初学者常听说“Python 几乎什么都能做”,但在面对具体业务场景时,往往不清楚它的具体边界在哪里、依托哪些核心库运作,以及能交付怎样的成果。本文直接围绕数据分析、Web开发与日常自动化三大支柱场景展开,通过清晰的工作流程、典型代码实现与选型建议,帮助读者建立务实的技术认知。
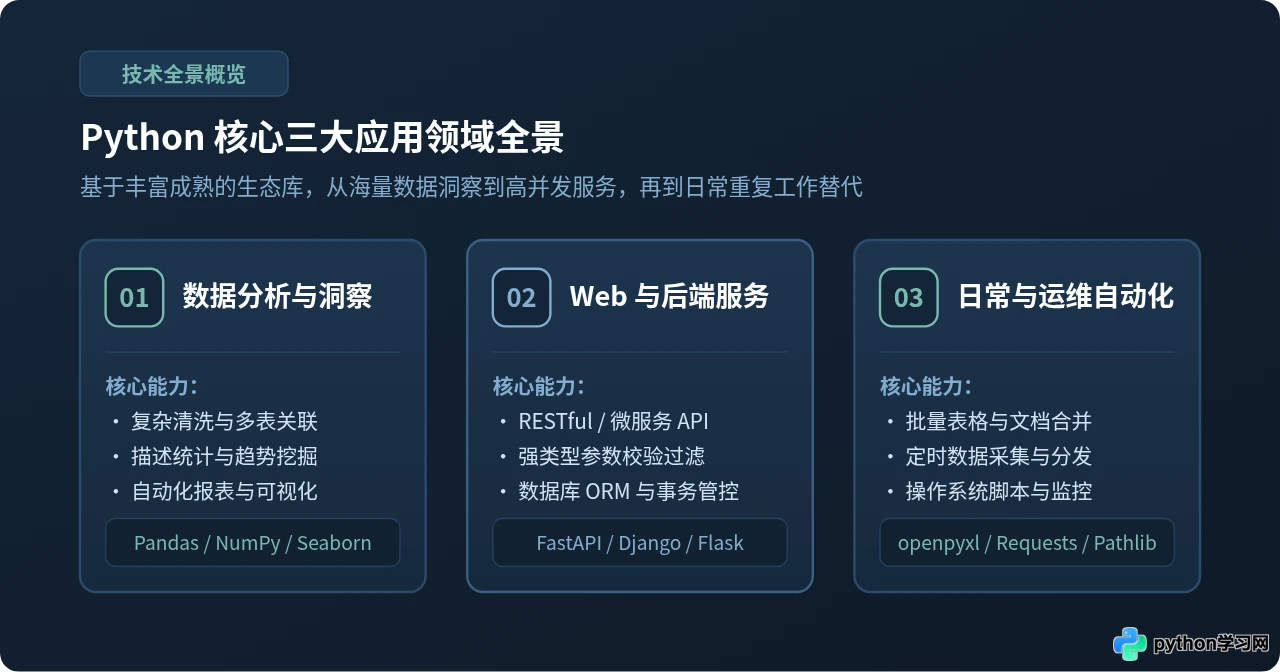
一、数据分析与可视化:从混乱数据到决策支撑
在企业日常运营、金融风控或科研实验中,最常见的问题是原始数据来源杂乱且格式不统一。业务人员可能每天面对几十个格式不规范的 CSV 文件、导出自数据库的几万条用户记录,或是第三方接口返回的深层嵌套 JSON。如果仅靠手动在表格软件中逐行核对与筛选,不仅极易遗漏错误,而且当数据量超过数十万行时软件极易卡顿崩溃。
Python 在这一领域充当了“自动化数据处理流水线”的角色。它拥有以 pandas 为核心的数据处理生态,搭配数值计算库 NumPy 以及图表绘制库 Matplotlib 与 Seaborn,能够以确定、可复现的脚本形式完成全部数据规整与统计工作。
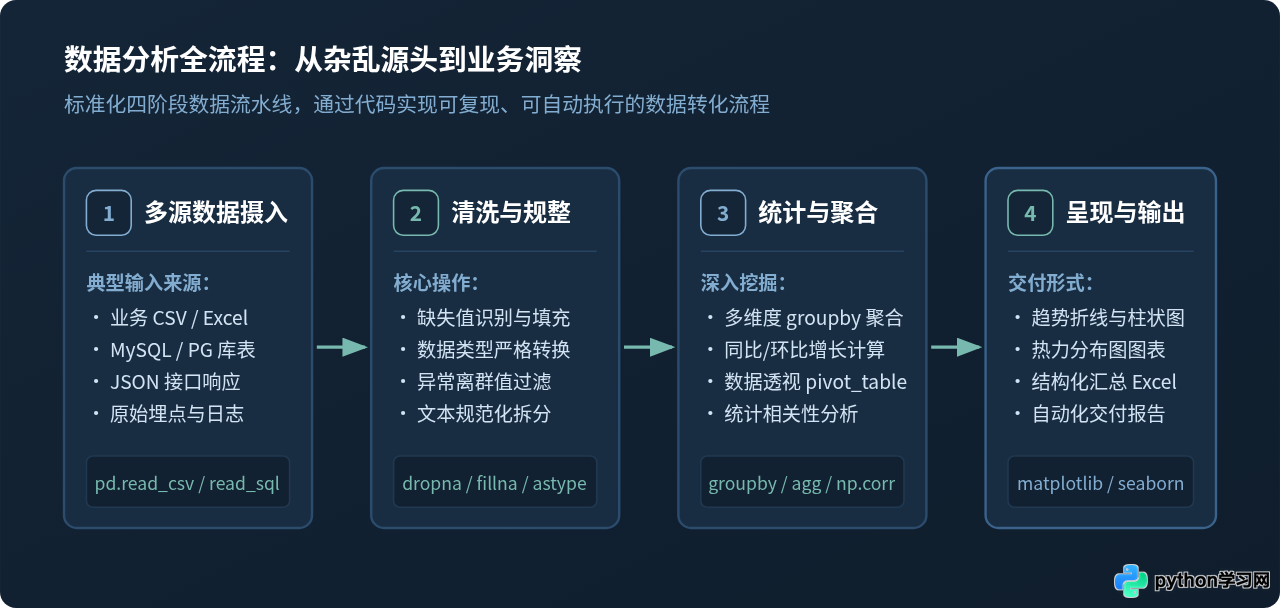
核心工作流与处理机制
- 多源数据摄入:利用
pandas.read_csv()、read_excel()或read_sql()直接从磁盘文件或生产数据库中拉取数据,转换为内存中的二维表格结构(DataFrame)。 - 数据清洗与规整:检测并填补缺失值(
fillna())、过滤重复记录(drop_duplicates()),并将字符串类型的日期或金额字段转换为标准的时间戳与浮点数值。 - 多维统计与分组聚合:通过
groupby()按照部门、地区或时间维度进行汇总计算,求取平均值、中位数或累计贡献率。 - 可视化呈现:将统计结果传递给
seaborn或matplotlib,导出高质量趋势图、柱状分布图或热力图,直接嵌入汇报文档。
典型代码示例:销售明细数据汇总与异常筛选
import pandas as pd
import numpy as np

# 1. 模拟读取原始订单数据
data = {
    'order_id': ['A101', 'A102', 'A103', 'A104', 'A105'],
    'category': ['数码', '家居', '数码', np.nan, '美妆'],
    'sales_amount': ['2999', '150.5', '4800', '320', '-50'],  # 包含异常负值与类型错误
    'order_date': ['2026-03-01', '2026-03-02', '2026-03-02', '2026-03-03', '2026-03-04']
}
df = pd.DataFrame(data)

# 2. 清洗:填补品类缺失值、转换金额类型并剔除退款负值
df['category'] = df['category'].fillna('其他')
df['sales_amount'] = pd.to_numeric(df['sales_amount'], errors='coerce')
clean_df = df[df['sales_amount'] > 0].copy()

# 3. 统计:按品类汇总销售总额及订单量
category_summary = clean_df.groupby('category').agg(
    total_sales=('sales_amount', 'sum'),
    order_count=('order_id', 'count')
).reset_index()

# 4. 计算贡献率并排序
total_revenue = category_summary['total_sales'].sum()
category_summary['revenue_share'] = (category_summary['total_sales'] / total_revenue).round(4)
category_summary = category_summary.sort_values(by='total_sales', ascending=False)

print("=== 最终品类销售分析结果 ===")
print(category_summary.to_string(index=False))pd.read_csv() 容易导致内存溢出。此时应使用 chunksize 参数分块读取,或改用轻量高效的分析型引擎(如 DuckDB / Polars)。
二、Web 开发与接口服务:构建稳健的后端架构
现代软件产品通常采用前后端分离架构,前端(Web 浏览器、移动端 App、微信小程序)负责页面渲染与交互,而真正的用户鉴权、订单结算、业务计算与数据持久化都必须依托后端服务完成。
Python 在后端开发中扮演着核心角色。相较于部分强类型编译语言繁琐的样板代码,Python 能够快速搭建出结构严密、开箱即用的 RESTful API 和企业级后台系统:
- FastAPI:基于 Python 3.6+ 类型提示语法的新一代异步框架。具备出色的并发吞吐能力,且能根据数据模型自动生成实时的交互式 API 文档(Swagger UI / ReDoc)。
- Django:以“全栈全能(Batteries-Included)”著称的成熟框架。内置强大的 ORM 数据库映射、用户权限验证模块与后台管理面板(Admin),极适合快速交付复杂业务管理系统。
- Flask:极简灵活的微框架,适合搭建轻量级原型、微服务探针或小型工具服务。
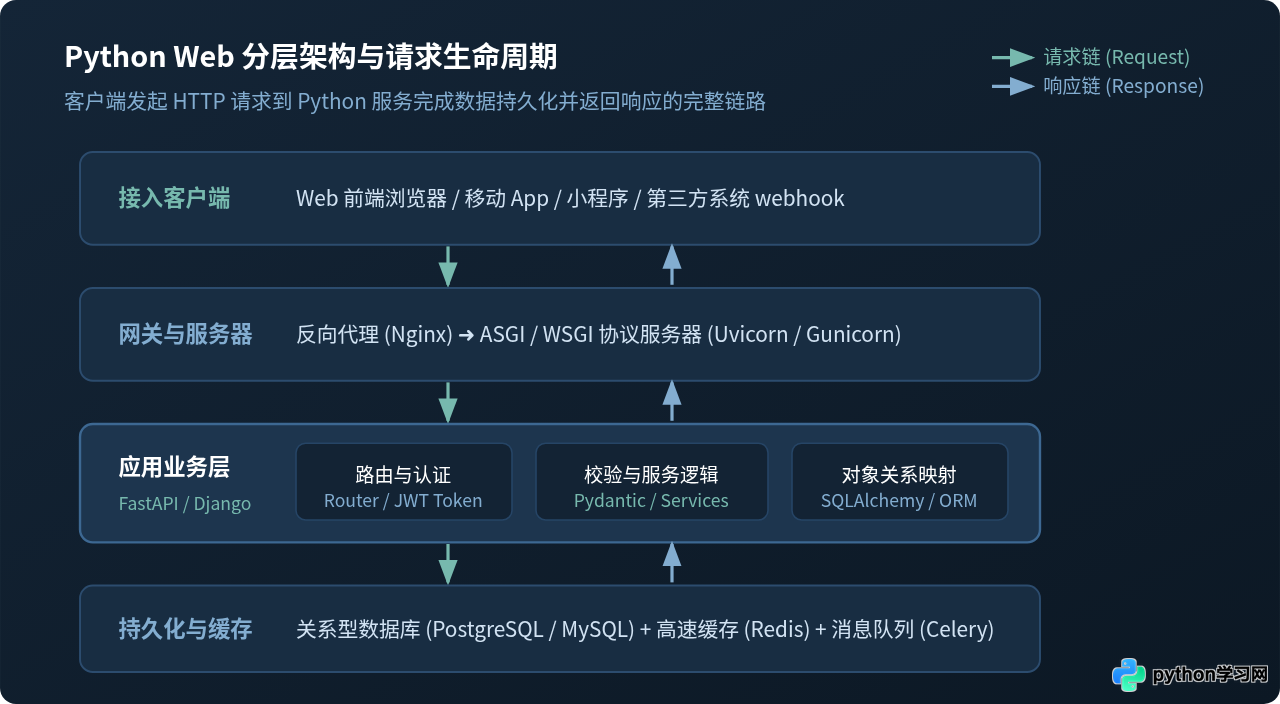
典型代码示例:使用 FastAPI 编写结构化查询接口
以下代码演示如何使用 FastAPI 和 Pydantic 定义一个带有参数验证与状态码控制的查询接口:
from fastapi import FastAPI, HTTPException, Query
from pydantic import BaseModel, Field
from typing import Optional

app = FastAPI(title="商品目录服务", version="1.0")

# 1. 定义响应数据模型(自动完成数据序列化与文档声明)
class ProductResponse(BaseModel):
    product_id: int
    name: str = Field(..., example="无线降噪耳机")
    price: float = Field(..., gt=0, description="商品单价(必须大于0)")
    in_stock: bool

# 模拟数据库字典
db_products = {
    101: {"product_id": 101, "name": "无线降噪耳机", "price": 899.0, "in_stock": True},
    102: {"product_id": 102, "name": "机械键盘", "price": 429.0, "in_stock": False}
}

# 2. 路由端点:通过 ID 查询单条商品信息
@app.get("/api/products/{product_id}", response_model=ProductResponse)
async def get_product(product_id: int):
    product = db_products.get(product_id)
    if not product:
        raise HTTPException(status_code=404, detail="指定的商品编号不存在")
return productuvicorn main:app --reload 启动服务十分便捷,但上线生产环境时,必须由 Nginx 作为反向代理负责 SSL 证书卸载与静态资源托管,配合 Gunicorn + UvicornWorker 管理多进程实例,以防止单进程阻塞导致接口宕机。
三、日常与运维自动化:消除繁琐重复操作
在各类岗位中,很多人往往耗费大量工作时间在高度机械的“搬运数据”上:例如每周一从多个业务系统分别下载日报、逐一打开并核对各部门格式、将关键数据复制粘贴到汇总总表中,再通过邮件附件发送给相关负责人。
这类任务逻辑固定、步骤清晰,是 Python 最显成效的应用场景之一。借助系统内置的标准库和丰富的第三方组件,原本需要数小时的人工点击,可压缩为几秒钟的后台静默运行:
- 文件与目录治理:使用
pathlib与shutil递归遍历深层目录、自动提取特定扩展名文件、按日期新建归档目录并重命名。 - Office 文档自动化:利用
openpyxl读写 Excel 单元格与公式;使用python-docx自动生成规范排版的 Word 汇报文档;使用pypdf完成合同文件的批量盖章与合并拆分。 - 网络数据与爬虫采集:使用
requests模拟 HTTP 请求拉取公开行业指数;使用Playwright模拟无头浏览器进行页面点击、登录及截屏取证。 - 定时守护与通知推送:结合操作系统自带的
cron定时任务或第三方调度器,在任务完成后调用钉钉/企业微信机器人 Webhook 发送即时告警。
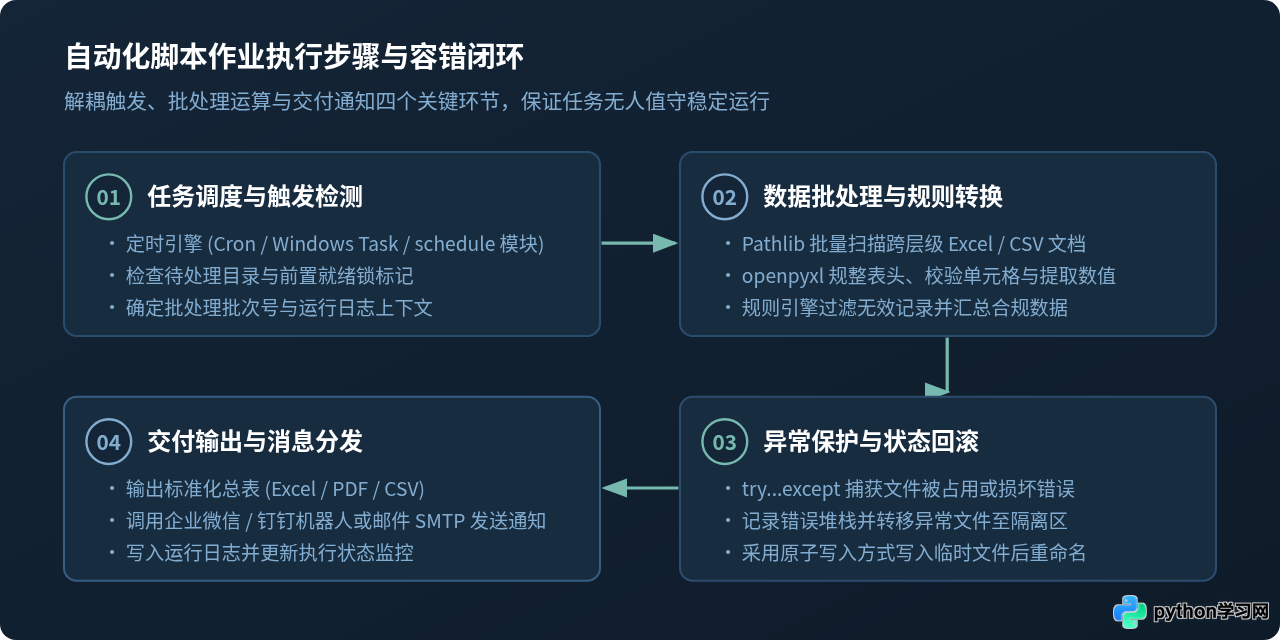
典型代码示例:跨部门周报 Excel 自动扫描与整合
from pathlib import Path
import openpyxl

def consolidate_weekly_reports(input_dir: str, output_filepath: str):
    base_path = Path(input_dir)
    # 1. 递归扫描目录下所有子文件夹中的 .xlsx 报告
    report_files = list(base_path.glob("**/*_周报.xlsx"))
    if not report_files:
        print("未找到匹配的周报文件,流程结束。")
        return

    # 2. 创建用于汇总的新工作簿
    summary_wb = openpyxl.Workbook()
    summary_ws = summary_wb.active
    summary_ws.title = "汇总数据"
    summary_ws.append(["来源文件", "部门名称", "任务项", "完成进度", "责任人"])

    # 3. 逐个文件读取并提取有效行数据
    total_rows = 0
    for file_path in report_files:
        try:
            wb = openpyxl.load_workbook(file_path, data_only=True)
            ws = wb.active
            # 假设首行为表头,从第2行开始提取
            for row in ws.iter_rows(min_row=2, values_only=True):
                if any(row):  # 跳过完全空白行
                    summary_ws.append([file_path.name] + list(row[:4]))
                    total_rows += 1
        except Exception as err:
            print(f"警告:读取文件 {file_path.name} 失败,原因: {err}")

    # 4. 保存合并后的目标工作表
    summary_wb.save(output_filepath)
    print(f"成功汇总 {len(report_files)} 份周报,合计提取 {total_rows} 条记录,保存至 {output_filepath}")

# 执行示例调用
# consolidate_weekly_reports("./reports", "./reports/2026年第10周汇总.xlsx")try...except 异常保护与完善的 logging 日志记录,确保即使单项文件损坏,其余任务也能正常完成并发出告警。
四、技术对比与方向选型指南
不同读者学习 Python 的出发点各不相同。初学者常犯的错误是同时铺开学习爬虫、机器学习、前端框架与自动化,最终因目标分散而无法真正独立完成一个可用项目。
以下汇总矩阵从学习难度、核心依赖工具、交付成果三个维度对比三大方向,帮助读者根据自身实际情况制定务实目标:
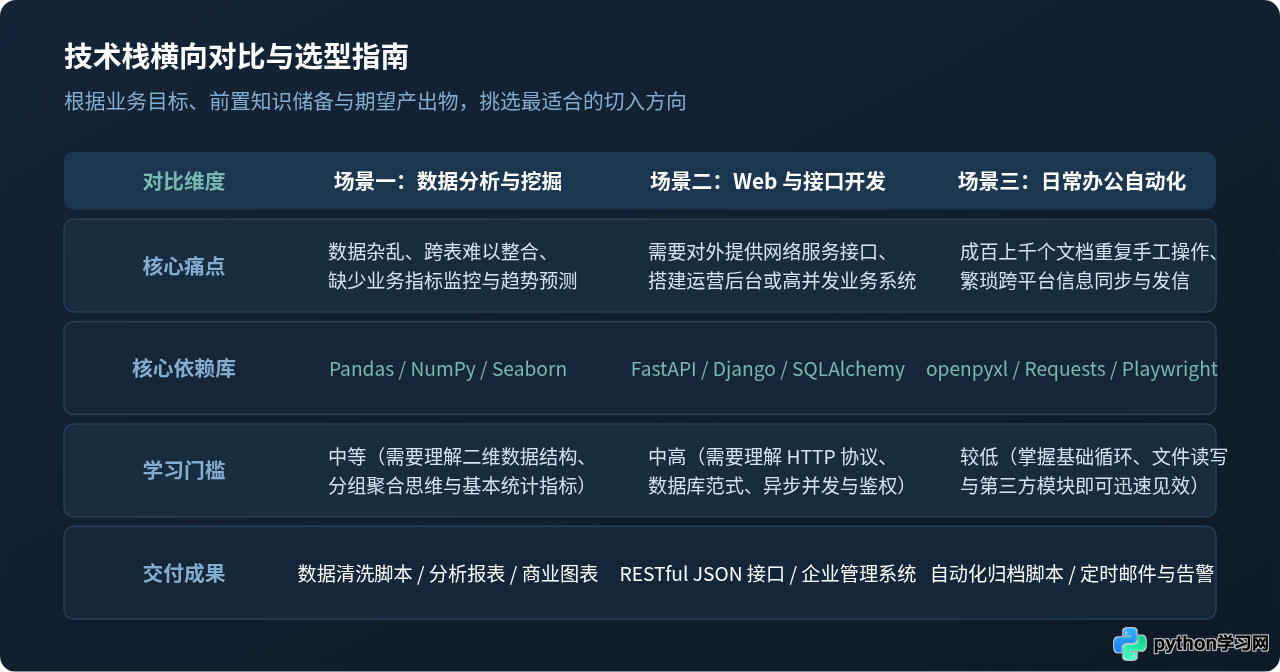
如何根据目标挑选切入路径?
-
如果目标是优化本职工作效率(非专业程序员):
建议从日常办公自动化切入。掌握 Python 基础变量、字典循环后,直接学习pathlib与openpyxl。只需写几十行代码,就能在短时间内解决实际文件处理问题,正向反馈迅速。 -
如果目标是从事运营分析、财务分析或数据科学:
重点学习 数据分析方向。跳过复杂的网络协议,直接以pandas为主线,结合真实 CSV 业务数据练习筛选、多表关联(merge)与分组透视,再逐步补充统计学概念与可视化图表表达。 -
如果目标是从事软件开发或系统服务端开发:
建议以 FastAPI 或 Django 为主线,打牢网络协议(HTTP/HTTPS)、关系型数据库设计(SQL 索引与事务)以及异步编程基础,循序渐进搭建具有鉴权、持久化与自动化测试的完整服务系统。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















