


从零编写Python Linter:利用语法分析检测代码规范
本文详细讲解如何利用Python标准库中的ast模块从零编写一个轻量级代码规范检查器(Linter)。通过深入剖析抽象语法树原理、NodeVisitor遍历模式与自定义检测规则编写,帮助开发者掌握真正的静态语法分析方法。
ast(抽象语法树)模块,从核心原理出发,带你一步步构建一个不依赖任何第三方重量级库的轻量级静态代码规范检查工具(Linter)。
一、为什么文本正则不足以支撑可靠的代码规范检查?
许多初学者在尝试编写规范检查脚本时,通常第一反应是逐行读取文件并用正则表达式匹配关键词。例如,检查函数命名是否符合下划线风格(snake_case),往往写成 re.search(r"def\s+([A-Z]\w*)", line)。
这种纯文本匹配在面对真实工程代码时非常脆弱:
- 上下文歧义:如果多行字符串或注释中恰好出现了
def BadName(),文本扫描器会将其错误识别为函数定义,造成虚假报警。 - 排版与断行干扰:Python 允许在圆括号内自由换行,复杂的参数列表可能跨越数行,正则表达式极难准确提取完整参数定义。
- 缺乏作用域概念:文本匹配无法确认某个变量是局部变量、全局变量还是类属性,更无法分析嵌套函数内部的调用逻辑。
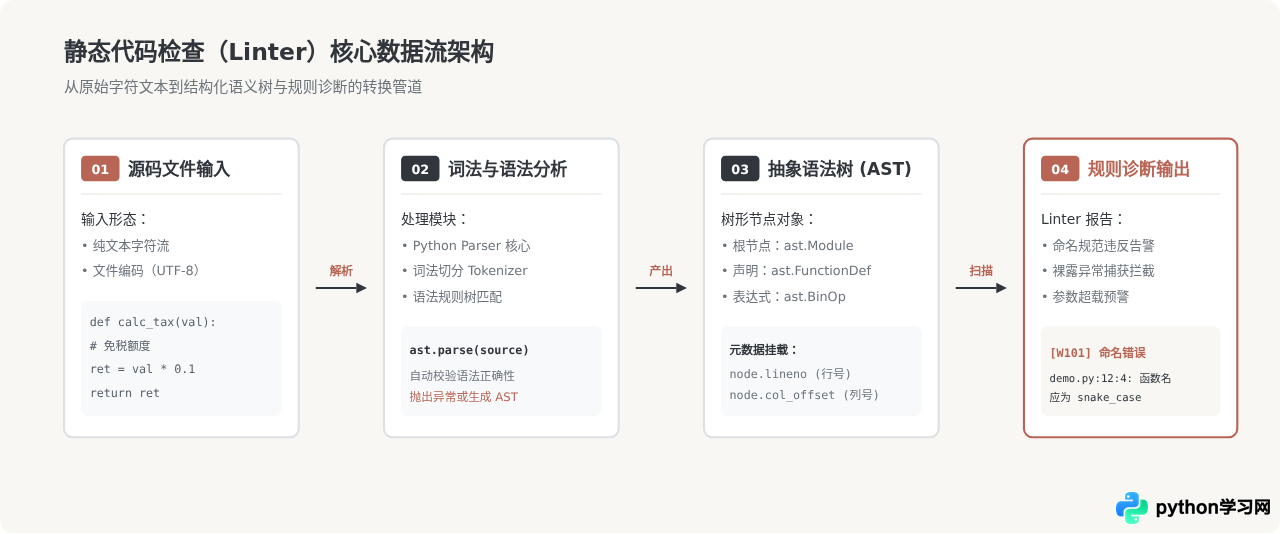
正规的静态分析工具(如 Flake8、Pylint、Ruff)均采用真正的语法分析技术:先将源码字符流转换为语法标记,再组装成结构严密的抽象语法树(Abstract Syntax Tree,简称 AST)。在 AST 中,每一个语法单位都被表示为一个包含行号、列偏移及明确语义关系的节点。
二、认识 Python 原生 AST 与 NodeVisitor 机制
Python 标准库提供了内置的 ast 模块,无需安装额外依赖即可使用。将代码文本转换为语法树仅需调用 ast.parse():
import ast

source_code = """
def calculate_area(width, height):
    return width * height
"""

tree = ast.parse(source_code)
print(ast.dump(tree, indent=2))
运行上述代码后,会输出层级分明的树状结构:
- 根节点为
Module,代表整个文件或代码单元。 - 子节点包含
FunctionDef,拥有属性name='calculate_area'、args(参数列表)以及body(函数内部语句)。 - 语句内部包含了
Return节点,其值是一个BinOp(二元运算),左侧是Name(id='width'),操作符是Mult(),右侧是Name(id='height')。
访问者模式:NodeVisitor
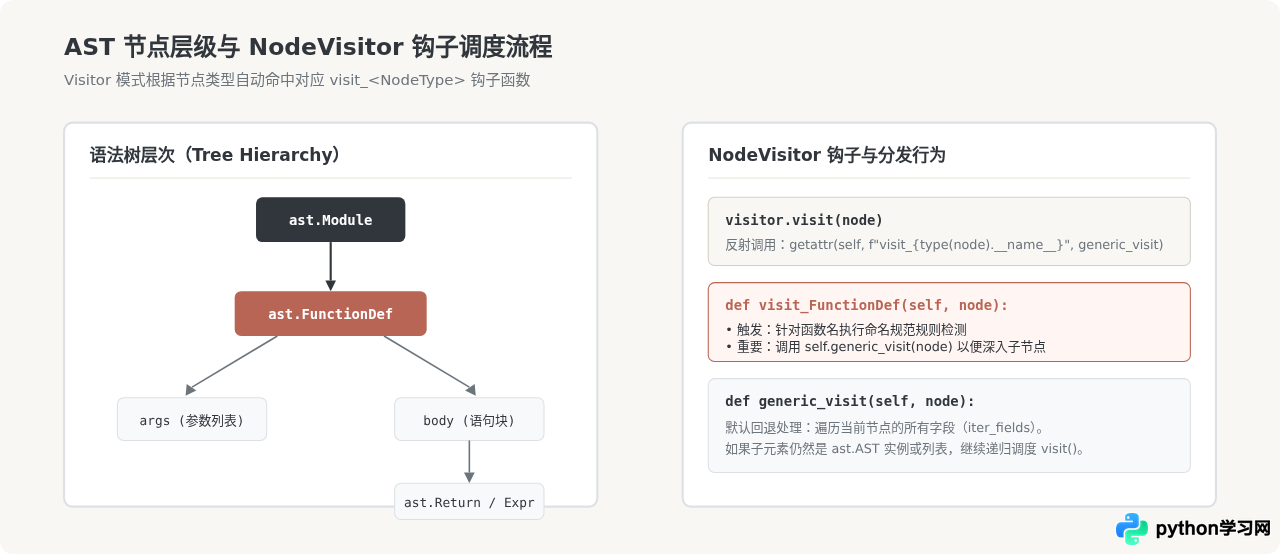
手动编写深度优先搜索递归遍历整棵树不仅代码冗长,而且容易遗漏分支。ast.NodeVisitor 类提供了一种优雅的访问者模式实现:
当调用 visitor.visit(tree) 时,它会根据当前节点的类型,动态查找名为 visit_节点类名 的方法并自动分发。例如,遇到 FunctionDef 节点时,会自动调用 visit_FunctionDef(self, node);若未定义该特定方法,则退回到通用方法 generic_visit(self, node) 并继续递归遍历所有子节点。
三、动手编写 Linter 核心检查器
下面我们动手设计一个轻量但功能完备的 Linter 核心。我们设计三条典型规则:
规则 1:E101 - 函数命名必须遵循下划线小写风格(snake_case)
除双下划线魔法方法(如 __init__)外,常规函数定义必须由全小写字母、数字和下划线构成,不能使用驼峰命名(PascalCase 或 camelCase)。
规则 2:E102 - 禁止使用无限制的裸露异常捕获(Bare Except)
except: 或 except BaseException: 会误捕获 KeyboardInterrupt 和 SystemExit,导致程序无法正常中断退出,必须明确指定捕获的异常类。
规则 3:E103 - 函数参数数量不宜过多(最多允许 5 个)
超过 5 个参数的函数往往意味着职责不清或缺少数据载体类(Data Class/Dict),需要报警提醒重构。
完整核心代码实现:`core_linter.py`
import ast
import re
from dataclasses import dataclass
from typing import List

@dataclass
class LintIssue:
    code: str
    message: str
    lineno: int
    col_offset: int
    file_path: str = ""

    def __str__(self) -> str:
        loc = f"{self.file_path}:{self.lineno}:{self.col_offset + 1}" if self.file_path else f"Line {self.lineno}:{self.col_offset + 1}"
        return f"{loc}: [{self.code}] {self.message}"

class CodeStyleChecker(ast.NodeVisitor):
    def __init__(self, file_path: str = ""):
        self.file_path = file_path
        self.issues: List[LintIssue] = []
        # snake_case 规则正则
        self._snake_case_re = re.compile(r"^[a-z_][a-z0-9_]*$")

    def visit_FunctionDef(self, node: ast.FunctionDef) -> None:
        """检查函数命名规范以及参数数量"""
        func_name = node.name

        # 规则 1:函数名检查(排除 __init__ 等双下划线魔法方法)
        if not (func_name.startswith("__") and func_name.endswith("__")):
            if not self._snake_case_re.match(func_name):
                self.issues.append(
                    LintIssue(
                        code="E101",
                        message=f"函数名 '{func_name}' 不符合 snake_case 命名规范",
                        lineno=node.lineno,
                        col_offset=node.col_offset,
                        file_path=self.file_path,
                    )
                )

        # 规则 3:参数总数检查
        # node.args.args 包含普通位置参数与关键字参数
        total_args = len(node.args.args)
        # 如果是类方法或实例方法,第一个参数通常为 self 或 cls,可在此按需减免
        if node.args.args and node.args.args[0].arg in ("self", "cls"):
            actual_args_count = total_args - 1
        else:
            actual_args_count = total_args

        if actual_args_count > 5:
            self.issues.append(
                LintIssue(
                    code="E103",
                    message=f"函数 '{func_name}' 参数过多 ({actual_args_count} > 5),建议重构或封装为对象",
                    lineno=node.lineno,
                    col_offset=node.col_offset,
                    file_path=self.file_path,
                )
            )

        # 必须显式调用 generic_visit,否则不会继续检查函数体内部的嵌套语句
        self.generic_visit(node)

    def visit_ExceptHandler(self, node: ast.ExceptHandler) -> None:
        """检查异常捕获规范"""
        # node.type 为 None 时,即为裸 except:
        if node.type is None:
            self.issues.append(
                LintIssue(
                    code="E102",
                    message="禁止使用裸露的 'except:',请明确指定异常类型(如 Exception)",
                    lineno=node.lineno,
                    col_offset=node.col_offset,
                    file_path=self.file_path,
                )
            )
        elif isinstance(node.type, ast.Name) and node.type.id == "BaseException":
            self.issues.append(
                LintIssue(
                    code="E102",
                    message="避免直接捕获 BaseException,通常应捕获具体的 Exception 子类",
                    lineno=node.lineno,
                    col_offset=node.col_offset,
                    file_path=self.file_path,
                )
            )

self.generic_visit(node)visit_xxx 钩子时,千万不要漏掉末尾的 self.generic_visit(node)。如果缺少这一句,遍历就会在此节点直接截断,函数内部定义的子函数、内部 try-except 块将完全逃逸检查!
四、包装为命令行工具(CLI)与实测验证
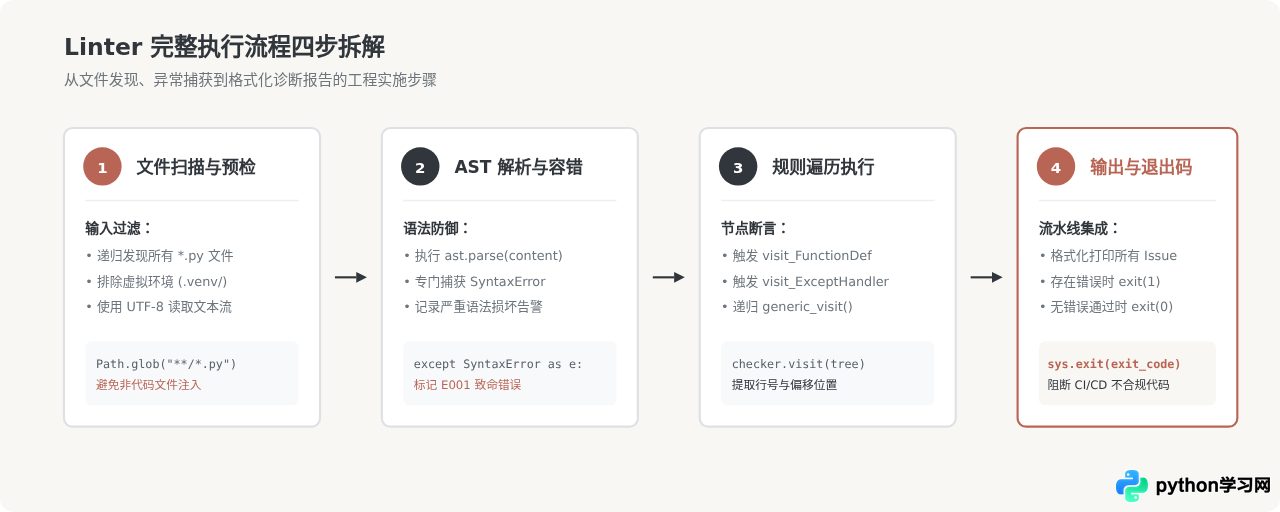
一个实用的 Linter 必须具备通过命令行接收路径参数、扫描目录以及在 CI/CD 流程中返回合理退出码(Exit Code)的能力。我们利用标准库的 argparse 和 pathlib 构建入口文件 py_mini_linter.py:
import argparse
import ast
import sys
from pathlib import Path
from core_linter import CodeStyleChecker, LintIssue

def lint_file(file_path: Path) -> list:
    """读取并检查单份 Python 文件"""
    issues = []
    try:
        content = file_path.read_text(encoding="utf-8")
    except UnicodeDecodeError:
        return [LintIssue("E000", f"文件非 UTF-8 编码,无法读取", 1, 0, str(file_path))]
    except Exception as e:
        return [LintIssue("E000", f"读取失败: {e}", 1, 0, str(file_path))]

    # 步骤 2:语法解析
    try:
        tree = ast.parse(content, filename=str(file_path))
    except SyntaxError as se:
        return [
            LintIssue(
                code="E001",
                message=f"语法错误,解析终止: {se.msg}",
                lineno=se.lineno or 1,
                col_offset=(se.offset or 1) - 1,
                file_path=str(file_path),
            )
        ]

    # 步骤 3:规则检查
    checker = CodeStyleChecker(file_path=str(file_path))
    checker.visit(tree)
    return checker.issues

def main():
    parser = argparse.ArgumentParser(description="轻量级原生 Python 代码规范检查器")
    parser.add_argument("paths", nargs="+", help="待检查的文件或文件夹路径")
    args = parser.parse_args()

    total_issues = []

    for path_str in args.paths:
        target = Path(path_str)
        if target.is_file() and target.suffix == ".py":
            total_issues.extend(lint_file(target))
        elif target.is_dir():
            for py_file in target.rglob("*.py"):
                # 忽略常见虚拟环境或缓存文件夹
                if any(part in py_file.parts for part in (".venv", "venv", "__pycache__", ".git")):
                    continue
                total_issues.extend(lint_file(py_file))
        else:
            print(f"[警告] 路径无效或非 Python 文件: {path_str}", file=sys.stderr)

    # 步骤 4:报告输出
    if total_issues:
        print(f"\n发现 {len(total_issues)} 处代码规范违规:")
        print("-" * 60)
        for issue in total_issues:
            print(issue)
        print("-" * 60)
        sys.exit(1)
    else:
        print("\n恭喜!所有代码检查通过,未发现规范违规。")
        sys.exit(0)

if __name__ == "__main__":
    main()
实测验证示例
创建一个故意违规的测试文件 test_bad_code.py:
# test_bad_code.py
def BadCamelCaseFunc():
    try:
        x = 10 / 0
    except:
        pass

def process_user_registration(user_id, user_name, user_email, user_phone, user_role, user_address):
    print("注册逻辑")
执行检查命令并观察标准终端输出:
$ python py_mini_linter.py test_bad_code.py

发现 3 处代码规范违规:
------------------------------------------------------------
test_bad_code.py:2:1: [E101] 函数名 'BadCamelCaseFunc' 不符合 snake_case 命名规范
test_bad_code.py:5:5: [E102] 禁止使用裸露的 'except:',请明确指定异常类型(如 Exception)
test_bad_code.py:8:1: [E103] 函数 'process_user_registration' 参数过多 (6 > 5),建议重构或封装为对象
------------------------------------------------------------
命令退出返回码为 1。在 GitHub Actions 或 GitLab CI 等流水线中,此返回码将直接拦截不合规的提交,确保代码库标准统一。
五、语法分析的局限性与进阶体系
尽管标准 AST 能准确表达语句骨架,但在实际工程体系中,它并非万能方案:
- 排版信息丢失:标准
ast节点不保留代码中的注释内容(Comments)以及缩进空格格式(如 2 个空格还是 4 个空格)。因此,纯格式化工具(如 Black)或长注释排版检查通常需要结合tokenize模块或 CST(具体语法树,Concrete Syntax Tree,例如 LibCST)。 - 跨文件类型推导限制:AST 仅局限于当前单文件的语法结构。要判断某个对象是否有指定方法,需要配合符号表、静态类型检查器(如 Mypy、Pyright)进行多模块联合流分析。
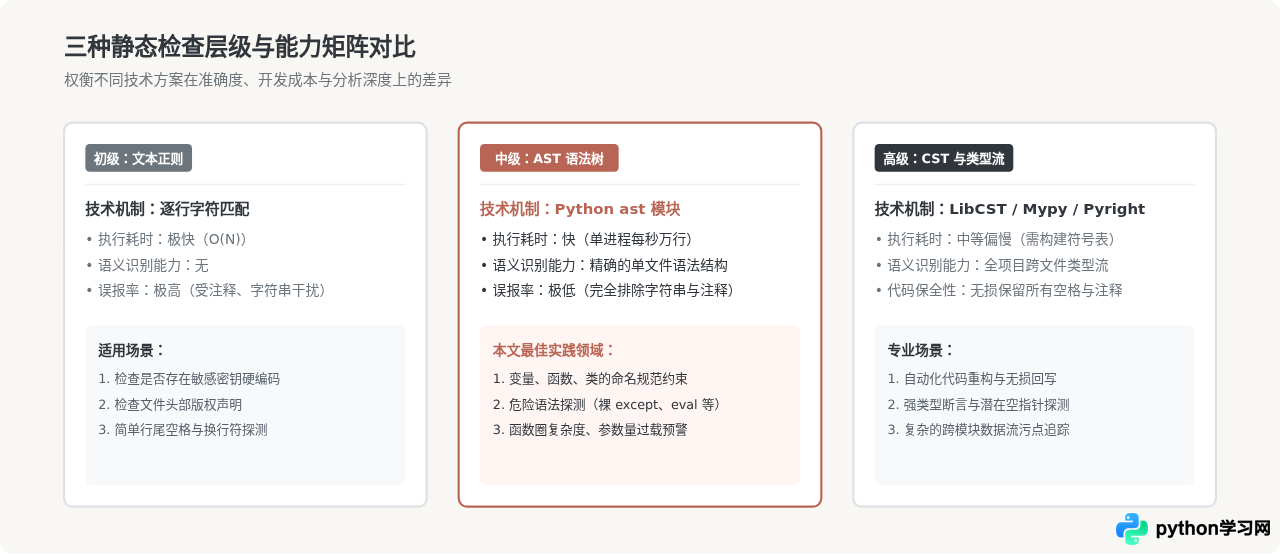
六、总结与落地建议
利用 Python 原生 ast 模块构建 Linter,不仅能够让你彻底摆脱脆弱的正则匹配,还能让你真正洞悉 Python 运行时的语法结构组织方式。在团队工程实践中,你可以按照以下步骤逐步推进定制化规范:
- 从小切口切入:优先将团队最深恶痛绝的痛点(如随意的命名、容易引发隐蔽 Bug 的
except: pass、循环内部的隐式重绑定)抽象为NodeVisitor规则。 - 善用 `ast.dump()`:在开发新规则前,先编写最小测试样本片段,通过
ast.dump(tree, indent=2)打印其节点分布,直观观察目标特征挂载在哪个字段上。 - 保持遍历通畅:重写特定
visit_NodeType之后,牢记调用self.generic_visit(node),保证深层嵌套结构无遗漏。 - 流水线卡点:将自研轻量级 Linter 接入 Git Pre-commit 钩子或 CI 步骤中,通过明确的返回码实现规范自动化守门。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















