


Python初学者必掌握的20个核心内置函数及示例
针对Python初学者系统梳理最核心、最高频的20个内置函数,涵盖输入输出、类型转换、容器操作、数值计算、迭代遍历及排序判定,配以详尽代码示例与架构图解。
Python 解释器在启动时会自动加载数十个原生提供的内置函数(Built-in Functions)。对于初学者而言,并不需要一开始就死记硬背官方文档中的近70个函数,掌握其中最核心、使用频率最高的20个内置函数,就足以支撑起绝大多数入门编程任务和日常数据处理需求。本文精选了这20个函数,按功能体系清晰拆解,通过具体的使用场景、语法规则、执行示例与常见陷阱,帮助读者建立起扎实的使用基础。
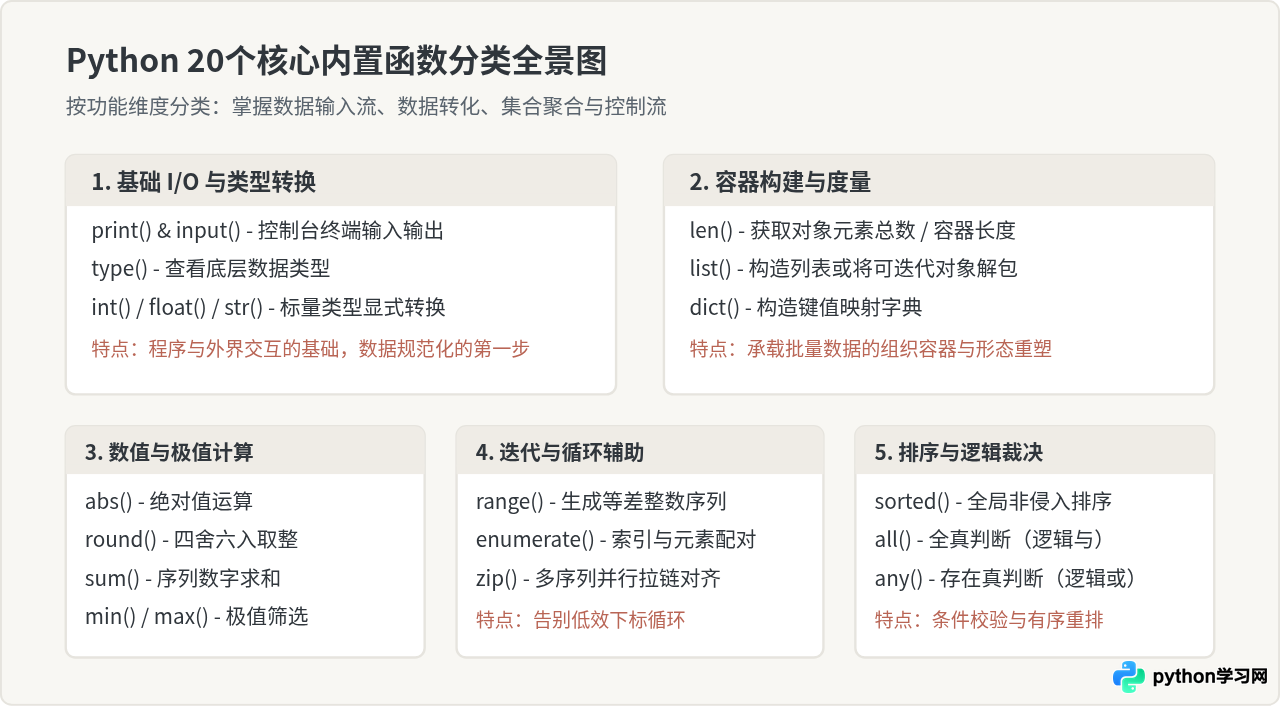
一、基础 I/O 与类型转换:与程序进行数据交互
在编写任何 Python 程序时,首先面临的就是接收外界输入、打印执行结果以及保证数据处于正确的数据类型上。以下6个函数是任何程序日常运转的基石。
1. print():标准输出与格式控制
print() 用于将指定的内容输出到控制台。许多初学者仅将其用于打印单一变量,实际上它内置了 sep(分隔符)和 end(行末终止符)两个非常实用的控制参数。
# 基础用法
print("Hello, Python!")

# 使用 sep 自定义多字段之间的分隔符
print("2026", "10", "16", sep="-")
# 示例输出: 2026-10-16

# 使用 end 控制不换行输出
for num in range(3):
    print(num, end=" -> ")
print("完成")
# 示例输出: 0 -> 1 -> 2 -> 完成
2. input():捕获键盘交互输入
input() 暂停程序执行并等待用户键入字符,接收到回车后返回内容。初学者最容易踩的陷阱是:无论输入的是纯数字还是符号,input() 返回的永远是字符串类型(str)。
# 接收用户输入
user_age = input("请输入年龄: ")  # 假设用户输入: 20
print("接收类型:", type(user_age))
# 示例输出: 接收类型: <class 'str'>

# 必须显式转换后才能进行数学比较或计算
age = int(user_age)
print("明年年龄:", age + 1)
# 示例输出: 明年年龄: 21
3. type():动态类型探查
Python 是一门动态强类型语言,变量名只是对象的引用。type() 帮助开发者在调试阶段即时确认当前变量指向的数据结构到底是什么类型。
x = 100
y = "100"
z = [100]

print(type(x))  # 示例输出: <class 'int'>
print(type(y))  # 示例输出: <class 'str'>
print(type(z))  # 示例输出: <class 'list'>
4. int():整数构造与进制解析
int() 将符合规则的字符串或浮点数转换为整数。转换浮点数时,它直接截断小数部分(向零取整),而不是进行四舍五入。此外,int() 还支持将特定进制字符串转为十进制。
# 截断小数
print(int(9.99))  # 示例输出: 9
print(int(-3.8))  # 示例输出: -3

# 解析二进制或十六进制字符串
print(int("1010", base=2))   # 示例输出: 10
print(int("1F", base=16))    # 示例输出: 31
5. float():浮点数转换
用于将整数或整型字符串转换为双精度浮点数。在处理带小数的输入数据或需要高精度除法运算前非常关键。
price = float("19.95")
quantity = 3
total = price * quantity
print("总计金额:", total)
# 示例输出: 总计金额: 59.85
6. str():转换为文本表示
str() 将任何对象转换为适合人类阅读的字符串表达形式,是字符串拼接、文件输出日志时的常用手段。
count = 42
msg = "库存剩余: " + str(count) + " 件"
print(msg)
# 示例输出: 库存剩余: 42 件
二、容器构建与度量:感知与重组数据
单值变量无法处理批量业务,列表、字典等容器是数据存储的主干。以下3个函数负责快速生成容器与探测其规模。
7. len():测量容器长度与元素个数
len() 在内部直接读取对象的元数据属性(底层 __len__),执行时间复杂度为常数级 \(O(1)\),效率极高。无论是字符串字符数、列表项数还是字典键数量,均统一使用此函数测量。
text = "Python编程"
items = [10, 20, 30, 40]
user_map = {"name": "张三", "role": "admin"}

print(len(text))      # 示例输出: 8 (中文与英文字符均计为1个长度)
print(len(items))     # 示例输出: 4
print(len(user_map))  # 示例输出: 2
8. list():构造列表与可迭代对象解包
用于从零新建一个空列表,或将元组、字符串、生成器及字典转换为列表。在需要即时展开惰性计算结果(如 range、map)时必不可少。
# 将字符串拆为字符列表
chars = list("ABC")
print(chars)  # 示例输出: ['A', 'B', 'C']

# 将 range 生成器解包为真实列表
numbers = list(range(1, 5))
print(numbers)  # 示例输出: [1, 2, 3, 4]
9. dict():映射字典构建
除了直接使用花括号字面量 {} 外,dict() 提供了更具表现力的字典构造方式,尤其是支持通过键值对元组列表或关键字参数快速装配字典。
# 关键字参数传值(键必须是合法标识符)
info = dict(name="李华", level="初级", score=88)
print(info)
# 示例输出: {'name': '李华', 'level': '初级', 'score': 88}

# 二元元组列表转换
pairs = [("id", 1001), ("status", "active")]
print(dict(pairs))
# 示例输出: {'id': 1001, 'status': 'active'}
三、数值计算与极值统计:摆脱手工循环
处理数字列表时,初学者往往习惯写 for 循环去累加或逐个比对大小,代码繁琐且易写出下标越界错误。Python 原生内置了高效的数学汇总函数。
10. abs():绝对值运算
返回给定数字的非负数值,对整数、浮点数均生效。在计算差值距离、容差判断时是基础工具。
print(abs(-15.6))  # 示例输出: 15.6
delta = abs(100 - 150)
print(delta)       # 示例输出: 50
11. round():浮点取整与舍入机制
round(number[, ndigits]) 用于保留指定位数的小数。
round() 采用国际通用的银行家舍入法(四舍六入五成双)。当处于正中间的 .5 时,它会舍入到距离最近的偶数,而不是一律向上进位。这有助于避免大规模统计计算中的系统性正向偏差。
print(round(2.4))  # 示例输出: 2
print(round(2.6))  # 示例输出: 3

# 遇到 .5 时舍入到最近的偶数
print(round(2.5))  # 示例输出: 2 (2是偶数)
print(round(3.5))  # 示例输出: 4 (4是偶数)

# 保留2位小数
print(round(3.1415926, 2))  # 示例输出: 3.14
12. sum():序列求和
sum(iterable, start=0) 将可迭代对象中的元素依次累加。可以通过 start 参数设置累计底数。
scores = [85, 90, 78, 92]
print(sum(scores))  # 示例输出: 345

# 带有初始底分的求和
print(sum(scores, 100))  # 示例输出: 445 (从100开始累加)
13 & 14. min() 与 max():极值提取与按键比对
min() 和 max() 可以传入多个参数,也可以传入一个可迭代对象。更强大的是它们的 key 参数,允许我们传入一个处理函数,基于特定规则筛选极值。
# 基础用法
nums = [15, 3, 42, 8]
print(min(nums))  # 示例输出: 3
print(max(nums))  # 示例输出: 42

# 使用 key 参数提取最长字符串
words = ["python", "go", "javascript", "c"]
longest = max(words, key=len)
print("字符最长者:", longest)
# 示例输出: 字符最长者: javascript
四、遍历迭代与循环辅助:Pythonic 代码的核心
写出整洁优雅 Python 代码的分水岭,就在于能否熟练运用 range()、enumerate() 与 zip()。熟练掌握它们之后,就可以彻底告别通过 for i in range(len(data)): 访问下标的别扭写法。
15. range():等差序列生成器
range(start, stop[, step]) 生成遵循前闭后开区间 [start, stop) 的整数序列。它是一个占用固定内存极小的惰性对象,无论区间多大都不会一次性在内存中创建全量列表。
# 单参数:0 到 4
print(list(range(5)))
# 示例输出: [0, 1, 2, 3, 4]

# 双参数:指定起始与结束
print(list(range(3, 8)))
# 示例输出: [3, 4, 5, 6, 7]

# 三参数:指定步长与倒序
print(list(range(10, 0, -2)))
# 示例输出: [10, 8, 6, 4, 2]
16. enumerate():索引与元素同步解包
在循环过程中,常常需要知道当前元素是第几个。enumerate() 将可迭代对象打包成形如 (index, item) 的元组,并支持自定义起始计数值。
fruits = ["苹果", "香蕉", "橙子"]

# 从 1 开始编号输出
for idx, fruit in enumerate(fruits, start=1):
    print(f"第 {idx} 号水果: {fruit}")

# 示例输出:
# 第 1 号水果: 苹果
# 第 2 号水果: 香蕉
# 第 3 号水果: 橙子
17. zip():多序列并行拉链对齐
zip() 接受多个可迭代对象,将其对应位置的元素配对为一个个元组。当输入序列长度不一致时,zip() 会在最短的序列耗尽时自动停止。
names = ["小明", "小红", "小刚"]
scores = [95, 88, 92]
grades = ["A+", "B+", "A"]

# 并行组合遍历
for name, score, grade in zip(names, scores, grades):
    print(f"学生: {name} | 得分: {score} | 等级: {grade}")

# 快速组合成字典
score_dict = dict(zip(names, scores))
print(score_dict)
# 示例输出: {'小明': 95, '小红': 88, '小刚': 92}
五、序列排序与状态裁决:让数据有序且可控
排序和状态真值判断是程序业务逻辑中最常用的分支条件。
18. sorted():全局非侵入式排序
sorted() 接受任何可迭代对象,并始终返回一个全新排序后的列表,原始数据完全保持不变。与之相对的是列表自身的 list.sort() 方法,后者会直接原地修改原列表并返回 None。
origin = [5, 2, 8, 1, 9]

# 返回全新有序列表,支持 reverse 反转
new_list = sorted(origin, reverse=True)

print("新列表:", new_list)  # 示例输出: [9, 8, 5, 2, 1]
print("原列表:", origin)    # 示例输出: [5, 2, 8, 1, 9] (原样未变)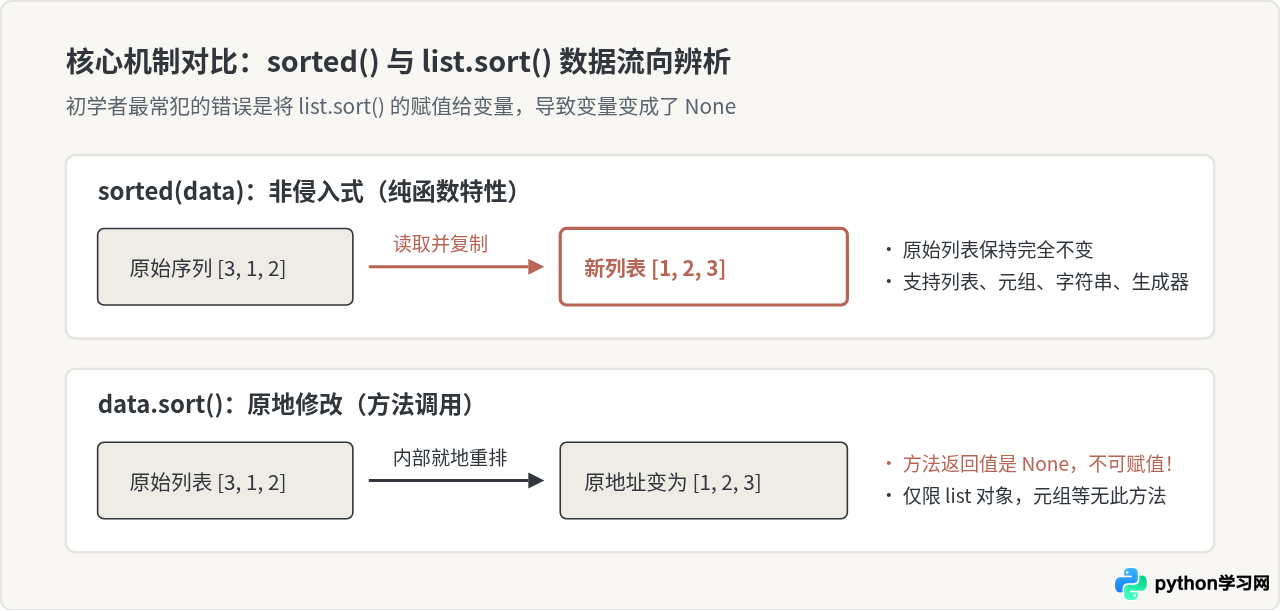
19 & 20. all() 与 any():批量真值裁决
用于替代复杂的 and / or 级联判断。all() 要求所有元素为真时才返回 True,遇到首个假值立即短路返回 False;any() 只要存在至少一个真值即返回 True。
checks = [True, True, False]

print(all(checks))  # 示例输出: False (存在一个 False)
print(any(checks))  # 示例输出: True (存在 True)

# 结合生成器表达式进行业务校验:判断所有商品是否均有库存
stocks = [15, 3, 0, 8]
all_in_stock = all(s > 0 for s in stocks)
has_out_of_stock = any(s == 0 for s in stocks)

print("是否全部有货:", all_in_stock)       # 示例输出: False
print("是否有缺货项:", has_out_of_stock) # 示例输出: Trueall([]) 返回 True(真空全称判断);而 any([]) 返回 False(不存在任何真值)。初学者在编写空值防护逻辑时需特别留意。
六、初学者掌握内置函数的阶梯路径
学习这20个函数不应孤立记忆,按知识依赖梯度逐步建立起系统化认知,能让代码逻辑快速蜕变为地道的 Python 风格。
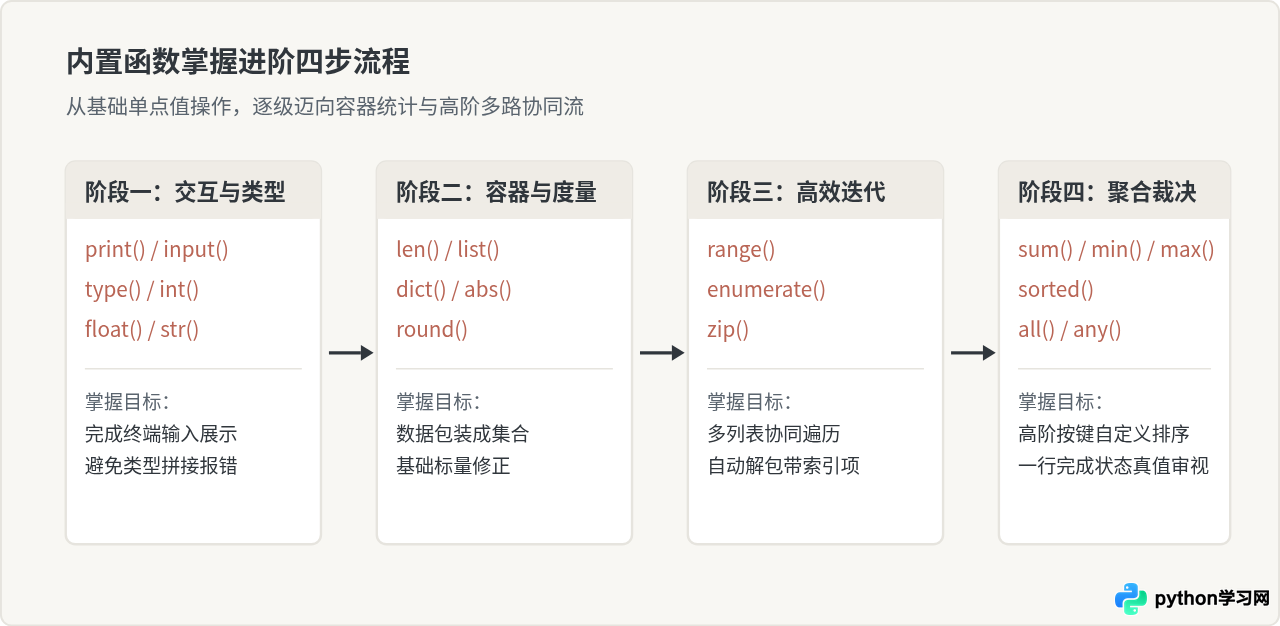
七、综合实战演练:学生成绩单处理流水线
真实项目并非单个函数各自为战,而是多个核心函数相互衔接协同。下面的完整案例通过组合使用 zip、sorted、sum、round、len、enumerate 与 all,仅用十几行代码就完成了一份成绩单的数据清洗、合格校验、名次排定与格式化输出。
# 原始数据输入
students = ["张明", "李华", "王芳", "赵强"]
math_scores = [85, 92, 58, 76]
english_scores = [78, 88, 64, 82]

# 1. 使用 zip 与列表推导式构建结构化记录
records = []
for name, m, e in zip(students, math_scores, english_scores):
    total = m + e
    records.append({
        "name": name,
        "math": m,
        "english": e,
        "total": total
    })

# 2. 使用 all 校验全班单科是否全部达到及格线(60分)
is_all_math_pass = all(item["math"] >= 60 for item in records)
print(f"全班数学是否全及格: {is_all_math_pass}")  # 输出: False (王芳58分)

# 3. 使用 sorted 根据总分倒序排定名次(利用 key 参数)
ranked_records = sorted(records, key=lambda x: x["total"], reverse=True)

# 4. 使用 sum、len、round 计算全班平均总分
class_total_score = sum(r["total"] for r in ranked_records)
avg_score = round(class_total_score / len(ranked_records), 1)
print(f"全班平均总分: {avg_score}")

# 5. 使用 enumerate 携带名次格式化输出
print("\n--- 最终排名榜单 ---")
for rank, student in enumerate(ranked_records, start=1):
    print(f"第 {rank} 名: {student['name']:<4} | 总分: {student['total']} (数学:{student['math']}, 英语:{student['english']})")

# 示例最终控制台输出:
# 全班数学是否全及格: False
# 全班平均总分: 153.2
#
# --- 最终排名榜单 ---
# 第 1 名: 李华   | 总分: 180 (数学:92, 英语:88)
# 第 2 名: 张明   | 总分: 163 (数学:85, 英语:78)
# 第 3 名: 赵强   | 总分: 158 (数学:76, 英语:82)
# 第 4 名: 王芳   | 总分: 122 (数学:58, 英语:64)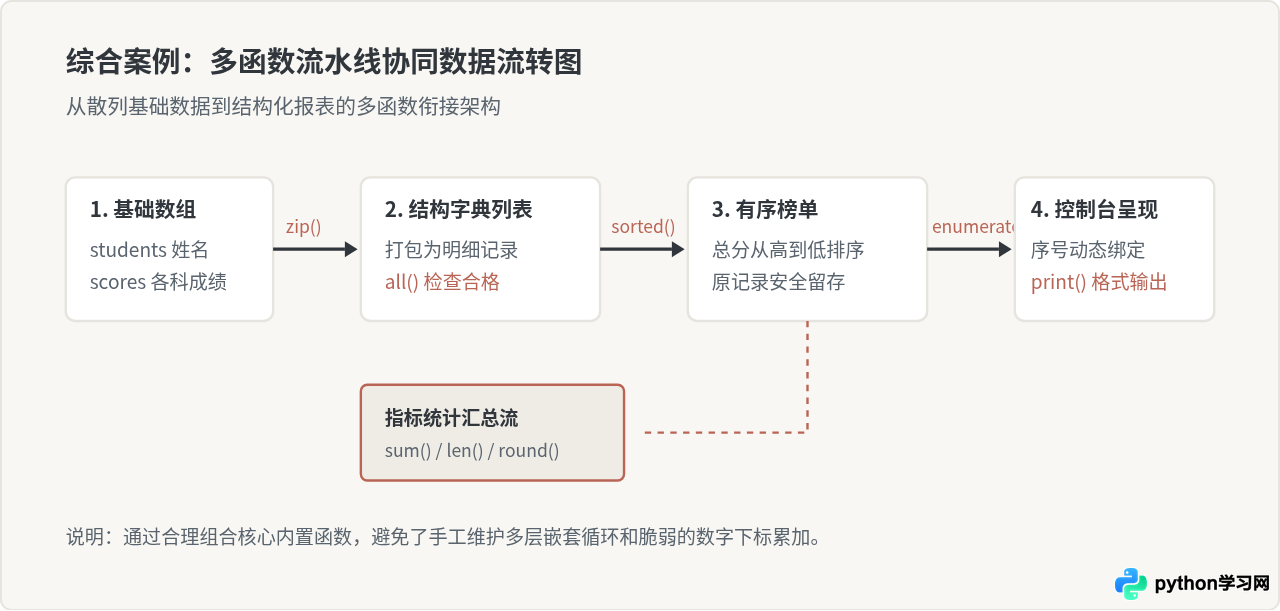
八、初学者必须牢记的避坑指南
- 严禁使用内置函数名作为自定义变量名:初学者极易写出
list = [1, 2, 3]或str = "hello"这样的代码。这虽然在当前赋值行不会报错,但它会覆盖全局作用域里的内置函数对象,导致后续再调用list()或str()时抛出TypeError: 'list' object is not callable。若不慎覆盖,可通过del list恢复内置映射。 - 小心
input()的隐式类型:始终牢记input()拿到的是文本。若要用于算术比较或加减,务必在外层嵌套int()或float()进行类型转换。 - 区分
sorted()与.sort():永远不要写data = data.sort(),这会使data丢失原本的数据并直接变为None。如果希望生成新对象,始终优先使用sorted()。 - 留意生成器对象的一次性消费:如
zip()和enumerate()返回的是迭代器对象。一旦遍历完一次,其内部指针便已走到末尾,再次对其循环将没有任何产出。如需多次使用,应提前使用list()将其固定为持久列表。
结语
掌握这20个核心内置函数,不仅能大幅削减日常代码量,更是写出地道 Pythonic 代码的第一步。在后续的学习与练习中,多尝试用 enumerate 代替下标索取,用 zip 进行多序列对齐,用 sum、min、max 和 sorted 替代冗长的算法循环,编程思路将会变得更加清晰而高效。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















