


pandas3.0里SettingWithCopyWarning为什么被移除?
深入解析 pandas 3.0 彻底移除 SettingWithCopyWarning 的底层原因,详解写时复制(Copy-on-Write)工作机制、链式赋值行为变革以及现代 pandas 的安全写法。
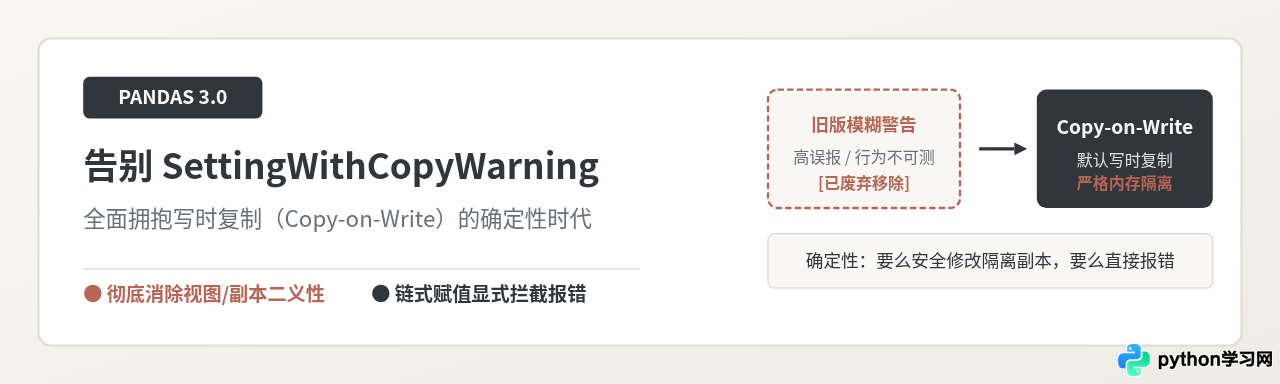
SettingWithCopyWarning 的核心原因,是全面默认启用了写时复制(Copy-on-Write,简称 CoW)机制。在过去的架构中,该警告之所以频发,是因为 pandas 无法静态判定切片对象究竟共享底层内存视图(View)还是持有独立副本(Copy),导致修改操作可能静默丢失或意外污染原始数据。在全面启用 CoW 后,切片与原数据之间的赋值操作拥有了确定性的写时隔离保护,而链式赋值也被直接升级为显式异常 ChainedAssignmentError。模糊不确定的中间状态被彻底根除,这一长期困扰开发者的警告便不再有存在的价值。
一、历史渊源:SettingWithCopyWarning 到底想防范什么?
要理解 SettingWithCopyWarning 为何在 pandas 3.0 中被移除,必须先回顾它在 pandas 1.x 和 2.x 时代试图解决的核心问题。该警告最初被设计出来的唯一目的,是在开发者进行切片赋值或链式索引赋值时,提醒他们注意底层内存行为的不确定性。
在日常数据处理中,很多初学者甚至有经验的工程师都写过如下形式的代码:
import pandas as pd

df = pd.DataFrame({
    'category': ['A', 'B', 'A', 'C'],
    'score': [70, 85, 92, 60]
})

# 常见写法:先通过条件筛选,再给目标列赋值
df[df['category'] == 'A']['score'] = 100
在 Python 解释器执行上述代码时,这行语句并不是单一操作,而是被分解为两个连续的方法调用:
__getitem__:首先调用df[df['category'] == 'A'],生成一个经过筛选的中间结果对象。__setitem__:接着对这个中间对象调用['score'] = 100尝试赋值。
致命的问题就在这里:第一步生成的中间对象,究竟是原 df 底层 NumPy 数组的一个视图(View),还是分配了全新内存的副本(Copy)?
在旧版 pandas 内部,这是由底层数据管理器 BlockManager 的内存布局决定的。如果数据是同质且连续的,可能返回视图;如果数据列跨越了不同类型、经过了碎片化拼接或多列组合,则极易生成临时副本。
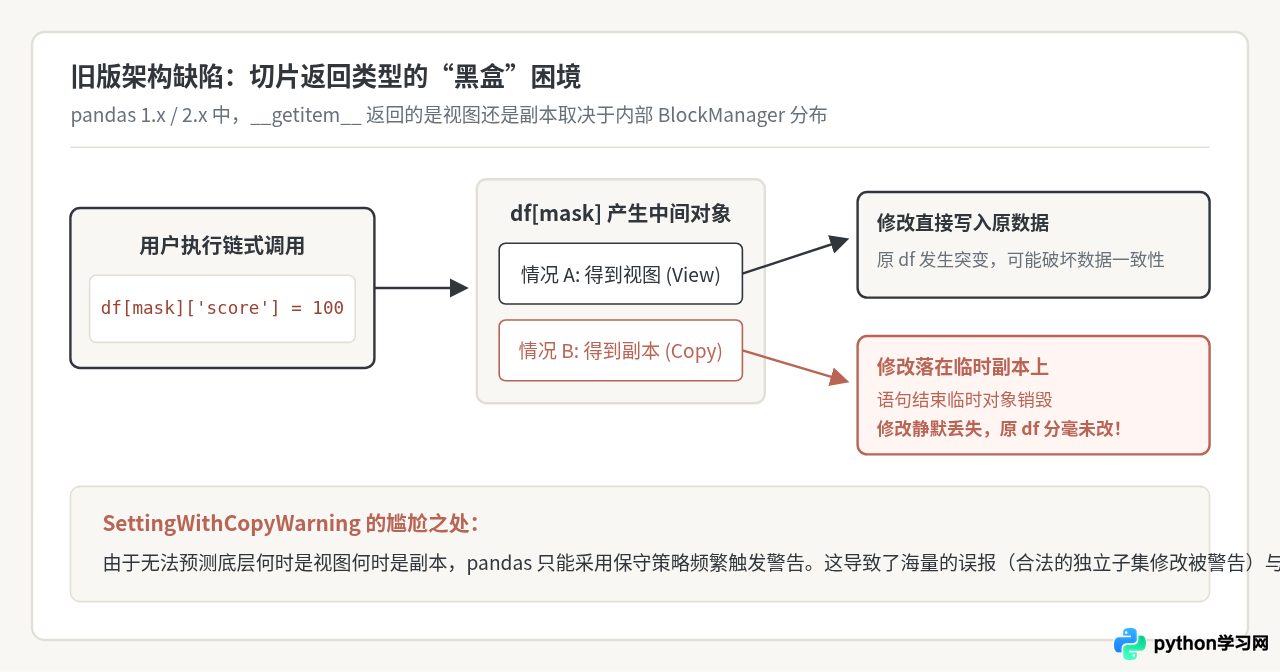
如果中间对象是副本,那么随后的 ['score'] = 100 修改的只是这个刚刚在内存中诞生的临时副本。当这行代码执行完毕,临时副本被 Python 垃圾回收机制销毁,原始 df 中的数据根本没有任何变化!
这种“代码没报错,但数据却没有任何修改”的静默失败极其危险。因此旧版 pandas 引入了 SettingWithCopyWarning。然而,因为判断机制存在缺陷,它带来的烦恼往往比它解决的问题还要多。
二、旧版警告的两大核心缺陷:误报泛滥与认知负担
在过去的长期实践中,SettingWithCopyWarning 被广大开发者戏称为“最令人抓狂的警告”,其根本问题不在于提示本身,而在于其实现机制上的固有局限:
-
高误报率(False Positives):
当开发者明确将一个切片赋值给独立变量,并打算将该变量作为新的子集使用时:
即便开发者完全不需要原sub_df = df[df['score'] > 60] sub_df['passed'] = True # 开发者本就打算修改 sub_df,并不关心原 dfdf同步改变,系统依然会弹出警告。开发者为了消除这行警告,只能机械性地在末尾追加.copy(),既增加了不必要的内存分配,又破坏了代码整洁。 - 高漏报率(False Negatives): 在复杂的嵌套结构或某些多列切片时,链式赋值有时即使发生了静默修改丢失,由于内部标志位重置未能及时触发,系统依然可能保持沉默。
- 无法给出确定性结论: 警告的提示文本通常是:“A value is trying to be set on a copy of a slice from a DataFrame... Try using .loc[row_indexer, col_indexer] = value instead.”。它无法确切告诉开发者“这次修改到底有没有生效”,迫使开发者每次都要打印数据反复核验。
三、破局之策:Copy-on-Write(写时复制)机制的引入
pandas 开发团队意识到,依靠静态警告修修补补根本无法解决内存二义性问题。从根本上解决这个痛点的唯一途径,是重构底层内存视图与所有权模型。这一方案就是从 pandas 2.0 开始测试、并在 pandas 3.0 中全面默认强制启用的机制——写时复制(Copy-on-Write,简称 CoW)。
Copy-on-Write 遵循一套极其严密且一致的原则:
-
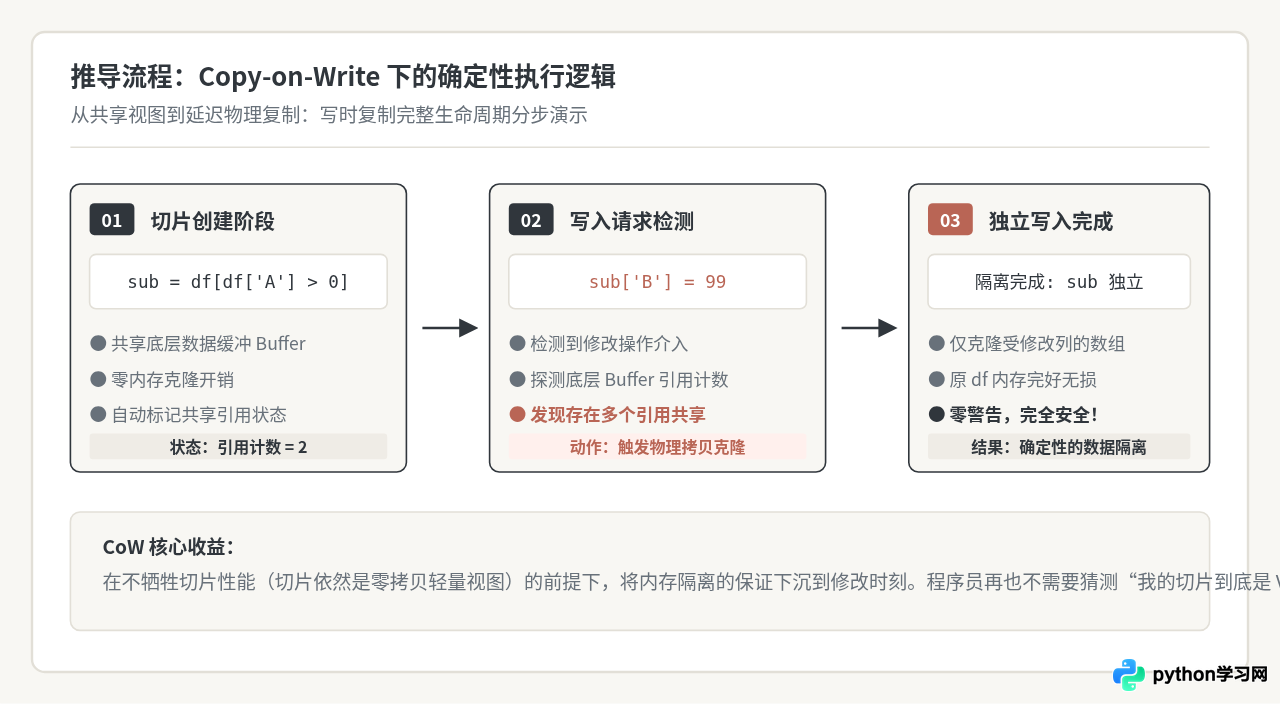
读取与切片阶段(延迟拷贝):
当你对 DataFrame 进行切片(例如
sub = df[0:5]或通过布尔掩码筛选)时,pandas 绝不主动分配全量新内存。新生成的子 DataFrame 直接引用原底层数据。此时两者共享内存只读视图,引用计数相应增加。这保证了极高的切片性能与极低的内存占用。 -
写入与修改阶段(写时触发):
当且仅当某个对象尝试发起修改(例如执行
sub['score'] = 99)时,pandas 内部会检查该数组是否被其他对象共享引用。如果发现存在共享,系统会在原地修改发生前,仅为即将修改的数据块自动复制一份全新的独立内存副本。
修改完成后,sub 指向新的独立内存,而原始 df 的底层数据完全未受影响。这意味着:任何从其他 DataFrame 衍生出的派生对象,其修改永远不可能意外回写或污染原始对象!
四、为什么 SettingWithCopyWarning 会被彻底移除?
当写时复制成为强制默认机制后,SettingWithCopyWarning 存在的理论基石彻底崩塌了。具体体现在两个层面:
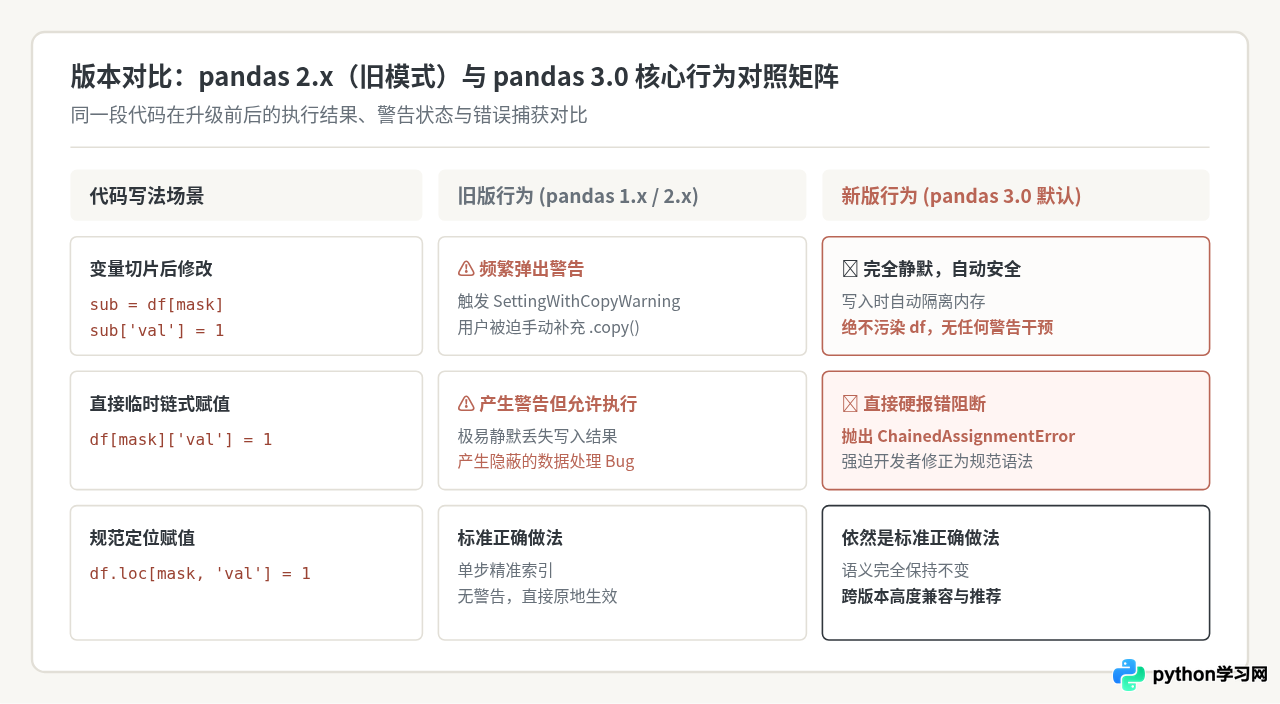
1. 针对变量切片:行为完全确定,无需再警示
在旧版中,执行以下代码必然弹出警告,因为 pandas 担心用户“不知道 sub 的修改会不会影响 df”:
sub = df[df['score'] > 60]
sub['status'] = 'Pass'
在 pandas 3.0 中,CoW 给出了一致且不可撼动的承诺:对 sub 的任何写操作,必然安全地发生在派生副本上,绝对不会影响 df。既然行为百分之百清晰、安全且符合绝大多数开发者的预期,那么任何警告提示都属于多余的噪音,应当被彻底移除。
2. 针对链式赋值:从“含糊警告”升级为“明确报错”
那么,对于那些原本确实存在逻辑错误的代码,例如临时链式赋值:
df[df['score'] > 60]['status'] = 'Pass'旧版 pandas 只是抛出一个警告(很多开发者由于日志繁杂而直接忽略),然后继续执行,导致更新悄悄失效。
但在 pandas 3.0 中,由于写时复制的严格约束,给一个临时对象赋值在语义上被判定为非法操作。pandas 3.0 不再抛出任何 Warning,而是直接抛出明确的异常:
pandas.errors.ChainedAssignmentError: A value is trying to be set on a copy of a DataFrame or Series through chained assignment.
When using Copy-on-Write, modifying a chained assignment will never modify the original DataFrame, and is therefore prohibited.
Use 'df.loc[row_indexer, col_indexer] = value' instead.
警告完成了使命,要么化为常态下的静默安全,要么升格为阻断隐蔽 Bug 的显式报错。因此,SettingWithCopyWarning 整体被官方彻底废弃并移除。
五、从旧代码迁移至 pandas 3.0 的实用规范
为了保证既有数据分析管道顺畅运行在 pandas 3.0 上,开发者应当遵循以下可落地的操作准则:
1. 原地修改原数据:始终使用 .loc 或 .iloc
如果你希望筛选条件满足后的更新直接反映在原始 DataFrame 上,务必放弃所有分步方括号语法,统一使用单步定位:
# 正确规范:单步传入行掩码与列名
df.loc[df['score'] < 60, 'status'] = 'Fail'

# 严禁写法(在 3.0 中将直接触发 ChainedAssignmentError):
df[df['score'] < 60]['status'] = 'Fail'
2. 独立处理子集:放心地移除冗余的 .copy()
在过去的脚本中,很多代码为了静音 SettingWithCopyWarning 写了大量的防御性拷贝:
# 过去为了避免警告而强行加 copy:
clean_subset = df[df['status'] == 'Pass'].copy()
clean_subset['bonus'] = clean_subset['score'] * 0.1

# 在 pandas 3.0 中,直接写即可:
clean_subset = df[df['status'] == 'Pass']
clean_subset['bonus'] = clean_subset['score'] * 0.1  # 安全、快速,自动触发 CoW
移除这些无谓的显式拷贝,不仅可以大幅减少内存周转,还能加快初始化执行速度。
.copy()?虽然写时复制会保护数据安全,但如果你的原始数据规模极大(例如几个 GB),而你只切出了其中很小的一部分(例如几百行)并长期保存在内存中,由于共享底层的 Buffer 强引用可能未被解除,原大数据块不会被 GC 及时回收。在这一特定场景下,显式调用
small_sub = df.head(100).copy() 可以切断对大底层的引用,及时释放内存。
3. 在既有环境中提前验证兼容性
如果你的生产环境目前还在运行 pandas 2.x(2.0 及更高版本),你可以无需等待迁移到 3.0,直接通过全局配置提前激活 Copy-on-Write 模式,以提前暴露代码库中隐藏的链式赋值错误:
import pandas as pd

# 在应用启动入口开启写时复制模式
pd.options.mode.copy_on_write = True

# 此时若代码库中有链式赋值,会立即抛出 ChainedAssignmentError 便于集中修复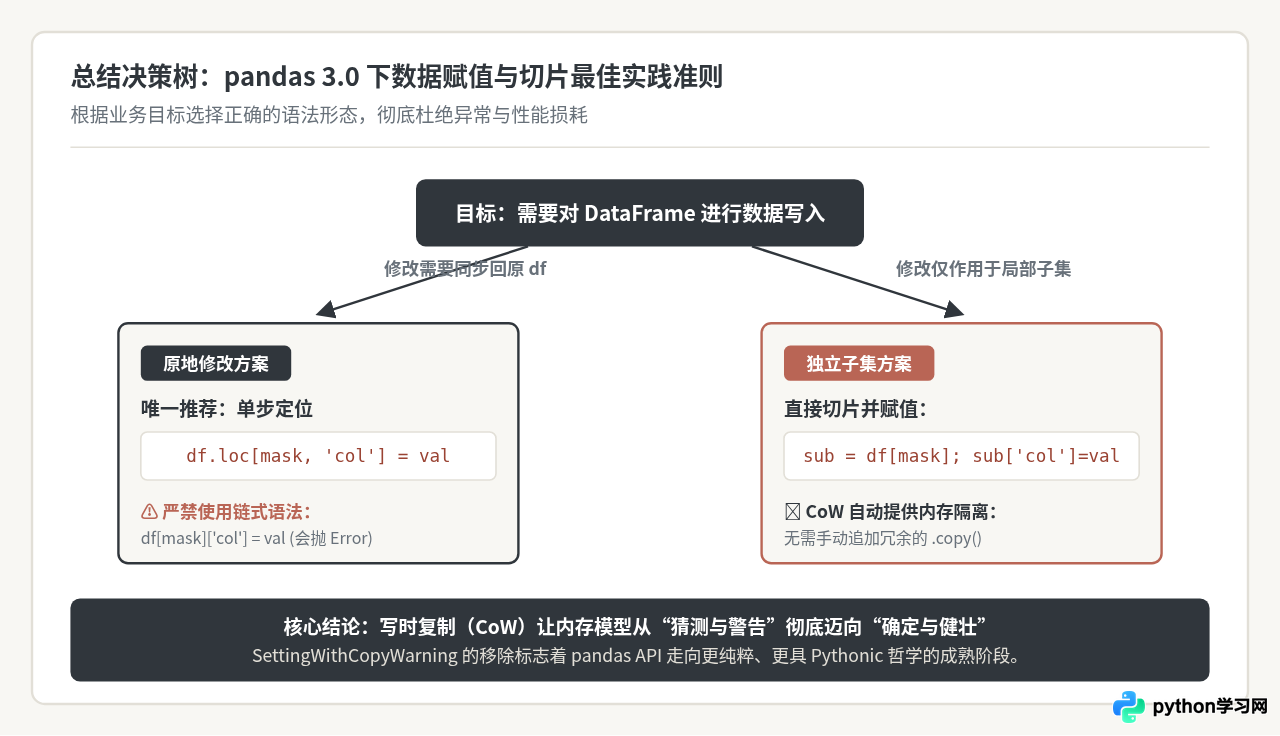
六、总结
SettingWithCopyWarning 的诞生与消亡,正是 pandas 发展史的一个生动缩影。在早期为了兼顾 NumPy 的切片性能而引入复杂 BlockManager 的历史背景下,它曾作为一道薄弱的防线,提醒用户谨防意料之外的内存副作用。
然而在长达数年的实际应用中,模棱两可的警告既无法根除隐蔽的数据错误,又极大地干扰了正常业务代码的编写。随着 pandas 3.0 正式全面落地写时复制(Copy-on-Write)机制:
- 切片与原 DataFrame 之间的修改永远拥有确定的内存隔离,绝不产生非预期的副作用;
- 容易引发静默数据丢失的临时链式赋值,直接被
ChainedAssignmentError拦截; - 对原数据的显式原地修改,依然由简洁直观的
.loc语法全权掌管。
当不确定的模糊状态彻底从系统底层被消除,作为权宜之计的 SettingWithCopyWarning 也就理所当然地退出了历史舞台。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















