


Python爬虫中chardet与charset-normalizer编码检测库怎么选
深入对比Python爬虫开发中两大主流字符编码检测库chardet与charset-normalizer的技术原理、检测性能、中文支持度与选型决策指南。
chardet是Python生态探测字节编码的事实标准;但从requests 2.26.0版本起,官方正式将默认探测库替换为charset-normalizer。对于现代爬虫项目,选型的核心结论十分明确:绝大多数新项目与高并发爬虫应优先选择charset-normalizer,其运行速度更快、内存开销更小、具备完全宽松的MIT开源许可;而chardet作为老牌经典库,在极度依赖历史经验参数或需要严苛匹配某些小众古老字符集的维护型项目中仍可继续保留。
一、为什么爬虫需要字符编码检测库?
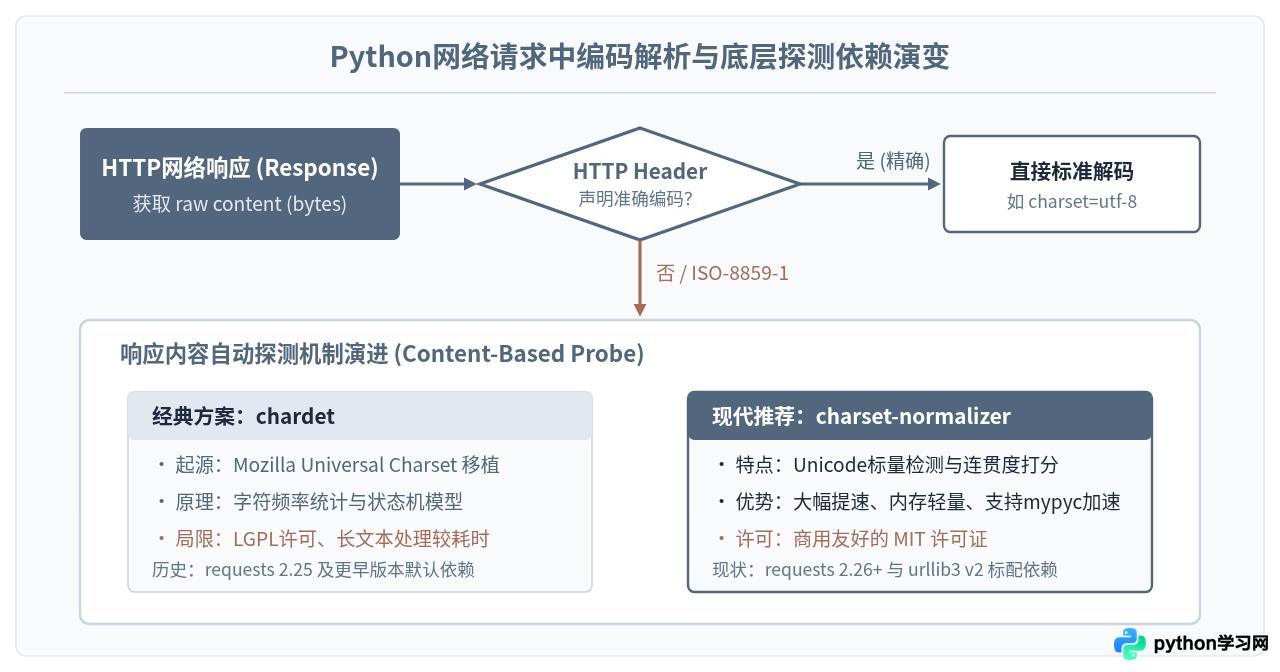
编写网络爬虫时,网络请求获取到的底层数据本质上都是二进制字节流(bytes)。通常情况下,HTTP响应头中的Content-Type字段会携带编码提示,例如text/html; charset=utf-8。然而,互联网上相当一部分历史网站或配置不规范的接口,常常出现响应头缺失charset参数,或者给出了错误的声明(例如将GBK或UTF-8页面一律标为ISO-8859-1)。
当HTTP头失效时,爬虫必须分析字节特征来推断真实编码。在这一过程中,如果直接使用错误的编码强行解码,程序轻则出现UnicodeDecodeError异常导致爬取中断,重则产生大面积难以察觉的生僻字符与问号乱码。字符编码探测库的作用,正是通过统计学特征、语言模型或Unicode属性,在毫秒级内推测出原始字节最有可能对应的编码名称及置信度。
二、chardet 与 charset-normalizer 的技术背景与核心差异
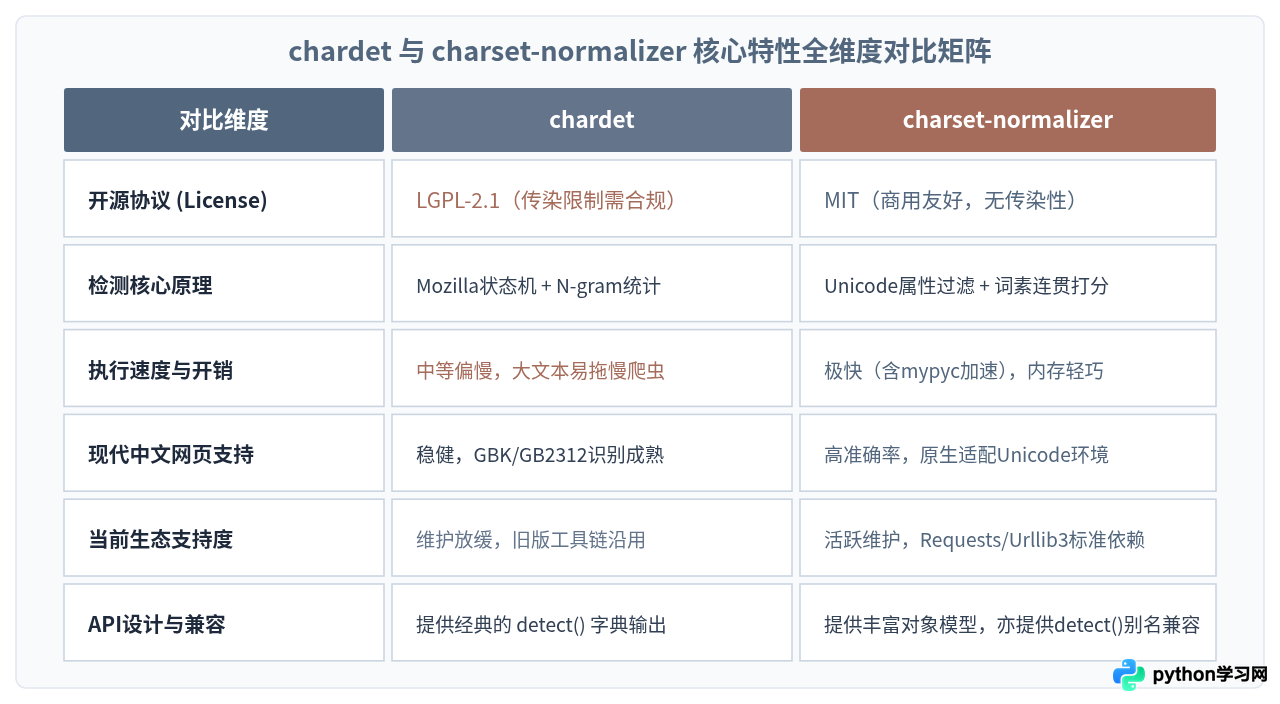
chardet是Python领域资格最老的编码检测工具,其底层思想移植自Netscape/Mozilla浏览器内部的通用字符集探测器(Universal Charset Detector)。它针对ASCII、UTF-8、GB2312、Big5、Shift-JIS、EUC-JP等几十种编码建立了专门的字节模式状态机与二元文法(2-gram)频率模型。这种设计成熟、理论完备,但完全基于Python层模拟状态跳转时,遇到大量HTML文本会导致CPU计算负载显著上升。
charset-normalizer则诞生于Python 3普及后的现代开发语境。它换了一种更为轻便高效的思路:首先基于Unicode字符属性,直接剔除明显不符合UTF-8或特定多字节编码规则的无效序列;随后利用语言字典连贯性与常用文字排布进行启发式打分。更重要的是,它提供了纯Python实现以及基于mypyc编译的C扩展优化,且采用了对开源与商业项目均十分宽容的MIT开源协议。
三、爬虫通用编码解析的最佳实践步骤
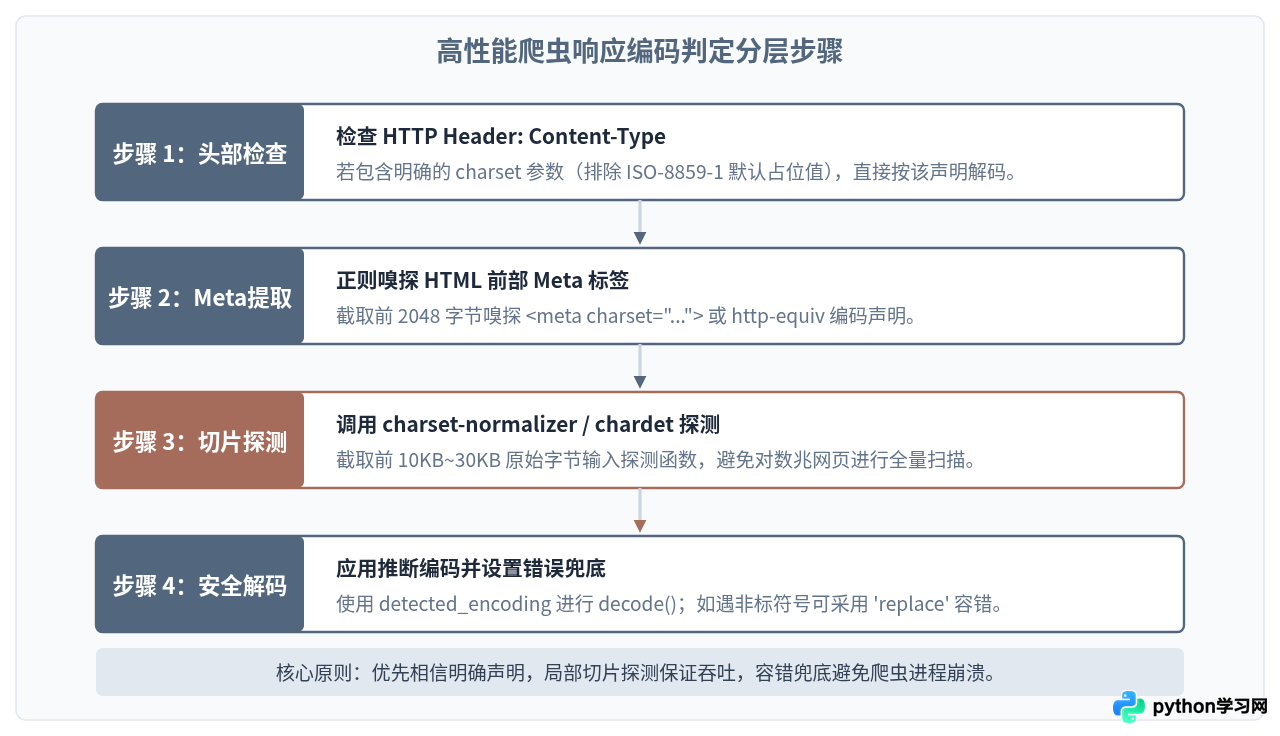
在实际编写爬虫时,不建议对获取到的每一个网页内容都直接盲目调用检测库。因为探测算法无论经过怎样的优化,都需要对字节流进行计算比对。如果爬虫并发量达到每秒几百甚至上千个页面,频繁全量检测会导致CPU迅速打满。
一个成熟健壮的爬虫编码判定流程,应当建立多层次的梯度判断机制:从开销最小的HTTP响应头开始,再到HTML自身的<meta>标签解析,最后才将原始字节切片交由探测库推断。
四、代码实战:API调用与爬虫解码封装
在代码层面,两个库的调用非常直截了当。为了方便开发者从旧代码迁移,charset-normalizer在包顶层同样提供了兼容旧版习惯的detect()接口。
1. 库的安装与依赖确认
# 现代环境安装推荐(MIT协议)
pip install charset-normalizer

# 传统环境安装(LGPL协议)
pip install chardet
2. 基础API调用范式对比
# 示例:使用 chardet 进行检测
import chardet

raw_data = "这是一段用于测试中文编码识别的示例文本".encode("gbk")
result_chardet = chardet.detect(raw_data)
# 典型返回结果: {'encoding': 'GB2312', 'confidence': 0.99, 'language': 'Chinese'}
print("chardet 检测结果:", result_chardet["encoding"], result_chardet["confidence"])

# 示例:使用 charset-normalizer 进行检测
import charset_normalizer

# 方式一:面向对象的精细化探测接口
results = charset_normalizer.from_bytes(raw_data)
best_match = results.best()
if best_match:
    print("charset-normalizer 最佳匹配:", best_match.encoding, best_match.chaos)

# 方式二:完全兼容 chardet 习惯的快捷函数
result_cn = charset_normalizer.detect(raw_data)
# 典型返回结果: {'encoding': 'gb18030', 'confidence': 0.99, 'language': 'zh'}
print("charset-normalizer detect 结果:", result_cn["encoding"])
3. 高并发爬虫中的防御性解码实用封装
在实际项目中,我们可以编写一个轻量级的通用解码工具函数。先截取前部内容探查声明,若无有效声明再截取前16KB输入charset-normalizer,兼顾准确度与吞吐效率:
import re
import charset_normalizer

META_CHARSET_PATTERN = re.compile(
    br'<meta[^>]+charset=["\']?([a-zA-Z0-9_\-]+)', re.IGNORECASE
)

def decode_html_content(raw_bytes: bytes, default_encoding: str = "utf-8") -> str:
    """
    智能解码网络爬虫获取到的 HTML 字节流。
    1. 快速嗅探 HTML meta 声明
    2. 切片调用 charset-normalizer
    3. 异常兜底解码
    """
    if not raw_bytes:
        return ""

    # 1. 尝试从前 2048 字节中匹配 HTML meta 标签
    head_slice = raw_bytes[:2048]
    meta_match = META_CHARSET_PATTERN.search(head_slice)
    if meta_match:
        encoding_candidate = meta_match.group(1).decode("ascii", errors="ignore").lower()
        # 规避历史常见别名问题:gb2312 宽容扩展为 gbk / gb18030
        if encoding_candidate in ("gb2312", "gbk"):
            encoding_candidate = "gb18030"
        try:
            return raw_bytes.decode(encoding_candidate)
        except UnicodeDecodeError:
            pass  # 若标签声明与实际内容不符,则继续向下探测

    # 2. 截取前 16KB 进行智能算法推断(避免整文件全量探测)
    probe_slice = raw_bytes[:16384]
    detected = charset_normalizer.detect(probe_slice)
    encoding_result = detected.get("encoding")

    if encoding_result:
        # 对国内中文常用编码进行别名规范
        if encoding_result.lower() in ("gb2312", "gbk"):
            encoding_result = "gb18030"
        try:
            return raw_bytes.decode(encoding_result)
        except UnicodeDecodeError:
            pass

    # 3. 最终保底:使用默认编码解码并替换无法解析的字符
    return raw_bytes.decode(default_encoding, errors="replace")
五、选型决策指南与工程避坑建议
在面对不同规模、不同生命周期的爬虫系统时,技术选型需要综合考虑法律合规、性能需求与维护成本:
- 新建网络爬虫系统或数据抓取中台:果断选择
charset-normalizer。除了性能优势,它与当前主流的网络库(requests、httpx、aiohttp相关生态)配合更为自然,且不会在分发闭源商用SDK或二进制包时引起LGPL协议的合规审查。 - 使用 Python 3.6 及更低版本的极老旧系统:如果受限于旧环境无法升级,由于
charset-normalizer在较新版本中逐步放弃了对早期Python 3分支的支持,此时chardet依然是行之有效的方案。 - 处理某些古老小众编码的特化爬虫:如果在抓取特定国家或冷门格式时发现
charset-normalizer打分不理想,可以保留chardet作为二级候选兜底。
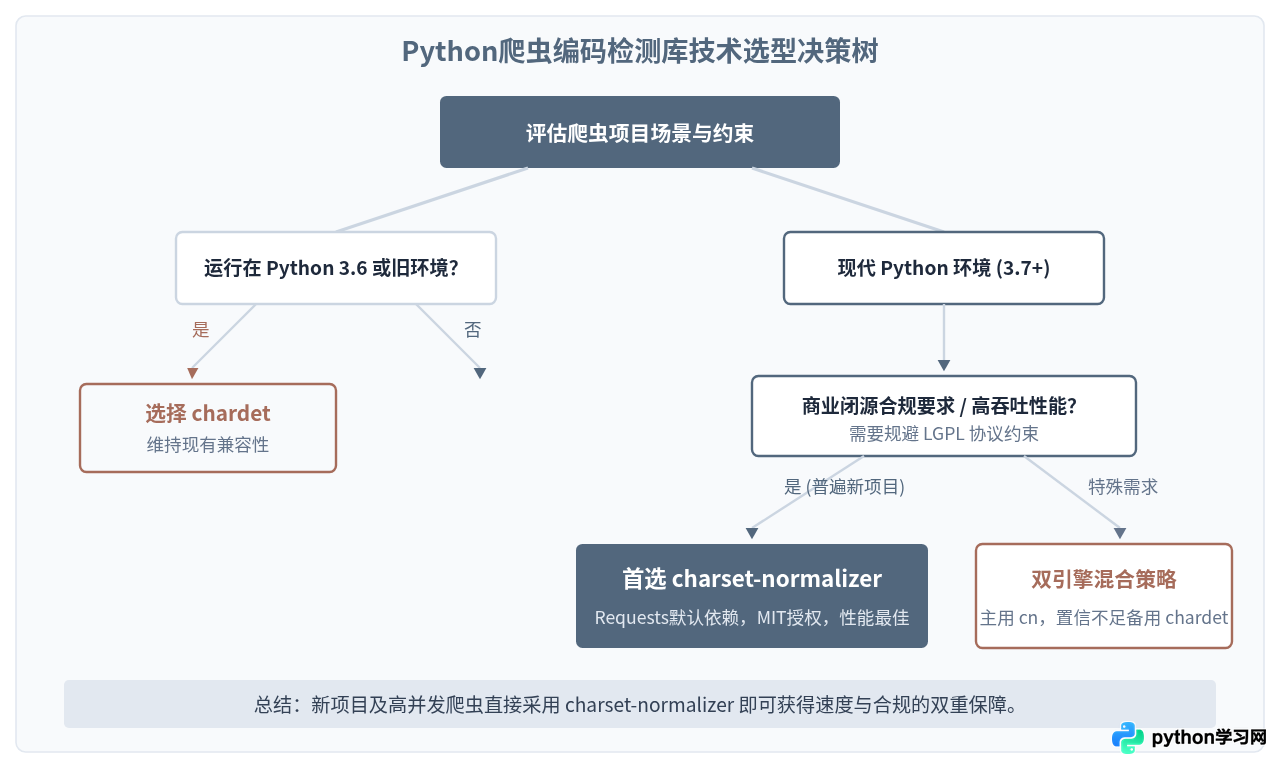
- GBK 与 GB18030 的超集特性:我国国家标准的GB18030向下完全兼容GBK和GB2312。当检测库识别出
GB2312或GBK时,在Python中建议统一指定为gb18030进行解码,可以完全避免遇到某些生僻人名或特殊符号时报错。 - 杜绝全量大文本盲目检测:爬虫下载大型文件(如PDF、超长文档、成兆的日志)时,切忌把全部字节直接传递给
detect(),这会无谓占用大量CPU。截取头部16KB~32KB足以给出高置信度结果。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















