


Python网络爬虫合法吗?新手必知的数据采集合规边界
针对Python爬虫初学者详细解析网络数据采集的法律与合规边界,从技术性质、法律红线、Robots协议解析到实操合规清单,帮助开发者安全编写爬虫。
简明结论:网络爬虫本身只是一种自动化HTTP请求与数据解析的技术手段,其法律属性呈“中立”状态。编写与运行Python爬虫在技术层面并不违法,但数据采集合法与否,严格取决于“怎么采集”(手段)以及“采集与使用了什么数据”(对象与目的)。厘清技术与法律红线,是每个新手在写出第一行抓取代码前必须掌握的常识。
一、技术中立与违法界限:爬虫合规的三个基本维度
在法律与监管实践中,评估一个爬虫项目是否合规,通常不会只看代码是用 Python 的 Requests 库、Scrapy 框架还是 Playwright 编写的,而是通过三个互相独立的维度进行归责判定:采集方式的合法性、数据客体的权利归属,以及后续使用行为的商业竞争属性。
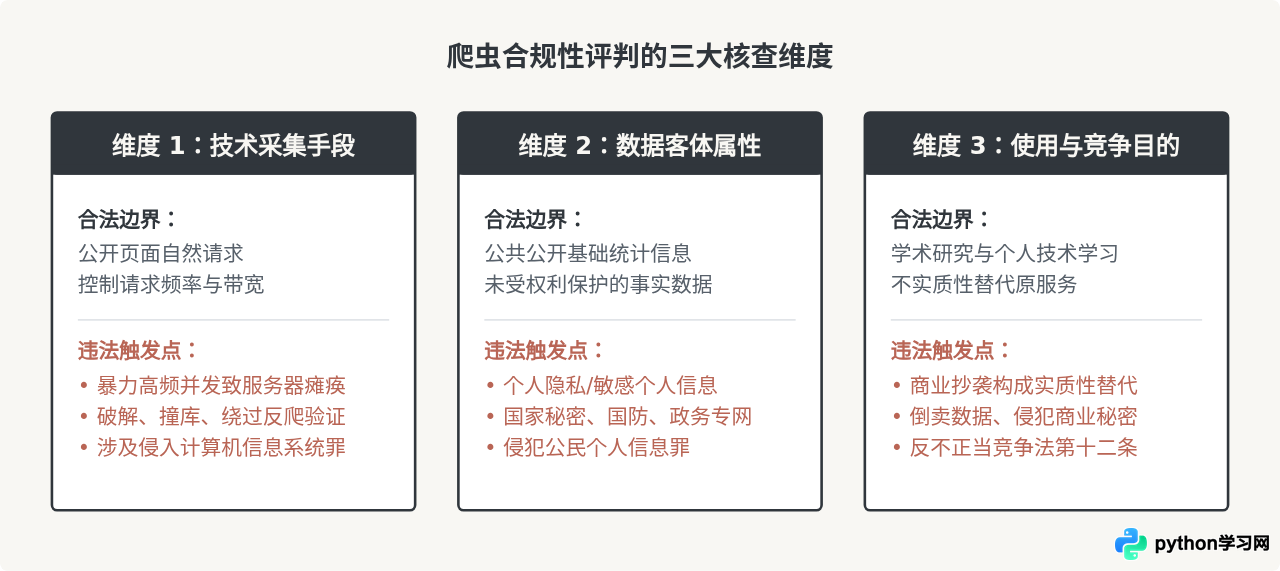
很多初学者常产生误解:“既然浏览器可以直接看到这些文字,那我用代码自动化批量拉取就肯定合法”。这种看法忽略了请求频率对服务器系统的侵害,以及批量处理对数据权利人合法权益的侵蚀。
二、新手必须绕开的三大核心法律红线
在我国现行法律体系中,爬虫相关的法律责任主要分布在《中华人民共和国刑法》、《中华人民共和国网络安全法》、《中华人民共和国个人信息保护法》以及《中华人民共和国反不正当竞争法》中。具体到实操,以下三类行为最易踩雷:
1. 非法侵入与破坏计算机信息系统
很多开发者在面对目标网站的反爬机制(如滑块验证码、设备指纹、Token加密、接口签名)时,倾向于使用逆向分析、自动化打码平台或修改请求头伪造身份。
如果目标网站设置了明确的权限验证或访问限制,而爬虫采取技术对抗手段“强行破解”、“越权读取”未公开接口,在司法认定中极易被归入《刑法》第285条规定的“非法获取计算机信息系统数据罪”。此外,若无节制的高并发爬虫导致目标网站带宽耗尽、数据库连接池溢出甚至宕机,可能构成“破坏计算机信息系统罪”。
2. 采集与买卖公民个人信息
《个人信息保护法》明确规定,自然人的个人信息受法律保护。姓名、手机号、身份证号、家庭住址、生物识别信息、行踪轨迹等均属于敏感范畴。
即使这些信息在某些平台上处于“半公开”或用户自主公开状态(如社交媒体主页、招聘平台简历),平台或个人并未授权第三方进行大规模批量抓取。未经被收集者明确同意,擅自抓取并集中存储个人信息,或将抓取到的数据打包出售、转让,达到一定数量门槛(如敏感信息几十条至数百条即可立案)即涉嫌触犯《刑法》第253条之一的“侵犯公民个人信息罪”。
3. 不当使用数据构成不正当竞争
在纯粹抓取公开商业数据(如电商商品价格、大众点评店铺评分、房产挂牌行情)的民事领域,原告往往依据《反不正当竞争法》提起诉讼。司法判例中的核心考量是“实质性替代原则”与“不合理增加运营成本”:如果爬虫方抓取竞品的核心商业数据,直接用作自身业务运营,免费搭便车分流了原平台的流量与用户,就会被判决构成不正当竞争并承担巨额赔偿。
三、合规检查第一步:读懂并遵守 Robots 协议
robots.txt(网络爬虫排除协议)是网站管理员放在根目录下的文本文件,用于告知自动化爬虫哪些目录可以访问,哪些目录禁止抓取。虽然它本身属于行业自律标准,在国际法与国内法中并非严格的成文法,但法院在审理不正当竞争和侵入系统纠纷时,往往将 robots.txt 作为评估网站主观授权范围与被告主观恶意的重要证据。
1. 如何定位与阅读 robots.txt
在任意网站主域名后添加 /robots.txt,即可在浏览器直接查看。例如:https://example.com/robots.txt。常见的语法规则如下:
# 示例:典型的 robots.txt 结构
User-agent: *
Disallow: /api/
Disallow: /admin/
Disallow: /user/private/
Crawl-delay: 2

User-agent: BadBot
Disallow: /
规则说明:
User-agent: *:表示对所有爬虫软件生效的通用规则。Disallow: /api/:禁止任何通用爬虫访问/api/路径及其子路径。Crawl-delay: 2:建议爬虫每次请求之间间隔 2 秒以上。User-agent: BadBot与Disallow: /:全站拒绝名为 BadBot 的爬虫。
2. 使用 Python 原生库自动化解析 Robots
开发爬虫前,不必每次手动肉眼核查。Python 标准库自带了 urllib.robotparser 模块,可直接用于自动化判断目标 URL 是否允许被抓取。
import urllib.robotparser

# 初始化解析器
rp = urllib.robotparser.RobotFileParser()
# 设置目标网站的 robots.txt 绝对路径
rp.set_url("https://www.example.com/robots.txt")
rp.read()

# 模拟自定义爬虫名称
user_agent = "MyFriendlyBot"

# 检查特定 URL 是否允许抓取
target_url_1 = "https://www.example.com/public/news.html"
target_url_2 = "https://www.example.com/api/v1/users"

print("news.html 可抓取:", rp.can_fetch(user_agent, target_url_1))
print("users API 可抓取:", rp.can_fetch(user_agent, target_url_2))
输出结果示例:
news.html 可抓取: True
users API 可抓取: False
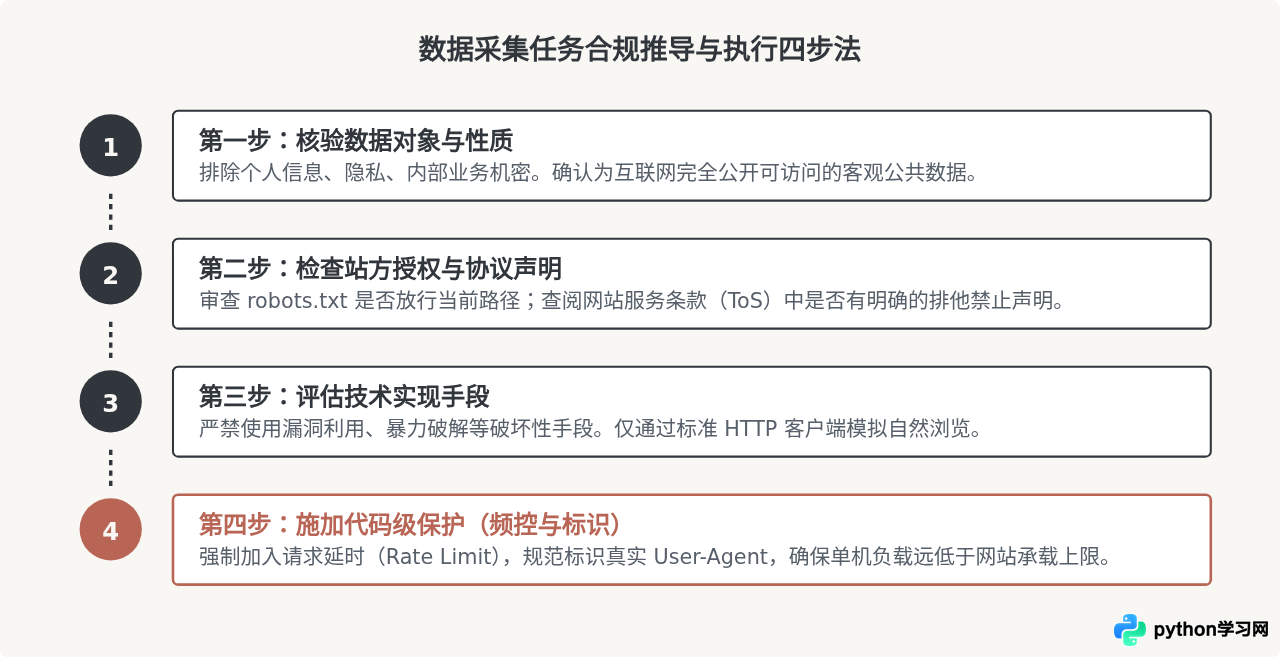
四、合规评估操作流程:从立项到运行的四步法
在真正敲定一个采集任务之前,新手应遵循一套固定的推导与验证流程,以此排查潜在的法律与技术风险。
五、文明爬虫实操:代码层面的合规技术模式
合规理念必须落地到具体的代码中。在编写 Python 爬虫脚本时,一个合规的爬虫程序应该至少具备清晰的身份标示、速率限制、异常退避机制与超时重试控制。
下面是一个使用标准 requests 库编写的“防御型与礼貌型”爬虫模板:
import time
import logging
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

# 配置日志便于追踪审计
logging.basicConfig(level=logging.INFO, format="%(asctime)s - %(levelname)s - %(message)s")

# 1. 规范的身份标示:向站长明确告知身份及联系方式,便于站长沟通,避免被直接标记为黑客攻击
HEADERS = {
    "User-Agent": "ResearchDataCollector/1.0 (+http://example.com/bot; contact@example.com)",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
}

def create_safe_session() -> requests.Session:
    """创建带有合理超时与退避策略的请求会话"""
    session = requests.Session()
    session.headers.update(HEADERS)

    # 2. 失败重试策略(避免短时间内暴力重试冲击服务器)
    retries = Retry(
        total=3,
        backoff_factor=1,  # 重试间隔逐步增加:1s, 2s, 4s
        status_forcelist=[429, 500, 502, 503, 504],
        raise_on_status=False
    )
    adapter = HTTPAdapter(max_retries=retries)
    session.mount("http://", adapter)
    session.mount("https://", adapter)
    return session

def fetch_data_safely(url_list: list, delay_seconds: float = 2.0):
    session = create_safe_session()

    for url in url_list:
        try:
            # 3. 必须设置超时时间,防止挂起占用服务器连接池
            response = session.get(url, timeout=5)

            if response.status_code == 200:
                logging.info(f"成功获取页面: {url}")
                # 处理数据解析逻辑(如 BeautifulSoup 提取)
            elif response.status_code == 429:
                logging.warning(f"触发频率限制(429),立即中止或深度睡眠: {url}")
                break
            else:
                logging.warning(f"服务器返回非200状态: {response.status_code} - {url}")

        except requests.exceptions.RequestException as e:
            logging.error(f"网络异常: {url}, 原因: {e}")

        # 4. 强制延迟:严格控制访问速率,降低对站方服务器的负荷
        time.sleep(delay_seconds)

if __name__ == "__main__":
    sample_urls = [
        "https://httpbin.org/get",
        "https://httpbin.org/status/200"
    ]
    fetch_data_safely(sample_urls, delay_seconds=1.5)
当目标服务器返回 429 或 503 时,说明你的爬虫已触发了对方的防护阈值或给对方带来了性能压力。正确的做法是立即停止采集脚本,检查并调大 delay_seconds,而不是立刻切换高匿代理 IP 池或使用多线程继续施压。强行对抗往往是构成系统破坏或民事侵权案件的直接导火索。
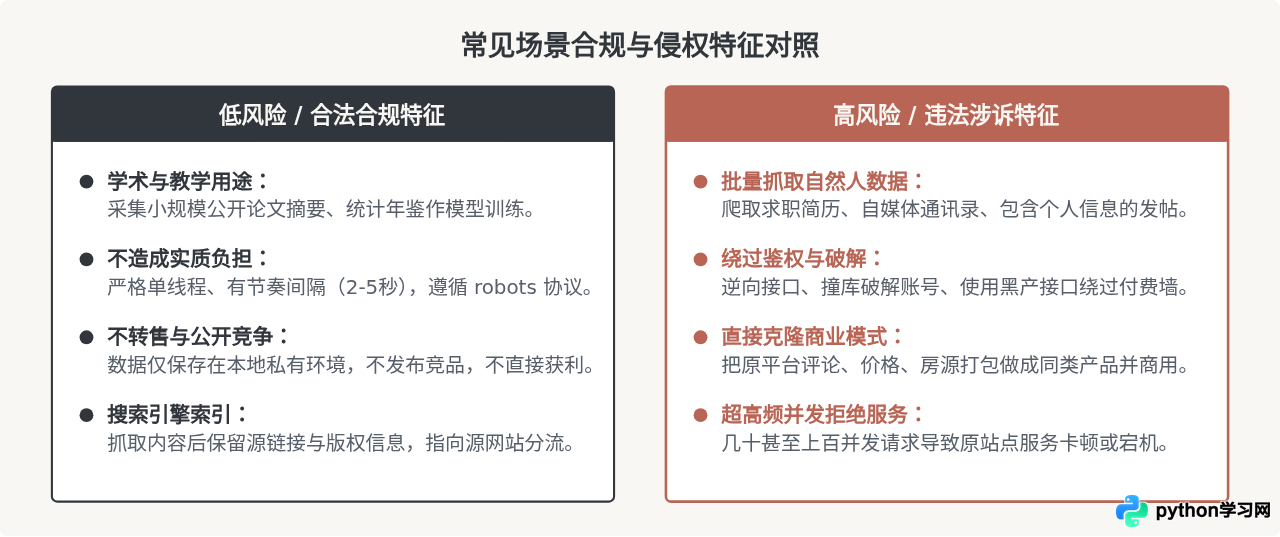
六、数据采集合法与非法场景对比
为帮助初学者直观判断自己手头的项目是否存在合规隐患,下面列举了常见场景的技术与法律差异分析:
七、总结:新手的爬虫自我保护原则
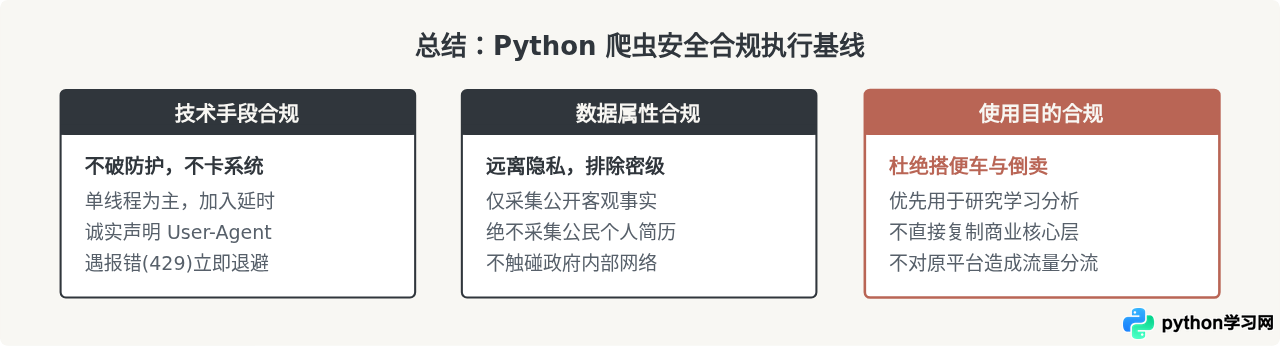
掌握 Python 爬虫技术能够极大提高信息处理与研究分析的效率,但在敲击键盘前,请牢记以下三条底线原则:
- 凡涉个人信息,绝不上规模采集:对任何含有自然人隐私属性的数据保持敬畏,不存储、不清洗、不出售。
- 凡遇权限控制,绝不强行突破:需要账号密码、支付授权或带有防篡改签名的接口,意味着权利人明确拒绝未授权访问,任何技术对抗手段都会显著增加法律风险。
- 凡写采集逻辑,必带速率限制:遵守
robots.txt,将请求延时写在每次循环内,让你的代码表现得像一个文明、自律的访问者,而非发起分布式拒绝服务的攻击脚本。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















