


Python Pandas DataFrame导出CSV的to_csv参数详解
详细解析Python Pandas中DataFrame.to_csv()的核心参数用法,涵盖行列结构控制、数值与缺失值格式化、Excel中文乱码解决方案、特殊符号转义及大文件分块压缩导出技巧。
在日常数据清洗、分析与管道传输中,将内存中的 Pandas DataFrame 导出为 CSV 文件是最基础也最高频的操作。Pandas 提供的 to_csv() 方法内置了数十个参数,用于精细控制导出的文本结构、编码兼容性、浮点数精度、特殊字符包裹以及大文件压缩。如果仅使用默认配置,经常会遇到索引列无端自增、Excel 打开中文乱码、长数字变成科学计数法等典型困扰。本文系统梳理 to_csv() 的参数体系与常用配置组合,帮助读者在不同业务场景下稳定输出合规的 CSV 文件。
一、基础语法与导出标准流程
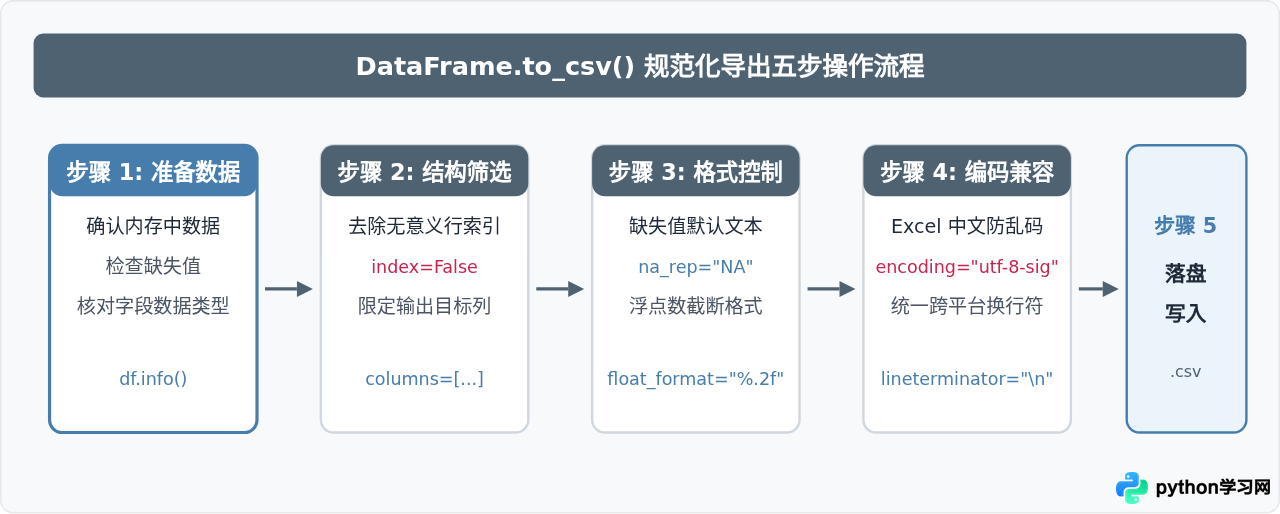
调用 DataFrame.to_csv() 的标准形式非常简单,最简调用只需要传入目标保存路径。其完整函数签名包含了多个控制阶段:从目标路径定位、行列选取,到格式转义、编码指定与缓冲区落盘。
import pandas as pd

# 创建示例数据
data = {
    "emp_id": ["E101", "E102", "E103"],
    "name": ["张伟", "李芳", "王强"],
    "salary": [12500.50, 18000.00, None],
    "join_date": pd.to_datetime(["2022-03-15", "2021-08-01", "2023-11-20"])
}
df = pd.DataFrame(data)

# 最基础的导出方式
df.to_csv("employees_raw.csv")
上述代码直接将整个表格写入 employees_raw.csv。但为了保证输出文件整洁且契合下游系统的接收要求,通常需要经过明确的参数配置阶段。
二、行列与结构控制参数
导出时最核心的需求是控制“哪些数据写出”以及“表头和索引如何排列”。以下四个参数决定了 CSV 文件的基本行列外观。
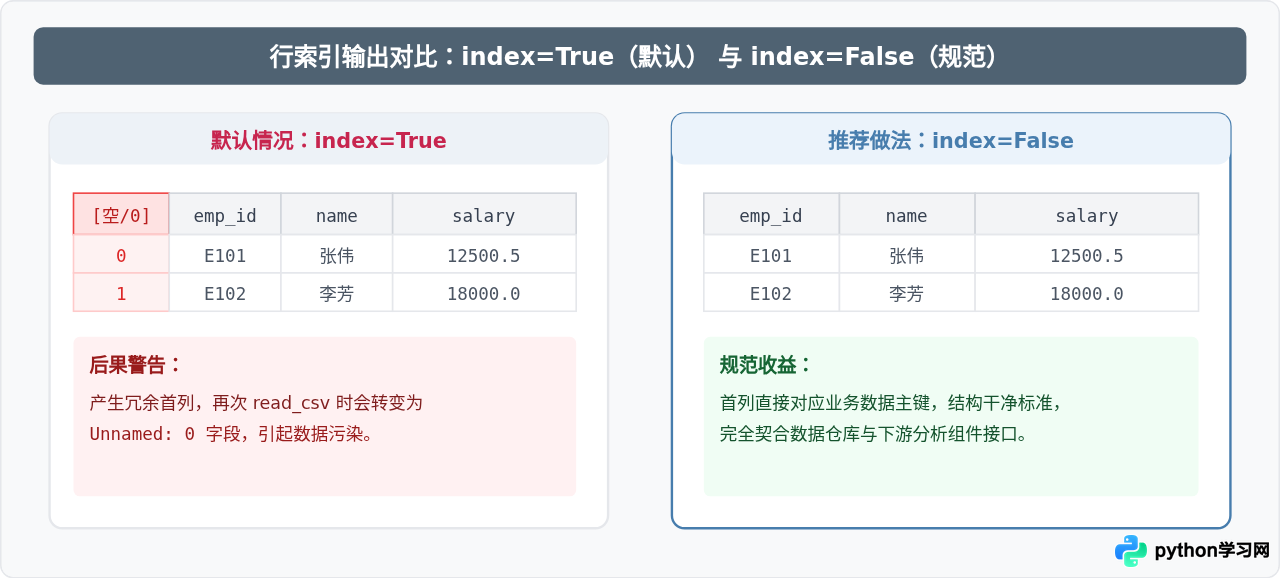
1. index(行索引开关)
默认值:True。这是初学者最容易踩坑的参数。默认情况下,Pandas 会把 DataFrame 的行索引(如 0, 1, 2...)作为 CSV 的第一列写入。如果不加以干预,当下一次使用 pd.read_csv() 读取该文件时,如果没有显式指定 index_col,Pandas 又会为其生成新的默认索引,导致出现诸如 Unnamed: 0、Unnamed: 0.1 这种无意义累加列。
# 推荐做法:绝大多数常规业务数据导出均需显式关闭索引
df.to_csv("output.csv", index=False)
2. header(列名控制)
默认值:True。可以传入布尔值或字符串列表:
header=True:正常输出当前 DataFrame 的列名作为 CSV 第一行。header=False:不输出列头,纯数据行输出,常用于增量追加写入场景。header=['员工编号', '姓名', '薪资', '入职日期']:直接在导出时映射自定义的列名,无需先在内存中重命名 DataFrame。
3. columns(列字段筛选)
默认值:None。当 DataFrame 包含非常多列,但当前任务只需要输出特定字段时,无需进行切片生成中间变量,直接传入列名列表即可:
# 仅导出工号和姓名两列
df.to_csv("employees_simple.csv", index=False, columns=["emp_id", "name"])
4. index_label(索引列名指定)
默认值:None。如果业务需求确实需要保留行索引(例如设置了时间戳作为索引 df.set_index('join_date')),通过 index_label="日期" 可以为第一列索引明确指定 CSV 表头名称,避免产生空表头单元格。
三、格式与缺失值控制参数
纯文本格式对于数值、空值和日期的表达十分敏感。合理利用格式化参数可以有效减小文件体积并保证下游解析准确。
1. sep(字段分隔符)
默认值:','(逗号)。虽然 CSV 的全称是逗号分隔值,但在很多特殊场景中,文本字段内本身就充斥大量中文逗号或标点。此时改用其他分隔符可以减少引用符号:
sep='\t':输出制表符分隔文件(TSV),常用于生物信息或与剪贴板交互。sep='|':输出以竖线分隔的纯文本文件,在电信与金融大型数据仓储中非常流行。
2. na_rep(缺失值表示符号)
默认值:空字符串 ''。当 DataFrame 中存在 np.nan 或 None 时,默认导出的结果是两个连续分隔符(如 101,,张三)。如果需要与 SQL 数据库中的 NULL 或统一缺失值标记对齐,可通过该参数设定:
# 将缺失数据导出为明确的 NULL 标识
df.to_csv("clean_data.csv", index=False, na_rep="NULL")
3. float_format(浮点数格式化输出)
默认值:None。如果 DataFrame 中存在计算产生的浮点数,可能会导出形如 3.141592653589793 的长串字符。这不仅大幅增加磁盘占用,还会引起精度波动。传入标准的 Python 格式化字符串可以精简输出:
# 统一将所有浮点数保留两位小数
df.to_csv("formatted_finance.csv", index=False, float_format="%.2f")
4. date_format(日期时间格式)
默认值:None。针对 datetime64 类型的列,默认输出是包含毫秒的 ISO 格式(如 2023-11-20 00:00:00)。如果仅需要精确到天或需要特定格式:
df.to_csv("output_dated.csv", index=False, date_format="%Y-%m-%d")四、编码兼容与特殊字符转义
字符编码与特殊符号冲突是导致“文件乱码”和“行错位”的两大罪魁祸首。正确理解以下参数对于工程落地至关重要。
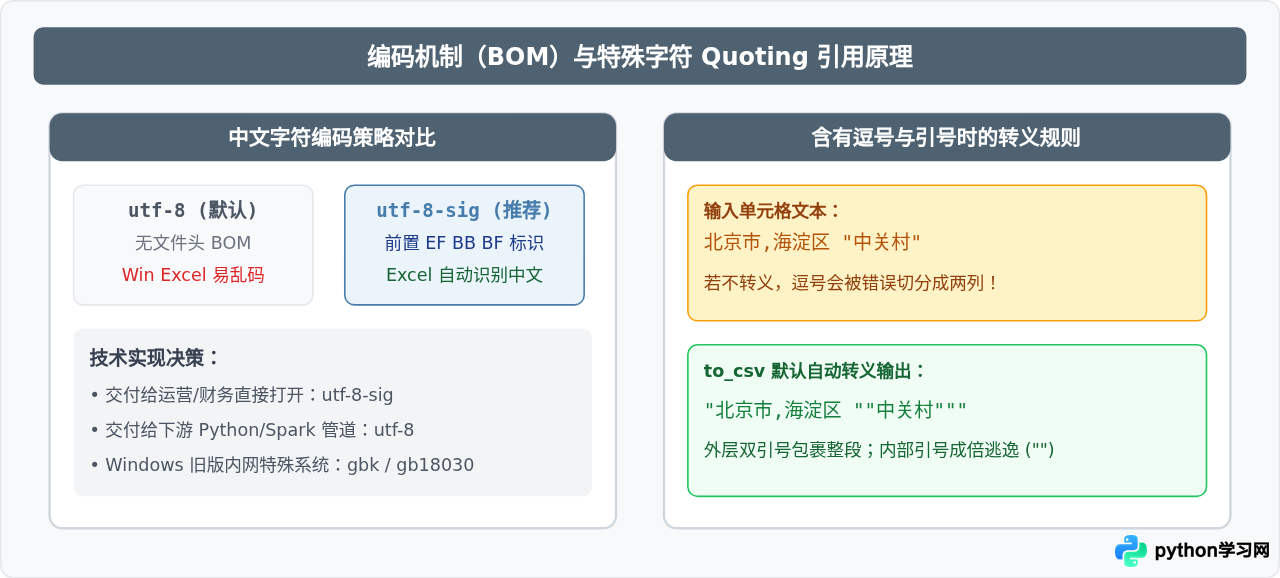
1. encoding="utf-8-sig"(Excel 中文乱码终结者)
Pandas 在 Linux 和 macOS 下默认采用 utf-8 编码。但在 Windows 平台上,微软 Excel 打开无 BOM(Byte Order Mark)标记的标准 UTF-8 文件时,会默认按照系统的 ANSI 编码(如中文系统的 GBK)解码,从而导致中文字符全部变成乱码。
encoding="utf-8-sig"。它会在文件最前部注入 3 个字节的 BOM 标头(0xEF, 0xBB, 0xBF),强制提示 Excel 按照 UTF-8 解码。如果是供 Linux 服务器程序或大模型清洗脚本读取,则使用默认的 utf-8 即可。
2. quoting 与 quotechar(引用与转义规则)
当字段文本本身包含逗号、双引号或回车符时,CSV 必须通过外层引号进行保护。该逻辑由 Python 内置的 csv 模块常量驱动:
quoting=csv.QUOTE_MINIMAL(默认):仅当内容含有分隔符、换行符或引号时才使用引号包裹。quoting=csv.QUOTE_ALL:对所有单元格均加上双引号包裹。常用于防止数字被 Excel 自动转换为科学计数法。quoting=csv.QUOTE_NONNUMERIC:对所有非数字列加引号。quotechar='"':包裹引用的字符,默认为双引号。escapechar='\\':当quoting=csv.QUOTE_NONE(不使用引号)时,用来转义内部特殊字符的转义符。
五、性能优化与特殊导出场景
在处理超大规模数据集或自动化管道时,内存控制与网络传输带宽是首要考量点。以下三个参数能够显著提升工业级导出的稳定性。
1. compression(在线压缩输出)
默认值:'infer'。Pandas 能够根据输出文件名的后缀自动推断压缩格式(如 .gz, .zip, .bz2, .xz),或者显式指定字典配置:
# 自动识别 .gz 扩展名并以 gzip 流式压缩输出,节省 80% 以上磁盘空间
df.to_csv("huge_dataset.csv.gz", index=False)

# 显式指定压缩参数与归档内文件名
df.to_csv("dataset.zip", index=False, compression={"method": "zip", "archive_name": "data.csv"})
2. mode='a'(增量追加写入)
默认值:'w'(覆写)。当编写爬虫脚本或轮询监听任务时,需要持续将新增的数据行追加到既有 CSV 文件的末尾。此时应将写入模式调整为追加 'a',并关闭表头输出以防多次写入标题行:
import os

file_exists = os.path.exists("sensor_logs.csv")
# 如果文件已存在,则追加且不写表头;如果是首次创建,则写入表头
df_new_records.to_csv(
    "sensor_logs.csv",
    mode="a",
    index=False,
    header=not file_exists
)
3. chunksize(分块流式写入)
当 DataFrame 本身体积过大时,一次性转换为庞大的 CSV 文本并落盘可能会造成峰值内存瞬间飙升。通过设定 chunksize=50000,Pandas 会按批次将数据行序列化为文本行,避免内存溢出(OOM)。
4. path_or_buf=None(输出到内存字符串)
如果不需要将数据写入磁盘文件,而是希望将其直接作为 HTTP 响应体、日志信息或上传到对象存储,可以省略目标路径(或设置 path_or_buf=None),此时 to_csv() 会直接返回一个由 CSV 构成的纯 Python 字符串:
csv_string = df.to_csv(index=False)
print(csv_string[:100])  # 直接获得字符串对象
六、核心参数全景与场景配置速查
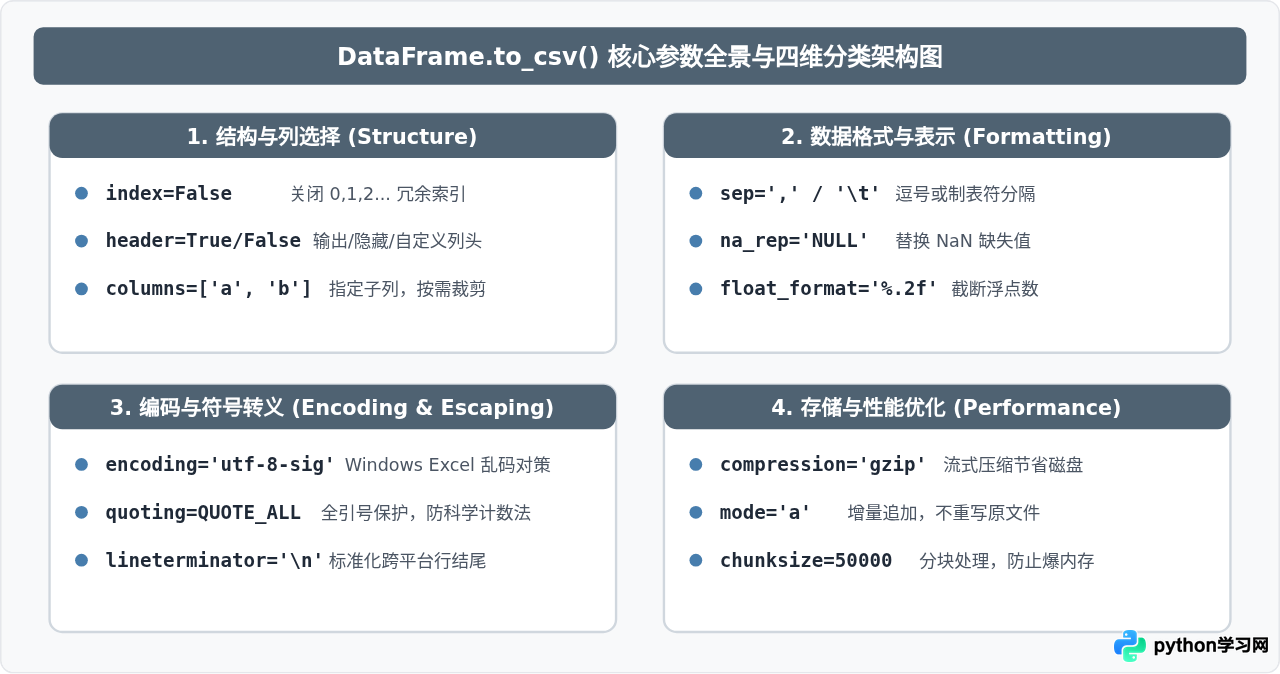
为了便于在日常开发中快速定位,下表汇总了最常用的参数组合与推荐取值:
| 分类 | 参数名称 | 默认值 | 常用推荐值 | 功能简述 |
|---|---|---|---|---|
| 结构控制 | index |
True | False | 是否输出行索引,绝大多数情况推荐设为 False |
columns |
None | ['colA', 'colB'] | 指定导出的字段子集,过滤无关冗余列 | |
| 内容格式 | na_rep |
'' | 'NA' 或 'NULL' | 缺失值(NaN)在文本文件中的显式替换字符 |
float_format |
None | '%.2f' | 截断浮点数格式,统一小数位并降低存储开销 | |
date_format |
None | '%Y-%m-%d' | 日期时间对象的输出格式模板 | |
| 编码兼容 | encoding |
None(utf-8) | 'utf-8-sig' | Windows Excel 打开中文防乱码的必选参数 |
quoting |
QUOTE_MINIMAL | QUOTE_ALL | 为所有非空列强制添加双引号,防止科学计数法 | |
| 存储性能 | compression |
'infer' | 'gzip' | 导出时实时流式压缩,减少磁盘及网络 I/O |
mode |
'w' | 'a' | 文件写入模式,'a' 配合 header=False 用于增量追加 |
七、总结与最佳实践模板
在绝大多数日常工程实践中,推荐采用以下标准模板作为 to_csv() 的基础配置模板,既兼顾了 Excel 用户的打开体验,又杜绝了冗余索引列的累积:
import pandas as pd

# 生产环境推荐通用导出模式:
df.to_csv(
    "final_report.csv",
    index=False,                  # 移除默认的自增整数行号
    encoding="utf-8-sig",         # 兼容 Windows Excel 直接打开中文无乱码
    float_format="%.2f",          # 保留两位小数,避免浮点数精度膨胀
    na_rep="NULL",                # 缺失值显式表达,方便数据库导入
    date_format="%Y-%m-%d"        # 统一规范日期格式
)
掌握这套参数配置后,无论面对数百万行的日志数据归档,还是日常面向业务人员的报表分发,都能做到输出精准、格式标准、跨平台零阻碍。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















