


GitHub上可替代商业软件的免费Python开源工具
解析GitHub上基于Python构建的高质量开源工具,如何替代Tableau、Airtable、Labelbox及Zapier等昂贵商业软件,涵盖功能映射、部署运维与选型边界。
商业SaaS软件往往按坐席与调用量梯次收费,长期使用会带来显著且持续的财务负担。本文梳理GitHub上基于Python技术栈开发、可直接私有化部署并对标主流商业产品的核心开源工具,围绕业务智能报表、多维表格协同、AI训练数据标注以及定时任务流水线四个高频场景,提供实际可落地的替代方案与落地指导。
一、商业闭源与Python开源生态的功能映射
选择替代品的前提并非盲目追求“完全相同”,而是明确自身核心功能需求是否在开源软件的能力覆盖区间之内。商业软件的高溢价通常体现在多租户权限细化管理、开箱即用的技术支持以及托管基础设施;而以Python为核心驱动的开源项目,则胜在生态透明、二次开发门槛低、数据绝对驻留在本地内网,以及极高的自定义灵活性。
Python在数据工程、Web后端接口与机器学习底层占据主导地位,这也决定了此类开源项目在底层协议打通和逻辑扩展上具备天然优势。如果业务需要对接特有的私有数据库或自定义校验算法,修改Python代码或编写原生插件的成本远低于向商业软件厂商定制功能。
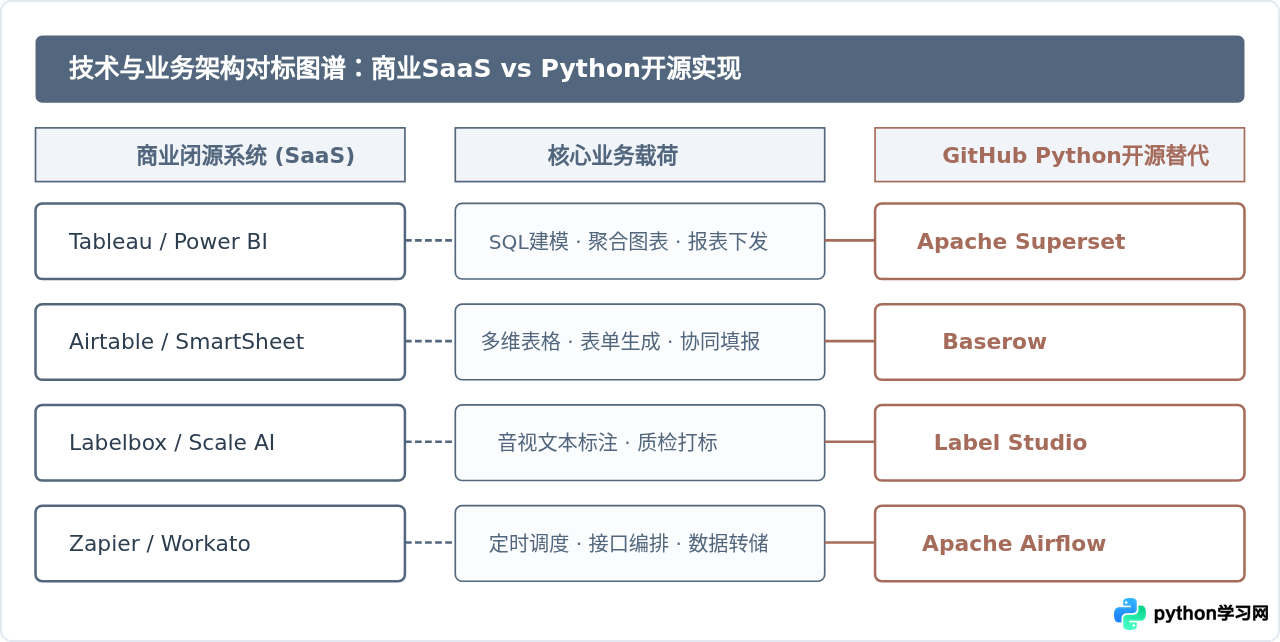
图 1:商业产品与四大核心Python开源解决方案的对照关系
二、四类高频场景的开源替代工具详解
1. 商业智能与数据可视化:Apache Superset 替代 Tableau
商业BI产品如Tableau或Power BI在处理企业级复杂图表时表现出色,但其云端订阅成本对中小团队或内部审计团队而言十分高昂。Apache Superset是一个完全由Python(Flask框架)构建的现代化企业级BI工具。
Superset直接支持与主流SQL数据库建立连接,无需先把数据提取到私有格式文件中。它原生配备了基于Web的SQL编辑器(SQL Lab)、细粒度权限控制机制以及数十种常用图表模板。对于日常运维或运营指标大盘而言,Superset能够提供几乎等同于Tableau核心看板的查询与下钻功能。
2. 多维协同表格:Baserow 替代 Airtable
Airtable将传统电子表格与关系型数据库结合,广受产品与市场团队青睐。但由于其免费版限制每张表格的记录行数上限(通常仅几百条至数千条),团队很容易被迫升级到按用户每月数十美元的商业套餐。
Baserow是基于Django框架构建的开源无代码数据库平台。与单纯提供界面外观的静态表单不同,Baserow在后端使用PostgreSQL存储底层数据,每一列均有明确的数据类型限制(如关联引用、多选标签、附件及公式计算)。用户可以搭建内部采购流转、Bug跟进库或人员信息表,并且完全不存在数据行数限制。
3. AI训练数据标注:Label Studio 替代 Labelbox
在构建计算机视觉模型或大语言模型微调(RLHF)阶段,商业标注平台(如Labelbox或Scale AI)大多根据标注任务量和成员席位计费。当数据集达到数万张图片或几十万段对话时,标注工具本身的服务开销可能超出算力成本。
Label Studio由Heartex开源,后端基于Python开发。该项目支持图像边界框分割、语音文本对齐、富文本实体抽取以及模型预测辅助标注。由于它是自托管的,企业无需将敏感测试集上传至第三方云端,从而规避了潜在的数据泄露风险。
4. 业务流编排与定时管道:Apache Airflow 替代 Zapier
Zapier等低代码自动化平台在处理轻量级WebHook转发时较为快捷,但只要涉及周期性数据同步、复杂依赖判断或失败重试机制,其费用会随着操作次数(Tasks)快速膨胀。
Apache Airflow是Python生态中最成熟的分布式任务编排引擎。它采用“代码即配置”(Configuration as Code)的DAG(有向无环图)定义工作流。所有的任务依赖关系、执行间隔与重试策略均由标准Python脚本编写,开发者能够直接在任务节点中引入Pandas进行数据清洗,或调用RESTful接口,兼具确定性与工程可控性。
三、核心架构与自托管通信机制
上述四款Python工具在工程架构上具有显著的共性:它们不再是桌面本地单机程序,而是遵循现代Web规范的三层或四层分布式架构。理解这一拓扑结构,有助于我们在替代商业云服务时,合理评估服务器计算资源。
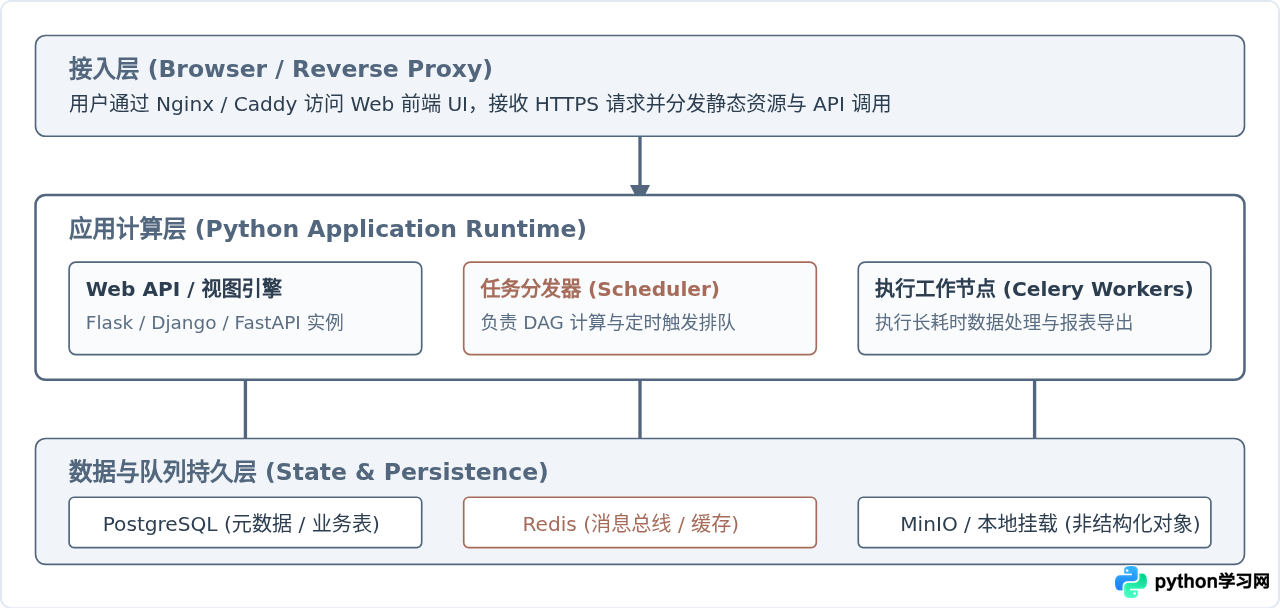
图 2:典型Python自托管开源套件的分层服务与通信架构
前端请求通过反向代理网关分流,静态资产直接由Web服务器解析;涉及数据库变更、报表呈现与任务调度的请求由Python后端接管。对于耗时超过几秒的任务(如生成PDF大型分析简报、触发批量数据清洗),系统会通过Redis将任务载荷写入消息队列,交由后台独立的Celery Worker异步消费,从而确保前端界面保持即时响应。
四、部署与验证实操:以自建多维表格服务为例
对于生产环境,直接从源码安装容易因操作系统环境依赖(如C编译链、libffi库版本)导致构建失败。目前官方维护最完善、可重复性最高的落地方式是使用容器化编排。以下演示在Linux服务器上快速拉起一个自托管多维表格服务(Baserow)的标准流程。
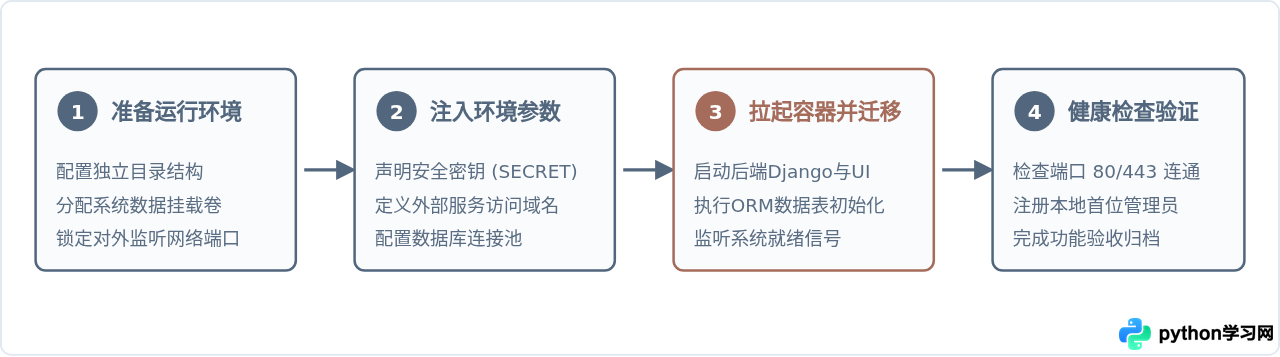
图 3:自托管Python开源工具标准生产部署步骤流
步骤一:创建宿主机配置与环境文件
首先在服务器上创建专用目录,并配置基础的环境变量。其中 SECRET_KEY 为Django后端签署Session会话所需的核心凭证,必须替换为不可逆推的随机字符;BASEROW_PUBLIC_URL 需设置为读者实际访问该服务时使用的内网IP或外部绑定域名。
mkdir -p /opt/baserow-data
cd /opt/baserow-data

# 生成配置文件 .env
cat <<EOF > .env
BASEROW_PUBLIC_URL=http://192.168.1.100:8080
SECRET_KEY=9a8fbc45e2a39281c7e909df81b9423d
DATABASE_USER=baserow
DATABASE_PASSWORD=strong_master_password
DATABASE_NAME=baserow_production
EOF
步骤二:编写并启动容器服务
编写 docker-compose.yml 文件,将数据卷绑定至宿主机的 /opt/baserow-data 目录,确保持久化数据在容器重启或版本升级时不会丢失。
cat <<EOF > docker-compose.yml
version: "3.7"
services:
  baserow:
    container_name: baserow_app
    image: baserow/baserow:1.26.1
    environment:
      - BASEROW_PUBLIC_URL=\${BASEROW_PUBLIC_URL}
      - SECRET_KEY=\${SECRET_KEY}
    ports:
      - "8080:80"
      - "8443:443"
    volumes:
      - /opt/baserow-data:/baserow/data
    restart: unless-stopped
EOF

docker compose up -d
步骤三:执行结果验证
容器启动后,内部会自动执行数据库初始化迁移脚本(Django Migrations)。可通过以下命令查看服务初始化的具体日志输出:
docker logs -f baserow_app --tail 15正常完成迁移后的标准日志输出如下所示:
当终端出现 listening on http://0.0.0.0:80 提示后,打开浏览器访问 http://192.168.1.100:8080,系统会引导创建第一个管理员账号。此时,团队即可开始导入Excel或从零新建表格,实现无行数限制的协作管理。
五、落地选型决策与隐性维护成本
商业软件的开销集中在财务预算表上,而开源自托管的成本往往隐藏在后续的软硬件维护工作中。为了避免“为省授权费而增加运维消耗”,在决定是否使用Python开源工具进行全面替代时,需要根据实际业务形态进行权衡。
| 对比维度 | 商业闭源软件 (SaaS) | GitHub Python 开源工具 |
|---|---|---|
| 核心软件费用 | 按成员席位及调用频次每月计费,规模越大单价越高 | 免费开源(主流遵循Apache-2.0或MIT协议),无节点限制 |
| 数据主权与合规 | 数据存储于供应商云端,受制于第三方安全政策 | 全量落盘于本地数据库,物理隔离,满足审计与合规要求 |
| 二次开发与扩展 | 受限,通常仅提供有限的WebHook或官方指定SDK | 完全开放,可基于Python直接编写中间件、重写认证模块 |
| 基础运维职责 | 服务商保障SLA、高可用容灾与底层漏洞修补 | 自行负责版本升级、跨版本迁移、快照备份与性能调优 |
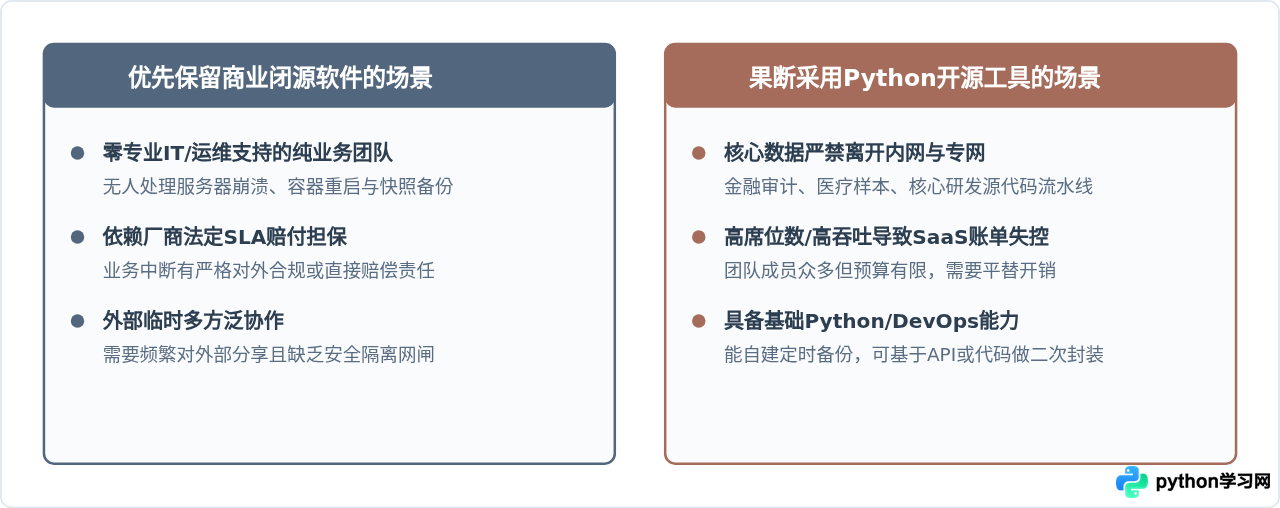
图 4:开源替代与商业续约的典型决策判断边界
综合来看,GitHub上的Python开源工具为技术与业务团队提供了一条摆脱软件订阅捆绑的切实路径。如果在团队内部具备基础的容器部署和脚本维护能力,从报表大盘、协同填报这类边界清晰的场景切入开源替代,往往能在确保数据主权完整的同时,最大化释放研发与管理效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















