


怎么用Python集合实现数据去重及交集并集运算
深入讲解如何使用Python集合(set)实现高效数据去重以及交集、并集、差集等代数运算,剖析底层哈希原理、运算符与内置方法差异、保序去重方案及实战避坑技巧。
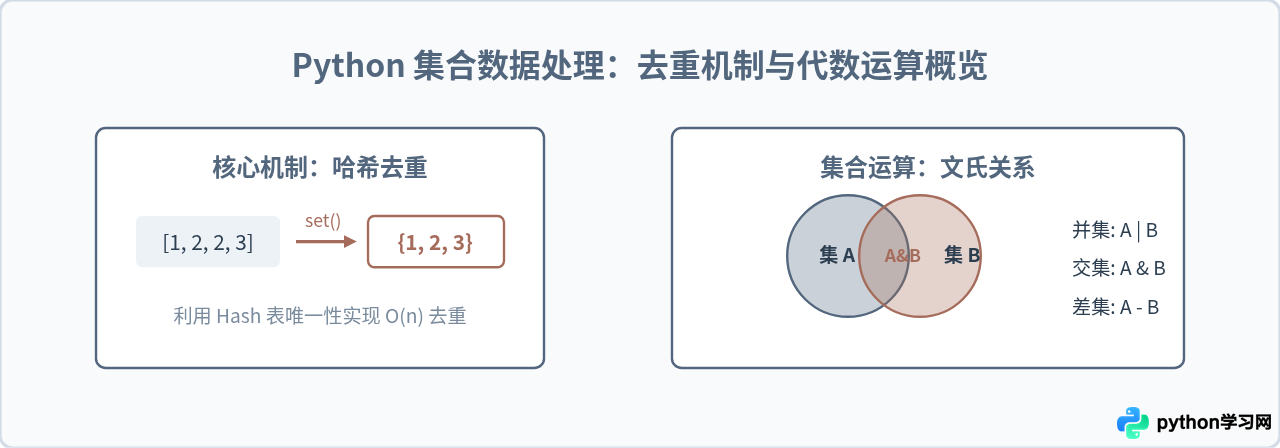
在日常数据清洗和逻辑筛选中,数据去重与多维度关联比对是极高频的操作。Python 原生内置的集合类型(set)具有无序且元素互异的数学特性,其底层基于高度优化的哈希表(Hash Table)构建。通过简单的构造调用 list(set(seq)) 即可在平均线性时间复杂度内去除重复项;同时,集合提供的交集(& 或 intersection)和并集(| 或 union)操作,能够高效求解公共交叠与全量汇总数据。本文将从代码实践、底层运行原理、运算符与方法差异以及保序边界等维度,完整讲解其实操方式与注意事项。
一、使用集合进行数据去重的核心方法与底层机制
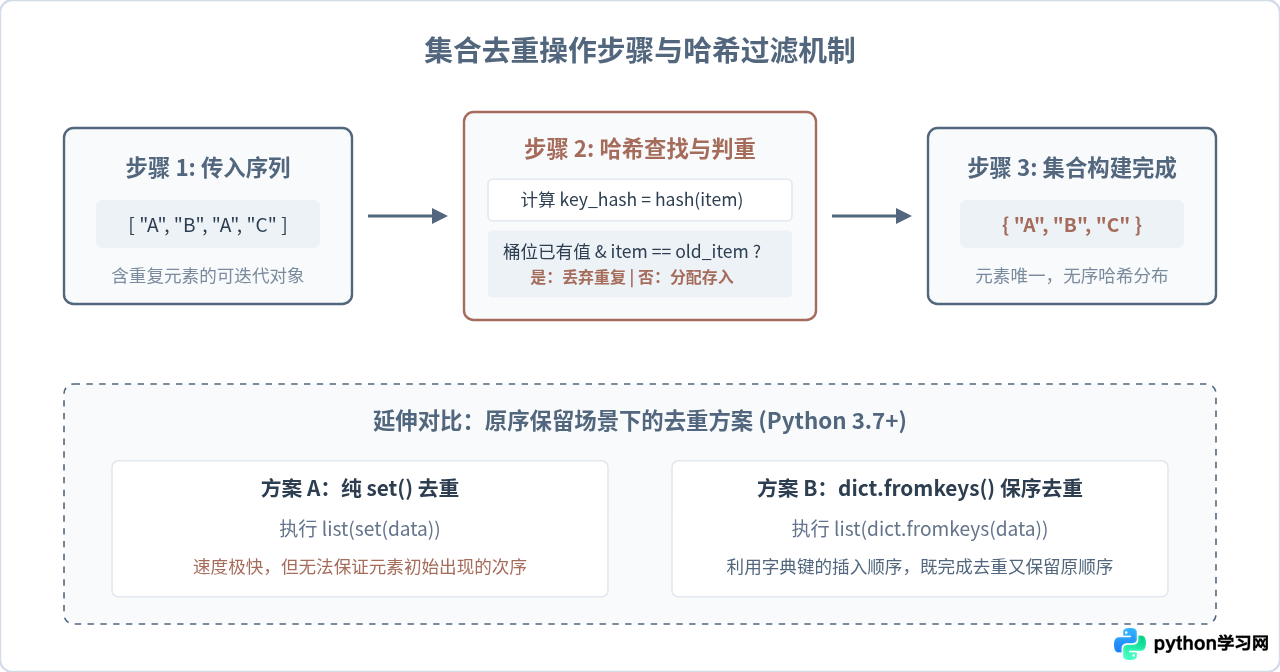
在 Python 中,如果原始序列中的元素顺序并不重要,最简洁快速的去重方式就是直接利用序列实例化一个 set,随后根据需要转换回原始容器类型(如 list 或 tuple)。
# 基础列表去重示例
raw_data = ["apple", "banana", "apple", "orange", "banana", "grape"]
unique_data = list(set(raw_data))

print("去重后的结果:", unique_data)
# 示例输出:['banana', 'apple', 'orange', 'grape'] (注意:元素顺序可能与原列表不同)
该操作之所以能够快速剔除重复项,是因为 Python 集合内部维护了一张哈希索引表。当向集合中添加元素时,解释器会首先调用该对象的 __hash__() 方法计算出哈希值,进而定位存储桶(Bucket)。如果对应的桶位已经存在相同哈希值的对象,解释器会进一步通过 __eq__() 判定二者是否严格相等。只有两个对象不完全相等时才处理冲突,若判定相等则直接跳过,从而保证每个值在集合中有且仅有一份。
去重时的重要限制:可哈希性(Hashable)
能够放入 set 的数据必须是“可哈希对象”(可理解为其值在其生命周期内不可变)。例如整数、浮点数、字符串、元组(tuple)以及冻结集合(frozenset)都可以正常去重。但如果列表中包含了字典(dict)、列表(list)等可变类型,直接调用 set() 会抛出 TypeError: unhashable type: 'list'。对于这类复合数据,需要先提取出不可变的特征值(如业务主键 ID)再实施去重。
二、集合的交集与并集运算实战
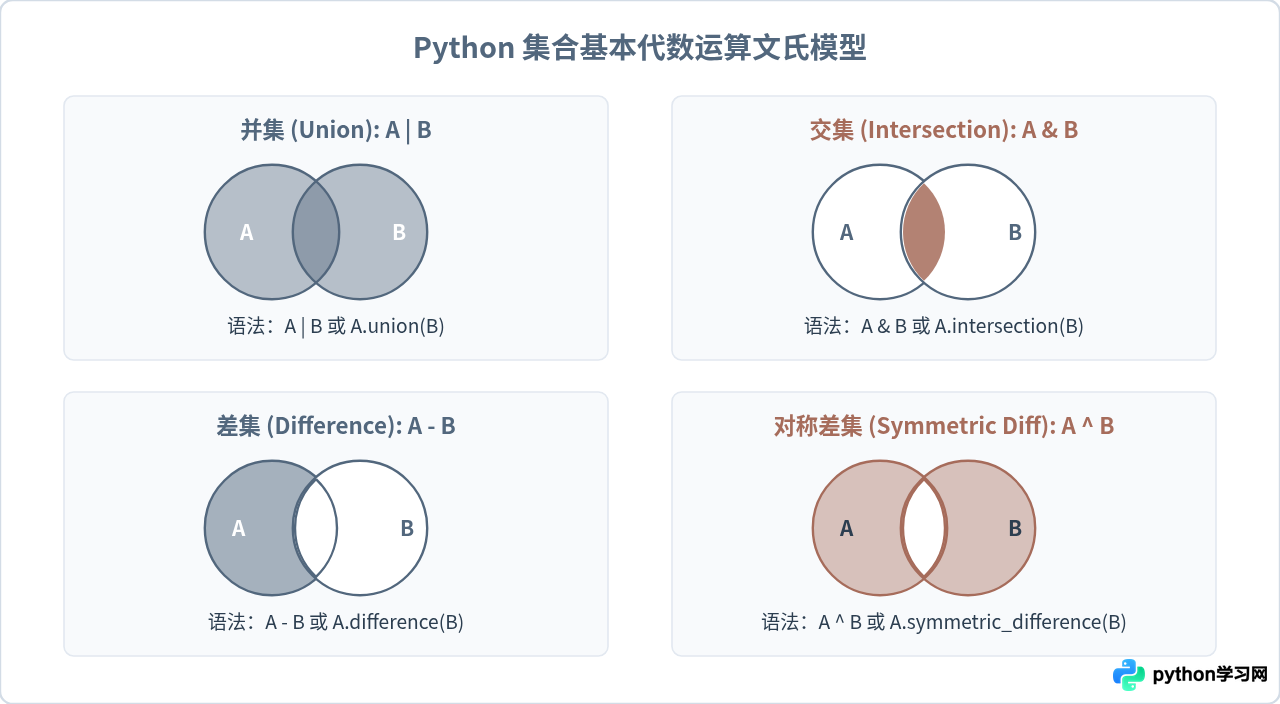
除单序列去重外,集合最强大的功能在于多集合之间的代数运算。Python 提供了两套语法体系:一种是类似数学符号的位运算符(如 &、|),另一种是更具可读性的面向对象方法(如 .intersection()、.union())。
1. 并集运算(Union)
并集表示将参与运算的所有集合中的全部唯一元素合并为一个新集合。适用于合并多份用户名单、汇总跨渠道的标签等需求。
set_a = {"Python", "Java", "Go"}
set_b = {"Go", "Rust", "C++"}

# 方式一:使用运算符 |
union_by_operator = set_a | set_b
print("运算符并集结果:", union_by_operator)
# 示例输出:{'Python', 'Go', 'Rust', 'Java', 'C++'}

# 方式二:使用 union() 方法
union_by_method = set_a.union(set_b)
print("方法调用并集结果:", union_by_method)
# 示例输出:{'Python', 'Go', 'Rust', 'Java', 'C++'}
2. 交集运算(Intersection)
交集表示提取同时存在于所有参与集合中的共同元素。常用于筛选共同好友、匹配多重筛选条件、重叠用户画像等场景。
dev_group_1 = {"Alice", "Bob", "Charlie", "David"}
dev_group_2 = {"Charlie", "David", "Edward", "Frank"}

# 方式一:使用运算符 &
intersection_by_operator = dev_group_1 & dev_group_2
print("运算符交集结果:", intersection_by_operator)
# 示例输出:{'Charlie', 'David'}

# 方式二:使用 intersection() 方法
intersection_by_method = dev_group_1.intersection(dev_group_2)
print("方法调用交集结果:", intersection_by_method)
# 示例输出:{'Charlie', 'David'}
3. 衍生集合运算:差集与对称差集
在实际业务中,与交并集紧密配合的还有差集与对称差集:
- 差集(Difference):
A - B或A.difference(B),表示属于集合 A 但不属于集合 B 的元素。常用于“筛选未完成任务”、“找出流失客户”。 - 对称差集(Symmetric Difference):
A ^ B或A.symmetric_difference(B),表示只在集合 A 或只在集合 B 中出现、但不同时存在于两者的元素。常用于“找出双方的不一致项”。
三、运算符与内置方法的关键差异与使用细节
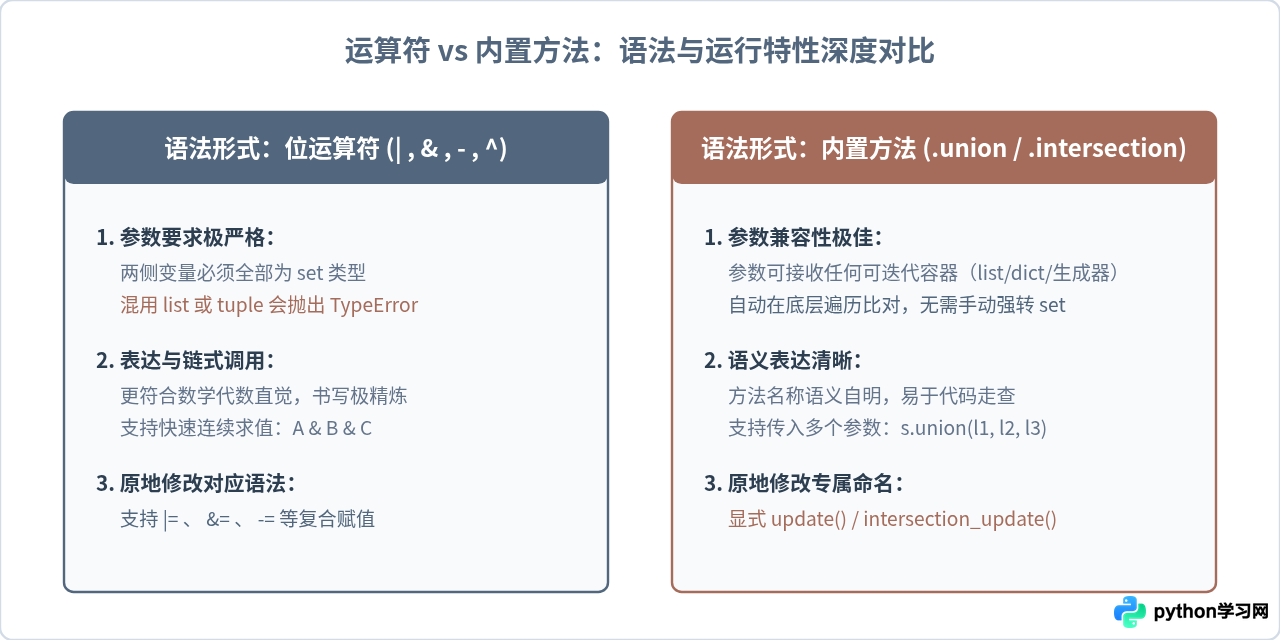
虽然运算符(如 &, |)与命名方法(如 .intersection(), .union())在数学结果上完全一致,但在实际开发中,它们在参数兼容性与内存修改模式上存在显著差异。
1. 参数类型的灵活性差异
使用位运算符时,参与运算的所有操作数必须是 set(或 frozenset)对象。如果右侧传入列表、元组或字典,Python 会直接报 TypeError。
而调用内置方法时,方法参数可以是任意可迭代对象(Iterable),包括 list、tuple、range 甚至是生成器。方法内部会自动将其视作集合元素进行比对,免去了手动二次转换的步骤:
base_set = {"admin", "editor"}
role_list = ["editor", "guest", "viewer"]

# 错误用法(报错):
# invalid_op = base_set & role_list
# TypeError: unsupported operand type(s) for &: 'set' and 'list'

# 正确且优雅的用法:直接使用方法参数
valid_intersection = base_set.intersection(role_list)
print("直接传入列表求交集:", valid_intersection)
# 示例输出:{'editor'}
2. 原地修改(In-place Update)以节省内存
默认的 | 或 union() 都会在内存中创建并返回一个全新的集合对象。当处理数百万级的大数据切片时,频繁创建新集合会导致严重的内存膨胀与垃圾回收压力。针对就地修改的需求,Python 提供了增量运算符和以 _update 结尾的原地方法:
- 并集原地更新:
a.update(b)或a |= b - 交集原地更新:
a.intersection_update(b)或a &= b - 差集原地更新:
a.difference_update(b)或a -= b
四、复杂数据结构去重与边界避坑指南
在工程实战中,常常遇到无法直接使用 set() 的复杂情况。掌握以下技巧能够避免常见的程序异常:
1. 针对字典列表(JSON 列表)的去重
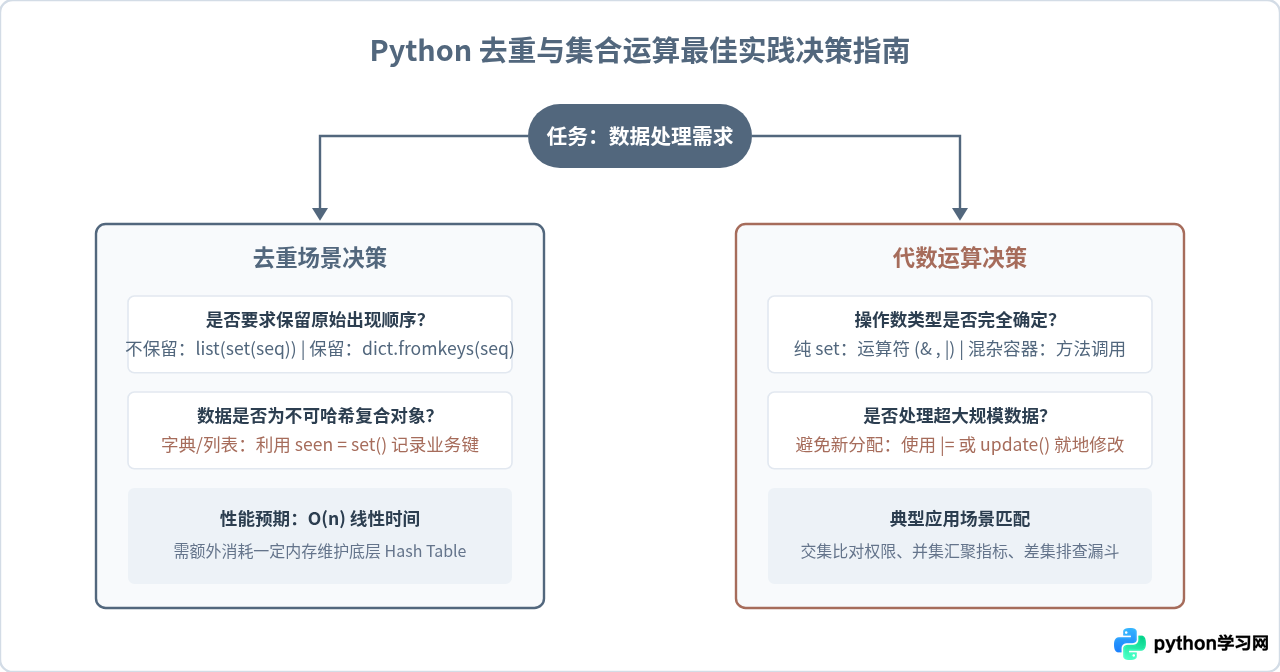
数据库查询或 API 接口常常返回字典列表。因为字典属于不可哈希类型,执行 set(dict_list) 会直接报错。此时最实用的方法是借助辅助集合 seen 记录主键唯一值:
users = [
    {"id": 101, "name": "Alice"},
    {"id": 102, "name": "Bob"},
    {"id": 101, "name": "Alice (Duplicate)"},
    {"id": 103, "name": "Charlie"}
]

seen_ids = set()
deduped_users = []

for u in users:
    if u["id"] not in seen_ids:
        seen_ids.add(u["id"])
        deduped_users.append(u)

print("字典去重结果:", deduped_users)
# 示例输出:[{'id': 101, 'name': 'Alice'}, {'id': 102, 'name': 'Bob'}, {'id': 103, 'name': 'Charlie'}]seen = set() 的集合成员查找操作(in)平均时间复杂度为 O(1),整个循环去重耗时仅为 O(n),比使用列表进行 item not in list 的 O(n²) 算法快几个数量级。
五、常用集合运算速查表
为了便于日常编码快速查阅,下表汇总了 Python 中常用集合操作的语法、运算含义及行为特征:
| 运算类型 | 位运算符 | 内置方法 | 原地修改版本 | 主要应用场景 |
|---|---|---|---|---|
| 并集 (Union) | a | b |
a.union(b) |
a |= b / a.update(b) |
多渠道数据合并、去重汇总 |
| 交集 (Intersection) | a & b |
a.intersection(b) |
a &= b / a.intersection_update(b) |
共同好友、标签交叉筛选 |
| 差集 (Difference) | a - b |
a.difference(b) |
a -= b / a.difference_update(b) |
未响应名单、黑名单过滤 |
| 对称差集 | a ^ b |
a.symmetric_difference(b) |
a ^= b / a.symmetric_difference_update(b) |
双向数据差异比对 |
| 子集/超集检测 | a <= b |
a.issubset(b) |
— | 权限范围验证、包含性断言 |
通过合理结合哈希表无序去重的性能优势与数学文氏运算的代数表现力,Python 集合能够让原本复杂的多重循环与重复值过滤逻辑缩减为几行高效且直观的代码。在掌握了可哈希性限制与保序技巧后,即可在各类业务开发与数据处理任务中游刃有余。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















