


Python爬虫常见报错排查:连接超时、解析错误与编码问题
针对Python爬虫开发中高频出现的连接超时、HTML解析提取为空或报错以及中文乱码等编码异常,系统梳理具体成因、定位步骤与实用修复方案。
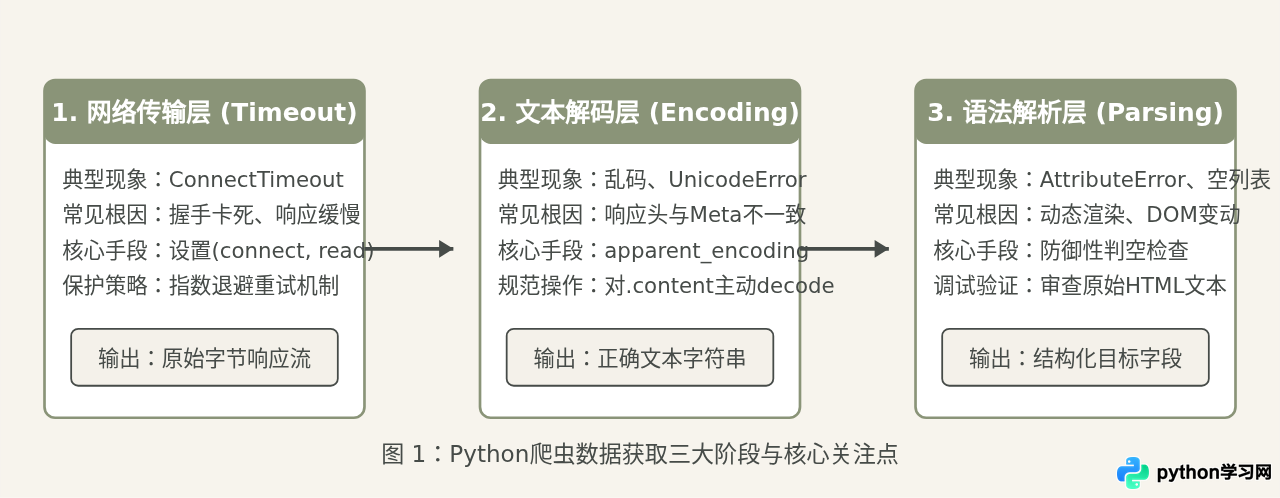
编写Python网络爬虫时,网络层中断、文档结构变动与字符集不匹配是三类出现频率最高的故障。排查此类问题的核心逻辑并非盲目增加重试次数或频繁替换请求库,而是先区分错误发生在哪一阶段——是在建立TCP握手与传输响应时发生网络中断,还是获取HTML后DOM解析器提取不到目标节点,抑或是读取文本流时解码规则与源网页字符集冲突。本文针对连接超时、解析错误和编码乱码这三大典型问题,逐一拆解其具体表现、诱发原因与工程落地的修复步骤。
一、连接超时(Timeout)的诊断与重试策略
连接超时是请求阶段最常见的外在表现。在默认情况下,若不为请求设置超时时间,Python的requests或urllib库可能会陷入无限阻塞,导致整个爬虫作业停滞不前。即便显式传入了timeout=5,很多开发者并不清楚该参数究竟约束的是哪一部分网络通信过程。
1. 连接超时与读取超时的区别
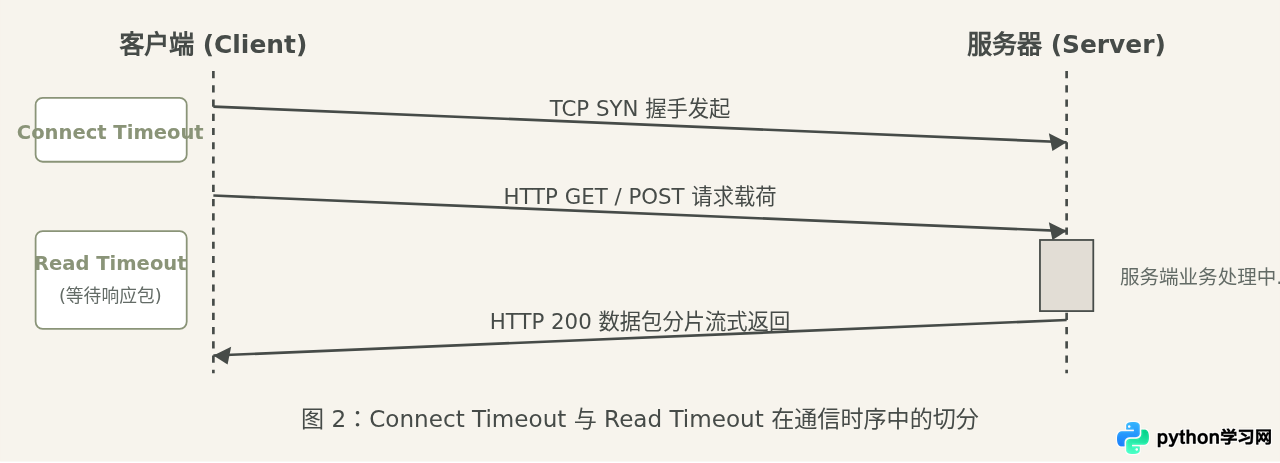
网络请求的生命周期主要由建立底层TCP连接(以及SSL/TLS握手)和等待服务器生成并传输响应内容两个阶段组成。在requests中:
- ConnectTimeout(连接超时):客户端向目标服务器发出SYN请求包后,在指定时间内未能完成三次握手。多由目标服务器宕机、DNS解析受阻、IP被对端防火墙拦截或代理服务器无法接通所导致。
- ReadTimeout(读取超时):客户端与服务器成功建立了TCP连接,但在指定时限内,客户端未能从套接字缓冲区读取到后续的数据包。通常发生在目标后端计算复杂、并发过高、数据库查询堵塞或爬虫遭遇反爬限速挂起时。
2. 超时参数的工程化配置与退避重试
为避免因单次网络抖动直接抛出未捕获异常中断批次,最佳实践是将超时参数拆分为元组 (connect_timeout, read_timeout),并结合内置的适配器或异常捕获机制进行有限次退避重试:
import time
import requests
from requests.exceptions import ConnectTimeout, ReadTimeout, RequestException

def fetch_with_retry(url, max_retries=3):
    # 分离连接超时(3秒)与读取超时(10秒)
    timeout_config = (3.0, 10.0)
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    }

    for attempt in range(1, max_retries + 1):
        try:
            response = requests.get(url, headers=headers, timeout=timeout_config)
            response.raise_for_status()
            return response
        except ConnectTimeout:
            print(f"[警告] 第 {attempt} 次请求连接超时,目标握手失败。")
        except ReadTimeout:
            print(f"[警告] 第 {attempt} 次请求读取超时,服务端未能及时响应。")
        except RequestException as err:
            print(f"[错误] 请求发生非超时网络异常: {err}")
            break

        if attempt < max_retries:
            backoff_delay = attempt * 2  # 线性退避:2s, 4s...
            time.sleep(backoff_delay)

return Nonetimeout 数值只会延长线程挂起时间。若重试仍持续超时,应检查是否触发了 IP 访问频率限制,此时必须降低抓取并发或引入轮换机制。
二、DOM 解析错误的根因定位与防御性提取
在网络层顺利取得响应内容后,下一道关卡通常发生在解析阶段。初学者常直接调用 soup.find('div', class_='content').text 或 tree.xpath('//span/text()')[0],一旦目标节点不存在,就会抛出 AttributeError: 'NoneType' object has no attribute 'text' 或 IndexError: list index out of range。
1. 为什么浏览器能看到的元素,爬虫却解析不到?
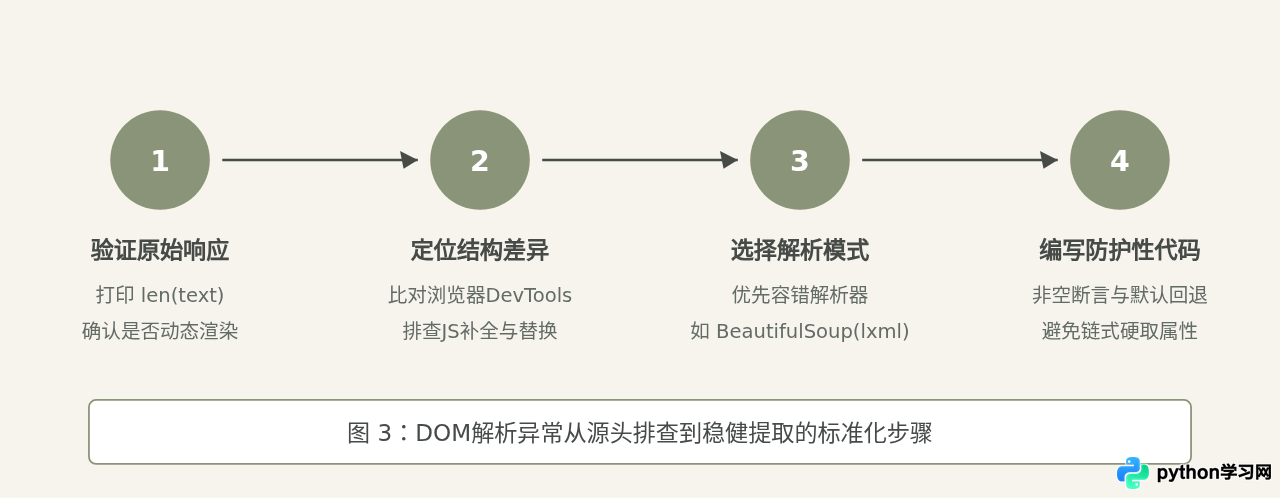
排查解析错误的第一步是纠正认知偏差:浏览器审查元素看到的DOM树,不等于爬虫拿到的HTTP响应体。
- 客户端动态渲染(SPA):现代前端页面广泛采用Vue、React等框架,浏览器接收到的初始HTML往往只包含一个空挂载点(如
<div id="app"></div>),核心数据通过后续异步AJAX/Fetch接口加载。此时通过XPath定位正文节点必然返回空列表。 - 浏览器自动容错修复:浏览器HTML解析引擎会自动补全闭合标签(例如为未规范书写的
<table>自动注入<tbody>)。如果直接从浏览器中复制绝对XPath路径(例如/table/tbody/tr[1]),由于原网页源码中并不存在tbody,解析器就会匹配失败。 - 反爬虫人机拦截页面:爬虫遭遇验证码验证(Cloudflare等)或重定向至登录页时,HTTP状态码可能是200,但返回的页面内容已被替换为拦截说明,原选择器自然匹配不到任何预期元素。
2. 防御性解析代码示例
在编写解析逻辑时,应当杜绝未经校验的链式属性调用,并采用相对松散且容错性高的选择器:
from bs4 import BeautifulSoup

def parse_article_safely(html_content):
    if not html_content:
        return {"title": "", "content": ""}

    # 推荐优先使用容错性好且速度快的 lxml 解析器
    soup = BeautifulSoup(html_content, "lxml")

    # 1. 提取标题:避免直接 soup.find('h1').text
    title_node = soup.find("h1")
    title = title_node.get_text(strip=True) if title_node else "默认空标题"

    # 2. 提取正文内容:使用更稳健的相对查找与循环容错
    content_node = soup.find("div", class_="article-body")
    if content_node is None:
        # 回退逻辑:尝试匹配备用结构
        content_node = soup.find("article")

    content = content_node.get_text(separator="\n", strip=True) if content_node else ""

    return {
        "title": title,
        "content": content
    }
三、字符集与编码乱码问题剖析
在抓取国内传统政企、教务网站或老旧门户时,常会遇到输出包含类似 ä¸æ–‡ 或 \xe4\xb8\xad 等不可读字符。此类乱码并非数据损坏,而是解码时使用了错误的编码集。
1. requests中 encoding 与 apparent_encoding 的运作机理
很多开发者认为“直接调用 response.text 就是解析后的字符串,乱码是库有Bug”。实际上,requests.text 内部完全依赖 response.encoding 的判断:
- 如果服务器在响应头(
Content-Type)中未声明charset,按照HTTP/1.1标准(RFC 2616),requests会默认回退至ISO-8859-1(西欧字符集)。而中文字符是多字节编码(UTF-8通常占3字节,GBK占2字节),使用单字节的西欧字符集解码UTF-8字节流,就会产生典型的拉丁文字符杂合乱码。 response.apparent_encoding则是通过chardet/charset_normalizer库分析原始字节流的特征分布,推断最可能的字符编码。但该推断存在算法开销与误判概率。
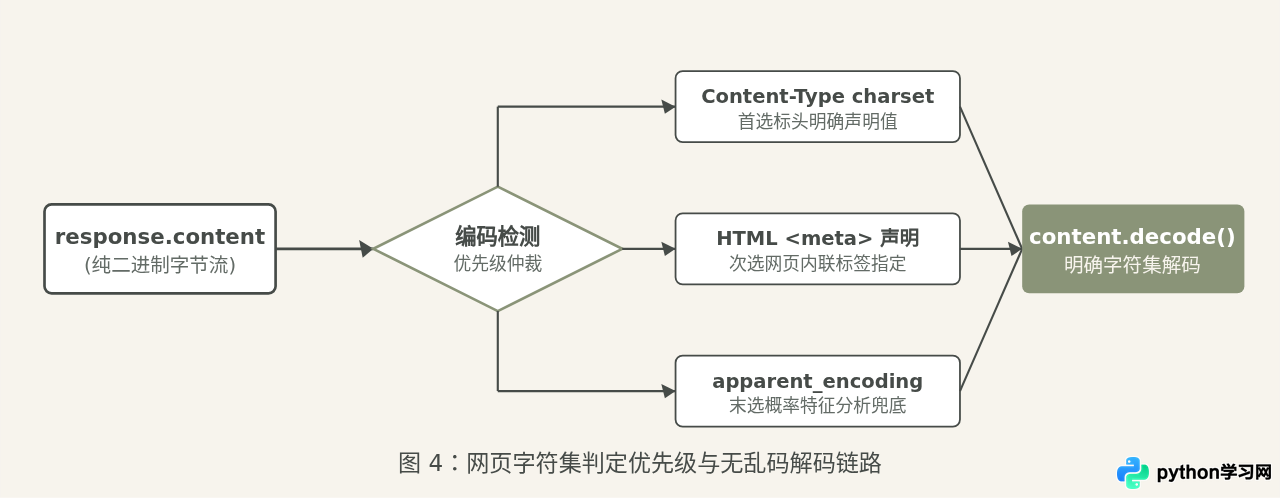
2. 彻底解决乱码的标准修复方案
解决乱码的根本准则是:优先信任原始字节流 response.content,按正确的字符集显式解码,而不盲目依赖默认的 response.text。
import re
import requests

def get_correct_text(response):
    # 1. 尝试从响应头提取 charset
    content_type = response.headers.get("Content-Type", "")
    match = re.search(r"charset=([\w-]+)", content_type, re.IGNORECASE)
    if match:
        encoding = match.group(1)
        try:
            return response.content.decode(encoding)
        except (UnicodeDecodeError, LookupError):
            pass

    # 2. 从HTML meta 标签中提取字符集(针对老旧页面)
    # 使用较小范围的二进制切片快速查找meta标签
    sample_bytes = response.content[:2048]
    meta_match = re.search(rb"<meta.*?charset=[\"']?([\w-]+)", sample_bytes, re.IGNORECASE)
    if meta_match:
        encoding = meta_match.group(1).decode("ascii", errors="ignore")
        try:
            # 常见gb2312建议扩充为gb18030以覆盖生僻字
            if encoding.lower() in ["gb2312", "gbk"]:
                encoding = "gb18030"
            return response.content.decode(encoding)
        except (UnicodeDecodeError, LookupError):
            pass

    # 3. 回退方案:使用 chardet 分析的推测编码,并设置 errors='replace' 避免抛崩
    encoding = response.apparent_encoding or "utf-8"
    return response.content.decode(encoding, errors="replace")
四、排查逻辑对照与排错检查清单
为便于在实际开发与运行巡检中快速对齐排查进度,下表归纳了三类常见报错的核心表现、第一检查点与最终防御措施:
| 报错类型 | 常见异常 / 错误现象 | 优先排查点 | 标准解法 |
|---|---|---|---|
| 连接超时 | ConnectTimeout、ReadTimeout |
区分握手阻断与回包慢;检查代理可用性与IP限频 | 设置超时元组 (connect, read),增加退避重试并合理调频 |
| 解析错误 | AttributeError、IndexError、提取为空 |
保存并查看爬虫收到的原始HTML文本,比对是否动态加载或人机拦截 | 改用API抓取或逆向接口,解析时引入非空判断与备用路径 |
| 编码乱码 | 文字变问号、拉丁杂合字符、UnicodeDecodeError |
检查 Content-Type 头是否缺省 charset,查看页面 meta 编码 |
对 response.content 明确按 GB18030 或 UTF-8 解码,容错处理生僻字 |
在日常爬虫编写与维护中,建立起“网络阶段精细配置超时与退避、解析阶段坚持原始代码核验与防御性取值、文本阶段基于字节流显式仲裁编码”的工作流,即可在无需盲目修改代码的前提下,快速闭环绝大多数由于反爬限制、网络抖动或文档异构引发的线上问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















