


Python数据处理脚本大全:CSV清洗与JSON转换实例
针对日常开发与数据工程中的高频痛点,系统整理实用的Python数据处理脚本,涵盖CSV编码修复、异常空值清洗、去重规范化,以及CSV与嵌套JSON结构互转的完整生产级实例。
一、CSV清洗与格式转换的处理全貌
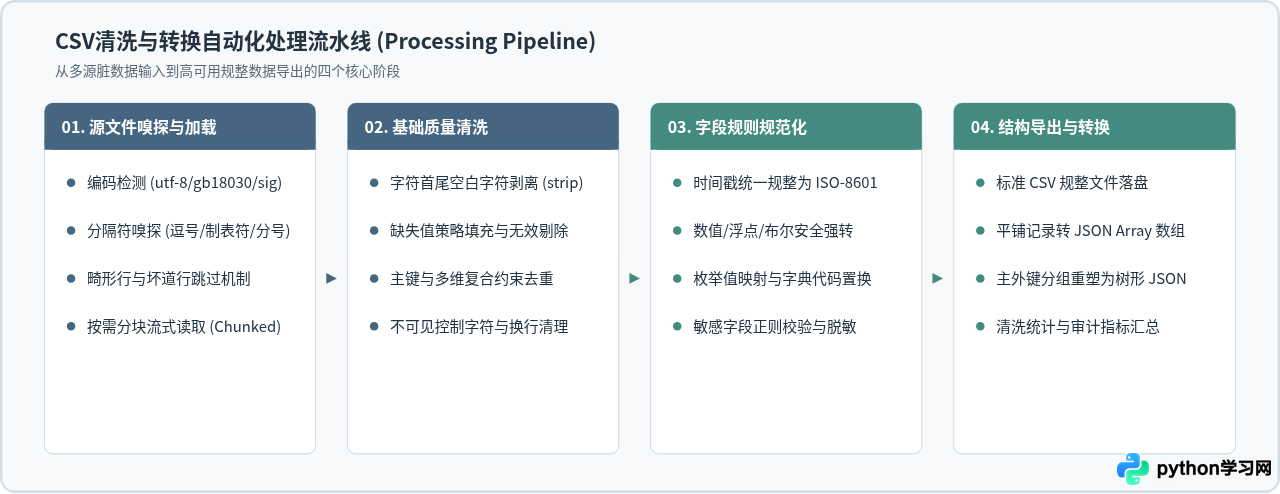
面对来源繁杂的原始数据,直接载入下游系统往往会引发编码错误、类型解析异常甚至程序崩溃。规范的处理路径通常遵循四个标准阶段:文件属性嗅探与预解码、数据质量基础清洗、字段语义规范化、以及根据目标模型实施的格式重组与结构导出。
二、CSV清洗核心脚本库
CSV本身不是严格的二进制规范,不同软件导出的CSV常常包含未声明的编码、带BOM头、多余前后空格或缺失字段。以下脚本提供了轻量级、不强依赖大型第三方库的标准库方案与高效率Pandas方案。
1. 编码检测与安全载入
Windows端导出的CSV常带 utf-8-sig(带有不可见BOM头 \ufeff)或 gb18030 编码,如果统一以常规 utf-8 读取,第一个字段的列名会被前缀破坏,中文亦会出现乱码。
import csv

def read_csv_safe(file_path):
    """
    自动兼容 utf-8-sig, utf-8 与 gb18030 编码的 CSV 读取函数
    """
    encodings = ['utf-8-sig', 'utf-8', 'gb18030']
    for enc in encodings:
        try:
            with open(file_path, mode='r', encoding=enc) as f:
                reader = csv.DictReader(f)
                records = [row for row in reader]
                return records, enc
        except UnicodeDecodeError:
            continue
    raise ValueError(f"无法识别文件编码: {file_path}")

# 示例调用
records, detected_enc = read_csv_safe("raw_user_data.csv")
print(f"成功使用 {detected_enc} 编码加载数据,记录数: {len(records)}")
2. 字段剥离、空值清洗与去重脚本
清洗的核心操作通常包括:修剪所有文本字段的首尾空白符、将空字符串或 NA、null 转换为统一的空值标识、以及基于关键业务字段进行去重。
def clean_csv_records(records, unique_key='id', fill_defaults=None):
    """
    通用行记录清洗函数
    :param records: 由 DictReader 读出的字典列表
    :param unique_key: 用于去重的唯一主键字段名
    :param fill_defaults: 缺失字段的默认补齐字典,例如 {'age': '0', 'status': 'unknown'}
    """
    if fill_defaults is None:
        fill_defaults = {}

    cleaned = []
    seen_keys = set()

    for row in records:
        # 1. 递归剥离首尾多余空白
        row_cleaned = {k.strip(): (v.strip() if v else "") for k, v in row.items() if k is not None}

        # 2. 检查主键
        pk = row_cleaned.get(unique_key)
        if not pk or pk in seen_keys:
            continue
        seen_keys.add(pk)

        # 3. 缺失值回填默认值
        for field, default_val in fill_defaults.items():
            if field in row_cleaned and row_cleaned[field] in ("", "null", "NULL", "NA", "None"):
                row_cleaned[field] = default_val

        cleaned.append(row_cleaned)

return cleaned0,这可能会在后续的平均值计算中引入人为偏差;应优先根据业务约定保留为统一的 None 或特定的缺失标识。
三、CSV二维表与JSON层级结构的映射模型
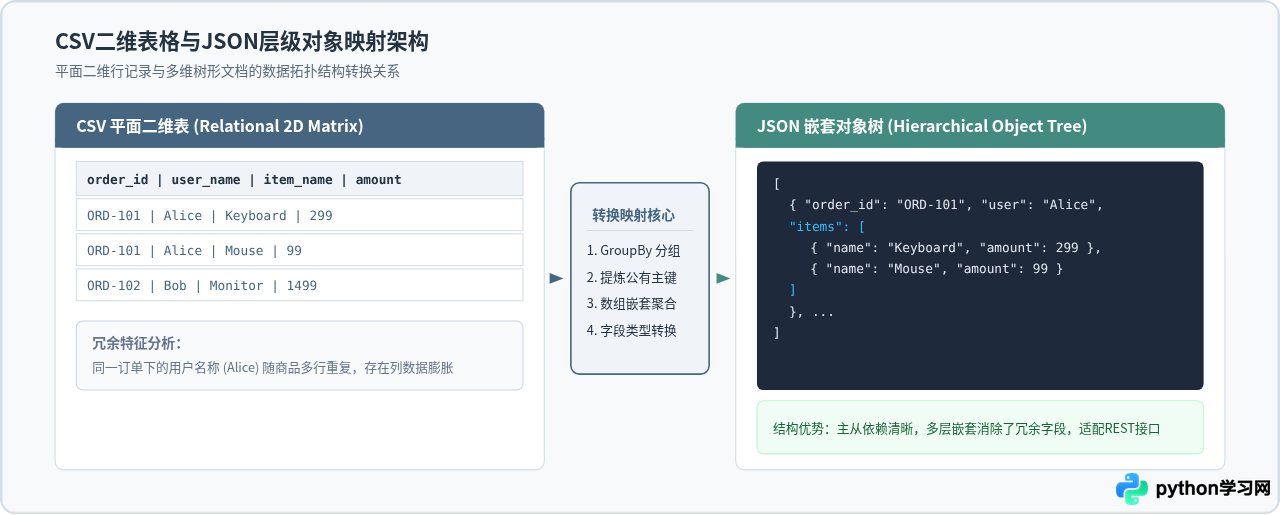
CSV本质上是由行和列构成的平面二维关系网格(2D Relational Matrix),其中每一行包含相同的表头结构。而JSON是树形、多维的文档对象模型(Document Tree),可以原生表达父子从属关系、列表集合与嵌套字典。
在从CSV向JSON转换时,最关键的一步是判断业务模型属于“平铺记录流”还是“分组聚合的层级树”。若同一个主键存在多条明细记录(例如订单与订单子项),必须通过主键聚合成数组,以避免顶层实体信息的无意义重复。
四、实战转换:CSV转JSON多模式脚本
根据消费端接口的具体规范,CSV转换至JSON主要有三种模式:记录列表模式(Records)、主键索引字典模式(Key-Value Index)、以及父子嵌套树形模式(Hierarchical Tree)。
模式一:快速记录列表导出(平铺输出)
每个CSV数据行直接转换为一个独立的JSON对象,整体封装在一个数组中。适合大部分批量入库或REST API批量查询接口。
import json
import csv

def csv_to_json_records(csv_path, json_path, encoding='utf-8'):
    """
    将 CSV 转换为标准 Records 格式的 JSON 文件: [ {col1: val1, col2: val2}, ... ]
    """
    with open(csv_path, mode='r', encoding=encoding) as f_in:
        reader = csv.DictReader(f_in)
        data = list(reader)

    with open(json_path, mode='w', encoding='utf-8') as f_out:
        json.dump(data, f_out, ensure_ascii=False, indent=2)

    return len(data)
模式二:分组聚合构造嵌套层级JSON
当CSV中包含主表与从表数据时(如订单编号与商品明细),使用字典作为哈希桶,基于主键进行归纳,将商品信息作为子列表嵌入主订单对象中。
def csv_to_nested_json(csv_path, json_path, group_key='order_id', child_key='items', child_fields=None):
    """
    基于公共主键将 CSV 多行聚合为树形嵌套 JSON
    """
    if child_fields is None:
        child_fields = ['item_name', 'amount']

    nested_dict = {}

    with open(csv_path, mode='r', encoding='utf-8-sig') as f:
        reader = csv.DictReader(f)
        for row in reader:
            gid = row[group_key]

            # 若该组首次出现,初始化根对象
            if gid not in nested_dict:
                parent_data = {k: v for k, v in row.items() if k not in child_fields}
                parent_data[child_key] = []
                nested_dict[gid] = parent_data

            # 提取子表字段并添加至列表
            child_item = {k: row[k] for k in child_fields if k in row}
            # 安全转为数值
            if 'amount' in child_item:
                try:
                    child_item['amount'] = float(child_item['amount'])
                except ValueError:
                    pass
            nested_dict[gid][child_key].append(child_item)

    # 导出为列表
    result_list = list(nested_dict.values())
    with open(json_path, mode='w', encoding='utf-8') as f_out:
        json.dump(result_list, f_out, ensure_ascii=False, indent=2)

    return result_list
五、实战转换:复杂嵌套JSON转平铺CSV脚本
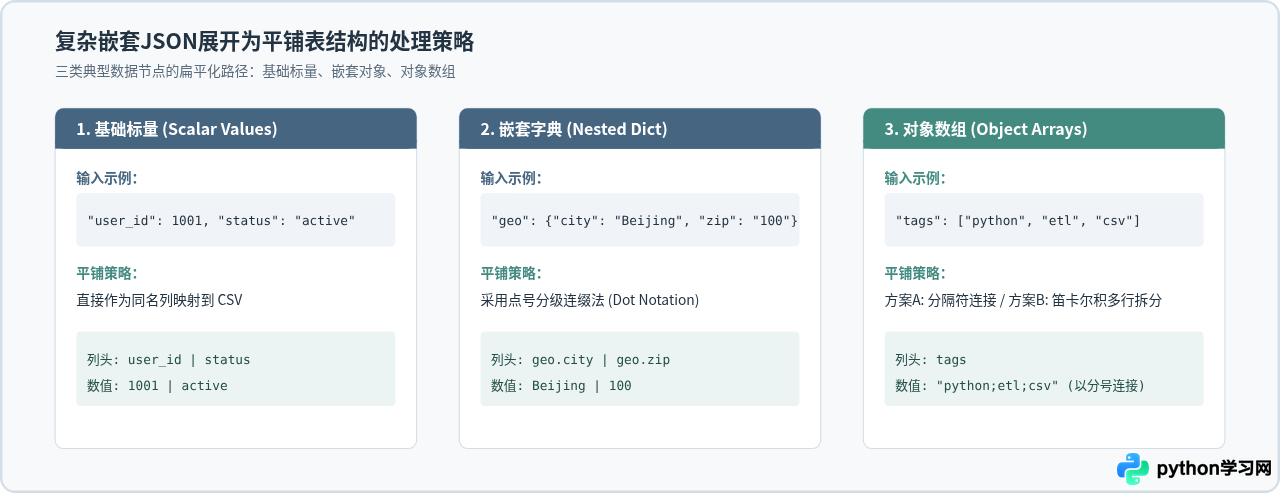
从外部接口获取的JSON数据往往包含多级嵌套对象(Nested Object)或数组(Array of Objects)。将这类型数据重构为平面表格时,需要明确不同数据节点的展开策略。
使用递归实现全量嵌套字典平铺(纯标准库)
当不想引入外部重型依赖时,通过简洁的递归函数即可把任意深度的JSON对象压平:
def flatten_dict(d, parent_key='', sep='.'):
    """
    递归压平多层嵌套字典
    :param d: 输入字典
    :param parent_key: 上级键前缀
    :param sep: 键连接分隔符
    """
    items = []
    for k, v in d.items():
        new_key = f"{parent_key}{sep}{k}" if parent_key else k
        if isinstance(v, dict):
            items.extend(flatten_dict(v, new_key, sep=sep).items())
        elif isinstance(v, list):
            # 若列表内为基本类型,合并为字符串;若为对象,转化为JSON字符串保留
            if all(not isinstance(i, (dict, list)) for i in v):
                items.append((new_key, ";".join(str(i) for i in v)))
            else:
                items.append((new_key, json.dumps(v, ensure_ascii=False)))
        else:
            items.append((new_key, v))
    return dict(items)

def nested_json_to_flat_csv(json_path, csv_path):
    """
    读取包含嵌套对象的 JSON 并导出为平铺 CSV
    """
    with open(json_path, mode='r', encoding='utf-8') as f:
        data = json.load(f)

    if not isinstance(data, list):
        data = [data]

    # 逐项扁平化
    flat_rows = [flatten_dict(item) for item in data]

    # 汇总所有可能出现的动态表头
    headers = set()
    for row in flat_rows:
        headers.update(row.keys())
    sorted_headers = sorted(list(headers))

    with open(csv_path, mode='w', encoding='utf-8-sig', newline='') as f_out:
        writer = csv.DictWriter(f_out, fieldnames=sorted_headers)
        writer.writeheader()
        for row in flat_rows:
            writer.writerow(row)

    return len(flat_rows)
基于 Pandas 的 json_normalize 高性能方案
对于数据分析场景,Pandas 提供了高度优化的 json_normalize 函数,能够一步完成树形记录的平铺展开:
import pandas as pd

def pandas_json_to_csv(json_path, csv_path):
    # 读取原始 JSON
    with open(json_path, 'r', encoding='utf-8') as f:
        data = json.load(f)

    # 扁平化展开
    df = pd.json_normalize(data)

    # 清洗:填补空值并重命名列
    df.fillna('', inplace=True)

    # 导出规整后的 CSV (带 BOM 兼容 Excel 直接打开)
    df.to_csv(csv_path, index=False, encoding='utf-8-sig')
    print(f"转换完成,生成行列维度: {df.shape}")
六、工程边界、选型矩阵与交付校验规范
在实际生产部署中,数据量级、内存约束以及异常数据的容错能力决定了脚本的选型与架构方案。
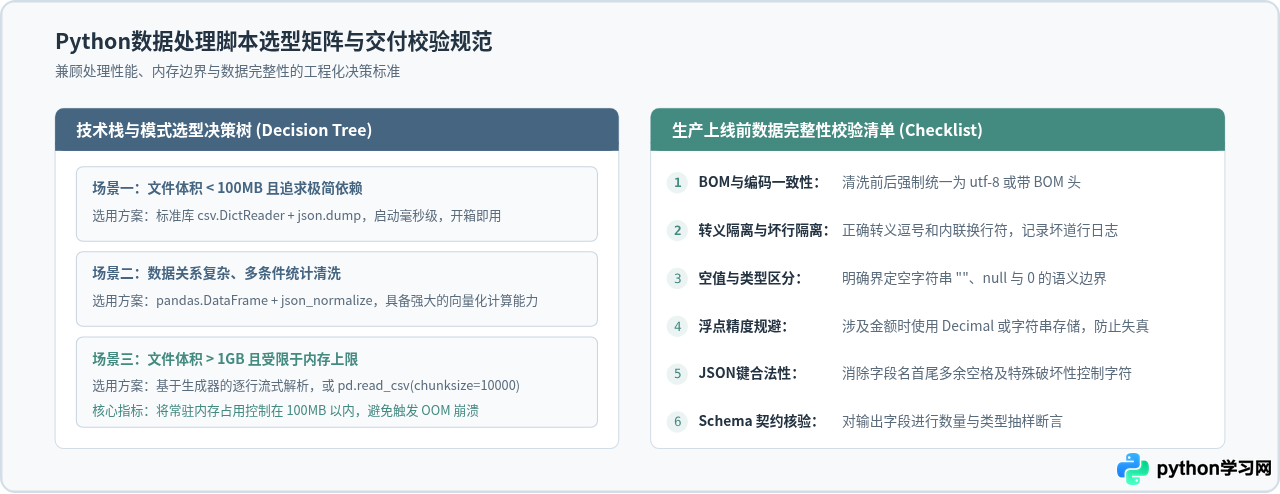
超大文件分块流式处理范例
处理超过数GB的大型CSV或JSON流时,切勿一次性 read() 或直接载入内存。使用 yield 生成器逐行读取,可以保证内存始终处于恒定水平:
def stream_process_large_csv(input_csv, output_json, chunk_size=5000):
    """
    流式分块处理超大 CSV,将其逐步写入 JSON 数组文件
    """
    with open(input_csv, 'r', encoding='utf-8') as f_in, \
         open(output_json, 'w', encoding='utf-8') as f_out:

        reader = csv.DictReader(f_in)
        f_out.write('[\n')

        is_first = True
        buffer = []

        for row in reader:
            # 基础行级清洗
            cleaned_row = {k.strip(): v.strip() for k, v in row.items() if k}
            buffer.append(cleaned_row)

            # 缓冲区填满,执行一次批量写入
            if len(buffer) >= chunk_size:
                for item in buffer:
                    line = json.dumps(item, ensure_ascii=False)
                    if not is_first:
                        f_out.write(',\n')
                    else:
                        is_first = False
                    f_out.write('  ' + line)
                buffer.clear()

        # 写入剩余缓冲区内容
        for item in buffer:
            line = json.dumps(item, ensure_ascii=False)
            if not is_first:
                f_out.write(',\n')
            else:
                is_first = False
            f_out.write('  ' + line)

f_out.write('\n]\n')本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















