


为什么在线运行Python代码有时会超时?原因与优化建议
深入解析在线平台运行Python代码出现超时(Time Limit Exceeded)的核心原因,包括沙箱资源配额、死循环、交互输入等待及高时间复杂度等,并提供详细的排查步骤与优化策略。
在各类编程学习网站、在线练习平台或在线IDE中编写并运行Python代码时,不少初学者和开发者都遇到过“运行超时”(通常提示为 Time Limit Exceeded、Timeout 或 Execution Timed Out)的提示。遇到这种情况时,很多人第一反应往往是怀疑“是不是平台服务器太慢了”或“网速不好”。事实上,在线环境超时绝大多数源于平台严格的安全沙箱机制与代码实际执行开销之间的冲突。在线平台为了防止死循环耗尽服务器资源、保障多用户公平调度,普遍为单次执行设置了5至15秒的硬性倒计时。一旦代码因为逻辑死循环、交互输入等待、算法复杂度过高或频繁I/O而未能在此窗口内退出,就会被监控程序直接强行中断。
一、在线平台的运行机制:为什么必须设定超时阈值?
要解决超时问题,首先需要理解在线运行Python与本地电脑运行的本质差异。在本地计算机上,一段代码即便跑上几个小时,操作系统也只会如实执行,直到计算完成或手动按 Ctrl+C 中断。但在云端共享的多租户平台上,服务器资源是由成千上万名用户共同使用的。
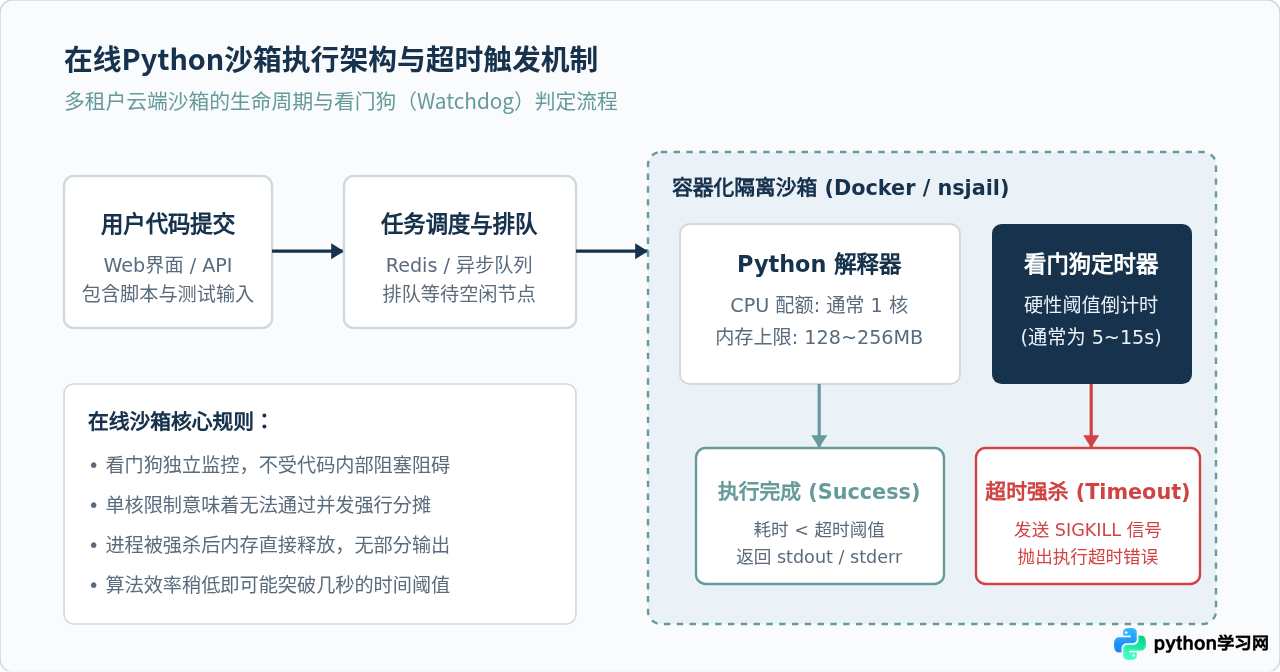
在线平台通常采用容器化技术(如 Docker、gVisor、nsjail 等)构建安全沙箱环境。当用户点击“运行”按钮时,系统会经历任务排队、沙箱启动、代码执行、输出捕获与容器销毁等阶段。为了防止恶意攻击(如挖矿、死循环攻击)以及无意间写出的死循环耗尽CPU与内存,平台会在沙箱外部挂载一个独立的“看门狗定时器”(Watchdog Timer)。只要倒计时归零而程序未正常退出,看门狗就会向进程发送 SIGKILL 信号瞬间杀掉程序,并向前台返回超时报错。
二、引发超时的四大核心原因深度剖析
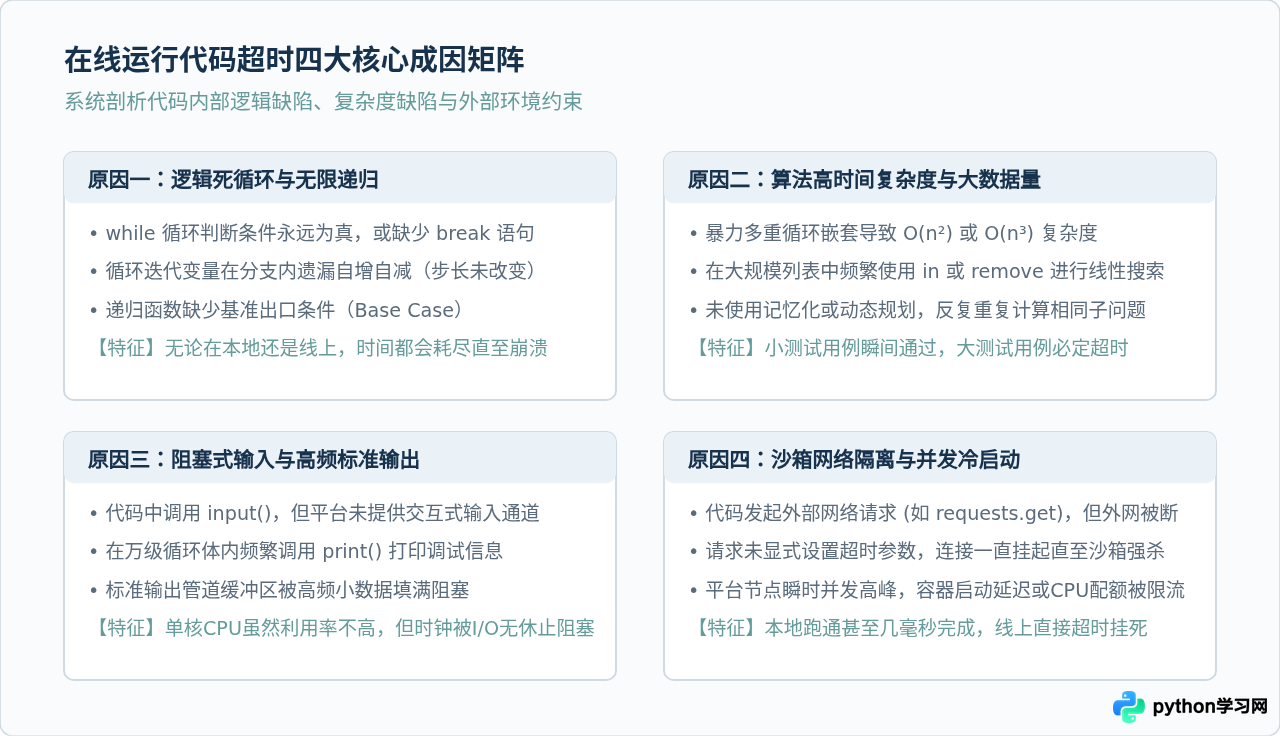
在理解了沙箱的运行与超时机制后,我们可以将导致代码超时的原因归纳为四种典型场景。从实际排查经验来看,这四种情况覆盖了绝大多数超时案例:
1. 逻辑死循环:永远无法抵达的退出终点
最直接的超时是死循环。尤其在使用 while 循环时,如果在某些分支下忘记更新计数器变量,或者循环跳出条件设计不当,就会陷入死循环。例如以下常见失误:
# 错误示例:条件分支遗漏迭代变量递增
i = 0
total = 0
while i < 100000:
    if i % 2 == 0:
        total += i
        i += 1
    else:
        # 当 i 为奇数时,缺少 i += 1,导致 i 永远固定,死循环!
        total += 1
这类问题在本地容易被发现,但在在线环境中,由于没有实时控制台交互,直接的结果就是静默等待几秒后弹出 Timeout。
2. 阻塞式输入(input):等待不存在的控制台输入
许多初学者直接把本地课后作业的代码贴到算法刷题网站或轻量在线测试页面。如果代码中包含 name = input("请输入内容:"),但运行平台本身并不是一个交互式伪终端(TTY),而是以非交互批处理方式运行脚本。此时,Python解释器会一直停在系统调用 sys.stdin.read() 上等待用户敲回车,直到沙箱看门狗到期强制斩首进程。
3. 算法复杂度过高:百万级计算遇上单核配额
Python作为解释型语言,纯Python代码在执行循环时的速度通常比编译型语言(如 C/C++、Go)慢 10 至 50 倍。在在线平台上,一般分配给每个沙箱的 CPU 算力只有 0.5 到 1 个虚拟核心(vCPU)。
如果算法时间复杂度是 $O(n^2)$,当测试数据量 $n = 10^5$ 时,总操作次数将达到 $10^{10}$ 次。在标准Python解释器下,1秒大约只能执行 $10^7$ 次左右的基本简单操作,处理完 $10^{10}$ 次操作需要数百秒,这必然远远超过平台规定的 5~10 秒阈值。
三、系统排查超时的五个关键步骤
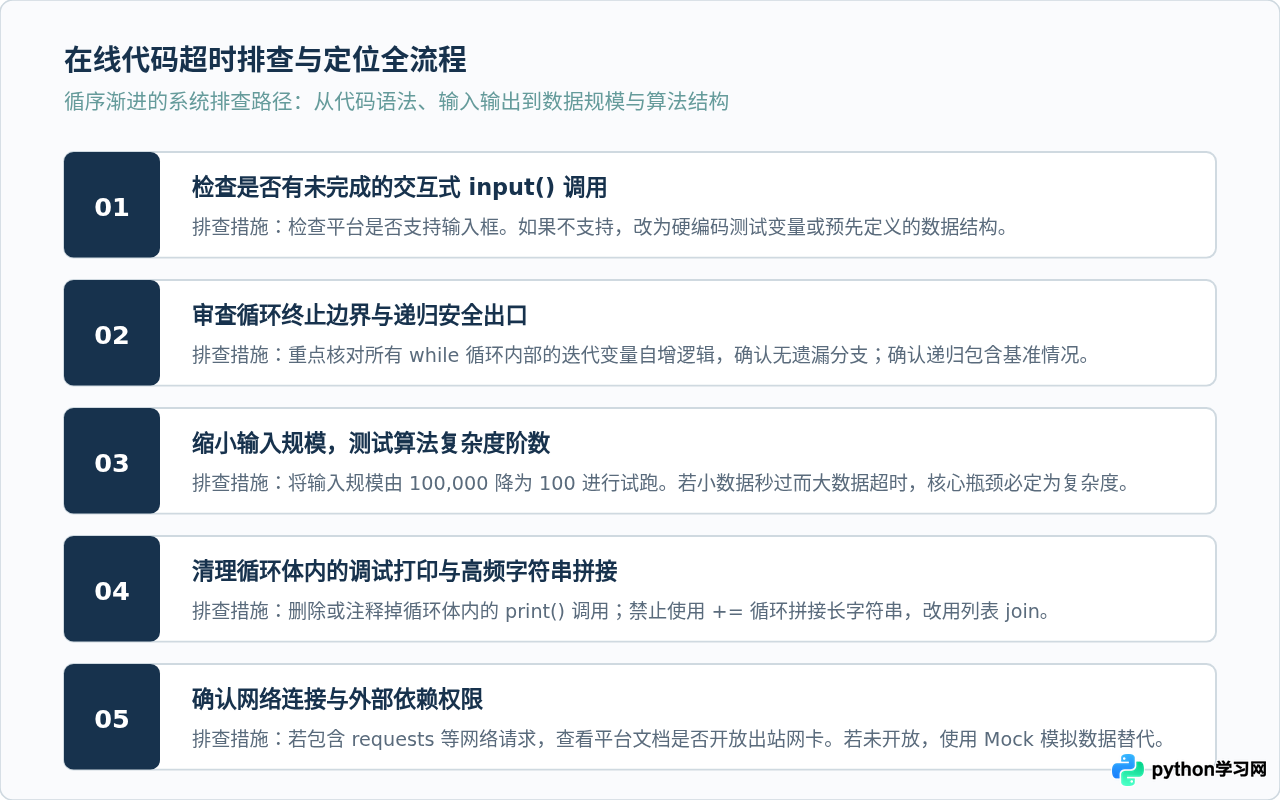
遇到在线代码超时时,无需盲目猜测。按照以下五步排查法,通常可以在数分钟内准确定位并解决瓶颈:
四、针对性代码优化建议与实战技巧
在定位到性能瓶颈后,如何用最地道、最高效的Python写法降低执行耗时?以下提供几套立竿见影的优化实践:
1. 善用哈希表(dict/set)替代列表(list)查找
在列表中执行 item in my_list 是 $O(n)$ 时间复杂度的线性扫描。如果在一个包含 $n$ 次的循环内每次都查找一次列表,整个算法复杂度就会退化为 $O(n^2)$。只需将列表转换为集合(set),查找操作即可瞬间变为 $O(1)$ 常数时间:
# 优化前:O(n^2) 耗时严重,容易超时
targets = [i * 2 for i in range(50000)]
data = range(50000)
count = 0
for x in data:
    if x in targets:  # 每次都是列表线性扫描,极慢!
        count += 1

# 优化后:O(n) 耗时仅需数毫秒
target_set = set(targets)  # 转换为集合哈希表
count = 0
for x in data:
    if x in target_set:  # 集合查找为 O(1),瞬间完成!
        count += 1
2. 避免循环内字符串 +=,改用 str.join()
在Python中,字符串属于不可变对象(Immutable)。每次执行 s += char,底层都会在内存中重新申请一块新空间并将旧内容完整拷贝一遍,耗时随长度呈二次方增长。优化方式是先将碎片字符串存入列表,最后一次性调用 join():
# 优化前:低效拼接
result = ""
for word in words:
    result += word + " "

# 优化后:高效批处理
result = " ".join(words)
3. 移除热循环内的 print() 输出
许多开发者喜欢在循环中打印中间结果以便调试,例如 for i in range(100000): print(i)。然而,在云端沙箱中,标准输出需要经过重定向、缓冲区刷新与跨进程/跨网络传输,I/O操作比内存计算慢上千倍。只要在提交前清理掉不必要的调试打印,执行速度通常能成百倍提升。
4. 为不可预测的循环添加“安全看门狗”计数器
在编写较为复杂的搜索或逼近算法时,若无法确保一定能收敛,可以在代码内部设置一个最大迭代轮数保护机制,防止死循环耗死沙箱:
MAX_STEPS = 100000
step = 0
while condition:
    step += 1
    if step > MAX_STEPS:
        print("达到预设最大安全步数,主动退出保护")
        break
    # 正常核心计算逻辑...
五、超时原因与应对对策总结
为了让大家在遇到不同超时情况时能快速对号入座,下表对常见超时特征、诱发根因及最佳解决方案进行了系统化整理:
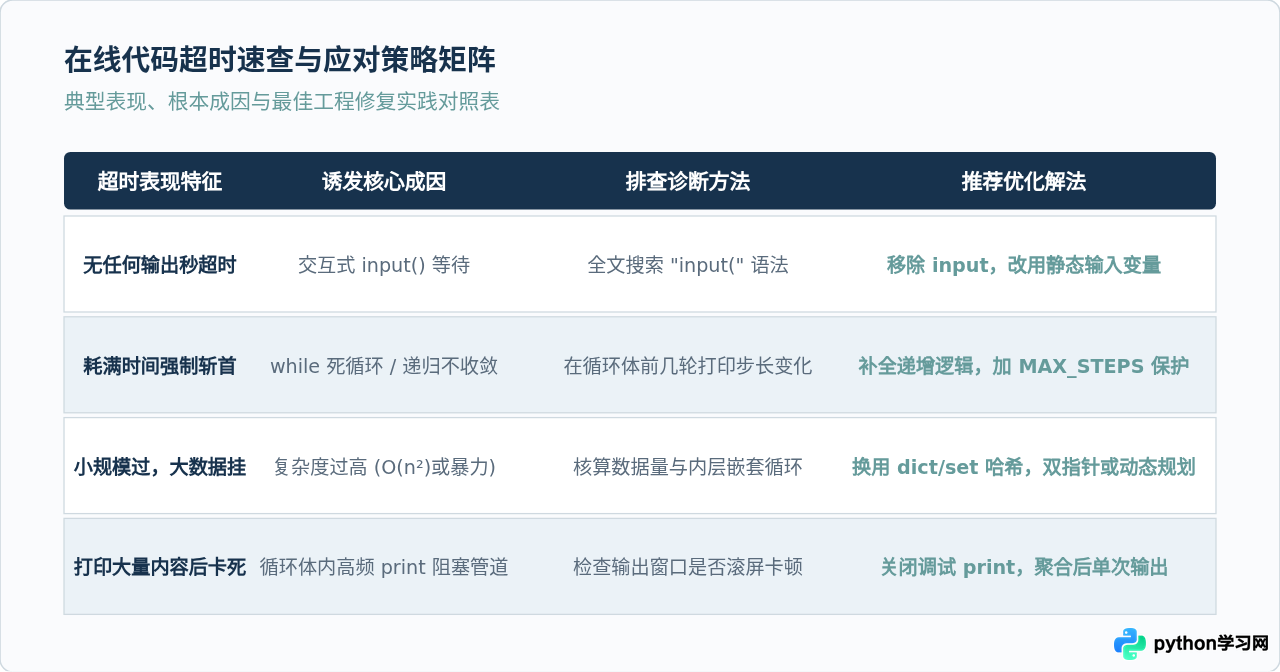
总结:在线运行Python出现超时,是学习编程过程中极有价值的反馈信号。它促使我们不仅要关注代码“能不能得出正确结果”,更要关注算法的“时间复杂度阶数”和“资源消耗边界”。掌握沙箱运行机理,养成检查输入状态、审查循环出口、优先使用高效数据结构的习惯,就能彻底摆脱超时的困扰。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















