


Python将嵌套字典或JSON数据展平后导入CSV文件
详细讲解如何使用Python内置模块与pandas将多层嵌套的字典或JSON数据展平成扁平结构,并规范导出为CSV文件的具体步骤与避坑指南。
将多层嵌套的字典或 JSON 数据导出为二维 CSV 文件,核心任务是确定“键名拼接规则”与“记录拆分维度”,将纵向延伸的树状层级压缩为横向扩展的列。本文通过纯 Python 原生递归与 pandas.json_normalize 两种方案,讲解单条与列表嵌套数据的展平逻辑、处理边界,并最终生成格式合规的 CSV 文件。
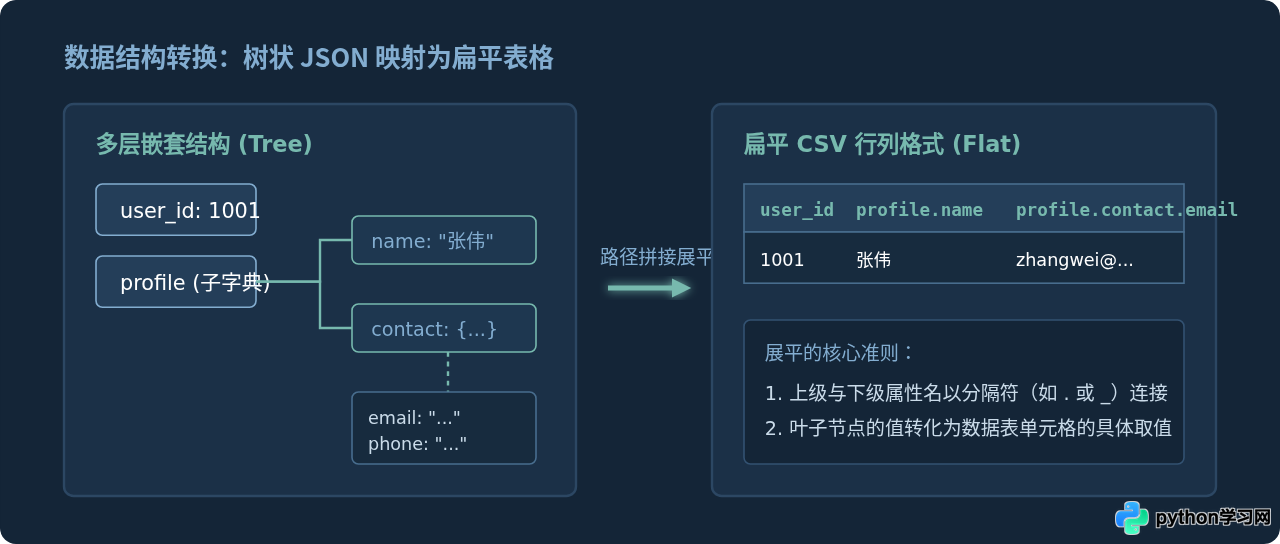
1. 树状层级与二维表格的结构冲突
假设你从某个第三方接口调用用户详情,返回了如下包含地址信息与多级配置的典型嵌套结构:
{
  "user_id": 1001,
  "profile": {
    "name": "张伟",
    "contact": {
      "email": "zhangwei@example.com",
      "phone": "13800000000"
    }
  },
  "roles": ["developer", "admin"]
}
CSV 本质上是由固定的行和列构成的二维文本格式,每个单元格仅能承载原子化的标量数据(如字符串、数字)。一旦遇到内嵌的子字典,表格无法在同一个单元格中直接表现从属结构;而遇到数组列表时,又面临“是将多个元素拼成一个字段,还是分裂成多行展示”的决策抉择。如果直接强行把子字典写入 CSV,通常只能得到类似 "{'name': '张伟'}" 这样的无序字符串,丢失了结构化查询与统计价值。
2. 方法一:使用 Python 原生内置模块进行递归展平
如果项目环境受到限制,不能安装第三方科学计算库,使用标准库中的 csv 配合自定义递归函数是兼顾轻量与灵活的解决方案。处理的思路是:遍历字典的所有键值对,若值依然是字典,则带上前缀继续向下递归,直到抵达基本数据类型。
2.1 递归函数实现
下面的 flatten_dict 函数能够以点号 . 作为连接符,将任意深度的嵌套字典压缩为一维结构:
def flatten_dict(nested_dict, parent_key='', sep='.'):
    """
    将多层嵌套字典递归转换为一维平铺字典。
    :param nested_dict: 待展平的字典对象
    :param parent_key: 上一层级的键前缀
    :param sep: 键名层级之间的连接符
    :return: 扁平化后的一维字典
    """
    items = []
    for k, v in nested_dict.items():
        new_key = f"{parent_key}{sep}{k}" if parent_key else str(k)
        if isinstance(v, dict):
            # 遇到字典类型,继续向下递归展平
            items.extend(flatten_dict(v, new_key, sep=sep).items())
        elif isinstance(v, list):
            # 遇到简单列表类型,转为以逗号分隔的字符串以保留单行结构
            # 若列表内部包含子字典,需配合拆行逻辑处理(参见第 4 节)
            items.append((new_key, ", ".join(map(str, v))))
        else:
            # 基础标量值直接保留
            items.append((new_key, v))
    return dict(items)
2.2 收集字段名并批量写入 CSV
在实际业务中,由于不同记录所拥有的属性可能存在差异(部分嵌套字段在某些数据项中缺失),直接写入会导致列名错位。必须先汇总所有记录展开后的完整键集合,再使用 csv.DictWriter 统一写入:
import csv

records = [
    {
        "id": 1,
        "name": "李强",
        "info": {"age": 28, "city": "北京"}
    },
    {
        "id": 2,
        "name": "王芳",
        "info": {"age": 32, "city": "上海", "education": "硕士"}
    }
]

# 1. 展平全部数据
flattened_records = [flatten_dict(item) for item in records]

# 2. 收集所有出现过的字段名作为表头
headers = set()
for r in flattened_records:
    headers.update(r.keys())
fieldnames = sorted(list(headers))

# 3. 写入 CSV 文件
with open('output_native.csv', mode='w', encoding='utf-8-sig', newline='') as f:
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()
    for row in flattened_records:
writer.writerow(row)encoding='utf-8-sig',这样 Python 会在文件开头写入 BOM 头,防止 Excel 自动按 ANSI 编码解析导致中文乱码。同时必须指定 newline='',避免在 Windows 环境下出现空行。
3. 方法二:使用 pandas 库快速完成解析与导出
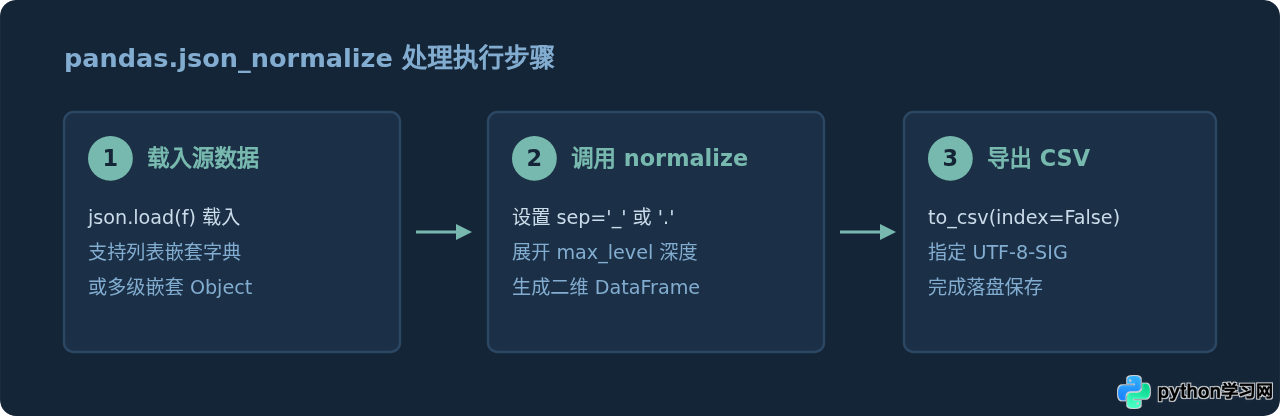
在安装了数据分析生态的环境中,pandas.json_normalize 是处理嵌套结构的标准工具。该函数内部深度优化了路径解析机制,能够一行代码将复杂 JSON 数组转换为 DataFrame,再通过 to_csv() 完成输出。
3.1 标准操作代码
import json
import pandas as pd

# 模拟从文件加载复杂 JSON 数据
raw_json = '''
[
  {
    "order_id": "ORD-2026-001",
    "customer": {
      "name": "陈敏",
      "address": {
        "province": "浙江",
        "city": "杭州"
      }
    },
    "payment": {
      "status": "PAID",
      "amount": 299.5
    }
  },
  {
    "order_id": "ORD-2026-002",
    "customer": {
      "name": "刘洋",
      "address": {
        "province": "广东",
        "city": "深圳"
      }
    },
    "payment": {
      "status": "UNPAID",
      "amount": 128.0
    }
  }
]
'''

data = json.loads(raw_json)

# 使用 json_normalize 展平,并通过 sep 指定列名连接符
df = pd.json_normalize(data, sep='_')

# 导出为 CSV 文件
df.to_csv('orders_flattened.csv', index=False, encoding='utf-8-sig')

# 输出清洗后的结果查看
print(df.columns.tolist())
# 输出示例: ['order_id', 'customer_name', 'customer_address_province', 'customer_address_city', 'payment_status', 'payment_amount']
在执行上述代码后,生成的 orders_flattened.csv 内容呈现标准规则矩阵,嵌套对象的所有叶子节点均升维成为第一层列,可以直接供数据库入库工具或电子表格调用。
4. 进阶场景:当嵌套结构中包含列表(一对多)
最棘手的嵌套情况并非字典套字典,而是对象中包含了数组列表,例如“一位客户拥有多张信用卡”或“一个订单包含多个商品明细”。在关系型建模中,这属于一对多(1:N)关联。
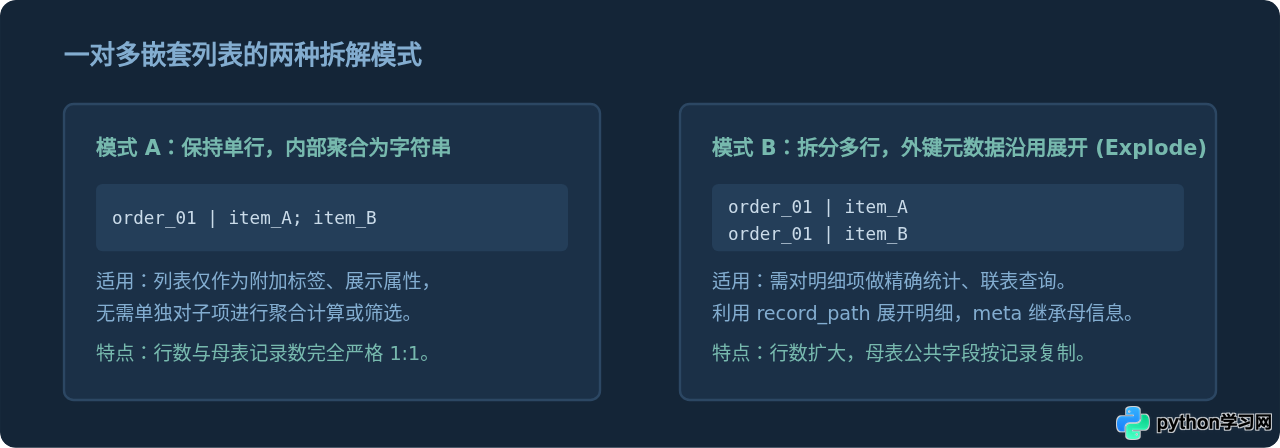
如果业务场景需要将列表拆解成多行呈现,可以利用 json_normalize 的 record_path 和 meta 参数:
order_payload = [
    {
        "order_id": "ORD-001",
        "store": "旗舰店",
        "items": [
            {"sku": "SKU-A", "qty": 2, "price": 50},
            {"sku": "SKU-B", "qty": 1, "price": 100}
        ]
    }
]

# record_path 指定需要拆开为行的列表键名
# meta 指定在每一行中需要继承保留的顶层公共字段
df_exploded = pd.json_normalize(
    order_payload,
    record_path=['items'],
    meta=['order_id', 'store'],
    meta_prefix='meta_'
)

df_exploded.to_csv('items_exploded.csv', index=False, encoding='utf-8-sig')
导出生成的 CSV 数据结构如下所示:
| sku | qty | price | meta_order_id | meta_store |
|---|---|---|---|---|
| SKU-A | 2 | 50 | ORD-001 | 旗舰店 |
| SKU-B | 1 | 100 | ORD-001 | 旗舰店 |
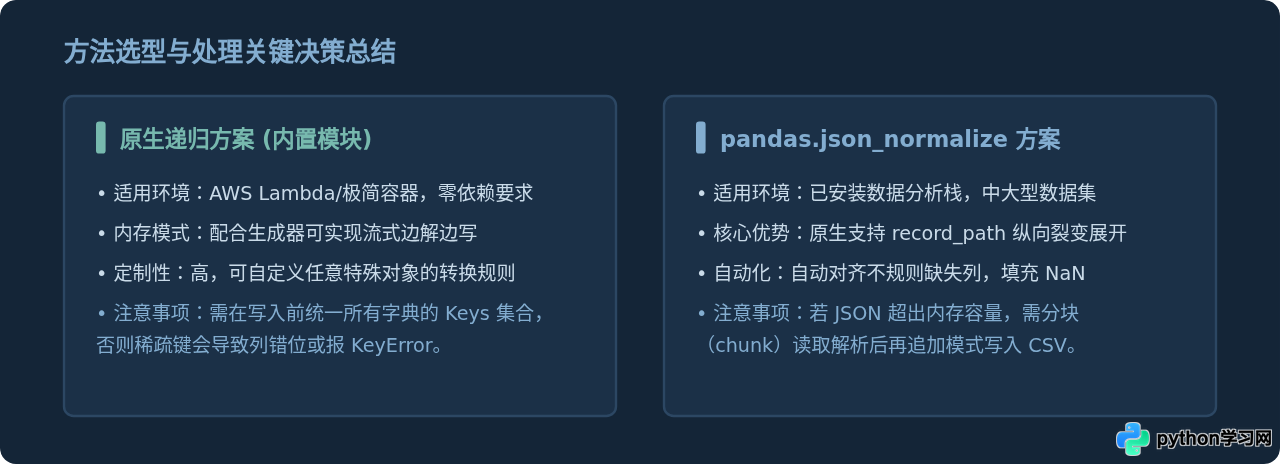
5. 两种方案选型与技术总结
在面对不同体量与复杂度的数据时,应根据部署依赖、内存表现和结构复杂度选择合适的实现方案:
6. 常见问题排查与注意事项
-
特殊字符与逗号截断:如果展平后的字段值中包含换行符(
\n)或半角英文逗号(,),会导致某些简陋解析器串行。Python 内置的csv.writer与 pandas 会默认在包含特殊字符的字符串两侧包裹双引号。在读取导出的 CSV 时,务必通过标准的 CSV 引擎加载,避免使用纯文本按逗号切分(split(','))。 -
层级过深时的栈溢出风险:默认情况下 Python 的最大递归深度为 1000。如果 JSON 嵌套异常深(例如极深递归生成树),可使用基于显式栈循环的迭代法替换函数递归,或适度调整
sys.setrecursionlimit()。 -
分隔符冲突:如果原始字段名本身就包含点号(如
"v1.0": {"status": "ok"}),使用默认的sep='.'会导致还原与解析时的歧义。此时建议改用双下划线sep='__'作为路径连接符。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















