


python闭包函数怎么定义有什么用
深入解析Python闭包函数的定义方式、实现条件、底层内存运行机制以及核心应用场景,结合代码示例与图解排查常见陷阱与技术选型。
一、闭包函数怎么定义:三大必备条件与标准范式
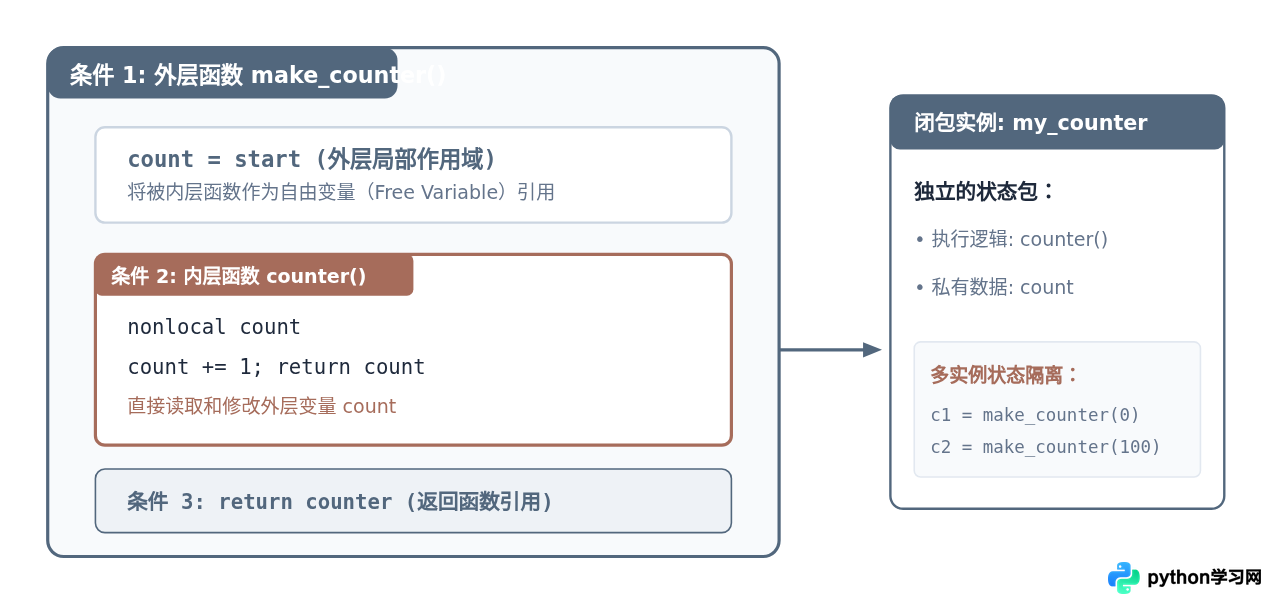
很多初学者在写嵌套函数时,经常误以为“只要函数里面套函数”就是闭包。实际上,Python 语法中构成闭包有三个严格的必要条件,缺一不可:
- 必须存在函数嵌套:必须有一个外层函数(Outer Function)和一个内嵌定义的内层函数(Inner Function)。
- 内层函数必须引用外层的变量:内层函数体中至少读取或操作了一个属于外层函数局部作用域的变量(该变量对于内层函数而言称为“自由变量”,Free Variable)。
- 外层函数必须返回内层函数对象本身:返回的是函数本身的引用(即
return inner),而不是调用后的执行结果(不是return inner())。
下面我们通过一个最基础的计数器(Counter)示例,展示闭包的标准定义与调用过程:
# 闭包标准定义代码
def make_counter(start=0):
    # count 是外层函数的局部变量,也是内层函数的自由变量
    count = start

    def counter():
        nonlocal count  # 声明修改外层作用域变量
        count += 1
        return count

    # 注意:返回的是函数对象本身,不要加小括号
    return counter

# 实例化闭包
my_counter = make_counter(10)

print(my_counter())  # 输出: 11
print(my_counter())  # 输出: 12
print(my_counter())  # 输出: 13
在上面的代码中,make_counter(10) 调用结束后,按常理其内部的局部变量 count 应该随着栈帧销毁而释放。但由于返回的 counter 形成了闭包,count 的值被完整保留了下来,并在随后的每一次调用中持续递增。
二、闭包的运作机制:为什么外部变量不会被销毁?
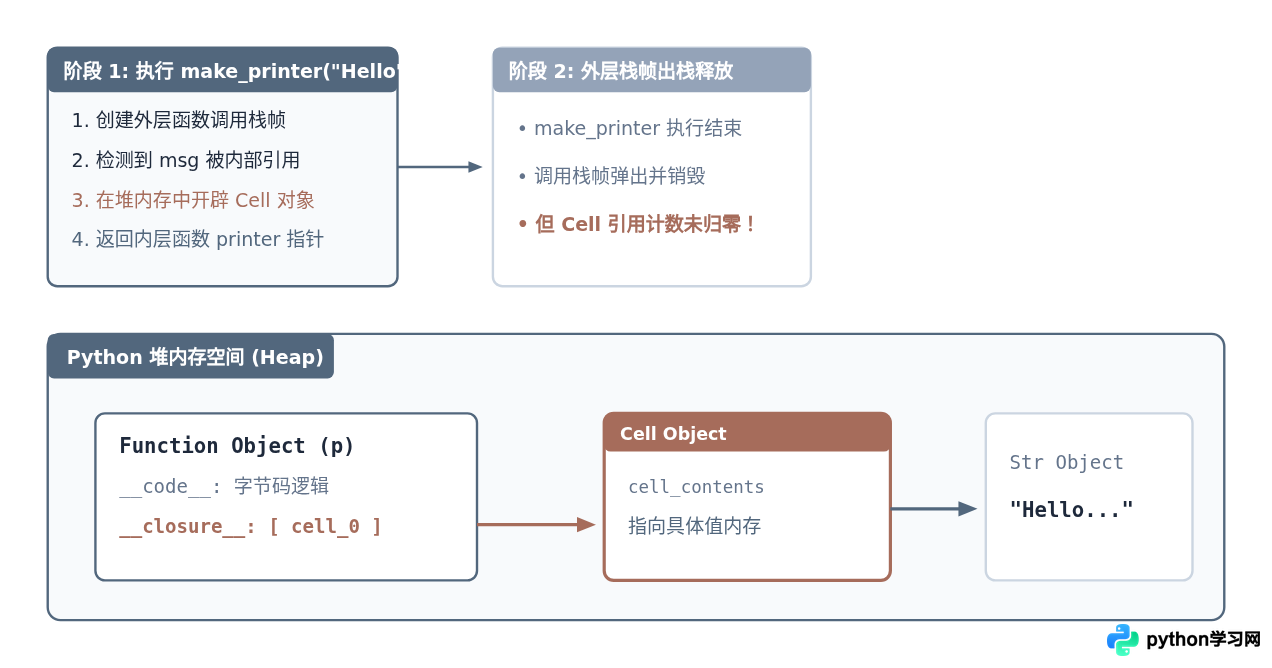
按照标准的函数调用栈模型,当一个函数执行完毕并返回时,它的局部作用域栈帧(Stack Frame)就会被出栈并释放,其内部的所有局部变量也应随之被垃圾回收。为什么闭包能够“打破”这个生命周期规律?
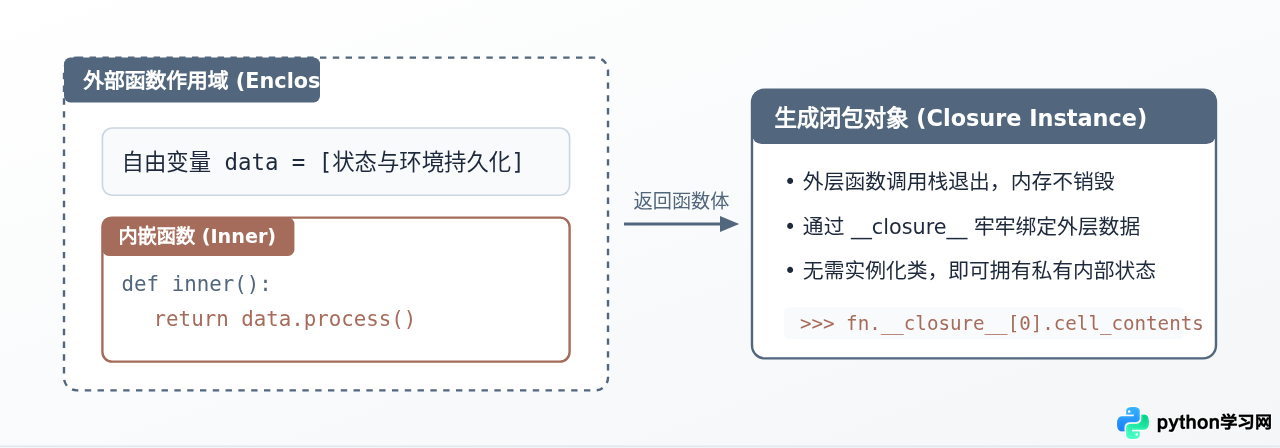
原因在于 Python 解释器在语法解析阶段做了特殊处理:当发现内嵌函数引用了外层变量时,Python 会将这个变量打包存放在一个专门的 Cell 对象 中。返回的内嵌函数对象拥有一个内置属性 __closure__,该属性是一个元组,里面存放着指向各个 Cell 对象的指针。
我们可以通过 Python 内省(Introspection)代码直接观测到底层的储存结构:
def make_printer(msg):
    def printer():
        print(f"Message is: {msg}")
    return printer

p = make_printer("Hello Antigravity")
p()

# 检查闭包属性
print("是否为闭包:", p.__closure__ is not None)
print("引用的 Cell 对象:", p.__closure__)
print("Cell 内部持久化的具体值:", p.__closure__[0].cell_contents)
print("自由变量名称列表:", p.__code__.co_freevars)
可以看到,即使 make_printer 已经运行完毕,变量 msg 的引用仍然牢牢保存在 p.__closure__[0].cell_contents 中。只要函数引用 p 没有被垃圾回收,底层的 Cell 对象就会一直存活。
三、闭包到底有什么用?三大核心应用场景
了解了闭包的定义和原理后,最实际的问题在于:我们在日常开发中为什么需要闭包?相比普通函数或面向对象类,闭包提供了哪些独特优势?
1. 轻量级状态封装:避免全局变量与臃肿的类
当我们需要一个函数在多次调用之间记住某些状态数据时,通常有三种解决方案:全局变量、面向对象类(Class)和闭包。
- 全局变量:破坏代码封装性,极易发生命名冲突,且无法做到多实例隔离。
- 定义类:为了简单的一个状态和单次调用,定义
class、编写__init__和__call__,往往显得代码繁琐且开销较大。 - 闭包:在函数内部保持局部私有状态,外界无法直接篡改,同时支持生成多个互不干扰的独立实例,既轻量又优雅。
# 场景:滑动平均值计算器
def make_averager():
    series = []  # 私有状态列表,外界无法直接访问或随意清空

    def averager(new_val):
        series.append(new_val)
        return sum(series) / len(series)

    return averager

avg_sensor = make_averager()
print("第 1 次测量均值:", avg_sensor(10))
print("第 2 次测量均值:", avg_sensor(20))
print("第 3 次测量均值:", avg_sensor(30))2. 函数工厂(Function Factory):动态生成定制化逻辑
闭包可以根据传入的不同参数,批量生产具有特定预设逻辑的专属函数。在科学计算、格式转换、数据校验以及数学幂运算中非常实用:
# 函数工厂:生成不同指数的幂函数
def power_factory(exponent):
    def calculate(base):
        return base ** exponent
    return calculate

square = power_factory(2)  # 专用平方函数
cube = power_factory(3)    # 专用立方函数

print("4 的平方:", square(4))
print("4 的立方:", cube(4))3. Python 装饰器(Decorator)的底层实现机制
Python 最常用的特性之一——装饰器,本质上就是接收一个函数作为自由变量,并返回闭包函数的语法糖。没有闭包,就无法实现无侵入式增强函数功能的装饰器机制。
import time

# 装饰器本质:接收原函数为自由变量并返回闭包 wrapper
def time_tracker(func):
    def wrapper(*args, **kwargs):
        start_time = time.time()
        result = func(*args, **kwargs)
        duration = time.time() - start_time
        print(f"[{func.__name__}] 耗时: {duration:.4f} 秒")
        return result
    return wrapper

@time_tracker
def compute_sum(n):
    return sum(range(n))

print("计算结果:", compute_sum(500000))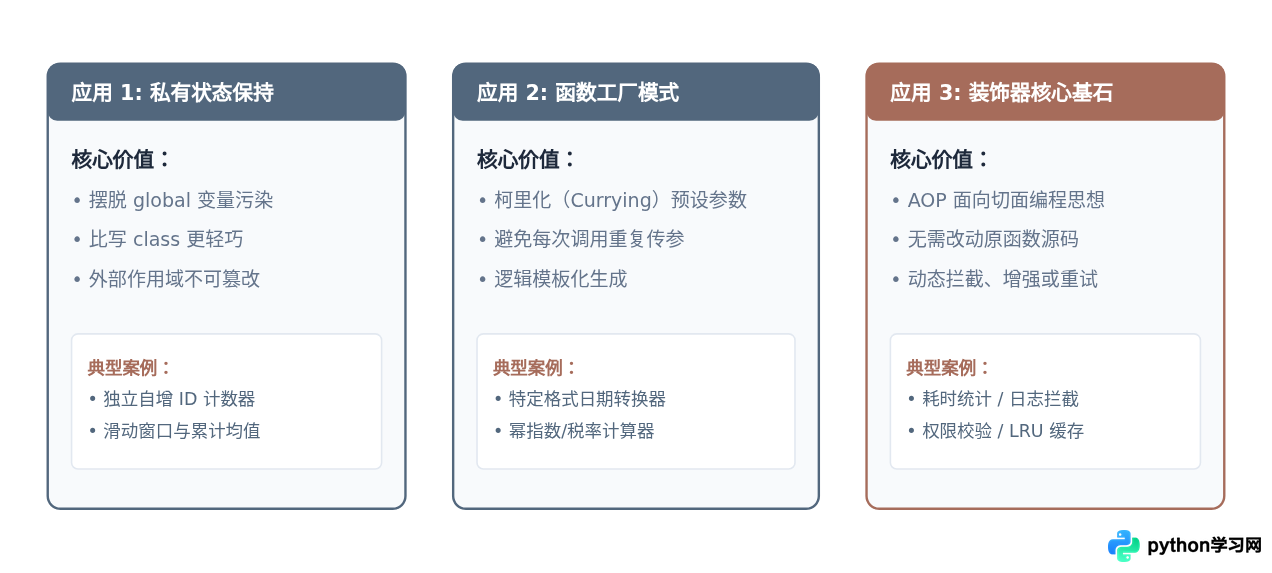
四、使用闭包的两大高频陷阱与选型指南
编写闭包函数虽然能带来高度的灵活性,但由于其独特的作用域机制,开发者经常会在两个常见问题上踩坑。
陷阱 1:变量修改引发 UnboundLocalError 与 nonlocal 关键字
在 Python 中,如果函数内部对一个变量进行赋值操作(如 count += 1),Python 会默认将其认定为当前函数的局部变量。如果在赋值之前尝试读取,就会抛出 UnboundLocalError:
# 错误示例:未声明 nonlocal 直接修改
def bad_counter():
    count = 0
    def inc():
        # 抛出异常: UnboundLocalError: local variable 'count' referenced before assignment
        count += 1
        return count
    return inc

# 正确做法:必须显式声明 nonlocal
def good_counter():
    count = 0
    def inc():
        nonlocal count  # 告诉解释器 count 来自外层作用域
        count += 1
        return count
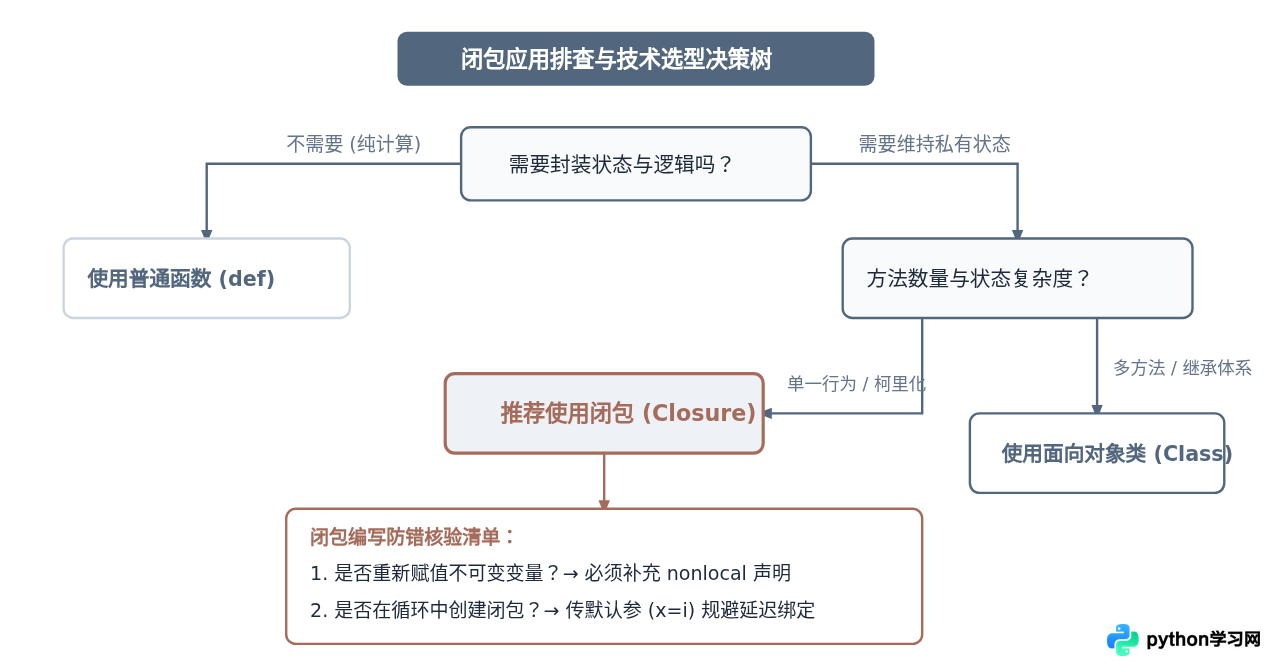
return inc注意区分:如果是对可变对象(如 list.append() 或 dict['key'] = val)进行内部修改,并不属于变量重新绑定,因此不需要 nonlocal;但只要涉及 =、+=、-= 等重新绑定变量名的操作,必须使用 nonlocal。
陷阱 2:循环生成闭包时的“延迟绑定”(Late Binding)
在 for 循环中批量生成闭包函数时,最容易出现所有闭包都返回同一个值的 Bug。这是因为闭包引用的自由变量是在函数被实际调用时去寻找绑定的值,而不是在定义阶段固化的值:
# 常见陷阱:循环延迟绑定
funcs = []
for i in range(3):
    # lambda 内部引用了外部变量 i
    funcs.append(lambda: i)

# 期望输出: 0, 1, 2
# 实际输出: 2, 2, 2
print("陷阱结果:", [f() for f in funcs])

# 解决方案:使用默认参数在定义期强制捕获当前数值
fixed_funcs = []
for i in range(3):
    fixed_funcs.append(lambda current=i: current)

print("修复后结果:", [f() for f in fixed_funcs])技术选型:什么时候用闭包?什么时候该用类?
既然闭包和类都能实现“逻辑 + 状态”的捆绑,我们应该如何抉择?
- 选用闭包:当状态较少(通常 1~2 个变量),且对外只暴露单一行为/函数调用时(如计数、过滤、参数柯里化),闭包更纯粹、开销更小、代码行数更少。
- 选用类(Class):当需要维护复杂的多属性状态,或者需要对外暴露多个不同方法(如
start()、stop()、reset())并支持继承与重载时,应果断定义类。
五、总结
Python 闭包并非神秘的语法黑魔法,而是作用域规则与对象生命周期结合的自然产物:
- 怎么定义:满足嵌套定义、内部引用外部自由变量、返回内部函数引用三要素即可构成闭包。
- 底层原理:Python 通过
__closure__元组与 Cell 对象在堆中维系自由变量的引用计数,保证栈帧退出后环境依然存活。 - 有什么用:用于轻量级私有状态持久化(替代全局变量与轻量级类)、函数工厂(按需生成专用逻辑),并作为 Python 装饰器的底层技术基石。
在日常开发中,只要牢记使用 nonlocal 正确更新外层不可变变量、利用默认参数规避循环延迟绑定陷阱,闭包便能成为编写高复用度、低耦合度 Python 代码的利器。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















