


Python元组、列表和字典在浅拷贝与深拷贝中的行为差异
深入解析Python中元组、列表和字典在浅拷贝与深拷贝下的底层机制与行为差异,包含内存图解、代码示例与工程避坑指南。
在 Python 中,变量之间的简单赋值(=)仅仅是绑定了同一块内存地址的标签引用,并不会创建任何独立的对象副本。当数据结构嵌套时,浅拷贝(Shallow Copy)与深拷贝(Deep Copy)的区别便直接决定了后续修改是否会引发难以察觉的数据污染。然而,面对 Python 内置的三大核心容器——列表(list)、字典(dict)与元组(tuple),拷贝机制并非一视同仁。由于列表和字典属于可变容器,而元组属于不可变容器,Python 解释器在执行复制操作时引入了独特的优化规则与内部复用策略。本文将系统拆解这三种数据结构在浅拷贝与深拷贝中的内存机制与行为边界,帮助你在工程实践中避开数据意外篡改的隐患。
一、核心机制:赋值、浅拷贝与深拷贝的内存区别
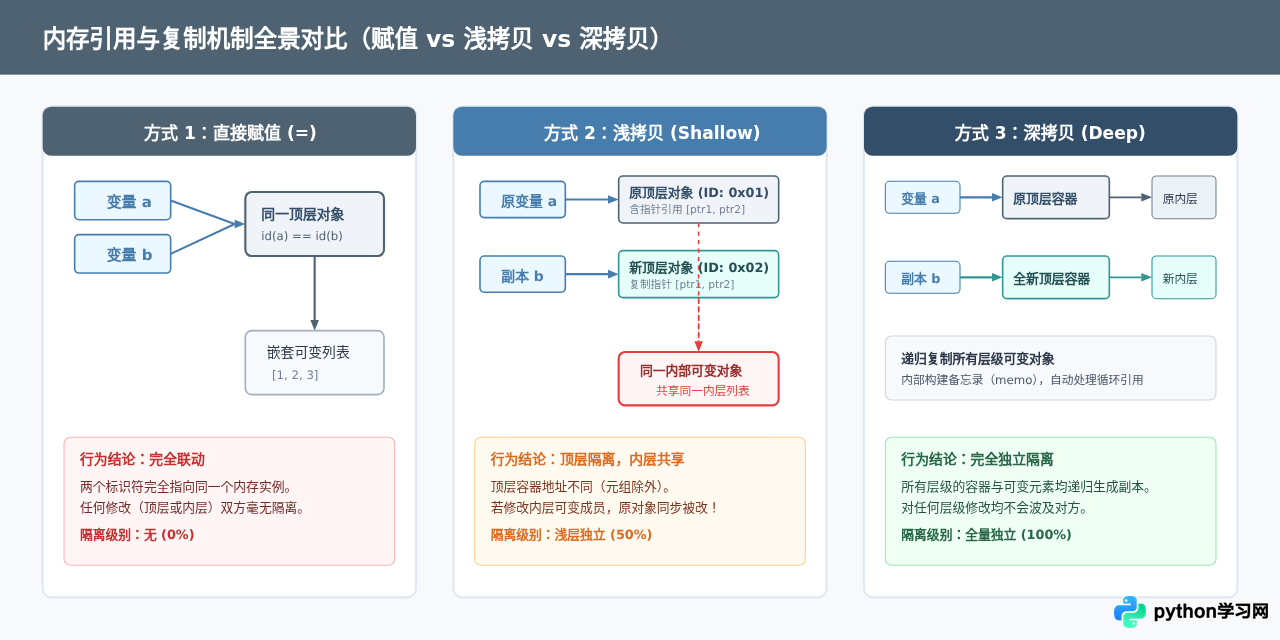
在探讨特定容器前,必须首先理清这三种操作在底层指针和内存管理上的本质界限:
- 直接赋值(
b = a):不发生任何对象构造,仅让新变量名指向与旧变量完全相同的内存空间。无论是修改顶层属性还是内层元素,两者完全联动。 - 浅拷贝(
b = copy.copy(a)或各类型特有浅拷贝方法):在内存中分配一个新的顶层容器对象(此时id(b) != id(a)),但该容器内部存储的所有元素指针,仍然直接引用原容器中各元素的内存地址。若元素本身是不可变类型(如数值、字符串),修改操作会生成新对象而不影响原容器;但若元素是可变对象(如嵌套列表),原位修改仍会直接反映在两边。 - 深拷贝(
b = copy.deepcopy(a)):沿着对象的引用链进行递归遍历,只要遇到可变容器或可变成员,都会在内存中全新克隆一份,彻底阻断任何嵌套层级的引用共享。
二、列表(List)的行为表现:标准的浅层与深层解耦
列表是 Python 中最常见且最符合直觉的可变序列。在浅拷贝与深拷贝时,列表展现出标准的行为范式:
1. 列表浅拷贝的多种途径与表现
在 Python 中,生成一个列表的浅拷贝有多种等价方式:
- 切片语法:
copy_list = original_list[:] - 内置方法:
copy_list = original_list.copy() - 工厂函数:
copy_list = list(original_list) - 标准库调用:
copy_list = copy.copy(original_list)
无论采取上述哪一种方式,Python 都会在堆上开辟一块全新的列表内存空间,因此 id(copy_list) != id(original_list) 恒为真。向新列表中 append() 或 pop() 元素,原列表纹丝不动。但如果列表中嵌套了子列表,该子列表在两个外层列表中存储的仅仅是指针地址。
import copy

# 准备包含嵌套可变对象的列表
orig_list = ["alpha", [1, 2, 3]]
shallow_list = orig_list.copy()

# 验证顶层容器:确实是不同对象
print(shallow_list is orig_list)           # 输出: False
print(id(shallow_list) == id(orig_list))   # 输出: False

# 验证内层嵌套列表:仍指向同一个对象
print(shallow_list[1] is orig_list[1])     # 输出: True

# 触发修改:原地变更内层列表
shallow_list[1].append(999)

# 观察原列表:被同步污染!
print(orig_list)    # 输出: ['alpha', [1, 2, 3, 999]]
print(shallow_list) # 输出: ['alpha', [1, 2, 3, 999]]
2. 列表深拷贝的递归解耦
使用 copy.deepcopy(orig_list) 后,Python 会递归创建内部所有子列表的全新对象。此时不仅 orig_list is deep_list 为 False,就连 orig_list[1] is deep_list[1] 也为 False。修改深拷贝对象内的任何元素,原列表绝不会受任何影响。
三、字典(Dict)的行为表现:键与值的引用分层
字典作为基于散列表实现的映射类型,其内部存储的是键值对槽位。理解字典在浅拷贝与深拷贝中的表现,关键在于分清顶层键值对映射关系的变动与值对象内部的原位修改。
1. 字典浅拷贝的三种常见方式
- 方法调用:
new_dict = d.copy() - 工厂构造:
new_dict = dict(d) - 字典解包:
new_dict = {**d}
浅拷贝后,Python 为 new_dict 构建了专属的哈希表结构。如果你为 new_dict 新增一个键、删除一个已有键,或者直接让某个键指向一个全新的数据对象,原字典均不受影响。然而,如果某个键对应的值(Value)是一个可变对象(例如列表、字典或集合),浅拷贝只复制了指针。通过 new_dict['key'].append(...) 进行的原位变动,同样会反噬原字典。
import copy

orig_dict = {
    "server": "web-01",
    "ports": [80, 443]  # 可变值对象
}

shallow_dict = orig_dict.copy()

# 顶层键赋值:生成新对象绑定,互不干扰
shallow_dict["server"] = "web-02"
print(orig_dict["server"])    # 输出: web-01 (未被修改)

# 内层原位修改:通过指针变更共享对象
shallow_dict["ports"].append(8080)
print(orig_dict["ports"])     # 输出: [80, 443, 8080] (被意外修改!)
2. 字典深拷贝对可变值与不可变键的处理
执行 copy.deepcopy(orig_dict) 时,字典的所有值对象都会被递归克隆。值得注意的是,Python 字典的键(Key)必须是不可变类型(Hashable,如字符串、数字或纯不可变元组)。深拷贝在处理不可变键时,会明智地复用不可变对象本身,而不会做多余的克隆,既保证了隔离安全,又兼顾了运行效率。
四、元组(Tuple)的反直觉优化与行为特例
元组是 Python 中最特殊的容器类型,因为它是不可变序列(Immutable)。正是由于不可变性,Python 解释器在浅拷贝和深拷贝的底层实现上采用了激进的内存优化策略,往往会出现超出直觉的现象。
1. 浅拷贝的“零开销复用”
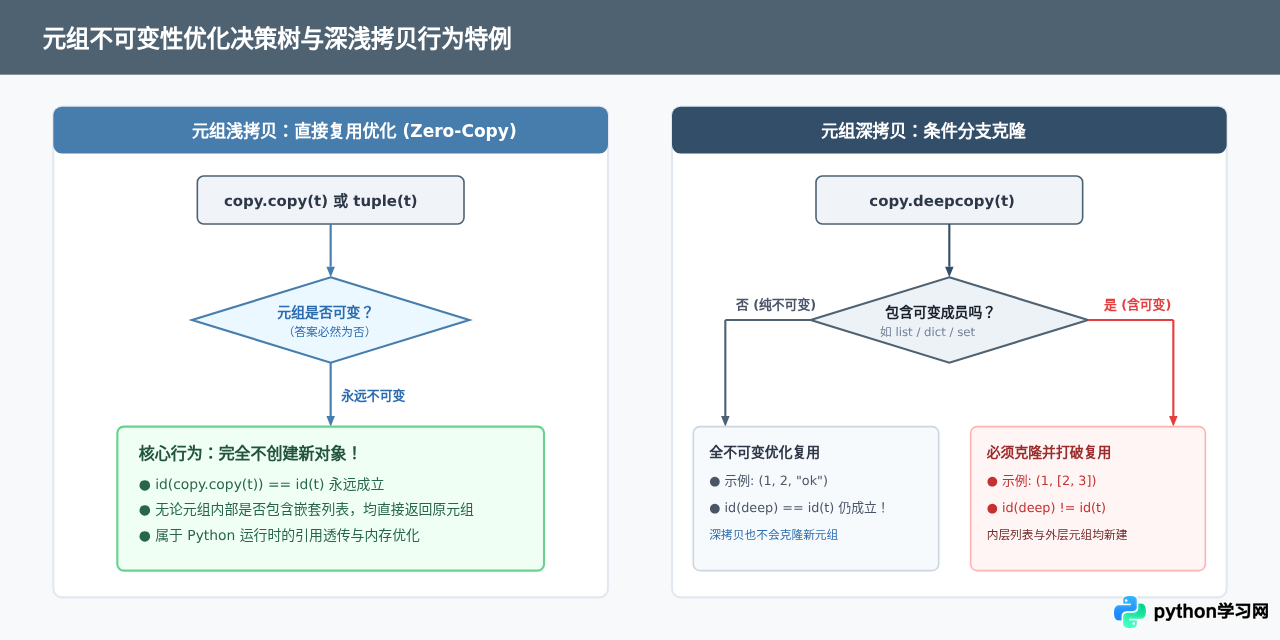
如果你对一个元组执行 copy.copy(t) 或 tuple(t),Python 绝不会在内存中创建任何新对象,而是直接返回原对象的引用。这是因为元组是不可变的,任何人都无法修改它的长度或替换其槽位中的指针,因此创建新元组在逻辑上毫无意义,只会徒增内存消耗。这一点与列表和字典形成了极其鲜明的对比:
import copy

# 列表浅拷贝:必然创建新对象
l = [1, 2, 3]
print(copy.copy(l) is l)  # 输出: False

# 元组浅拷贝:直接复用原对象引用
t = (1, 2, 3)
print(copy.copy(t) is t)  # 输出: True!id 完全相同
print(tuple(t) is t) # 输出: True!t = (1, [2, 3])),copy.copy(t) 依然返回原元组本身(copy.copy(t) is t 仍为 True)。浅拷贝绝不会因为内层有可变元素而为你新建元组外壳!
2. 深拷贝中的条件分支克隆
很多开发者误以为深拷贝一定会为任何容器分配新内存。但在元组身上,copy.deepcopy() 会先探查其内部是否包含任何可变成员:
- 纯不可变元组(如
(1, 2, "abc")):元组无法被修改,其包含的所有子元素也无法被修改。此时深拷贝如果创建新对象纯属浪费。因此,Python 的深拷贝同样会触发优化,直接返回原元组(copy.deepcopy(t) is t为 True)。 - 含可变成员的元组(如
(1, [2, 3])):尽管外层元组不可变,但内层的列表是可变的。为了保证深拷贝的“绝对隔离”语义,Python 此时必须克隆内部列表,并且因为列表地址变了,外层元组也必须重新构造以容纳新的列表指针!此时copy.deepcopy(t) is t才会变为 False。
import copy

# 案例 A:纯不可变元组深拷贝
pure_t = (1, 2, ("x", "y"))
deep_pure = copy.deepcopy(pure_t)
print(deep_pure is pure_t)  # 输出: True!并没有创建新元组

# 案例 B:包含可变对象的元组深拷贝
mut_t = (1, [2, 3])
deep_mut = copy.deepcopy(mut_t)
print(deep_mut is mut_t)            # 输出: False!外层元组重新创建了
print(deep_mut[1] is mut_t[1])      # 输出: False!内层列表也重新克隆了
五、行为验证操作流:四步确认数据隔离性
在面对复杂的复合数据结构时,不能仅凭直觉判断对象是否安全。建议按照以下规范的四步操作流在单元测试或调试环境中进行验证:
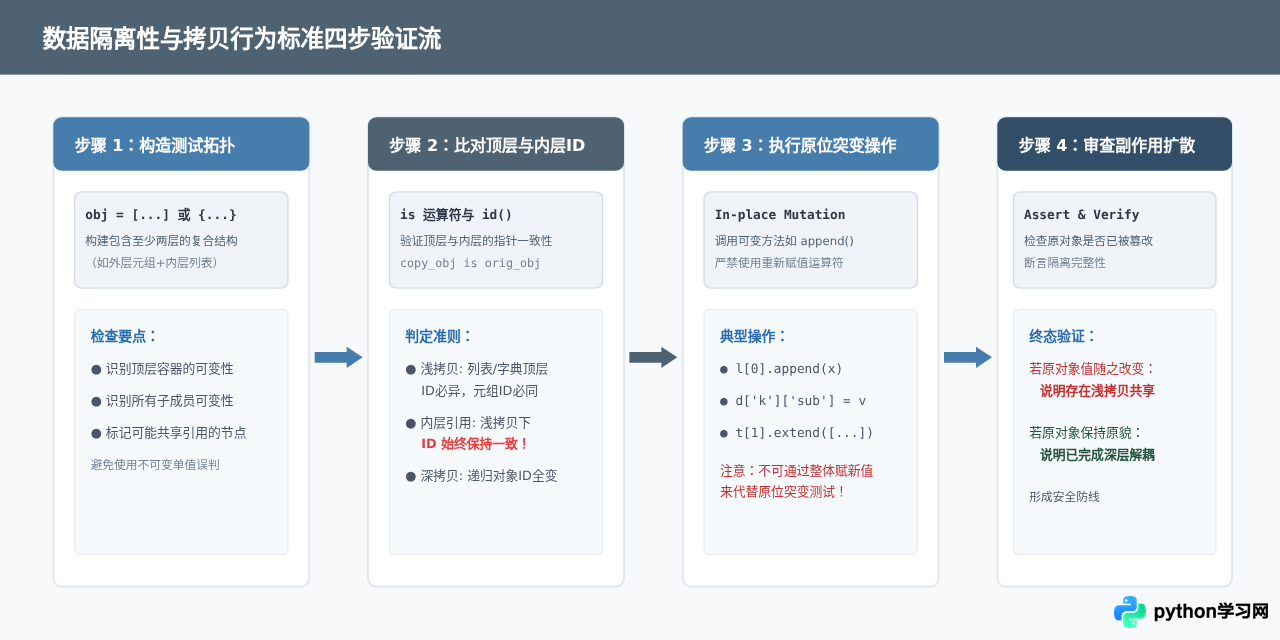
- 构造多层拓扑:在测试用例中,务必构造包含嵌套可变对象的容器(例如
outer = [[1, 2], {"count": 10}]),单一深度的平铺容器无法暴露浅拷贝的引用共享缺陷。 - 比对指针地址:运行
is运算符。若顶层返回True(元组浅拷贝特有),说明直接透传了引用;若顶层False但内层True,说明是标准浅拷贝。 - 执行原位操作(In-place Mutation):对副本的内层对象调用改变自身内容的方法(如
append()、pop()、dict.update()),注意不要进行重新赋值,重新赋值会改变指针指向从而掩盖问题。 - 核实污染范围:打印原对象的内容。如果原对象的值发生了改变,即可实证当前拷贝策略存在数据泄露与副作用扩散。
六、全景对比与工程选型避坑指南
在工程项目中,选择浅拷贝还是深拷贝,需要在数据安全性与运行时性能之间取得平衡:
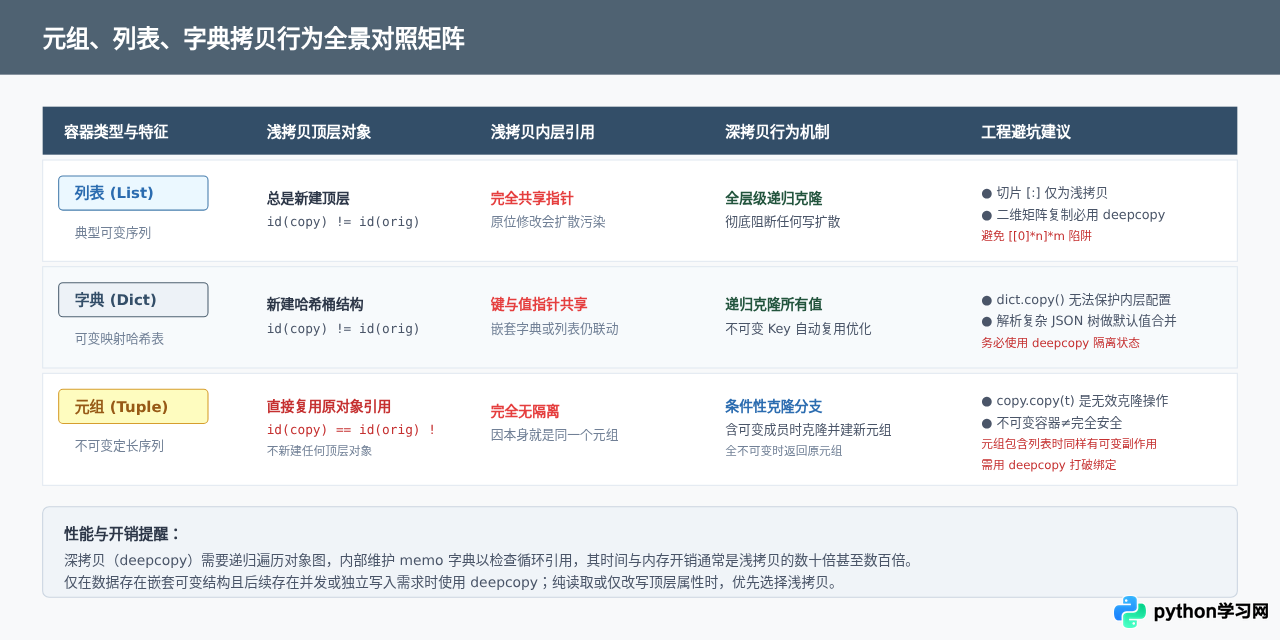
| 容器类型 | 浅拷贝方式 | 浅拷贝顶层 ID | 浅拷贝内层引用 | 深拷贝行为 |
|---|---|---|---|---|
| 列表 (List) | l.copy() / l[:] |
独立新对象 (不同) | 共享同一地址 (相同) | 全链路递归克隆,彻底隔离 |
| 字典 (Dict) | d.copy() / {**d} |
独立新哈希表 (不同) | 键与值指针共享 (相同) | 递归克隆所有值对象,不可变键复用 |
| 元组 (Tuple) | copy.copy(t) / tuple(t) |
透传复用 (完全相同) | 透传复用 (完全相同) | 含可变对象时新建元组与子对象;纯不可变时复用原元组 |
掌握列表、字典和元组在复制时的行为边界,本质上是掌握 Python 对象模型与可变性设计哲学的体现。在日常开发中,对包含嵌套数据结构的配置字典、多维列表或含列表的元组进行状态流转时,务必根据实际的读写场景合理选择拷贝策略,从源头上杜绝隐蔽的引用共享缺陷。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















