


怎么向面试官解释Polars多线程SIMD加速?
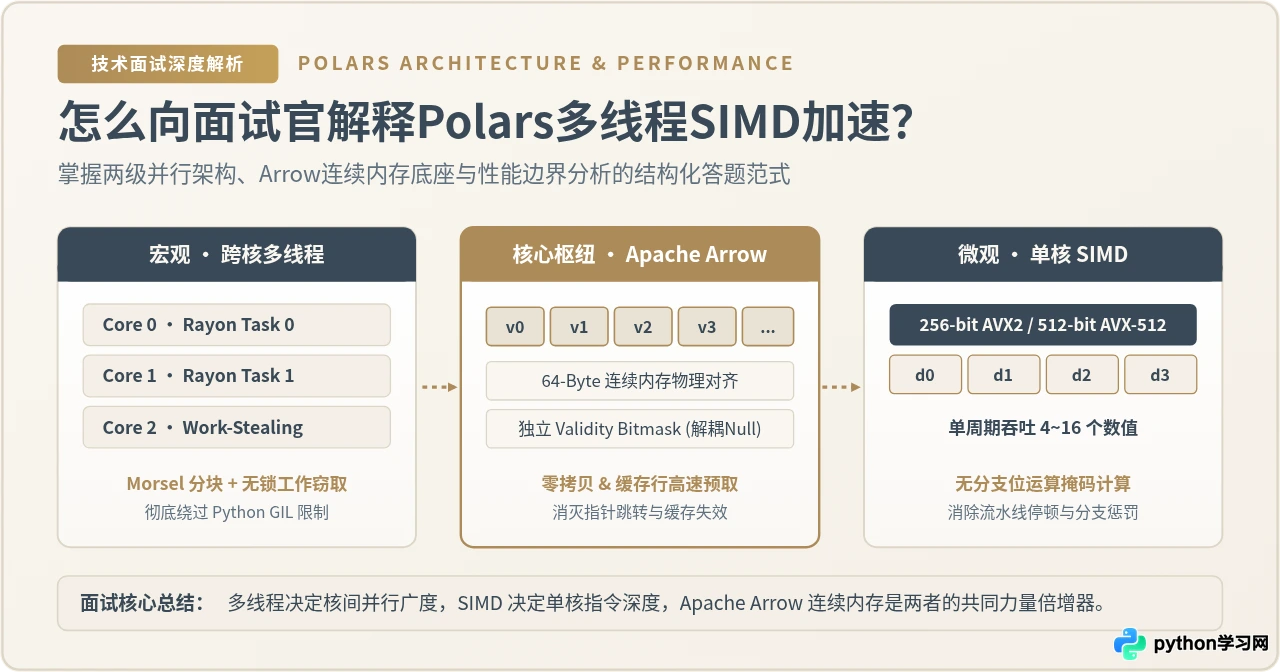
深入解析如何在技术面试中清晰阐释Polars的多线程与SIMD加速原理。涵盖宏观Rayon工作窃取、微观AVX向量寄存器、Apache Arrow连续内存底座与性能边界分析。
一、面试破题:构建四层递进答辩框架
当技术面试官抛出“请解释一下 Polars 为什么这么快?它的多线程和 SIMD 加速是怎么实现的?”这个问题时,考察的往往不是死记硬背的官方简介,而是候选人对现代计算机体系结构(多核 CPU、硬件缓存行、指令级并行)与列式数据处理引擎结合点的理解深度。
普通候选人往往把回答局限在“底层用 Rust 重写,消除了 Python GIL,所以多线程很快”。这类回答会立刻暴露两个缺陷:第一,忽略了单核内部以倍数提升吞吐的 SIMD 向量化;第二,没有讲清楚为什么多线程在处理倾斜数据时不会被长尾任务卡死。高水平的回答应该采用“四层推进逻辑”,层层下潜,最终以客观的工程权衡收尾。
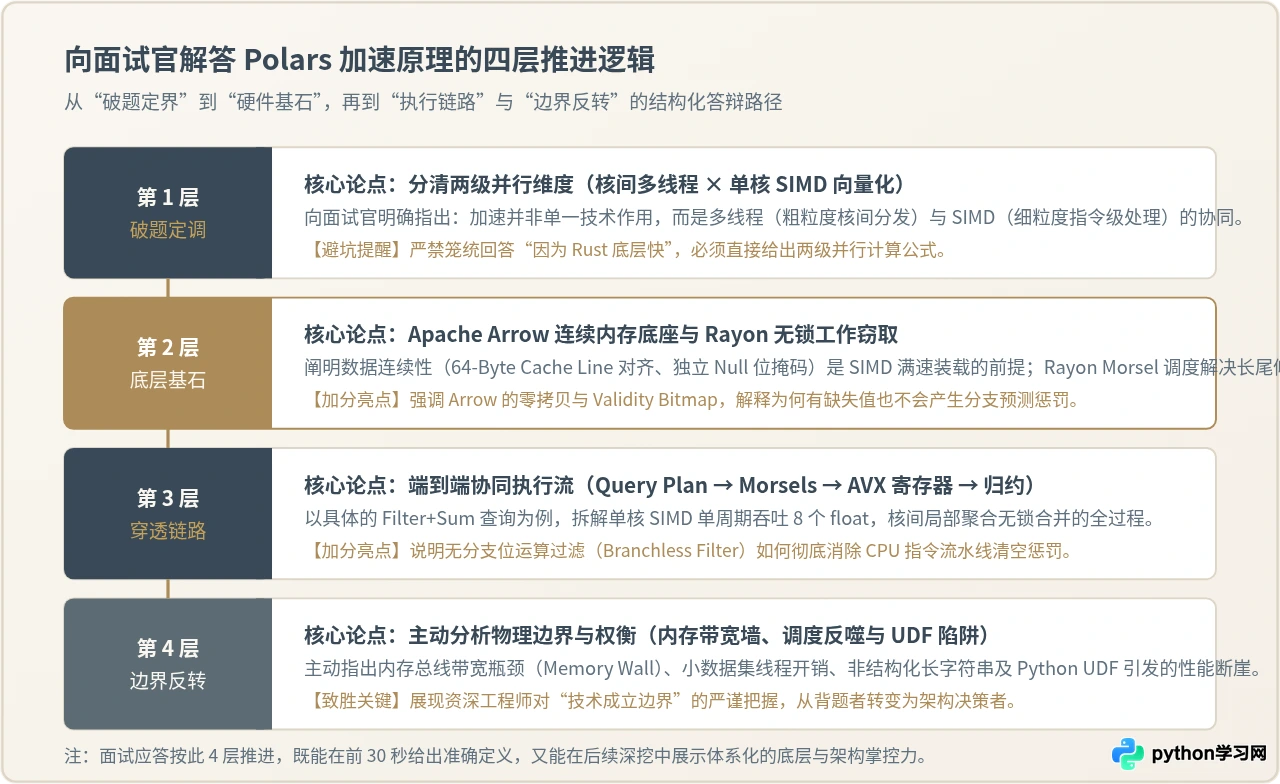
在实际面试中,建议在前 30 秒给出高度概括的破题定调,随后按层次展开:
- 第 1 层 · 概念定界:明确区分“宏观跨核并行”与“微观单核指令级并行”,指出两者的协同乘数效应;
- 第 2 层 · 底层基石:剖析 Apache Arrow 列式连续内存物理排布与 Rayon 无锁工作窃取调度器,解释硬件对齐与位图解耦;
- 第 3 层 · 穿透链路:以典型的数据过滤与聚合查询为例,还原从查询计划到 CPU 向量寄存器单指令处理 8/16 个数据点的微观流转;
- 第 4 层 · 边界反转:主动指出内存带宽墙(Memory Bandwidth Wall)、小任务调度反噬与 Python UDF 阻断等工程瓶颈,展现架构师思维。
二、第一层剖析:两级并行模型与核心概念厘清
回答的第一步是向面试官清晰建立两级加速的概念坐标系。现代 CPU 的算力由两部分构成:横向的多物理核心和纵向的单核心执行宽度。Polars 的性能突破正是分别在宏观和微观两个尺度上榨干了这两项硬件能力。
1. 宏观层:核间粗粒度多线程(Multi-Threading)
多线程解决的是“如何让 16 个或 32 个 CPU 核心同时运转”。在传统 Python 数据分析工具中,由于全局解释器锁(GIL)的存在,纯 Python 代码的多线程无法利用多物理核进行计算密集型处理。即使是在部分底层为 C 的库中,线程管理通常也是静态或粗粒度的分块,容易因数据倾斜导致“一核工作、群核围观”。
Polars 彻底解除了这一限制:当 Python 脚本调用 Polars API 时,Python 层仅仅负责将查询表达式解析为抽象语法树(AST);一旦进入物理执行阶段,控制权完全移交至 Rust 运行时,Python GIL 被瞬间释放。底层的多线程引擎可以同时调度所有物理核心。
2. 微观层:单核细粒度 SIMD 向量化(Single Instruction Multiple Data)
多线程只决定了有多少工人同时干活,而 SIMD 决定了每个工人“一铲子能挖几倍的土”。在传统的标量指令(SISD)下,CPU 计算两个 32 位浮点数相加需要一条指令,处理 8 个浮点数就需要重复循环 8 次。
而在支持 SIMD(如 x86 的 AVX2、AVX-512 或 ARM 的 NEON)的现代处理器中,CPU 拥有 256 位或 512 位的超宽向量寄存器。一条 AVX2 向量指令可以在单个时钟周期内,同时对 8 个 32 位浮点数执行算术运算或大小比较。Polars 利用 Rust 编译器的自动向量化与底层的显式 SIMD 内联函数,确保单核的计算能力得到数倍释放。
三、第二层基石:为什么 Polars 能够真正喂饱多线程与 SIMD?
此时经验丰富的面试官往往会追问:“很多库也宣称开了多线程和 C 扩展,为什么实际跑起来没有 Polars 这么快?Polars 的底层到底有什么特殊结构能同时喂饱两级并行?”
这里是拉开分数差距的核心关键点:多线程和 SIMD 都是硬件算力,如果底层数据结构没有解决‘内存连续性’与‘负载均衡’,算力就会因为等待内存或线程锁竞争而严重闲置。Polars 的核心杀手锏是 Apache Arrow 内存契约与 Rayon 工作窃取引擎。
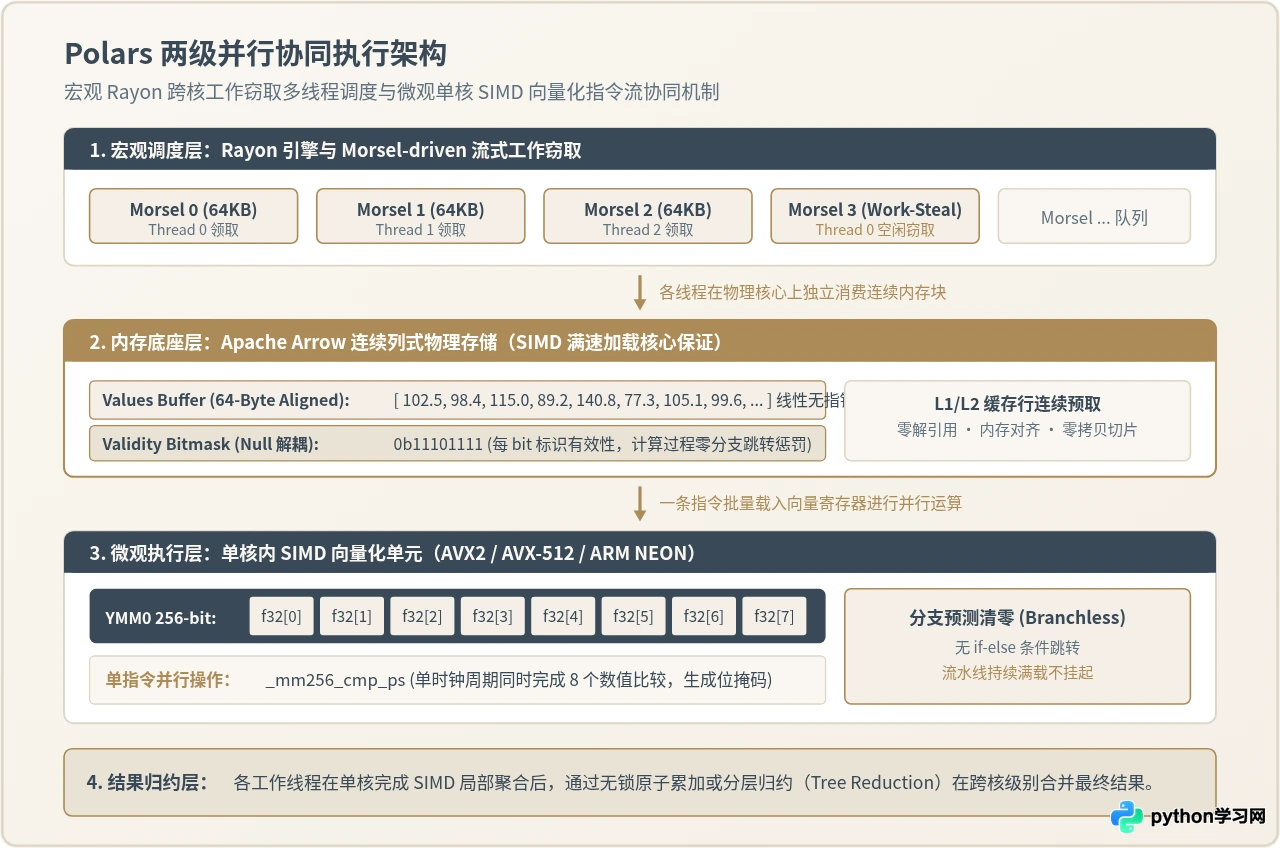
1. Apache Arrow 连续列存:SIMD 向量化的物理前提
SIMD 向量寄存器要求装载的数据在物理内存中必须是连续地址(Contiguous Buffer),最好能按 64 字节(对应一个 Cache Line)物理对齐。如果内存地址不连续,CPU 就必须通过开销巨大的 Scatter/Gather 指令拼凑数据,向量化收益几乎荡然无存。
Apache Arrow 标准天然具备这一物理特性:
- 一维连续缓冲区:一整列
Float64或Int32在内存中就是一块纯粹的物理字节数组,没有任何对象头或指针开销,CPU 向量单元可以通过对齐内存加载指令(如_mm256_load_ps)以纳秒级速度整批灌入寄存器; - Null 值的独立位图解耦(Validity Bitmask):传统数据结构中,缺失值要么占用特殊哨兵位(如 NaN),要么依赖对象的
is_none属性判定,这会导致每次计算都要执行条件分支。Arrow 将 Null 独立存放在紧凑的位图(Bitmap)中,每 1 位表示一个元素是否有效。计算时,SIMD 向量单元直接盲目全速计算数据缓冲区,最后通过向量与指令(Bitwise AND)与有效性掩码合并,彻底做到了无分支计算(Branchless Computing),消除了 CPU 分支预测失败(Branch Misprediction)引发的流水线清空惩罚。
2. Rayon 工作窃取与 Morsel-driven 流式调度:消除长尾木桶效应
多线程最怕什么?最怕“数据倾斜”与“伪共享(False Sharing)”。如果把 1 亿行数据简单切成 8 份均分给 8 个线程,只要其中一个分区的过滤条件命中率极高或计算逻辑复杂,其余 7 个线程跑完后就必须在屏障(Barrier)处停工等待,总耗时完全取决于最慢的木桶短板。
Polars 采用类似 DuckDB 的 Morsel-driven(小批次流式执行)机制,底层深度结合 Rust 的并发工作窃取调度器 Rayon:
- 细粒度分块:物理执行器将列数据切分为适合 CPU L2/L3 缓存容量的 Morsel(通常为 64KB 到 1MB,包含数万行数据);
- 动态任务窃取(Work-Stealing):各个物理核心对应的工作线程维护自己的双端任务队列(Deque)。当某个核心率先完成了手中的 Morsel 时,不会进入休眠等待,而是会主动从其他繁忙核心的队列尾部“窃取”尚未执行的 Morsel 继续运算;
- 无锁化流水线:每个线程在独立的工作内存区对各自的 Morsel 执行本地向量化计算,最后仅通过原子累加或轻量级树形归约(Tree Reduction)合并局部结果,最大限度消除了互斥锁(Mutex)争用。
四、深入硬件层:对比传统方案的微观性能断崖
为了向面试官直观证明你真正掌握了系统底层机制,拿传统基于 Python/Pandas 的对象模型进行横向物理内存对比,是最具说服力的回答技巧。
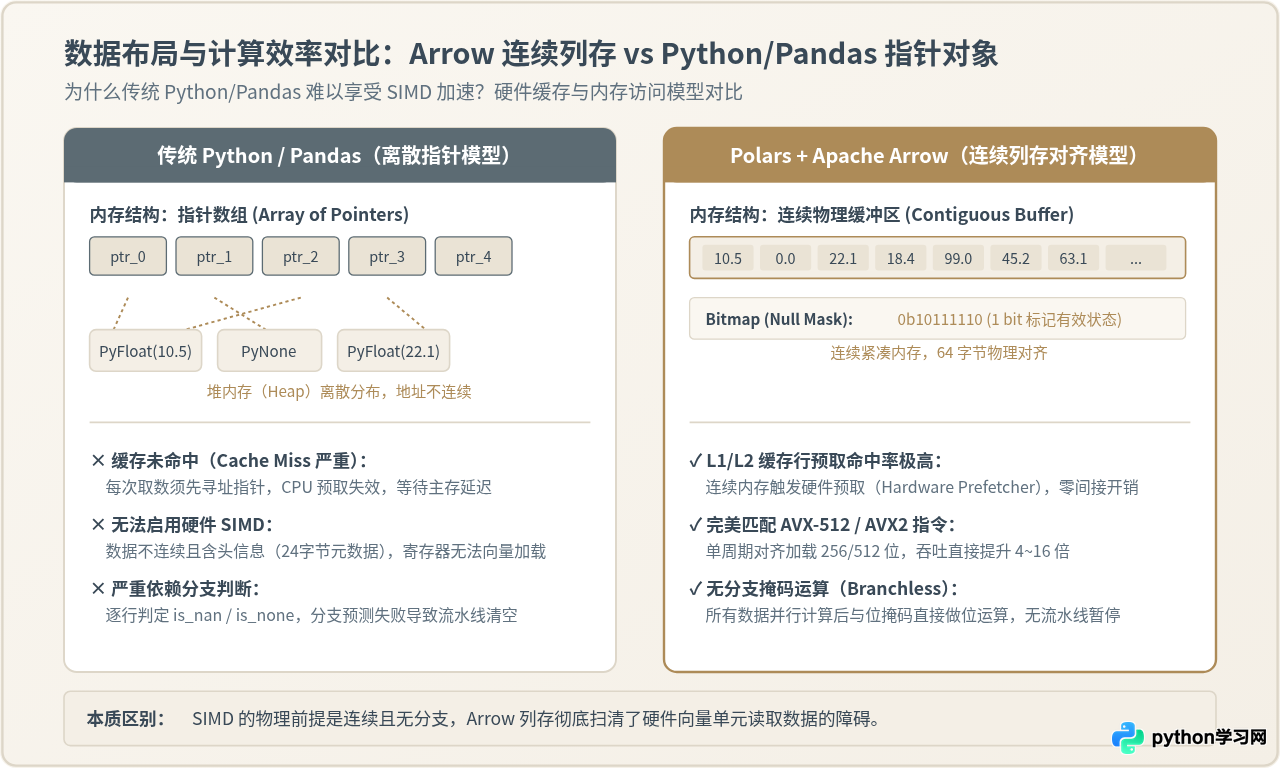
从硬件性能监控(CPU Profiling)的视角来看,传统行式对象或指针数组在现代 CPU 上会遭遇三重性能暴跌:
| 对比维度 | 传统 Python / Pandas (离散指针模型) | Polars + Apache Arrow (连续列存对齐模型) |
|---|---|---|
| 内存物理布局 | 指针数组(Array of Pointers),指针指向堆上散落的 PyObject 结构体,伴随 24 字节以上的对象头元数据。 | 一维连续无头字节流(Contiguous Array Buffer),按 64 字节缓存行边界对齐。 |
| CPU 缓存命中率 | 严重的 Cache Miss。指针解引用导致 CPU 随机寻址内存,硬件预取器(Hardware Prefetcher)彻底失效,CPU 大量时钟周期处于等待主存的数据停顿(Stall)。 | 极高命中率。连续读取触发硬件高速流式预取,L1/L2 缓存直接拉满,几乎没有内存等待开销。 |
| SIMD 向量化支持 | 完全不支持。向量寄存器无法从分散的内存地址同时加载数值,只能退化为标量单步循环逐个解包。 | 原生支持。单条 AVX2 指令一次读取 256 位内存,单周期处理 8 个 32 位浮点或 4 个 64 位浮点。 |
| 分支预测惩罚 | 循环内充斥着大量的 if value is None 或类型校验,导致 CPU 分支预测失败,频繁清空指令流水线。 |
无分支计算(Branchless)。数据值与 Validity Bitmask 解耦,位运算掩码合并,流水线全程顺畅不换气。 |
五、第三层实战:一个典型查询的端到端穿透
在面试中,结合一段具体的 Polars 查询代码,向面试官口述物理引擎在 CPU 上的端到端执行链路,是技术落地能力的最佳佐证。
import polars as pl

# 一个典型的过滤聚合查询
query = (
    pl.scan_parquet("transactions.parquet")
    .filter(pl.col("amount") > 100.0)
    .select(pl.col("score").sum())
)
result = query.collect()
向面试官口述这段代码执行时的四步穿透流程:
- 逻辑优化与物理切分:Polars 的 Lazy 引擎首先下推谓词,跳过 Parquet 文件的无用 Row Group。剩余的列数据被切分为一系列 64KB 的 Morsel 数据块,挂入 Rayon 调度队列;
- 核间粗粒度分发:控制权进入 Rust 核心,Python GIL 释放。主机上有 N 个物理核,Rayon 就唤醒 N 个 Worker 线程,各自从任务队列中抢占一个 Morsel;
- 单核内微观 SIMD 计算:
在核心内部,Worker 线程将当前 Morsel 的
amount列内存地址绑定到 CPU 寄存器。CPU 执行一条_mm256_cmp_ps指令,同时将 8 个连续单精度浮点数与 100.0 进行比较;比较结果直接生成一个 8 位的位掩码(Bitmask),完全没有
if-else分支跳转。紧接着,CPU 依据该掩码向量化加载score列数据,载入累加向量寄存器(YMM1),在一个时钟周期内完成 8 路累加; - 无锁全局结果归约:每个 Worker 线程处理完各自窃取的 Morsel 后,保留单核局部的浮点累加值。当所有 Morsel 消费完毕,Rayon 通过无锁树形归约将各核的局部和合并为全局 Scalar,重新封装并返回给 Python 环境。
六、第四层高分突围:主动揭示“性能边界与负优化陷阱”
初级开发者只谈优点,资深工程师必谈边界。如果在面试最后阶段,你能主动向面试官分析 Polars 多线程和 SIMD 加速在什么时候会失效、甚至产生负优化,面试评价会直接上升到架构与生产排障级别。
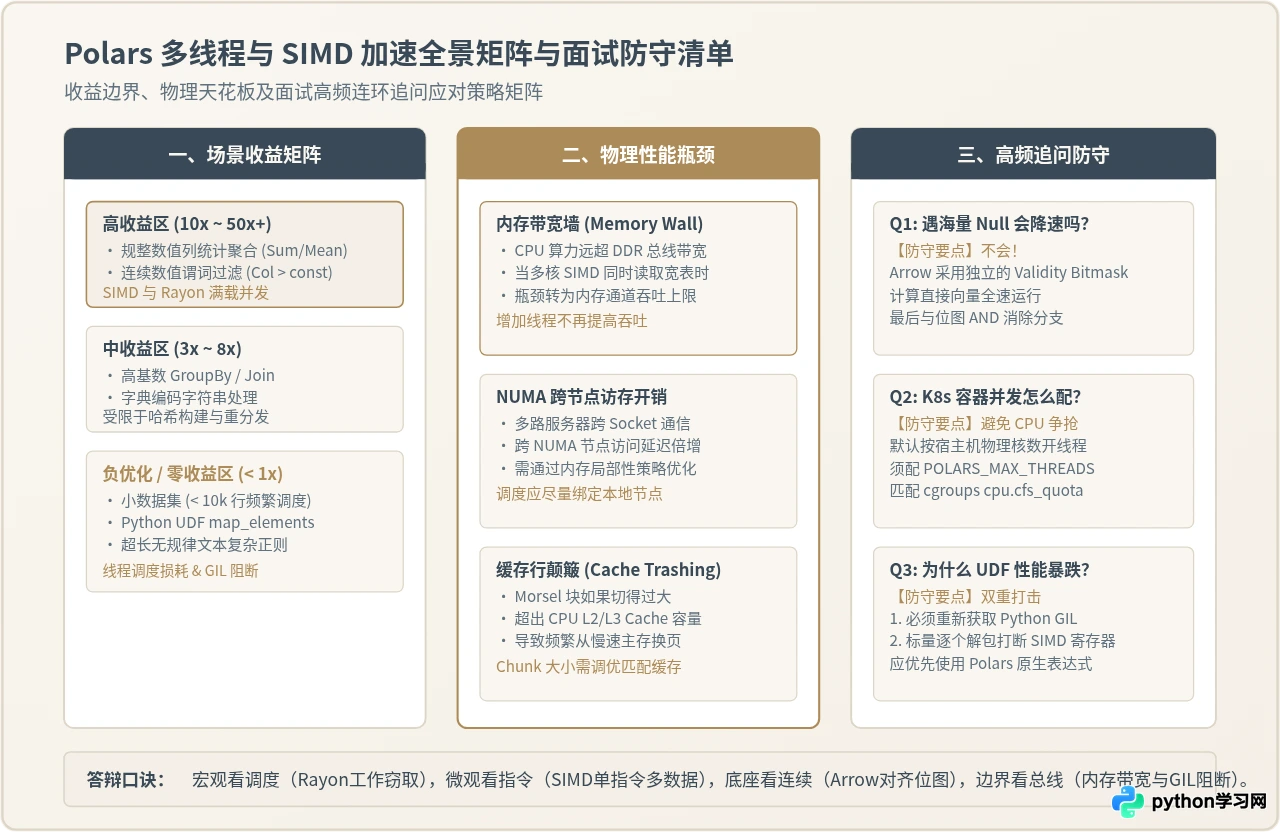
1. 内存带宽墙(Memory Bandwidth Wall)
这是多核加速最经典的物理天花板。现代 CPU 的浮点计算能力增长速度远快于内存总线(DDR4/DDR5)的读写带宽。
当并发线程数增加到一定程度(例如在双路 64 核服务器上开满 128 线程),所有核心的 SIMD 单元都在拼命向内存控制器索取数据,系统的瓶颈就会从 “CPU 算力不足” 瞬间转变为 “内存通道带宽耗尽”。此时继续增加线程,加速比将呈水平甚至因为内存总线拥塞而下跌。
2. 小数据集的调度反噬
如果数据量只有几千行或几万行,数据传输与处理本身的耗时可能只有微秒级。此时,线程池唤醒、Morsel 切分、跨线程上下文切换以及跨核合并的系统开销,甚至会远远超过直接在单线程单核上跑一个标量循环的耗时。小数据集强开多线程是典型的负优化。
3. 非结构化与变长长文本的 SIMD 衰减
SIMD 向量寄存器对固定位宽的数值类型(Int32、Int64、Float64、Date)加速效果极其恐怖(可达 20x~50x)。然而,对于包含大量长短不一、无固定规律的自由文本(String)以及复杂的正则表达式匹配,数据无法规整地一次性对齐载入固定位宽寄存器,SIMD 加速比会大幅缩水,性能主要依赖多线程粗粒度分担。
4. Python UDF(自定义函数)引发的“性能断崖”
如果在 Polars 查询中写了 pl.col("val").map_elements(lambda x: custom_func(x)),底层就会遭遇毁灭性打击:
- 为了执行这行 Python 函数,Rust 底层必须重新申请并持有 Python GIL;
- 连续对齐的 Arrow 内存块必须被迫退化,逐个元素反序列化为拥有独立对象头的
PyObject; - SIMD 向量寄存器彻底被破坏,多线程因反复争夺 GIL 导致严重的锁自旋。执行时间往往会出现 10 倍到 100 倍的暴涨。
七、面试现场连环追问速防清单
在讲解完上述体系后,面试官通常会挑出 3 个细节进行现场压力测试。掌握以下标准应对口径,即可稳妥收官:
limits: cpu: 2,但宿主机有 64 核,Polars 默认会启动 64 个并发工作线程。这会导致 64 个线程争夺 2 个 CPU 核心的时间片,触发严重的 cgroups 限制(CFS Quota Throttling)和上下文切换开销。最佳实践是在容器环境变量中显式配置 POLARS_MAX_THREADS=2,精确匹配配额。”
八、全文总结口诀
面试时间宝贵,在回答结尾时,建议用一句凝练的口诀为整场阐述画上句号:
只要按照“两级并行模型 → Arrow/Rayon 底座支撑 → 硬件级效率对比 → 物理瓶颈与边界洞察”这四步逻辑展开,就不仅能回答出“Polars 为什么快”,更能向面试官证明你拥有从高级语言到底层硬件体系结构的完整工程知识体系。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















