


Python文件读写与数据处理实例:100例中的IO操作精讲
精讲Python文件读写与数据处理的核心IO操作,涵盖with上下文管理、编码规范、CSV与JSON读写、大文件分块流式处理及原子写入安全防御。
在日常数据清洗、接口日志归档和自动化脚本开发中,文件读写(Input/Output,简称 IO)是最基础且最频繁的环节。许多运行期异常,如文件未释放导致的句柄枯竭、跨操作系统引发的编码乱码(UnicodeDecodeError)、或者全量载入大文件导致的内存溢出(OOM),根源都在于没有规范地组织 IO 流水线。本文聚焦 Python 经典场景中关于输入输出操作的核心技术,从上下文管理、结构化数据转换、大文件分块迭代到原子落地防御,提供可直接落地的完整操作范式。
文件打开模式与上下文管理机制
在 Python 中操作文件,最安全且标准的方式是结合 open() 函数与 with 语句。with 语句依托上下文管理协议(Context Manager),在代码块进入时自动调用底层对象的 __enter__() 方法,在离开作用域时不论是正常执行完毕还是中途抛出未经捕获的异常,都会无条件调用 __exit__() 方法关闭文件句柄,彻底杜绝操作系统文件句柄泄漏。
打开文件时需要显式声明操作模式与字符编码。常见的文件操作模式包括:
r:只读模式(默认)。文件必须存在,否则抛出FileNotFoundError。w:覆盖写入模式。若文件存在则直接截断清空,若文件不存在则创建新文件。a:追加写入模式。文件指针固定位于文件末尾,新增内容直接追加在末尾,不影响历史数据。x:独占创建模式(Python 3 特性)。若目标文件已存在则直接抛出FileExistsError,防止并发冲突或意外覆盖。b:二进制模式,如rb或wb,直接读写bytes字节串,常用于音视频、编译缓存及序列化数据。
encoding="utf-8"。若缺省该参数,Python 会读取宿主操作系统的默认编码(如 Windows 中常默认为 GBK/CP936,而 Linux 与 macOS 为 UTF-8),一旦读取包含中文字符的文本,就会引发编码解码崩溃。
from pathlib import Path

# 使用 pathlib 保证路径在 Windows/Linux 下的天然兼容性
file_path = Path("sample_data.txt")

# 写入文本示例
with open(file_path, mode="w", encoding="utf-8") as f:
    f.write("第一行:基础IO参数配置\n")
    f.write("第二行:强制指定UTF-8编码防乱码\n")

# 逐行读取示例
with open(file_path, mode="r", encoding="utf-8") as f:
    for line_num, line in enumerate(f, start=1):
        print(f"行号 {line_num}: {line.strip()}")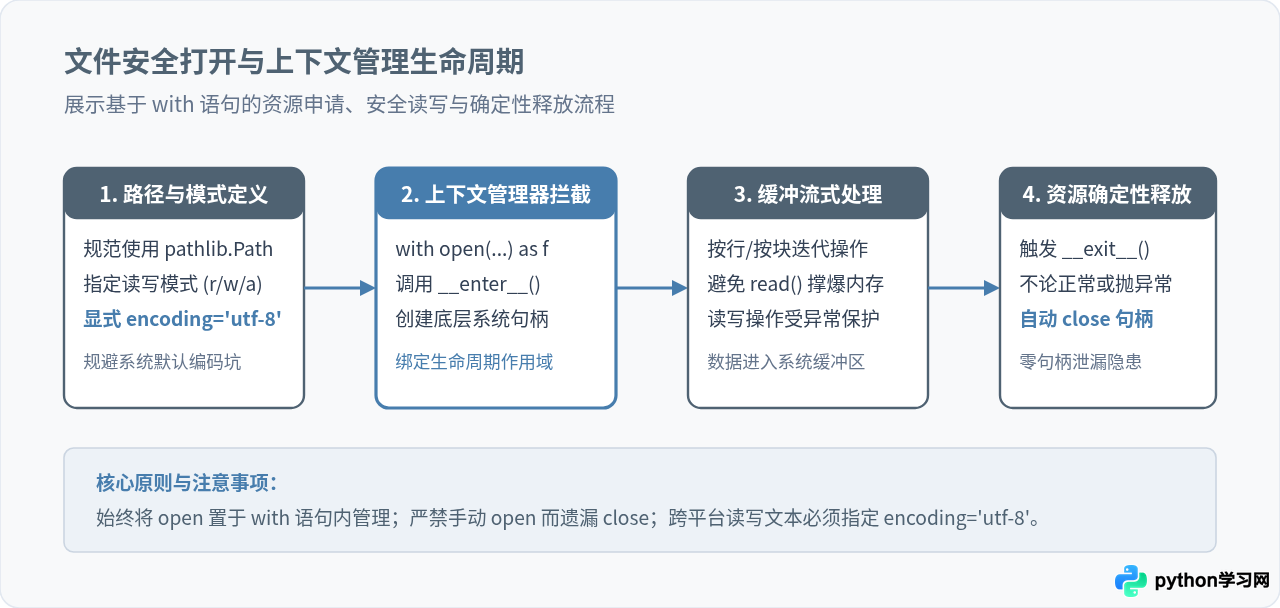
结构化数据处理:CSV 与 JSON 实战
在日常数据清洗任务中,文本往往不是散乱的段落,而是具备强结构特征的表格数据或对象映射。Python 标准库自带的 csv 模块和 json 模块是处理结构化数据的基石,合理选用能极大简化解析逻辑。
1. CSV 格式的高效映射与空行防范
处理 CSV(Comma-Separated Values)文件时,最常见的错误是在 open() 中遗漏了 newline='' 参数。Python 的通用换行符机制会在写入行末时将 \n 翻译为平台默认换行(如 Windows 下的 \r\n),而 csv.writer 本身也会写入行结束符,两者叠加会导致每行数据之间多出一个空白空行。设置 newline='' 可交由 csv 模块统一托管换行处理。
相比于基础的 csv.reader(返回列表),使用 csv.DictReader 和 csv.DictWriter 可以将每一行数据直接映射为 Python 字典,无需依靠硬编码数字下标访问列,提升代码鲁棒性。
2. JSON 序列化中的中文字符与对象类型
JSON 模块核心提供四个方法:针对内存字符串的 json.loads() 与 json.dumps(),以及针对文件流对象的 json.load() 与 json.dump()。在持久化包含中文的字典时,默认 ensure_ascii=True 会将非 ASCII 字符转义为形如 \u4e2d\u6587 的 Unicode 序列。将参数设为 ensure_ascii=False,可以直接输出真实的 UTF-8 中文字符,不仅便于人类直接审阅,还能减少存储体积。
import csv
import json

# 1. 结构化写入 CSV 文件
records = [
    {"user_id": 1001, "name": "李强", "dept": "数据工程", "score": 94.5},
    {"user_id": 1002, "name": "王敏", "dept": "后端开发", "score": 91.0},
    {"user_id": 1003, "name": "张伟", "dept": "算法研究", "score": 96.0}
]

csv_file = "users_dataset.csv"
fieldnames = ["user_id", "name", "dept", "score"]

with open(csv_file, mode="w", encoding="utf-8", newline="") as f:
    writer = csv.DictWriter(f, fieldnames=fieldnames)
    writer.writeheader()
    writer.writerows(records)

# 2. 读取 CSV 并转换为 JSON 汇总字典
aggregated_data = []
with open(csv_file, mode="r", encoding="utf-8") as f:
    reader = csv.DictReader(f)
    for row in reader:
        # 类型还原:csv读取出来的值全为字符串,需显式转换数值
        row["user_id"] = int(row["user_id"])
        row["score"] = float(row["score"])
        aggregated_data.append(row)

# 3. 持久化为 JSON 文件
json_file = "users_summary.json"
with open(json_file, mode="w", encoding="utf-8") as f:
    json.dump(aggregated_data, f, ensure_ascii=False, indent=2)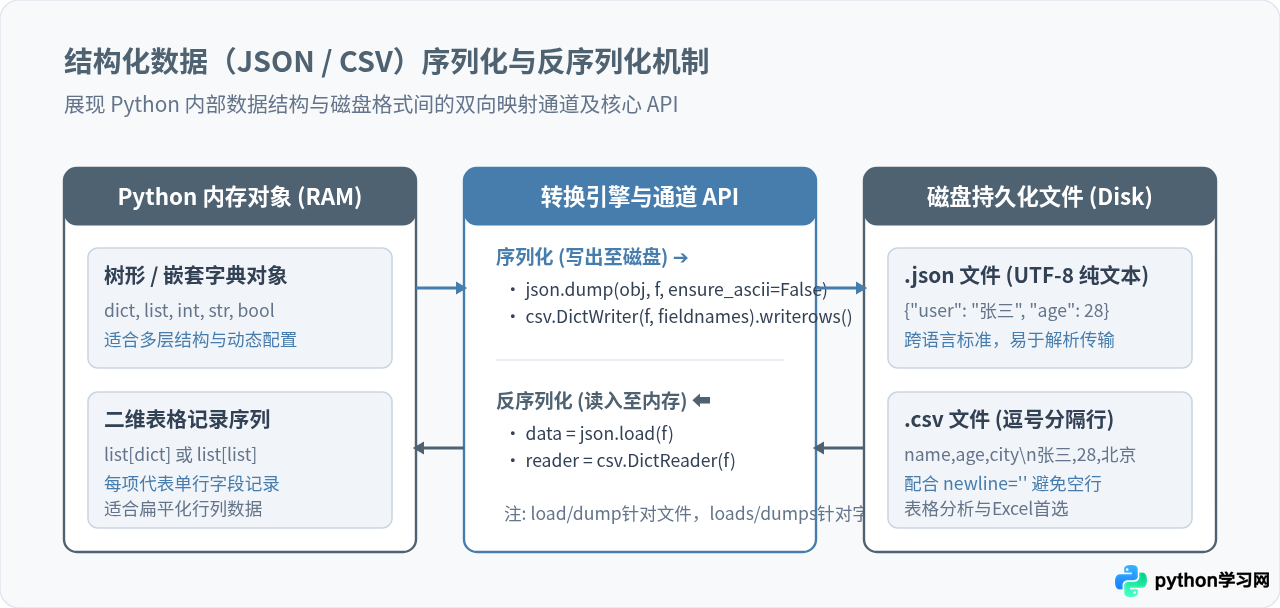
高效处理海量数据:分块读取与内存流式迭代
当处理的文件从几兆字节上升到数吉字节(GB 级别,例如 Nginx 访问日志、大型数据库导出转储或传感器时序记录)时,绝对不能使用 f.read() 或 f.readlines()。因为这两个方法会将整个文件内容完全载入内存,造成内存瞬间占满触发操作系统 OOM(Out Of Memory)直接强制杀死进程。
处理大文件的标准范式是惰性生成器与固定缓冲区流式分块:
- 文本文件按行惰性流:直接使用
for line in f:语法。Python 文件对象内部封装了智能行缓冲迭代器,在底层逐行按需加载,内存占用始终恒定在单行字符串大小。 - 二进制或定长分块流:利用
iter(lambda: f.read(CHUNK_SIZE), b"")构造生成器哨兵迭代。每次仅载入预分配的固定大小(如 64KB 或 1MB)缓冲区,处理完毕后立即被垃圾回收。
from functools import partial

def process_huge_log(file_path: str):
    """逐行惰性流式统计,内存开销恒定小于5MB"""
    error_count = 0
    with open(file_path, mode="r", encoding="utf-8", errors="replace") as f:
        for line in f:
            if "ERROR" in line:
                error_count += 1
    return error_count

def copy_large_binary(src_path: str, dst_path: str, chunk_size: int = 65536):
    """二进制定长分块拷贝,杜绝内存峰值"""
    with open(src_path, "rb") as src, open(dst_path, "wb") as dst:
        # 使用 partial 构造定长读取生成器,读到空字节 b"" 自动退出
        for chunk in iter(partial(src.read, chunk_size), b""):
            dst.write(chunk)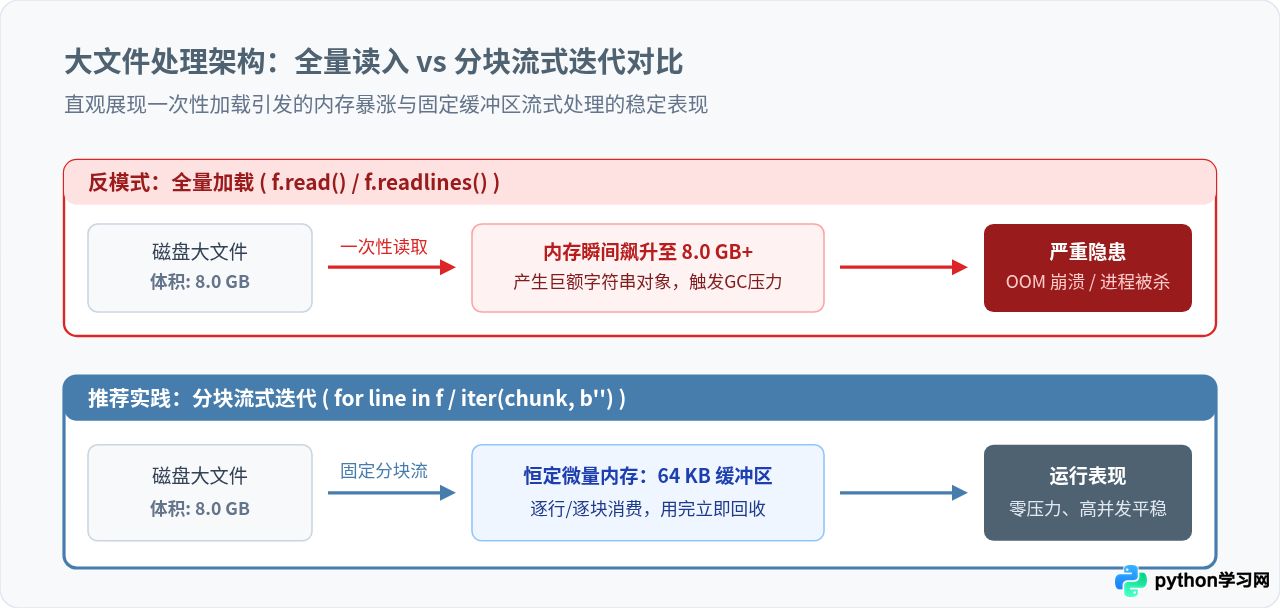
健壮性与生产级 IO 防御模式
在严肃的生产环境中,编写文件不仅需要考虑“写成功”,更要防范“写到一半机器断电、进程崩溃或磁盘已满”引发的半截坏文件。常见的文件直接覆盖写入(mode="w")会在文件打开的一刹那把文件长度截断为 0;如果此时程序发生崩溃,原来的旧数据已经荡然无存,新数据又未写完,导致灾难性的数据破坏。
1. 原子替换(Atomic Write)落地保障
防御此类崩溃的标准解决方案是“写临时文件 + 原子重命名”。在目标文件同目录下创建一个带随机后缀的临时文件,将数据完整写入并同步刷新到底层存储(f.flush() 和 os.fsync())。当临时文件完整落地后,调用操作系统的原子重命名操作(POSIX 和现代 Windows 上的 os.replace())将临时文件覆盖为目标名称。因为重命名在文件系统级别是原子指令,即便在写入阶段崩溃,原有数据文件依然毫发无损。
2. 缓冲区刷新机制区别
需要理清 f.flush() 与 os.fsync() 的边界:
f.flush():仅将 Python 进程内部的用户空间缓冲区数据刷新到操作系统的内核文件缓存中,此时数据尚未真正写入物理硬盘盘片或闪存颗粒。os.fsync(f.fileno()):强制操作系统内核把对应文件描述符(File Descriptor)的所有脏数据和元数据立即刷盘写入物理存储介质,具备最高的掉电安全性。
import os
import tempfile
from pathlib import Path

def atomic_save_content(target_path: str, content: str):
    """原子化安全保存,防止写入中断损坏原文件"""
    target = Path(target_path).resolve()
    # 在目标所在目录创建临时文件,确保处于同一个文件系统分区,避免跨设备移动失败
    temp_dir = target.parent
    temp_dir.mkdir(parents=True, exist_ok=True)

    # 创建带隐藏前缀的安全临时文件
    with tempfile.NamedTemporaryFile("w", dir=temp_dir, delete=False, encoding="utf-8") as tf:
        temp_name = tf.name
        tf.write(content)
        tf.flush()
        # 强制内核将缓冲刷入底层磁盘
        os.fsync(tf.fileno())

    try:
        # 原子替换,旧文件瞬间被无缝覆盖,不存在中间截断空窗期
        os.replace(temp_name, target)
    except Exception:
        # 若重命名出现意外,及时清理遗留的临时碎片
        if os.path.exists(temp_name):
            os.remove(temp_name)
        raise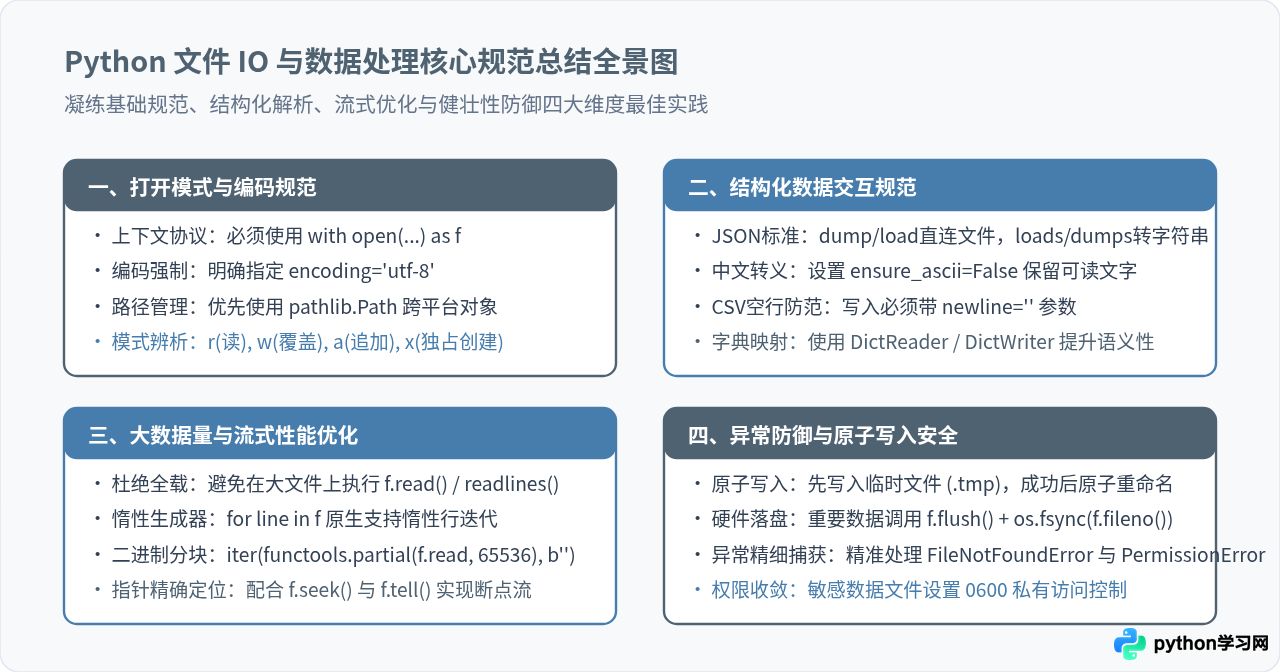
常用 IO 操作速查与注意事项清单
| 场景诉求 | 推荐 API / 模式 | 关键注意事项 |
|---|---|---|
| 文本读取与写入 | open(p, "r", encoding="utf-8") |
禁止缺省 encoding,始终在外层使用 with 上下文 |
| 读取逗号分隔数据 | csv.DictReader(f) |
写入 CSV 时必须添加 newline="" 参数,避免出现多余空行 |
| 保存中文 JSON | json.dump(obj, f, ensure_ascii=False) |
缺省 ensure_ascii 会导致输出大量 Unicode 转义字符 |
| 海量日志流式迭代 | for line in f: 或生成器分块 |
严禁使用 f.read() 一次性把超大文件读入内存导致 OOM |
| 二进制媒体/缓存拷贝 | open(p, "rb") + 64KB Buffer |
无需指定 encoding 参数,直接操作 raw bytes 数据流 |
| 重要数据覆盖写入 | tempfile + os.replace |
临时文件与目标文件必须在同目录,确保触发原子重命名 |
遵循上述规范,能让你的 Python 代码在处理各类型输入输出任务时具备优良的运行效率、跨平台兼容性以及数据完整性保障。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















